Qwen-Image 2.1のローカル版をAnimaと比べた
 目次
前回のアンバサダー向けの先行体験では、ModelScope StudioでQwen-Image 2.1を使い、俯瞰などの構図指定や、オリキャラのかなちゃんの立ち絵の編集を試した。
9月20日に重み(学習済みモデルのデータ)が公開されたので、手元のM1 Max 64GBでも同じように構図を取れるのか確かめた。
あわせて、4月にAnima・WAI-Anima・WAI-Illustriousを比べた記事と同じプロンプトでも生成し、作例を並べた。
比較に使う条件
Qwenの生成条件は832×1216、40ステップ、シード42にそろえた。ステップは画像を更新する反復回数、シードは乱数の起点になる番号。各条件は1回ずつ生成した。
生成処理の時間は、プロンプトの読み取り・反復計算・画像への復元を合わせて測った。モデルの読み込み時間は含まない。
計算はBF16という16ビット浮動小数点形式で行い、PyTorchからMacのGPUを使うMPSを指定した。プロンプトに従わせる強さを調整するCFGは1.0とし、出したくない要素を書くネガティブプロンプトは使っていない。
ノイズから画像を作る計算方式がサンプラーで、その計算を進める刻み方はスケジューラーと呼ばれる。Qwenでは、画像生成用ライブラリDiffusersが公開重みの設定から読み込んだものを使った。
| 比較 | そろえたもの | 異なるもの |
|---|---|---|
| Studioとローカル | 英文、参照画像、解像度、シード番号 | 実装、ネガティブプロンプト、Studio側の未確認の内部設定 |
| かなちゃんの構図・ポーズ変更 | 入力の立ち絵、ローカルの生成条件 | 変更する向きや手足の指定 |
| 4月のAnima・Illustriousの作例 | 英文、解像度、シード番号 | モデル、ステップ、CFG、サンプラー、生成時期 |
| 4月のi2i(WAI-IL → Anima系) | 元画像、解像度、シード番号 | Anima系はdenoise 0.5のi2i、Qwenは参照画像と英文による編集 |
M1 Max用のPython環境
| 項目 | 今回の環境 |
|---|---|
| 本体 | MacBook Pro、Apple M1 Max |
| メモリ | 64GB |
| OS | macOS 27.0、ビルド26A428 |
| Python | 3.12.12、uvで専用環境を作成 |
| PyTorch / Torchvision | 2.14.0 / 0.29.0 |
| Transformers / Accelerate | 5.17.0 / 1.15.0 |
| Diffusers | 0.41.0.dev0、コミット 80c7ed262aeffbeb43ef13ae04baeb9b84515a69 |
| ModelScope | 1.40.1 |
公式の実行例は、画像生成用ライブラリDiffusersの QwenImage21Pipeline を使う。
手元ではGPUの指定をCUDAからMPSへ変更し、既存のComfyUIとは別のPython環境に導入した。
最初はPyTorch 2.13.0で環境を作ったが、モデル読み込みが次のエラーで止まった。
Qwen3VLVideoProcessor requires the Torchvision libraryTransformersが入力を整える処理(プロセッサー)を読み込む段階で、Torchvisionが必要になっていた。
Torchvisionを追加インストールしたときにPyTorchも2.14.0へ上がったので、生成時間の計測はすべて更新後の環境で行った。
専用フォルダーで、生成に使ったバージョンを指定してインストールする。
uv venv --python 3.12 .venv
uv pip install --python .venv/bin/python \
  'torch==2.14.0' 'torchvision==0.29.0' \
  'transformers==5.17.0' 'accelerate==1.15.0' \
  'modelscope==1.40.1' 'pillow==12.3.0' \
  'git+https://github.com/huggingface/diffusers@80c7ed262aeffbeb43ef13ae04baeb9b84515a69'
ModelScopeから重みを取得する
公式リポジトリの9月20日の告知に、ModelScopeとHugging Faceの公開先が載った。
今回はModelScopeのファイル一覧にある重みを、上で作った専用環境からModelScope SDKで取得した。
import os

os.environ["MODELSCOPE_DOWNLOAD_PARALLEL_WORKERS"] = "4"
from modelscope import snapshot_download

snapshot_download(
    "Qwen/Qwen-Image-2.1",
    revision="master",
    endpoint="https://modelscope.ai",
    local_dir="model",
    cache_dir="cache",
    max_workers=4,
)
画像生成本体、文章や参照画像を読み取るテキストエンコーダー、画像と内部表現を変換するVAEを合わせて、重みは7ファイルだった。
合計33,115,613,408バイト、約33.1GB。公式の7B(70億パラメーター)は画像生成部分の数で、テキストエンコーダーとVAEは別に加わる。
取得後、全7ファイルのサイズと、破損を確かめるためのSHA-256を公開一覧と照合し、すべて合っていた。
ライセンスはQwen Research License。非商用の研究・評価向けで、商用利用には別途ライセンスを求める条件がある。
小さい画像で動作確認
最初はネオン看板の短いプロンプトを使い、512×512の画像を保存できるか試した。
シード42・BF16・MPSは本文の生成と同じで、ステップ数を4に減らした。
A neon shop sign that reads "QWEN IMAGE 2.1", rainy night, reflections on wet pavement| 解像度・ステップ・シード | 生成時間 | 出力 |
|---|---|---|
| 512×512・4ステップ・42 | 24.99秒 | 暗い背景に青と赤の線が重なり、看板の文字は読めない |
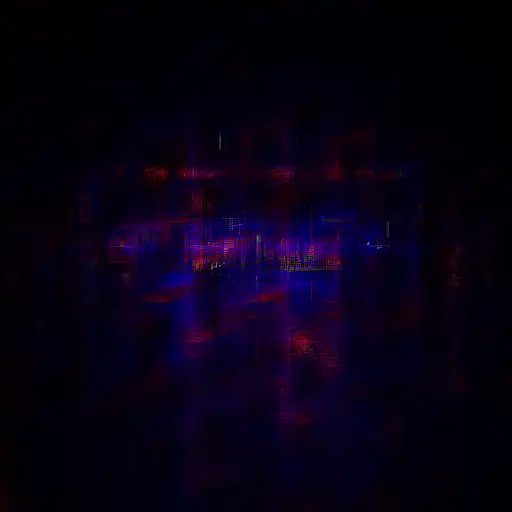
4ステップでもPNGの保存まではできた。
Studioと同じ俯瞰プロンプト
ここからステップ数を公式例と同じ40に増やした。
前回Studioで送った俯瞰の英文を、実行記録からそのまま使った。人物を上から見下ろし、顔をカメラへ上げさせる内容。
masterpiece, best quality, high quality, newest, year 2025, year 2024,
1girl, solo, long blonde hair, blue eyes, school uniform, white shirt, navy skirt,
strong high-angle overhead view, camera clearly above the subject looking steeply downward, visible top surfaces and pronounced top-down perspective. The subject is seen from the head toward the legs with the head visually nearer and larger than the lower body; the ground fills most of the background. The subject tilts her face upward and looks up into the camera.
ローカルで生成したコード
モデルはダウンロード済みのファイルだけから読み込んだ。再実行するときは、上の英文を prompt.txt に保存して使う。
from pathlib import Path
import torch
from diffusers import QwenImage21Pipeline

prompt = Path("prompt.txt").read_text()
pipe = QwenImage21Pipeline.from_pretrained(
    "./model", torch_dtype=torch.bfloat16, local_files_only=True,
).to("mps")

image = pipe(
    prompt=prompt,
    width=832,
    height=1216,
    num_inference_steps=40,
    true_cfg_scale=1.0,
    use_kv_cache=True,
    generator=torch.Generator("cpu").manual_seed(42),
).images[0]
image.save("local-from-above.png")
KVキャッシュは計算済みの情報を再利用する設定で、有効にした。計算の途中でモデルをCPUへ退避する処理や、内部のデータを画像へ戻すVAEの分割処理は使っていない。
今回のDiffusersのコードでは、true_cfg_scale=1.0 のときネガティブプロンプトによる誘導は働かない。
| 項目 | 前回のStudio | 今回のローカル |
|---|---|---|
| プロンプト | 上の英文 | 同じ英文 |
| 解像度 / シード | 832×1216 / 42 | 832×1216 / 42 |
| プロンプトの自動補強 | オフ | なし |
| ステップ数 / CFG | 内部設定は未確認 | 40 / 1.0 |
| ネガティブプロンプト | 指定あり | 使用なし |
| 乱数を作る実装 | 未確認 | PyTorchのCPU乱数生成器 |
各条件はシード42の1回だけなので、出力の違いが通常の揺れなのか、実行環境による差なのかは区別できない。
前回のStudioでかかった時間は体感値だったので、今回の実測とは速度を比べられない。
| 実行場所 | 指定 | 確認した結果 |
|---|---|---|
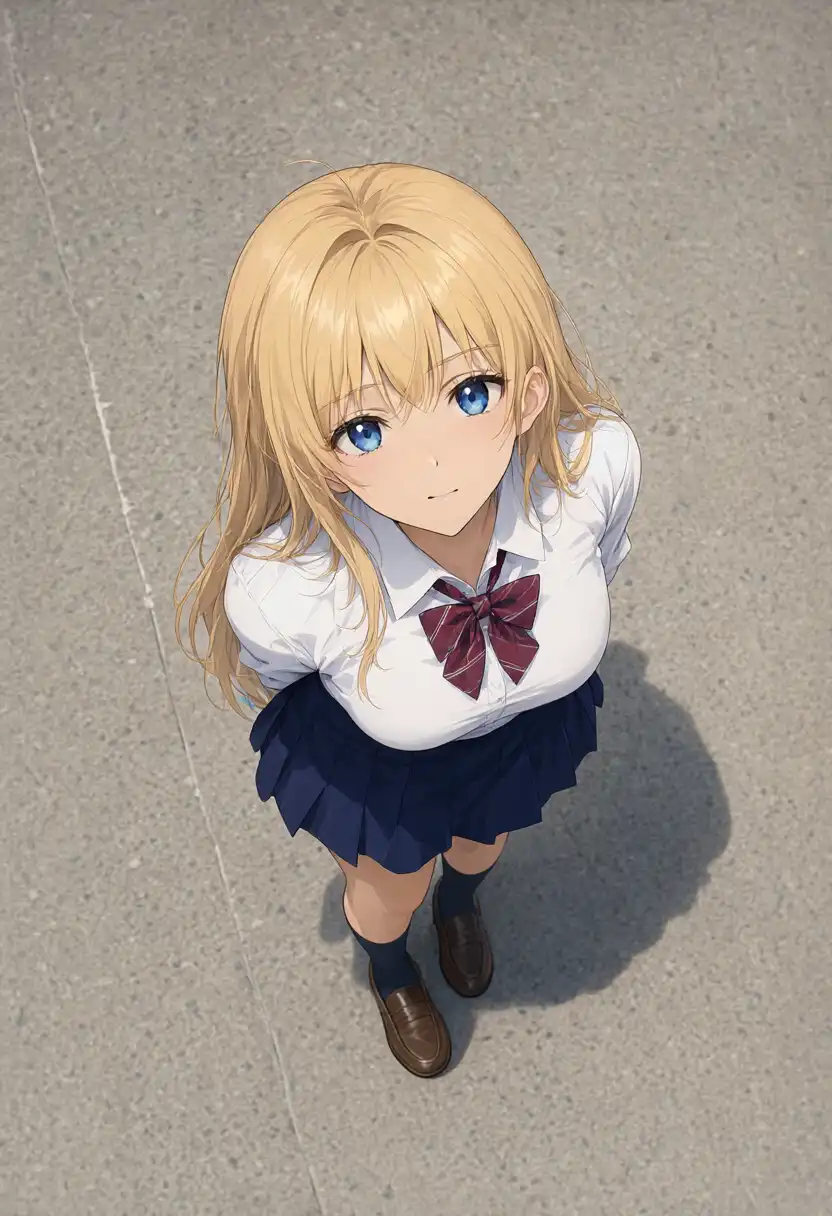
| 前回のStudio | 金髪・青い目・制服の人物を俯瞰し、見上げさせる | 地面が背景になり、頭が手前に大きく見える |
| 今回のM1 Max | 同じ英文 | 地面が背景になり、頭が手前に大きく見える。リボンの色や立ち位置は異なる |
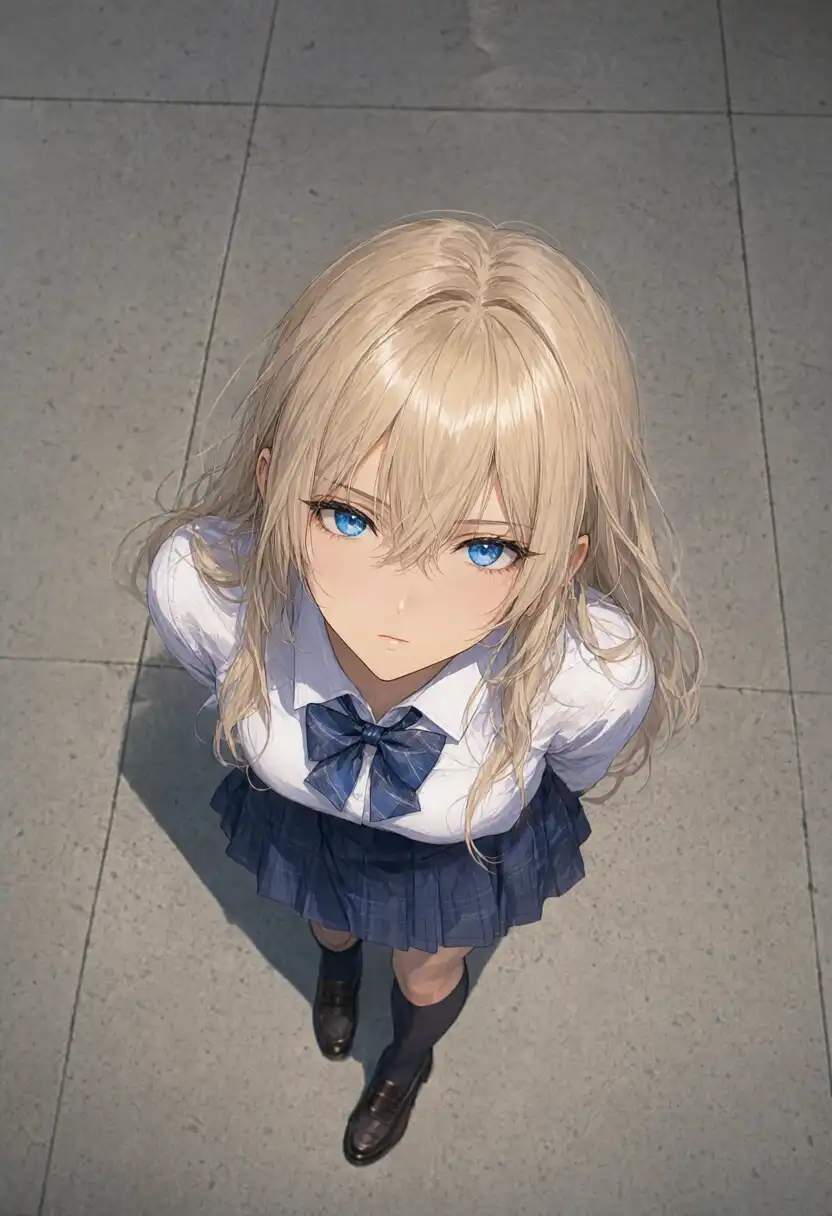
俯瞰の構図は、ローカルでもStudioと同じように出た。
描き込みは、元のPNGを同じ大きさで並べるとStudio版のほうが細かかった。髪の細い毛束やハイライト、シャツのしわがあり、スカートにはチェック柄も描かれていた。ローカル版は髪や服の面がなめらかだった。
M1 Maxでの生成時間とメモリ
上の俯瞰の生成で、時間とメモリを記録した。832×1216の生成は1ステップ約15秒かかった。
ほかの処理の影響を確かめるため、同じMacで動いていたブログ確認用のAstro開発サーバーを25ステップ終了後に停止した。停止前もサーバーのCPU使用率はほぼ0%だった。
| 区間 | 1ステップの平均時間 |
|---|---|
| サーバー停止前、2〜25ステップ | 15.177秒 |
| 停止後、27〜40ステップ | 15.040秒 |
ステップの時間は終了時刻同士の差で測り、最初の終了時刻を基準にした2ステップ目以降を平均した。
停止をまたぐ26ステップ目は除いた。停止後も1ステップに約15秒かかった。
| 計測区間 | 文章からの生成・832×1216 |
|---|---|
| CPUでのモデル読み込み | 1.59秒 |
| MPSへの転送 | 16.83秒 |
| 生成処理 | 614.71秒、約10分15秒 |
| モデル読み込み開始からPNG保存まで | 633.24秒、約10分33秒 |
| 2〜40ステップの平均 | 15.12秒 |
| GPU側の確保メモリ・記録上の最大 | 約45.8GB |
| システム全体のスワップ・開始時→終了時 | 約0.5MB→約0.5MB |
生成処理には文章の読み取り、40回の反復、VAEで画像へ戻す処理を含む。
モデル読み込みとPNG保存は別に測り、Pythonのimport時間は表のどの値にも含めていない。時刻はGPU処理の完了を待ってから記録した。
メモリはMPSドライバーの確保量を記録した。反復中は約33.9GB、VAEの処理後には約45.8GBだった。
PyTorchが返すGPU側の確保量には、モデルのデータに加えてキャッシュなども含まれる。
1秒ごとと処理の区切りで測ったので、その間の短いピークは取り逃している可能性がある。
スワップ(メモリ上のデータを一時的にSSDへ移す仕組み)の使用量は、システム全体で実行開始時から終了時まで約0.5MBのままだった。
かなちゃんの立ち絵を俯瞰へ編集
文章からの生成ができたので、前回の編集に使ったオリキャラのかなちゃんの立ち絵を1枚入力した。
| 参照画像で維持するもの | 変更するもの |
|---|---|
| 顔・髪型・服装 | 正面の立ち絵を、上から見下ろして顔を上げる構図へ変える |
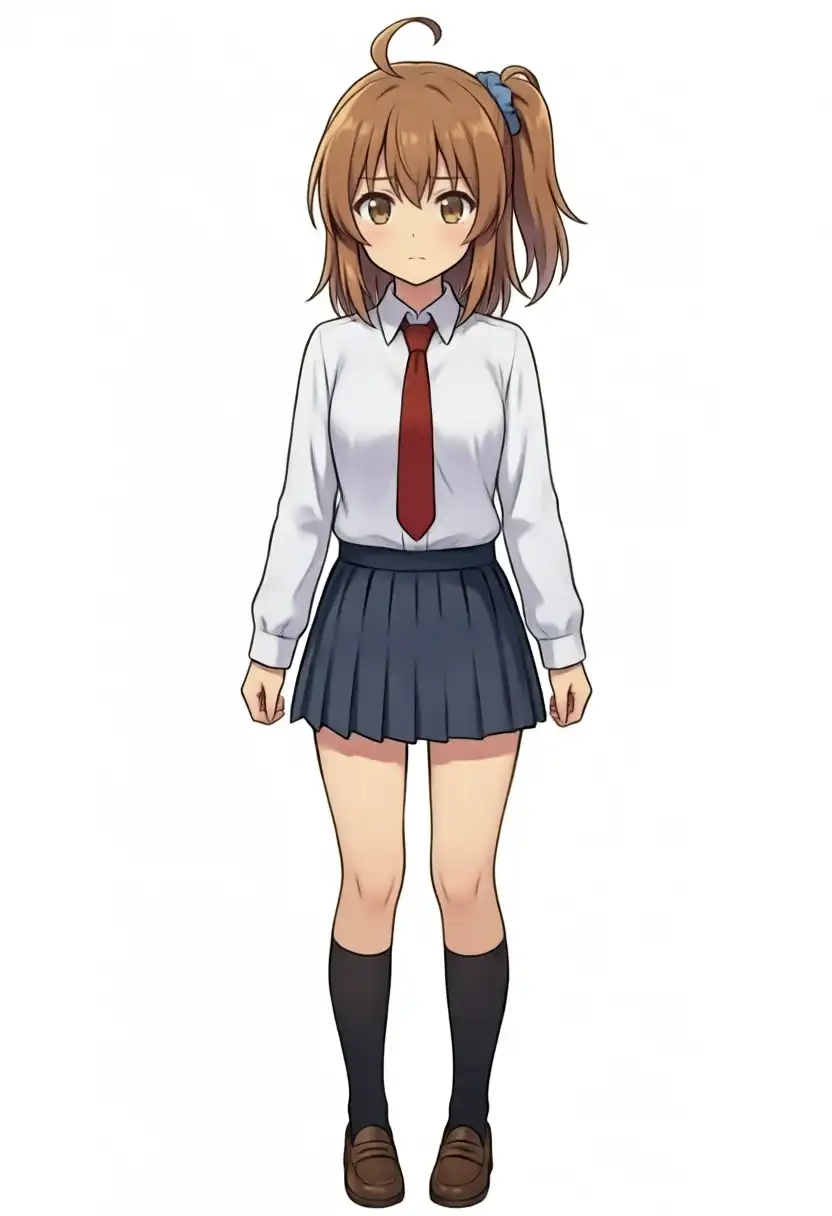
プロンプトは次の英文で、前回の編集で送ったものと同じ。
masterpiece, best quality, high quality, newest, year 2025, year 2024,
1girl, solo, the girl from image 1, keep her face, hairstyle and outfit exactly as in image 1,
strong high-angle overhead view, camera clearly above the subject looking steeply downward, visible top surfaces and pronounced top-down perspective. The subject is seen from the head toward the legs with the head visually nearer and larger than the lower body; the ground fills most of the background. The subject tilts her face upward and looks up into the camera.
生成コードの prompt をこの英文に変え、image=[Image.open("kana-front-arms-down-normal-s42.png").convert("RGB")] を指定した。
Image はPillowの from PIL import Image で読み込む。解像度832×1216、40ステップ、シード42、BF16は文章からの生成と共通にした。
ローカル側のCFGは1.0、ネガティブプロンプトは使っていない。前回のStudioでは画像編集にもネガティブプロンプトを指定しており、内部のステップ数やCFGは未確認のまま。
| 実行場所 | 指定 | 確認した結果 |
|---|---|---|
| 前回のStudio | 立ち絵の顔・髪型・服を維持して俯瞰へ変更 | サイドポニーと制服を残して上を見上げる。背景は灰色の地面 |
| 今回のM1 Max | 同じ英文と参照画像 | サイドポニー、青いシュシュ、制服を残して上を見上げる。白い背景で、足元に影が出た |
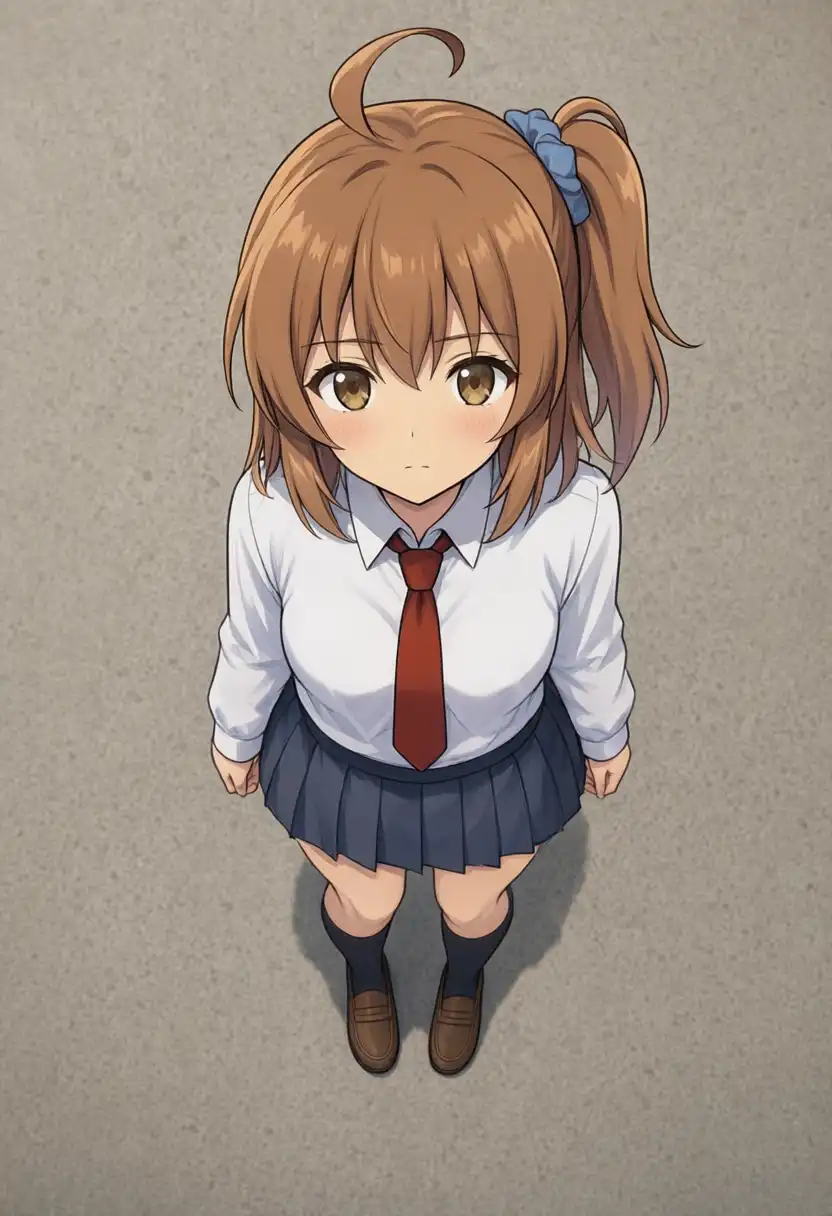
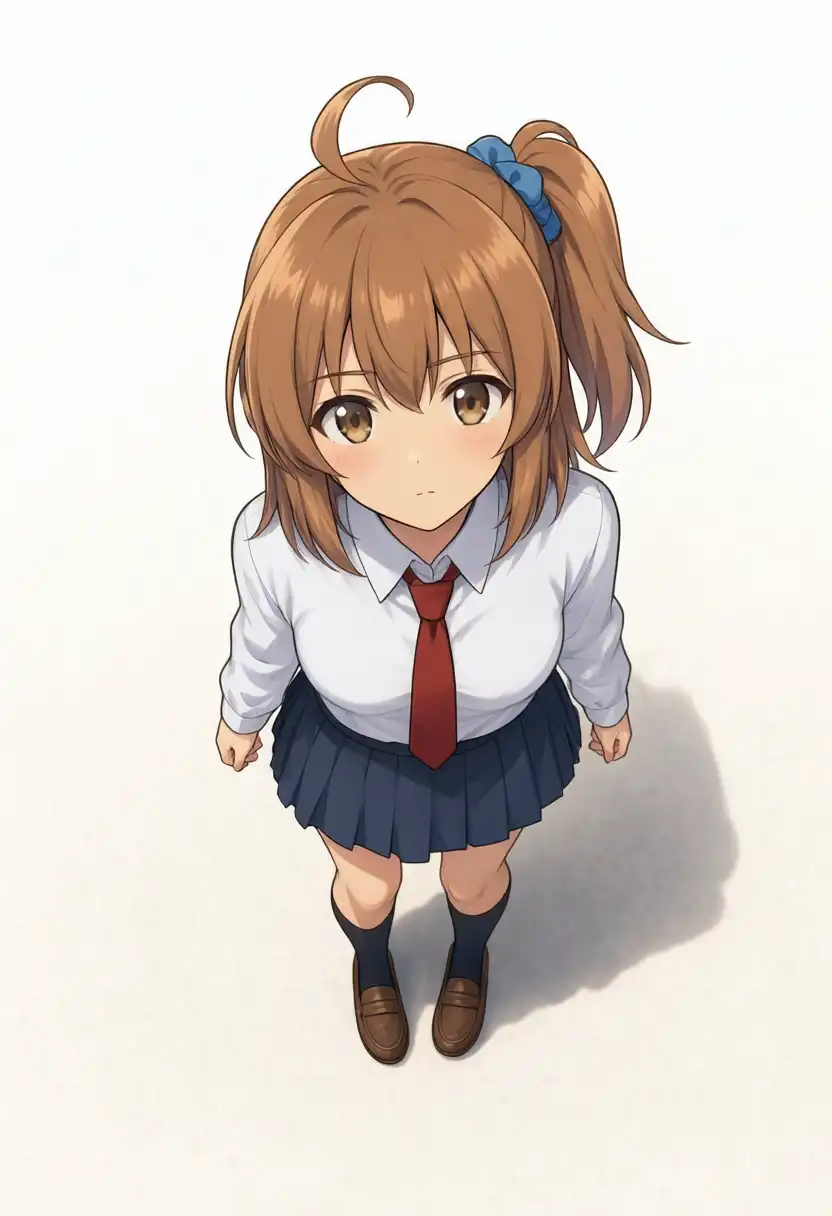
かなちゃんの画像編集でも、ローカル版は上から見下ろす構図になり、頭が手前に大きく描かれた。
描き込みはStudio版のシャツのしわや地面の質感が目立つが、ローカル版にも髪の細い線や目のハイライトがあり、差は文章から生成した2枚ほど大きくなかった。
時間とメモリは、前の節と同じ方法で記録した。
| 計測区間 | 参照画像を使う編集・832×1216 |
|---|---|
| CPUでのモデル読み込み | 1.64秒 |
| MPSへの転送 | 16.01秒 |
| 生成処理 | 721.22秒、約12分1秒 |
| モデル読み込み開始からPNG保存まで | 739.00秒、約12分19秒 |
| 2〜40ステップの平均 | 17.36秒 |
| GPU側の確保メモリ・記録上の最大 | 約49.0GB |
| システム全体のスワップ・開始時→終了時 | 約0.5MB→約0.5MB |
MPSドライバーの確保量は反復中約38.2GB、VAEの処理後に約49.0GBを記録した。スワップ使用量は約0.5MBのままだった。
かなちゃんの左右非対称な髪型は残るか
かなちゃんは本人の左側で髪を結んでいる。正面の元絵では画面右にあるサイドポニーが、向きやポーズを変えても本人の左側に残るかを試した。
入力は先ほどの俯瞰で使った正面の立ち絵。左右非対称な髪型を保てるかを中心に、手足の指定も確認した。
青いシュシュの位置で、髪を結ぶ側が元絵と同じかを確かめた。
832×1216・40ステップ・シード42・BF16・CFG1.0で、ネガティブプロンプトは使っていない。各条件1回だけなので、結果の揺れは未確認。
構図を変える3条件は、顔・髪型・服装を元絵のままにする英文を使った。ポーズを変える2条件では、サイドポニー・青いシュシュ・頭頂から立つアホ毛も保つように書いた。
右側からの条件は、英文内で食い違っていた画面上の向きを修正した。直した英文は末尾の折りたたみに載せた。
| 変えた指定 | 髪の左右・結び目(期待→結果) | 向き・手足の結果 |
|---|---|---|
| 真横(本人の左側から)。全身を画面左へ向け、顔や目線をカメラへ戻さない | 期待:本人の左側の結び目が手前側。 結果:結び目が後頭部に寄り、サイドポニーより普通のポニーテールに近い形になった | 全身が画面左を向いた横姿になり、顔も目線もカメラのほうを向かなかった |
| 真横(本人の右側から)。全身を画面右へ向け、顔や目線をカメラへ戻さない | 期待:本人の左側の結び目が奥側。 結果:サイドポニーの形は残ったが、結ぶ位置が本人の右側へ逆転した | 全身が画面右を向いた横姿になり、顔も目線もカメラのほうを向かなかった |
| 真後ろ。顔を出さず、カメラと反対へ向かせる | 期待:結び目が画面左。 結果:青いシュシュとサイドポニーが画面左に移り、本人の左側を維持した | 顔を出さず、頭から靴まで真後ろ向きの全身になった |
| ジャンプ。正面向き。右膝を上げ、左脚を下へ、右こぶしを真上、左腕を横へ | 期待:正面向きのまま、結び目は画面右。 結果:結び目は画面右のままで、本人の左側を維持した。髪の束は外側へなびいた | 右こぶしと右膝を上げたジャンプ姿になった。左腕は斜め下へ伸び、左脚は少し曲がった |
| 斜め向きで走る。画面左へ45度の向きで走る。右膝を上げ、左脚で後ろを蹴り、左腕を前・右腕を後ろへ | 期待:髪がなびいても、結ぶ側は本人の左側のまま。 結果:青い結び目は画面右にあるが、元絵より後頭部寄りに見える。髪の束は後ろへなびいた。本人の左側で結べているかは、この画像からは分からなかった | 画面左へ前傾して走るが、膝は高く上がらない。左腕が後ろ・右腕が前になり、腕は指定と逆 |
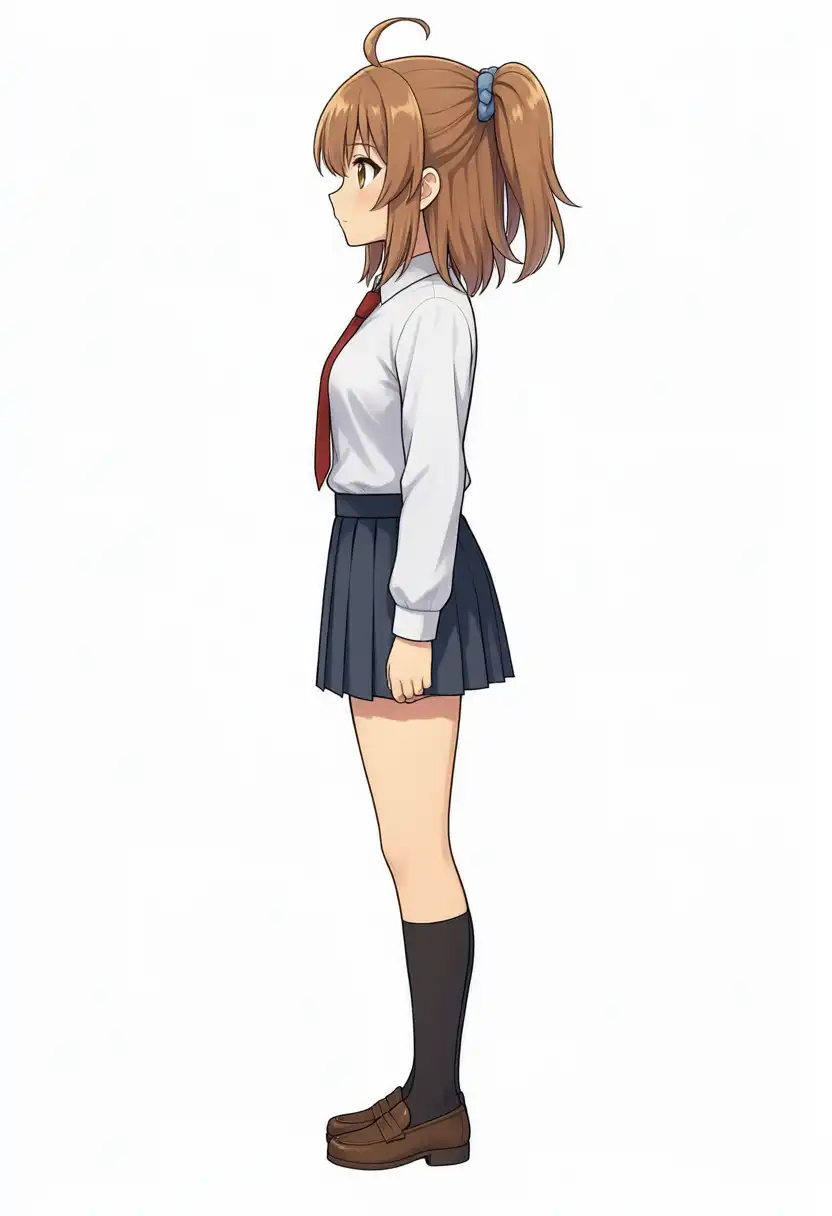
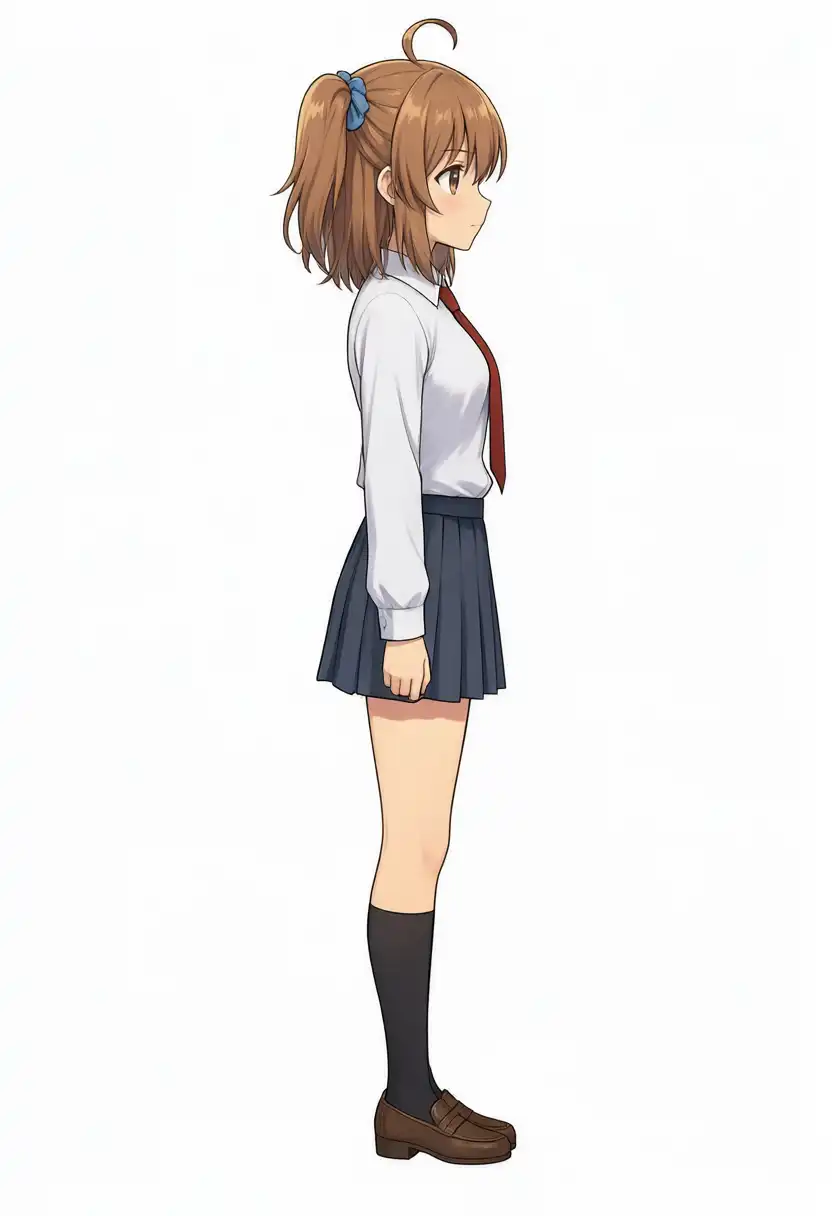
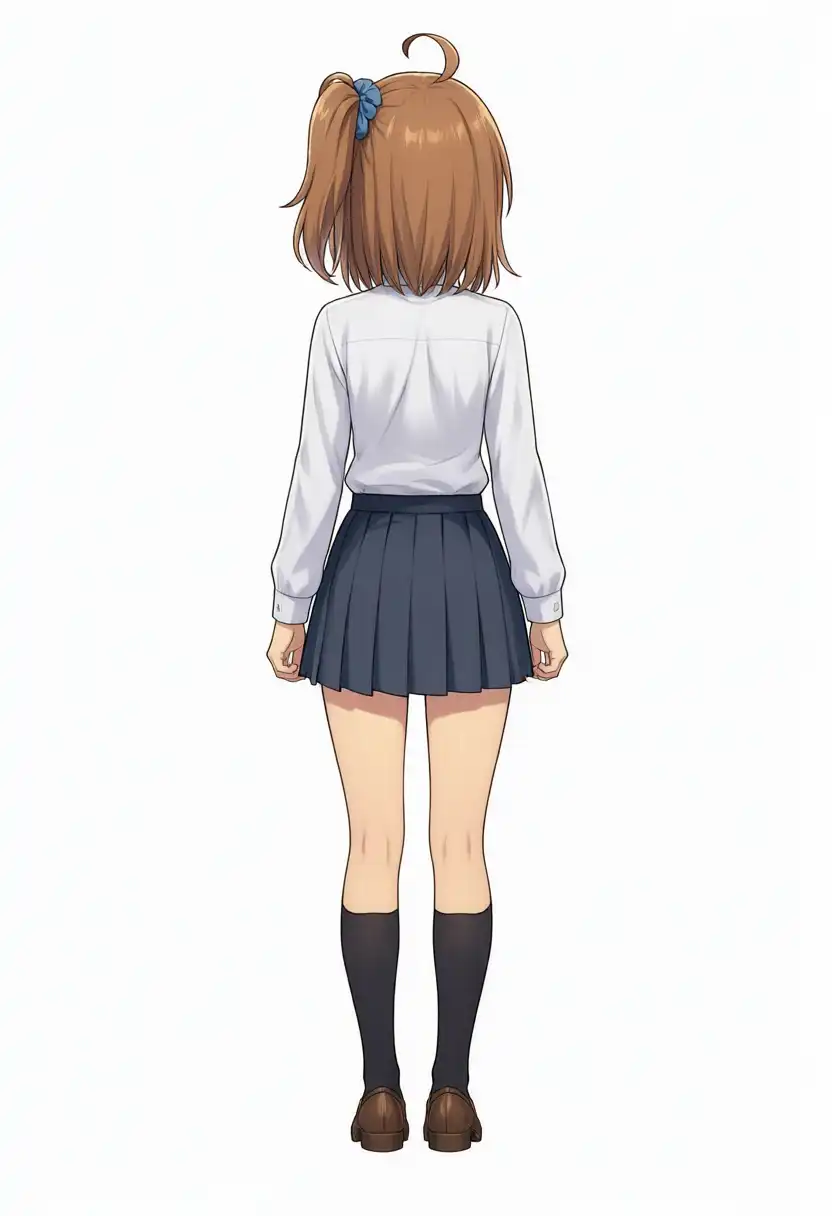
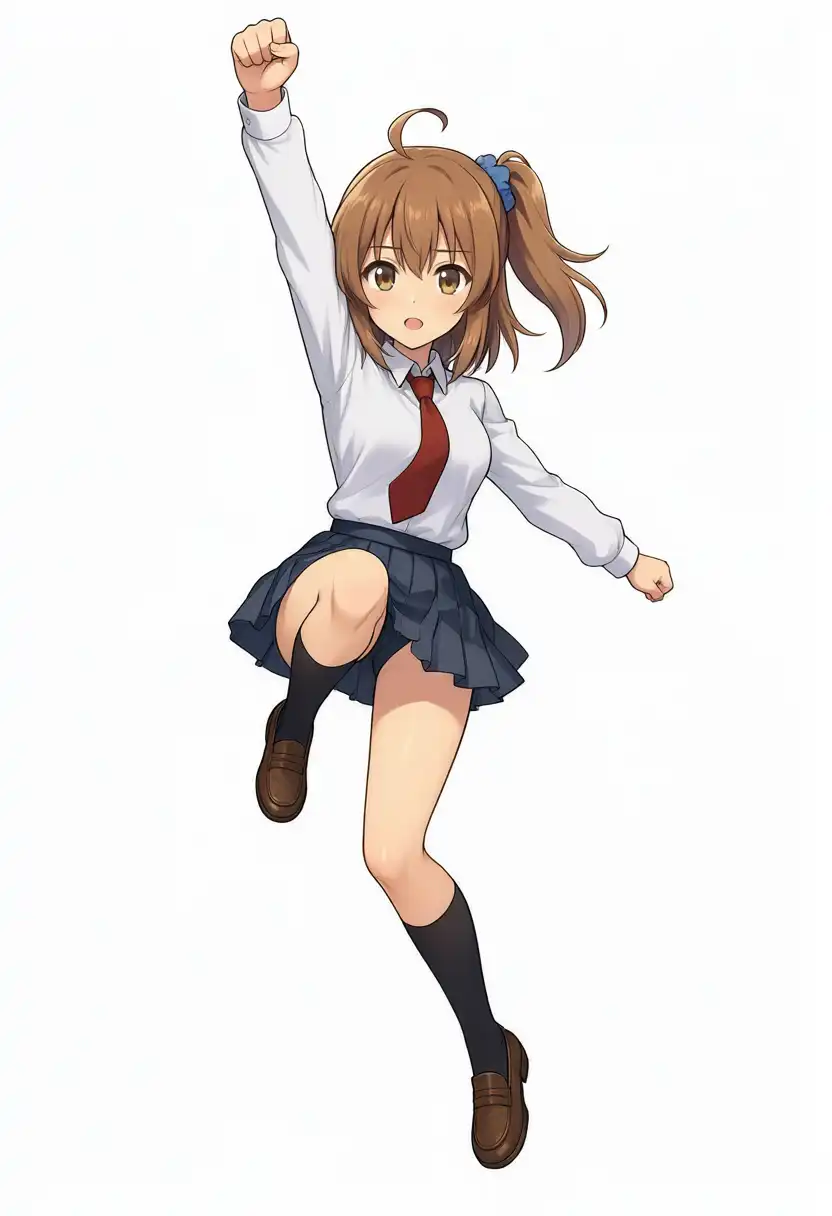
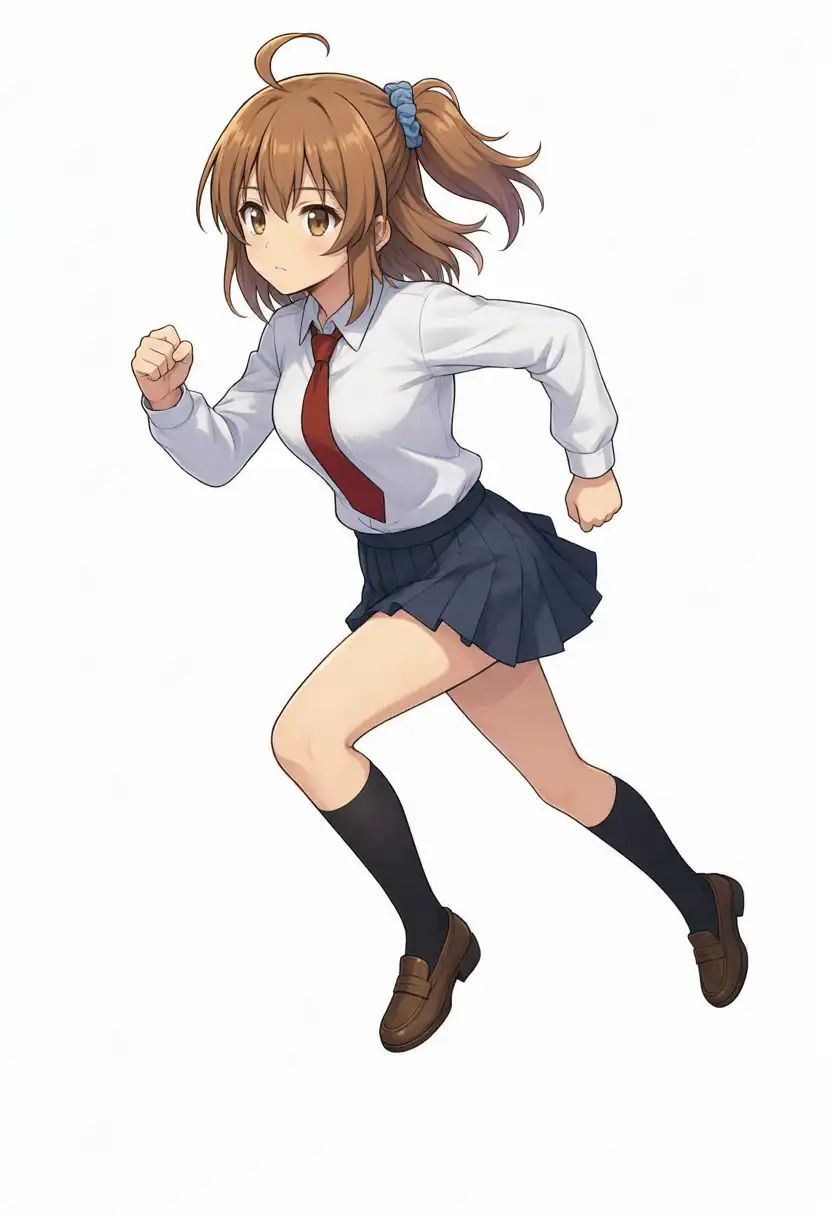
背面と正面向きのジャンプでは、本人の左側で髪を結ぶ形を保った。
今回の横向き2枚では、本人の右側からはサイドポニーの結ぶ側が逆になり、本人の左側からは普通のポニーテールに近い形になった。斜め走りは結び目が後頭部寄りになり、腕の前後も指定と逆だった。
| 条件 | 生成処理 | GPU側の確保メモリ・記録上の最大 |
|---|---|---|
| 真横(本人の左側から) | 719.15秒 | 約48.4GB |
| 真横(本人の右側から) | 707.13秒 | 約48.4GB |
| 真後ろ | 721.98秒 | 約49.0GB |
| ジャンプ | 710.83秒 | 約48.4GB |
| 斜め向きで走る | 712.18秒 | 約48.4GB |
構図・ポーズ変更で送った英文
真横(本人の左側から)
masterpiece, best quality, high quality, newest, year 2025, year 2024,
1girl, solo, the girl from image 1, keep her face, hairstyle and outfit exactly as in image 1,
from side, profile, exact orthographic 90-degree eye-level side view, camera at the subject's left side. Full body head to toe, flat left-facing silhouette. No head, body or gaze turn toward camera; no eye contact. Exact profile, never front or three-quarter.
真横(本人の右側から)
前回Studioで送った英文では、カメラを本人の右側に置く指定と、画面左向きの輪郭の指定が食い違っていた。今回は輪郭の指定を left-facing から right-facing に直した。
masterpiece, best quality, high quality, newest, year 2025, year 2024,
1girl, solo, the girl from image 1, keep her face, hairstyle and outfit exactly as in image 1,
from side, profile, exact orthographic 90-degree eye-level side view, camera at the subject's right side. Full body head to toe, flat right-facing silhouette. No head, body or gaze turn toward camera; no eye contact. Exact profile, never front or three-quarter.
真後ろ
masterpiece, best quality, high quality, newest, year 2025, year 2024,
1girl, solo, the girl from image 1, keep her face, hairstyle and outfit exactly as in image 1,
direct rear view, eye-level camera positioned directly behind the subject, with zero camera roll. Full body from head to toe in a centered rear-view composition. Show only the back of the head, torso, arms, legs and shoes; do not show the face. The subject looks straight ahead away from the camera.
ジャンプ
masterpiece, best quality, high quality, newest, year 2025, year 2024,
1girl, solo, the girl from image 1, keep her face, hairstyle, side ponytail with the blue scrunchie, ahoge, eye color, outfit and white background exactly as in image 1,
change only her pose: a dynamic mid-air jump facing the viewer. Both feet are high off the ground, her right knee is pulled up high and her left leg stretches down, her right fist punches straight up toward the sky and her left arm swings out to the side. Full body from head to toe.
斜め向きで走る
masterpiece, best quality, high quality, newest, year 2025, year 2024,
1girl, solo, the girl from image 1, keep her face, hairstyle, side ponytail with the blue scrunchie, ahoge, eye color, outfit and white background exactly as in image 1,
change only her pose: three-quarter view, not frontal. Her body and face are turned about 45 degrees toward the viewer's left, so her left side is visible. She is sprinting toward the viewer's left: her body leans far forward, her right knee is driven up high, her left leg pushes off behind her with only the toes touching the ground, her left arm swings forward and her right arm swings back with bent elbows. Full body from head to toe.
Anima・Illustriousと同じプロンプトで生成してみた
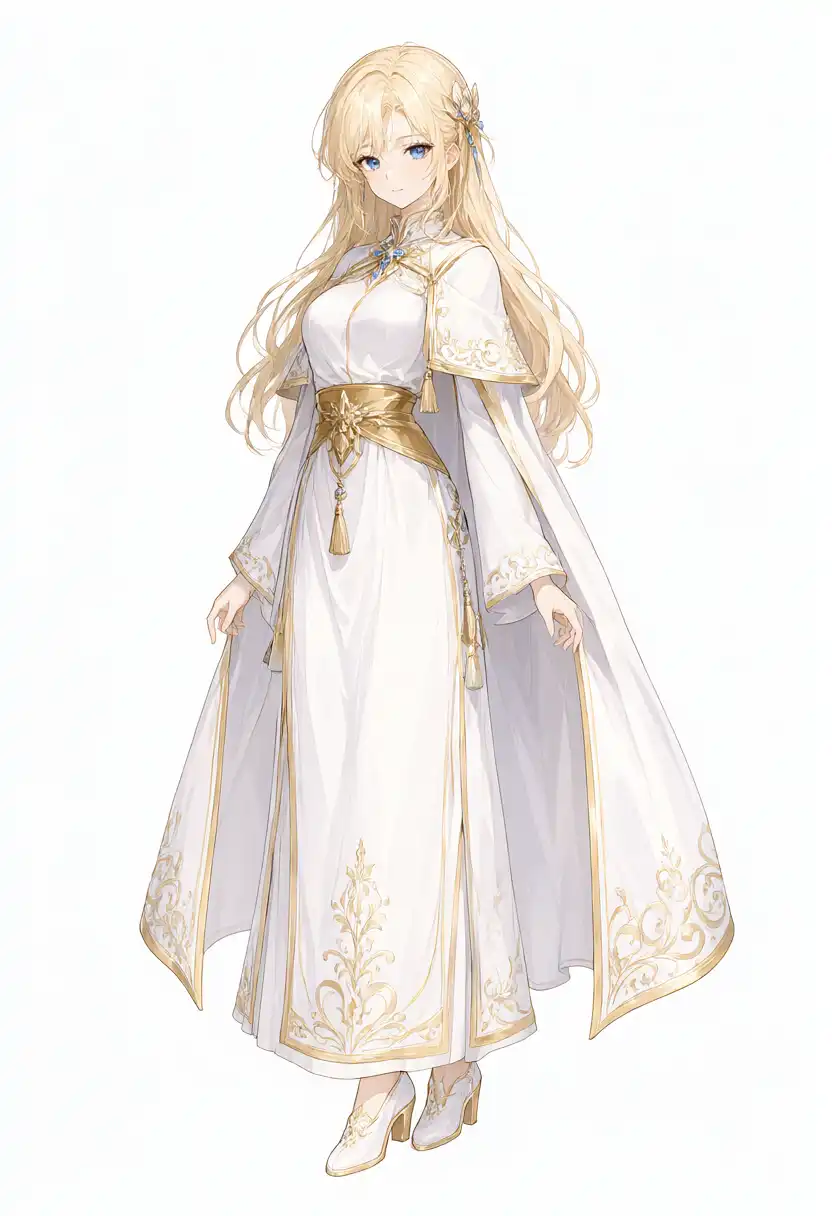
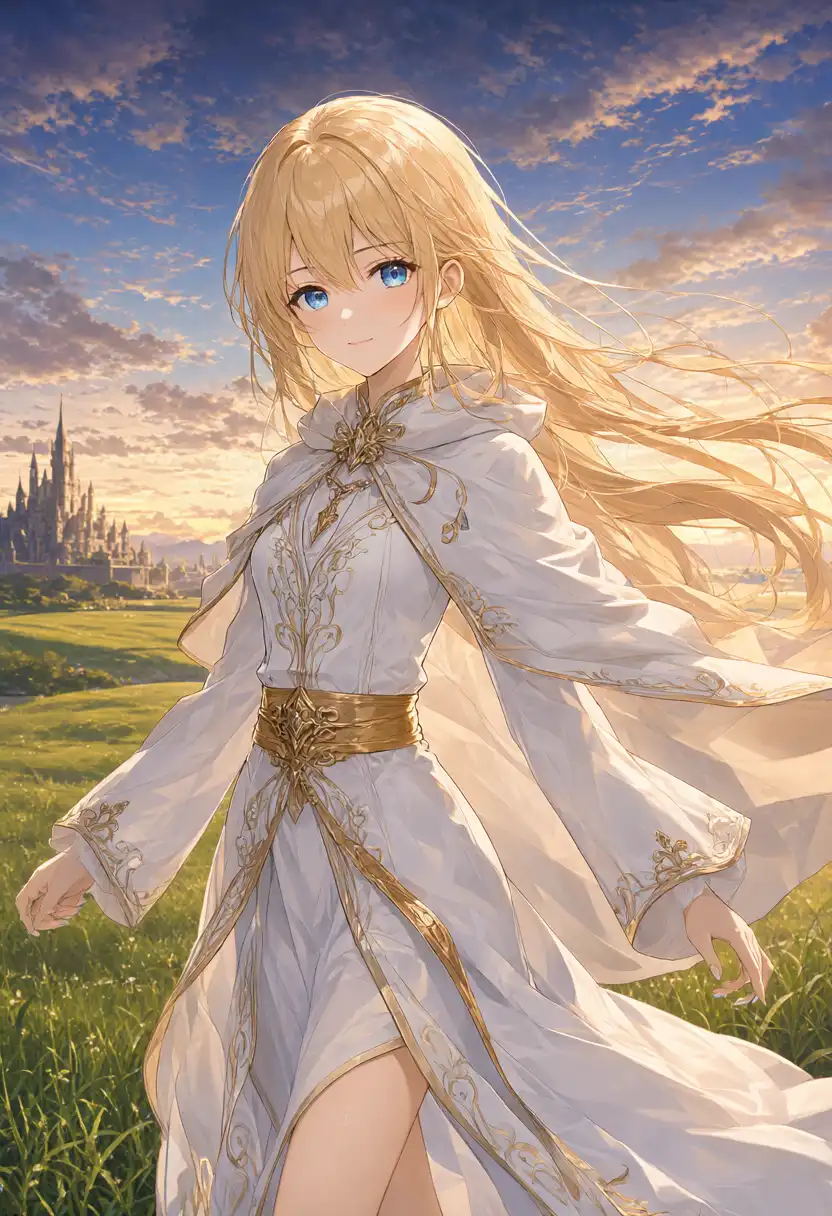
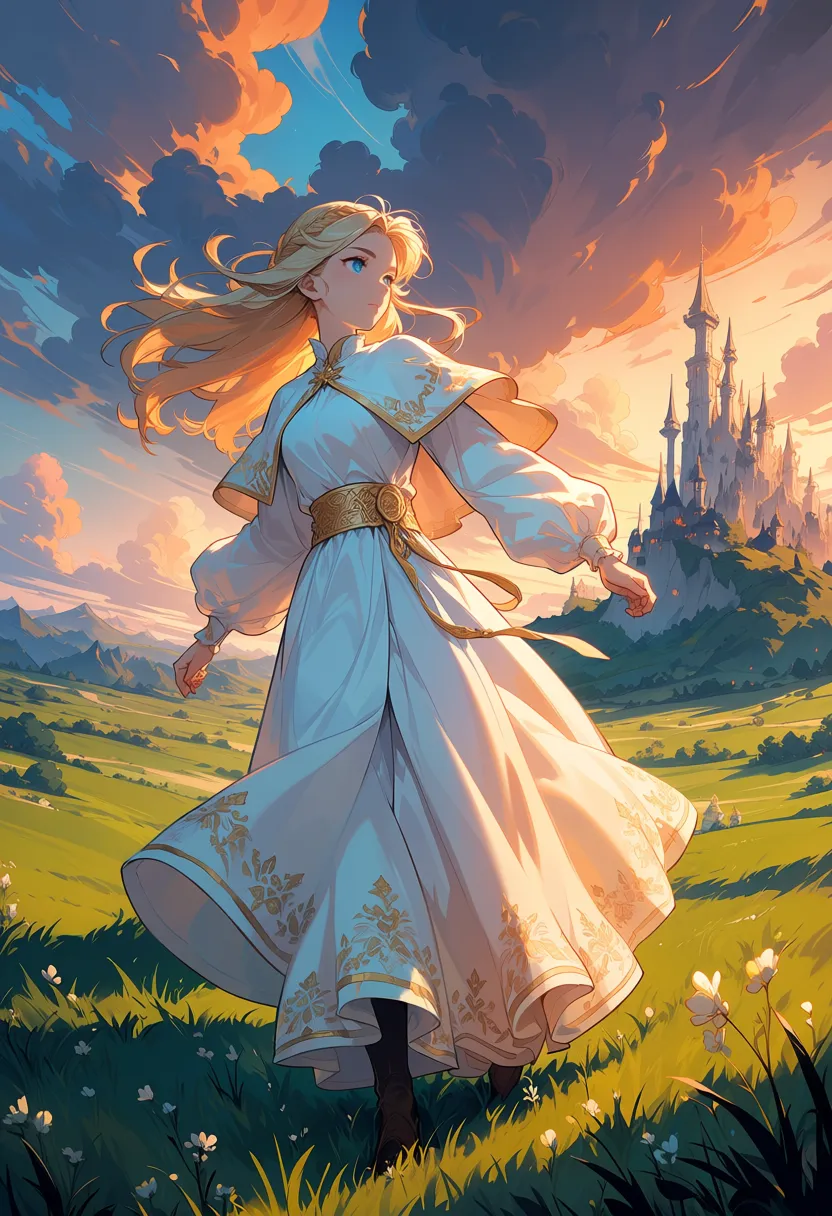
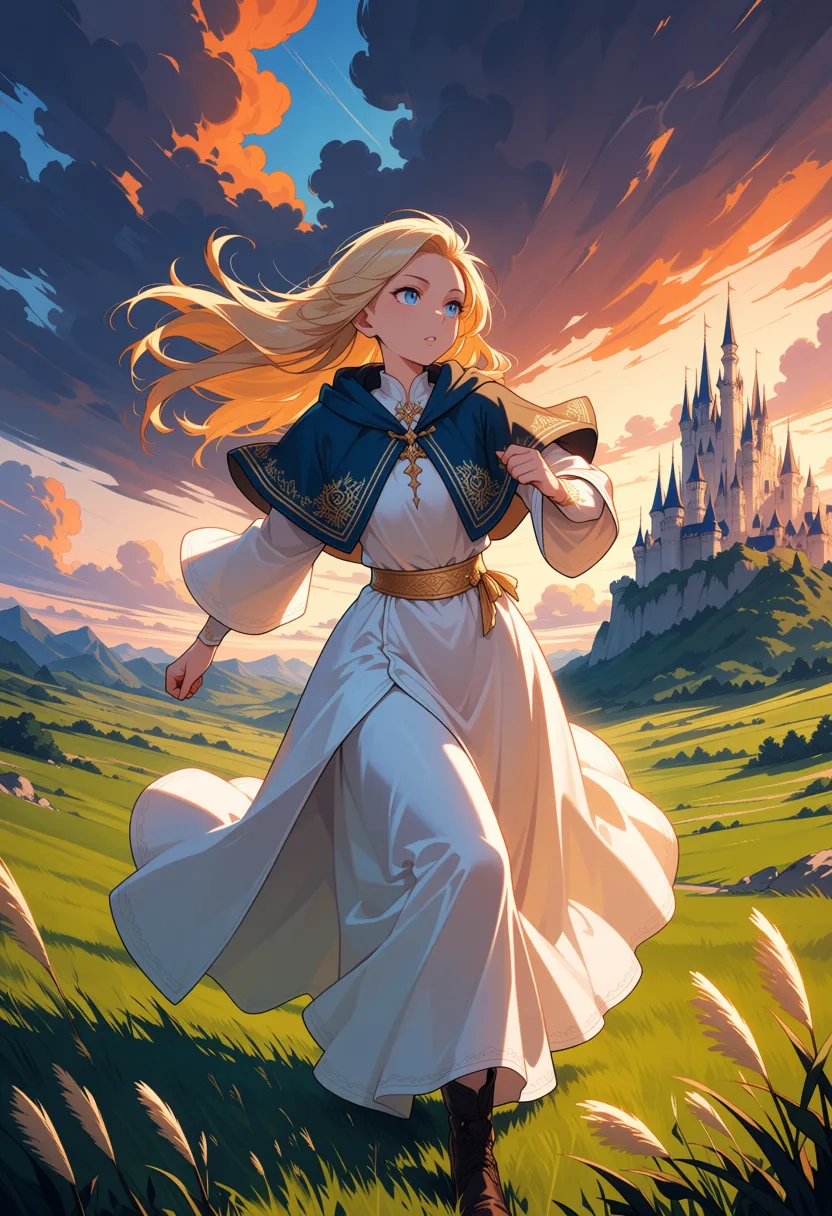
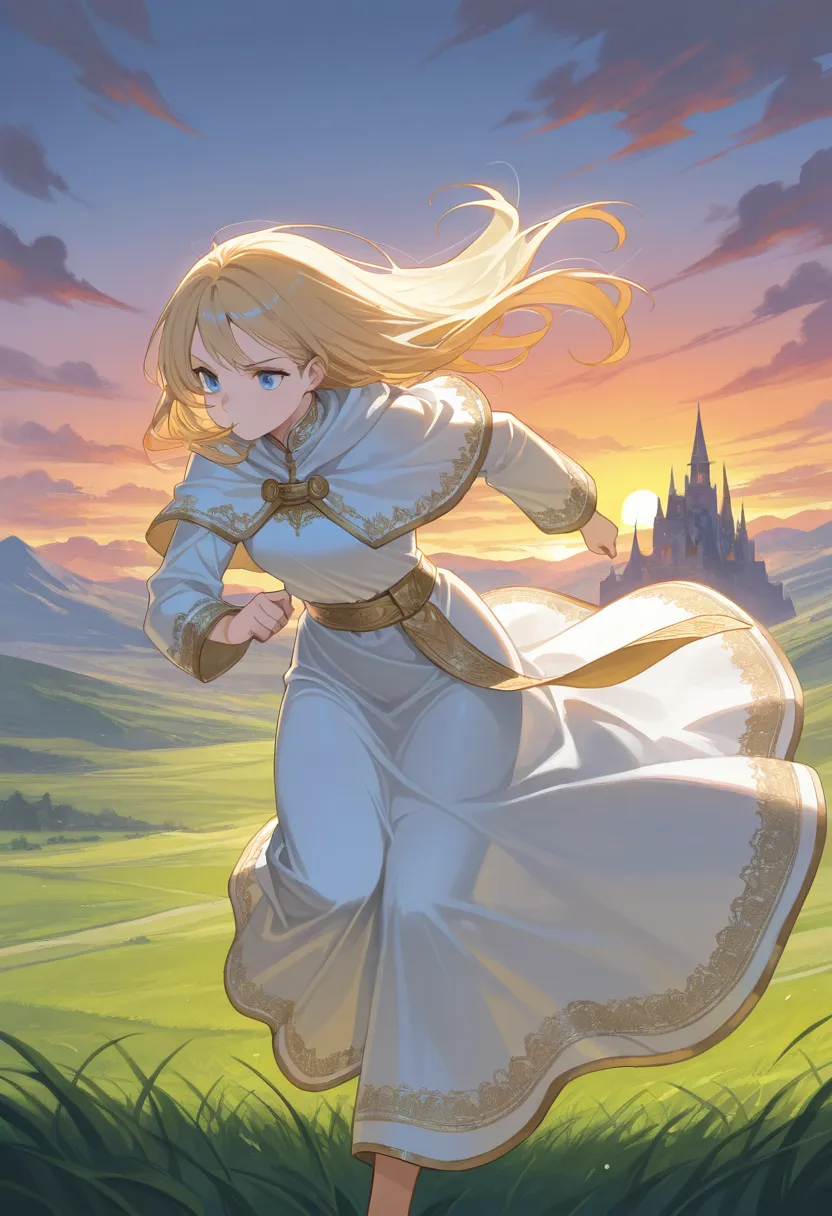
WAI-Animaを試した記事と同じ英語プロンプト・832×1216・シード42で、白と金のローブの立ち絵と、夕暮れの城を背景に走る場面をQwen-Image 2.1でも生成した。
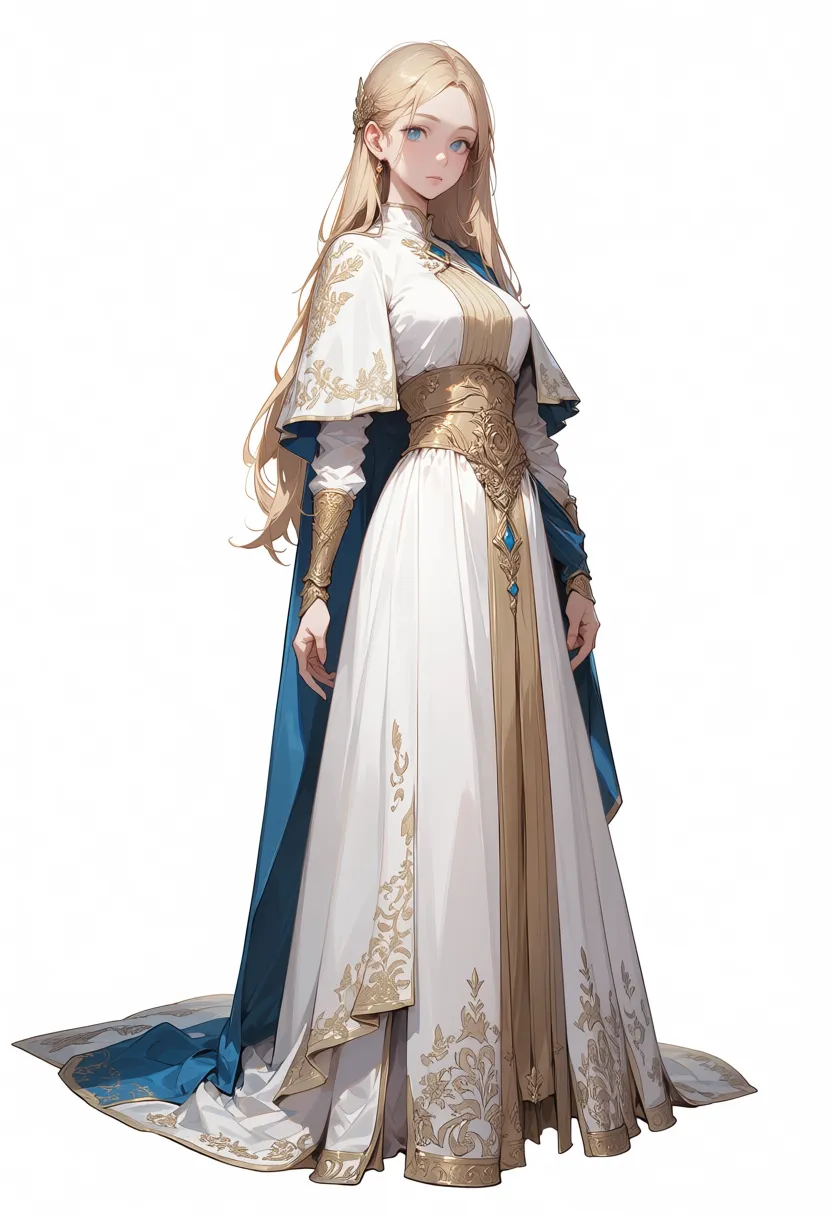
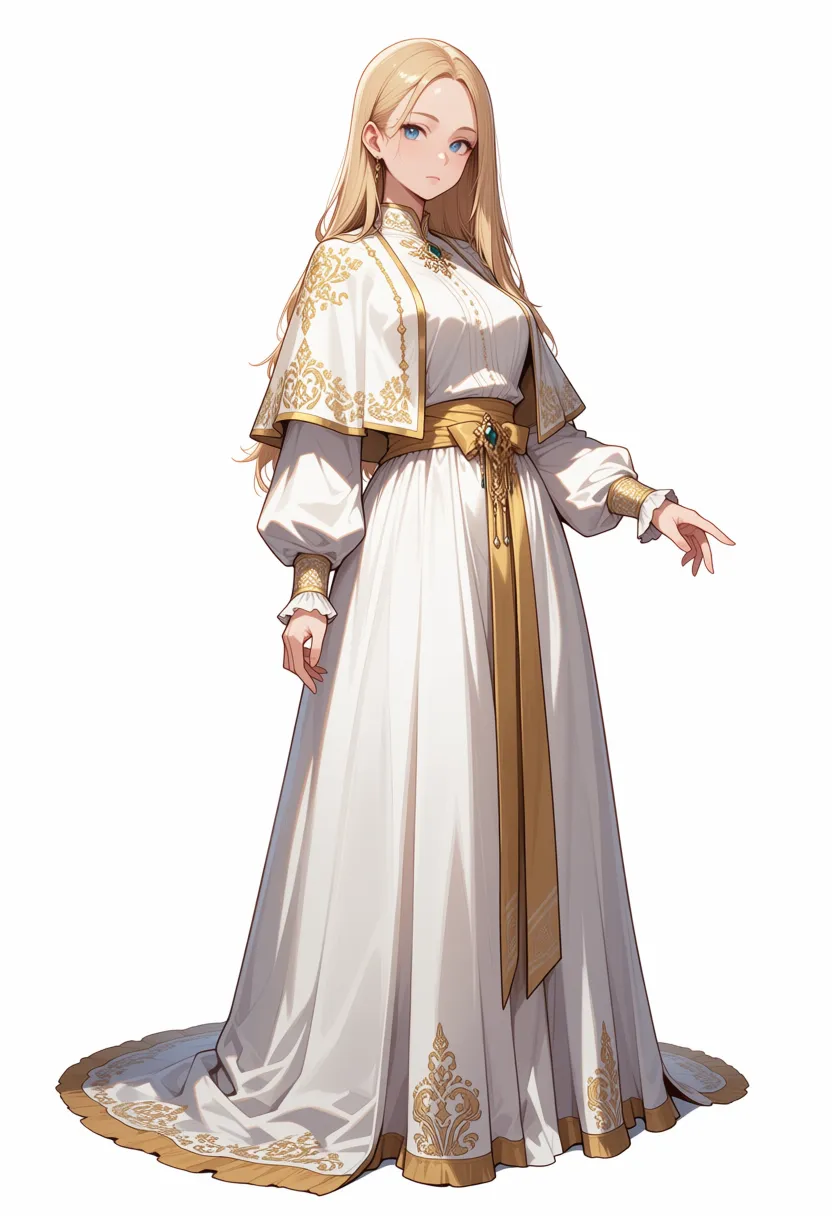
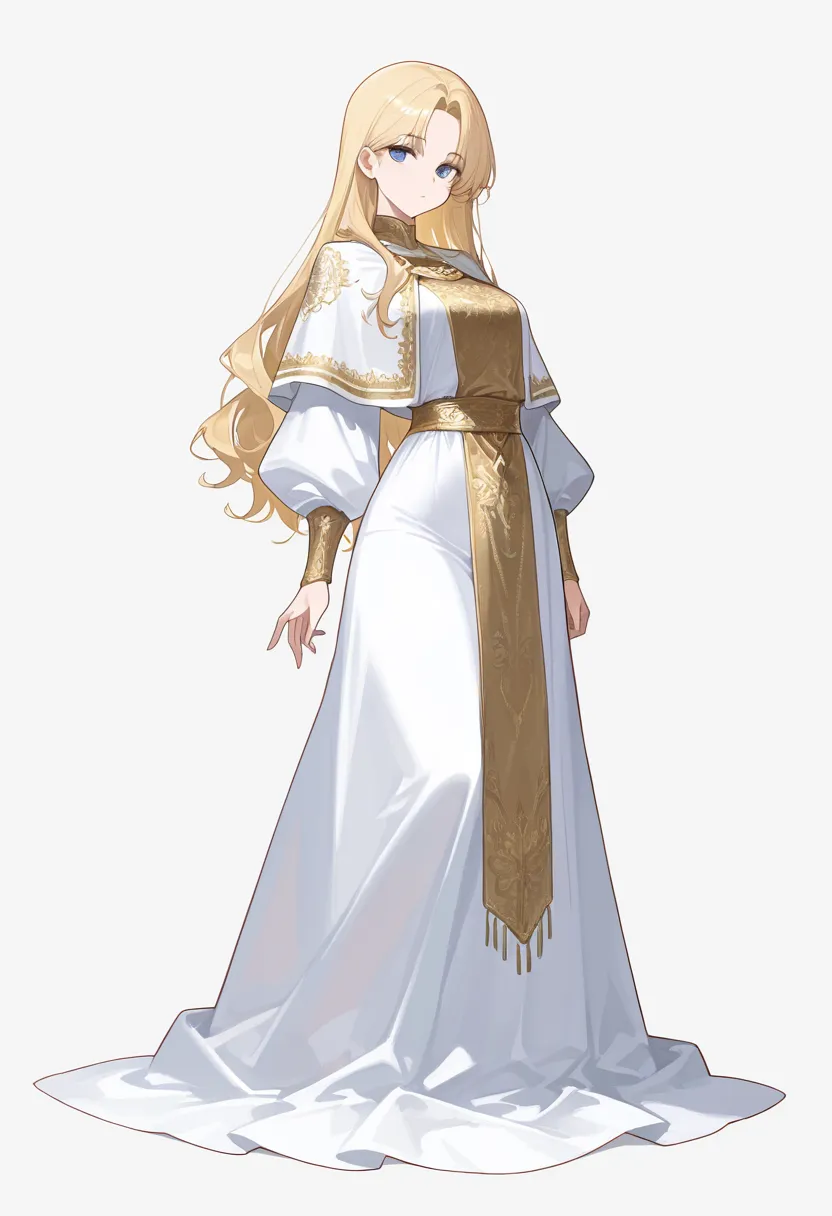
Anima preview3-base、WAI-Anima v1、WAI-Illustrious v160の3モデルは、4月16日の記事の出力をそのまま並べた。今回は再生成していない。
Qwenの欄はDiffusersのクラス名、過去3モデルの欄はサンプラーとスケジューラーを順に書いた。
| モデル | 出力の時期 | ステップ / CFG | サンプラー / スケジューラー |
|---|---|---|---|
| Qwen-Image 2.1 | 今回 | 40 / 1.0 | FlowMatchEulerDiscreteScheduler |
| Anima preview3-base | 4月16日の記事 | 30 / 4.0 | er_sde / simple |
| WAI-Anima v1 | 4月16日の記事 | 30 / 4.0 | er_sde / simple |
| WAI-Illustrious v160 | 4月16日の記事 | 25 / 5.0 | euler_ancestral / karras |
過去3モデルのネガティブプロンプトは4月の記事に記録がない。ステップ数やCFGもモデルごとに違う。
白背景の立ち絵
(今回)
(4月の出力)
(4月の出力)
(4月の出力)
| モデル | 画像で確認したこと |
|---|---|
| Qwen-Image 2.1 | 白と金のローブで、肩布・袖口・裾に細い刺繍がある。髪は細い毛束に分かれ、青い髪飾りと首元の飾りも描かれた。裾が地面より上にあり、靴まで見える。 |
| Anima preview3-base | 白と金の衣装に、指定していない青い布が内側と裾へ加わった。金の刺繍と腰まわりの飾りが細かい。 |
| WAI-Anima v1 | 白と金のローブで、肩布と裾に刺繍がある。首元と腰に青緑色の飾りがある。 |
| WAI-Illustrious v160 | 白と金のローブと長い金色の前垂れ。Anima系2枚より塗り分けが大きく、服の影が淡い。 |
Qwenの立ち絵は、Anima系2枚より顔や服の影が淡く、髪の線が細い。WAI-Illustriousも淡い塗りだが、Qwenは肩布・袖・裾の模様が細かく、金の前垂れを大きく描いたIllustriousとは衣装の形も違う。
4モデルで使った同じプロンプト
1girl, solo, long blonde hair, blue eyes, white robe, gold embroidery, capelet, gold sash, long sleeves, long dress, standing, looking at viewer, full body, white background城と夕景を背景に走る人物
(今回)
(4月の出力)
(4月の出力)
(4月の出力)
| モデル | 画像で確認したこと |
|---|---|
| Qwen-Image 2.1 | 白と金のローブで、髪と布が大きくなびく。細い草や小さな雲まで描かれた。人物が大きく、膝下は画面外。腕は下がったままで、走っている感じは薄い。 |
| Anima preview3-base | 夕焼けの雲、草地の起伏、遠くの城を描いた。髪と裾はなびくが、腕を下ろした姿で、走っている感じはあまりしない。 |
| WAI-Anima v1 | 腕を曲げて走る姿になり、夕焼けと草地の影が細かい。立ち絵では白かった肩布が紺色に変わった。 |
| WAI-Illustrious v160 | 前傾して走る姿で、白と金の配色は残った。裾と髪が大きくなびき、城や草地の形はAnima系より描き込みが少ない。 |
走るポーズは、腕を振るWAI-Animaと前傾するWAI-Illustriousのほうが、腕を下ろした今回のQwenより走っているように見える。
4モデルで使った同じプロンプト
1girl, solo, long blonde hair, blue eyes, white robe, gold embroidery, capelet, gold sash, long sleeves, long dress, running, wind, hair blowing, dynamic pose, fantasy landscape, castle in background, sunset sky, dramatic clouds, grass fieldi2i(WAI-IL → Qwen)
4月の記事では、WAI-Illustrious v160とかなちゃんLoRAで出した立ち絵を、Anima系にdenoise 0.5のi2iで通した。
同じ元画像をQwen-Image 2.1にも入力した。
今回使ったDiffusersの QwenImage21Pipelineには、元画像をどれだけ崩すかを決めるdenoise(strength)の引数がない。
参照画像を渡して文章で指示する編集になるので、「顔・髪型・衣装・ポーズ・構図・背景を元のまま描き直す」と英文で指定した。
Anima系のdenoise 0.5とは仕組みが違う比較になる。
元画像は背景に金色の円が入った立ち絵で、青いシュシュでサイドポニーを結んでいる。
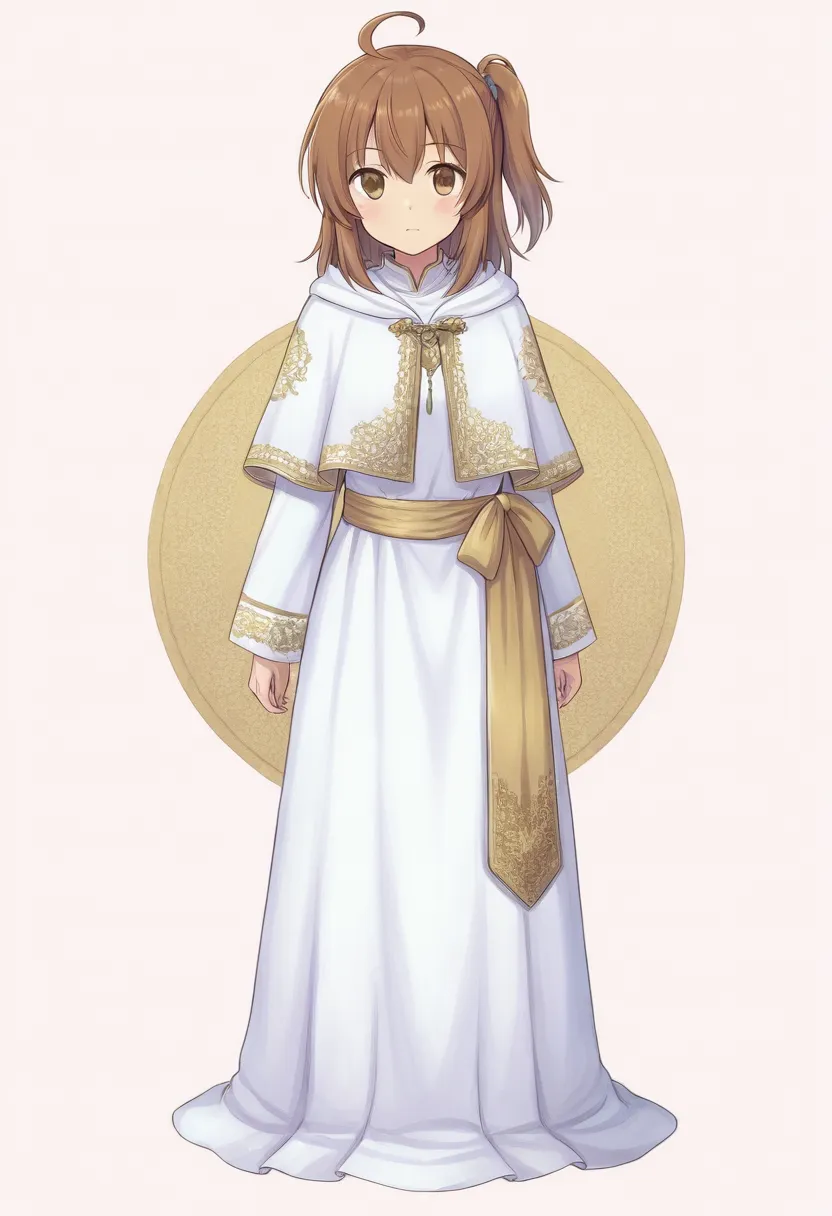
(今回)
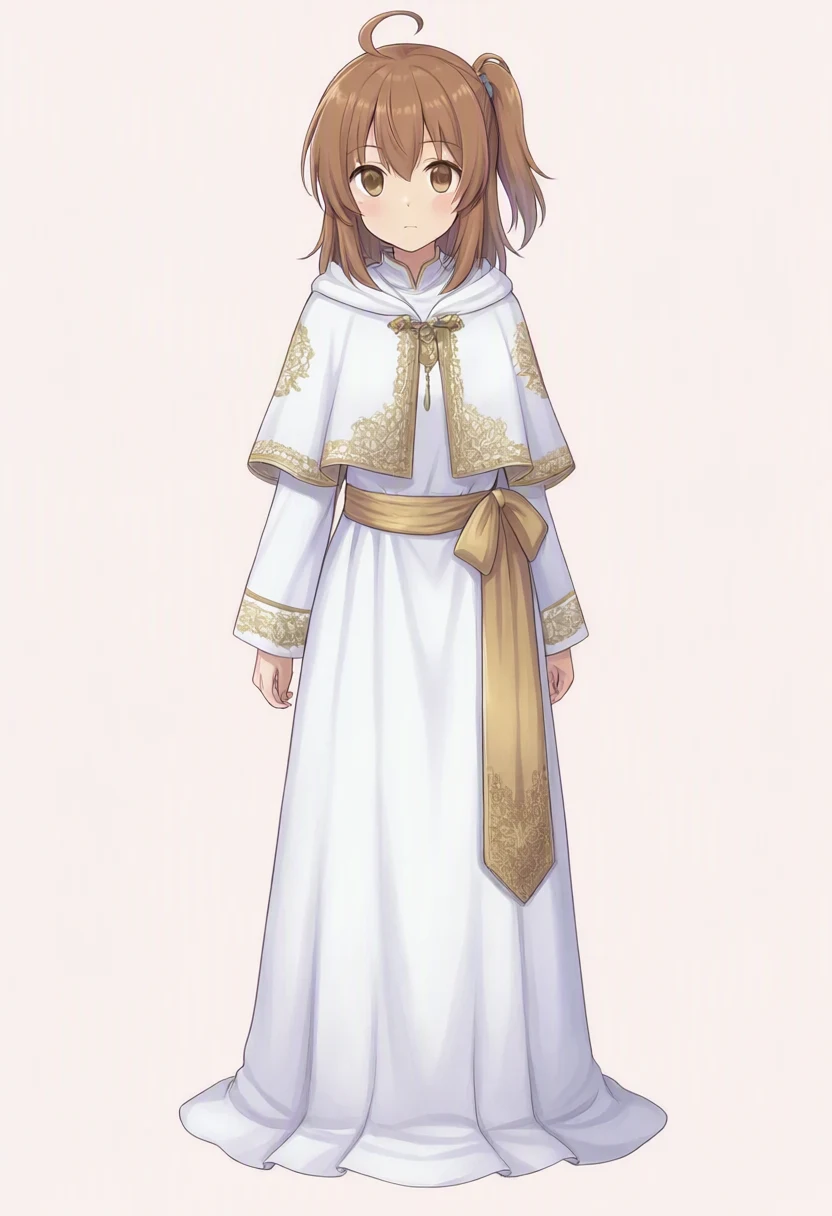
(4月の出力)
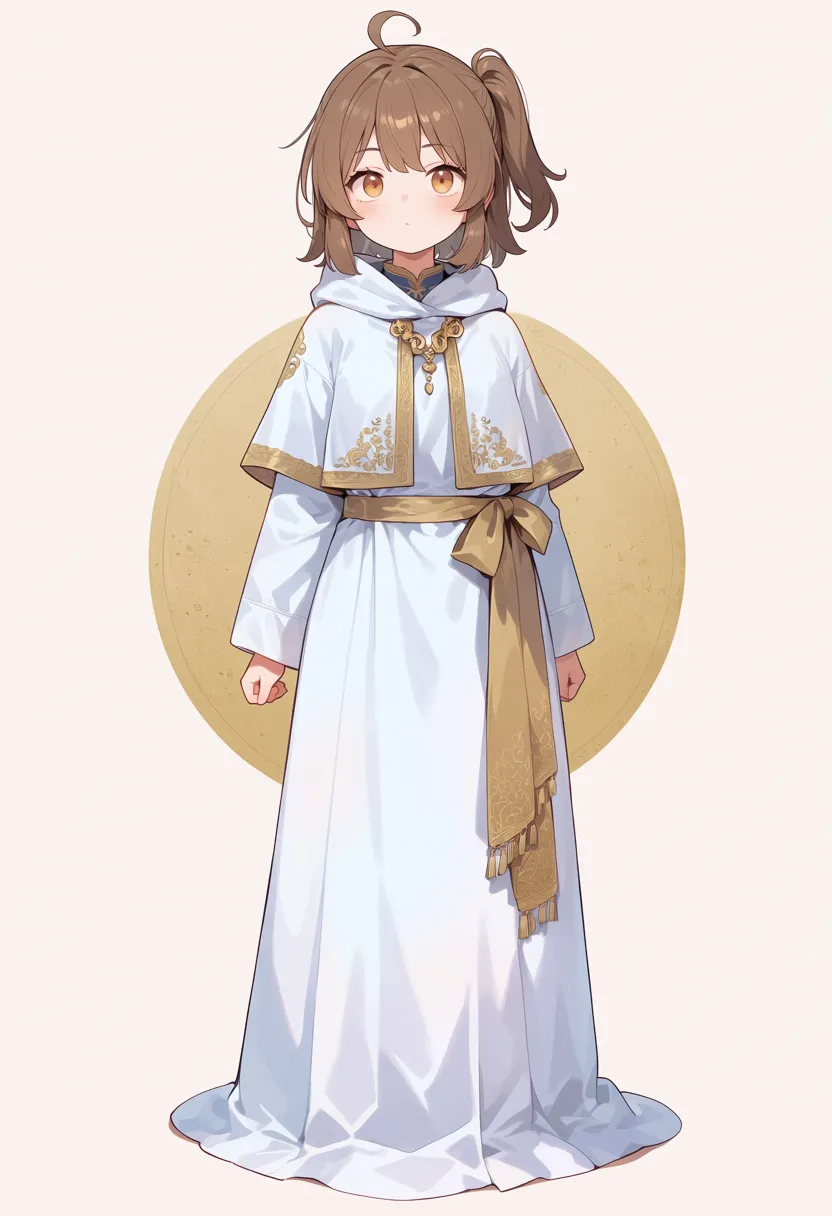
(4月の出力)
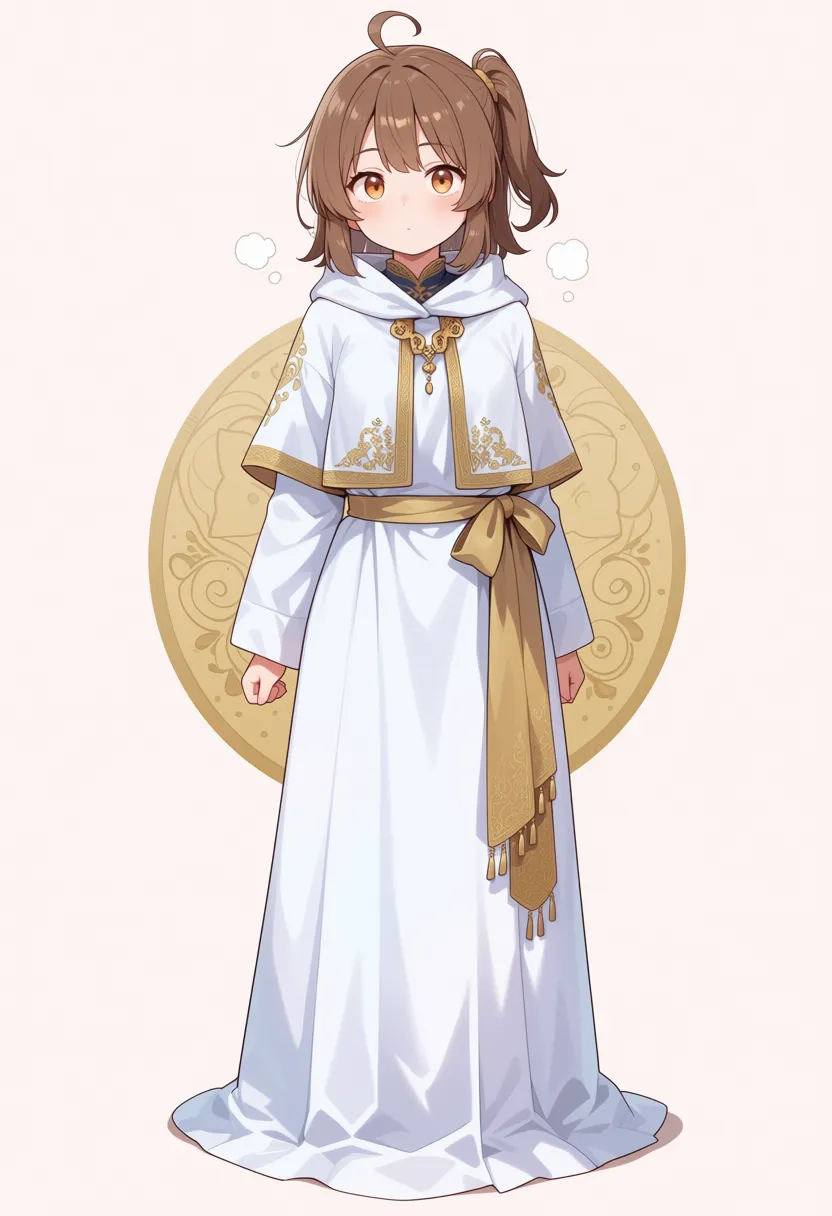
| モデル | 画像で確認したこと |
|---|---|
| Qwen-Image 2.1 | 顔の丸さ・目の描き方・髪色・青いシュシュは元画像とほぼ同じ。背景の金色の円は、残す指定をしたのに消えて無地になった。 |
| Anima preview3-base | 顔が丸くなり幼く見える。サッシュにフリンジが付き、シュシュはほぼ消えた。背景の円は模様が薄れた。 |
| WAI-Anima v1 | preview3-baseと同じく顔が丸くなった。シュシュは別の色で入り、背景の円にはっきりした模様が入った。口元の左右に白いもやが出た。 |
Anima系の2枚は顔が丸くなり、元画像より幼い印象になった。Qwenの顔は元画像とほとんど同じだった。
一方で、背景の金色の円はQwenの出力だけ消えた。生成処理は672.00秒かかった。
Qwen-Image 2.1に送った英文
Redraw image 1 as a new illustration. Keep the same girl, her face, brown hair with the side ponytail and blue scrunchie, the white robe with gold embroidery, capelet and gold sash, the standing pose, the composition and the background exactly as in image 1.4モデルの生成速度
4月の記事の速度表に、今回のQwen-Image 2.1を1行足した。
同じM1 Maxだが、4月の3モデルはComfyUI、QwenはDiffusersで動かしていて、ステップ数も違う。
| モデル | ステップ | 立ち絵 | 走る場面 | 1ステップあたり(立ち絵) |
|---|---|---|---|---|
| Qwen-Image 2.1 | 40 | 588秒 | 584秒 | 約14.7秒 |
| Anima preview3-base | 30 | 275秒 | 277秒 | 約9.2秒 |
| WAI-Anima v1 | 30 | 277秒 | 274秒 | 約9.2秒 |
| WAI-Illustrious v160 | 25 | 217秒 | 337秒 | 約8.7秒 |
1枚あたりではAnima系の2倍強かかった。
生成時間をステップ数に比例させて単純に換算すると、Animaと同じ30ステップでも約440秒になる。
おまけ: NSFW出力テスト
ここから先はテスト出力した画像がセンシティブな可能性があるため、画像自体をぼかしています。出力のちゃんとした結果が見たい場合には、手元の環境でお試しください。
4月の記事のおまけと同じ2種類のプロンプトを、Qwen-Image 2.1でも生成した。条件は立ち絵・走る場面と同じで、ネガティブプロンプトは使っていない。
表の4月の3モデルの行は、4月の記事の記録をそのまま載せた。
nsfwタグなし
nsfw タグを入れずに全裸指示だけ出した場合にどうなるか。
(今回)
(4月の出力)
(4月の出力)
(4月の出力)
| モデル | 画像で確認したこと |
|---|---|
| Qwen-Image 2.1 | 正面を向いて水辺の木の板に座り、胸や股間を隠していない。写真のような実写調で出た。 |
| Anima preview3-base | 全裸だが、胸や股間を隠す構図。 |
| WAI-Anima v1 | 全裸だが、胸や股間を隠す構図。 |
| WAI-Illustrious v160 | 全裸だが、胸や股間を隠す構図。 |
立ち絵と走る場面は、同じ 1girl 始まりのタグでアニメ絵になっていた。画風を指定するタグはどれにも入れていないが、今回の1枚では実写になった。生成処理は555.78秒。
4モデルで使った同じプロンプト
1girl, solo, long blonde hair, blue eyes, completely nude, naked, bare skin, sitting on edge of spring, feet in water, forest, natural light, serene, full body, looking at viewernsfwタグあり(正面全身)
nsfw タグを追加して正面全身で出すとどうなるか。
(今回)
(4月の出力)
(4月の出力)
(4月の出力)
| モデル | 画像で確認したこと |
|---|---|
| Qwen-Image 2.1 | アニメ絵で、正面を向いた全裸の立ち姿。胸は大きめに描かれ、股間は線を省いたなめらかな形。文字は出ていなかった。 |
| Anima preview3-base | 正面全裸。顔と体型がアメコミ調になり、立ち絵とは別人の印象。 |
| WAI-Anima v1 | 正面全裸。立ち絵と同じキャラに見えるが、胸が大きく、右下に @Pagex.com のウォーターマークが出た。 |
| WAI-Illustrious v160 | 正面全裸。立ち絵・走る場面と同じキャラに見える。 |
4月の記事では、WAI-IllustriousとWAI-Anima v1は服を着た立ち絵と裸の画像が同じ顔に見えた。
Qwenの白背景の立ち絵は切れ長の目の大人びた顔だったが、この画像は目が大きく丸い顔で、別の絵柄になった。生成処理は557.42秒。
4モデルで使った同じプロンプト
1girl, solo, long blonde hair, blue eyes, completely nude, naked, bare skin, nsfw, straight-on, full body, standing, white background