画像1枚から3Dを作るIdolはCUDA無しのM1 Maxでも動いた、1回7分
 目次
10月末に、SperidlabsがIdolという画像→3D生成モデルを公開した。
画像を1枚入れると、物体の見えていない側まで含めた3D Gaussian Splatを出力する。
3D Gaussian Splat(元の論文)は、色と透明度を持った小さな楕円体(Gaussian)を何十万個も空間に置いて立体を表す形式で、メッシュのような面ではなく点の集まりとして描画される。
READMEのインストール手順には「an NVIDIA GPU with CUDA」と書かれている。
手元はM1 Max 64GBのMacBook Proで、CUDAは無い。
PyTorchはApple SiliconのGPUをMPS(Metal Performance Shaders)経由で動かす機能があるため、CUDAが無くてもMacのGPUを使って計算できる。
CUDAが無くても動くのか、動くならうちのキャラクターのかなちゃんの立ち絵を3Dにできるのかを試した。
Idolの基本情報
モデルカードとSDKのREADMEに書かれている内容を表にした。
| 項目 | 内容 |
|---|---|
| 配布 | speridlabs/idol(Apache-2.0)。コードは speridlabs/idol-sdk |
| 入力 | 画像1枚。背景除去と切り抜きはパイプライン内で行う |
| 出力 | 標準の3DGS形式の .ply。Gaussianは32,768〜1,048,576個で、既定は262,144個 |
| 構成 | DiT(ノイズ除去本体)370.6M、Octreeデコーダー50.8M、Gaussianデコーダー237.3M、BiRefNet(背景除去)220.7M、DINOv3 ViT-H+/16 840.6M、FLUX.2のVAE 84.1M。合計約1.80B |
| メモリ | 重み3.7〜4.4GB、ピーク7.2GB(CUDA環境での値) |
| 公式の速度 | 50step・262,144個のリクエスト時間(8画像の中央値)で、H100が6.7秒、RTX 4090が19.1秒、RTX 3080が46.2秒 |
| 動作環境 | Python 3.10以上、PyTorch 2.5以上、CUDA対応のNVIDIA GPU |
| 利用条件 | 画像エンコーダーのDINOv3とFLUX.2-dev(VAEだけ使う)がHugging Faceのゲート付きで、利用規約の承諾が要る |
出力はGaussianの集まりだけで、ポリゴンのメッシュやボーン(リグ)は出ない。
Blenderなどの一般的な3Dソフトでそのまま動かせるポリゴンではなく、3D Gaussian Splatting対応のビューアで表示する形式になる。
検証環境
| 項目 | 内容 |
|---|---|
| マシン | MacBook Pro(M1 Max、メモリ64GB) |
| OS | macOS 27.0 |
| GPU | MPS(PyTorchのApple GPU向けバックエンド)。CUDAは無い |
| Python | 3.12(Homebrew)、Idol専用のvenv |
| 主なライブラリ | torch 2.15.0、torchvision 0.29.2、transformers 5.22.1、diffusers 0.42.1、tensordict 0.15.4 |
| Idol SDK | GitHubのコミット 4702a7f(2026年10月29日) |
| 表示 | Chromium上のthree.js 0.170.0と @mkkellogg/gaussian-splats-3d 0.4.7で .ply を読み込み、Playwrightで角度ごとに画像を出力 |
普段裏で動かしている画像生成サーバー(ComfyUIとその前段のキュー)は、メモリを空けるために止めてから始めた。
CUDA無しで動かすための準備
SDKのコードは約1,600行で、すべてPyTorchで書かれていた。
CUDA専用の拡張モジュール(独自のCUDAカーネルや、Gaussian描画用のライブラリ)は使っていない。
アテンションは flash_attn が入っていればそれを使い、無ければPyTorch標準のSDPAに切り替わる。
CUDAに依存しているのは高速化の部分だけだった。
torch.compile によるコンパイル、CFG(条件付きと条件なしの2回の計算)を1回のバッチにまとめる処理、cuDNNのアテンション、TF32の行列積は、どれもデバイスが cuda のときだけ有効になる。
それ以外のデバイスでは、これらを切って普通に計算する。
IdolPipeline はデバイスを引数で受け取れるが、付属のコマンドラインツール idol.sample には --device の指定が無い。
そこで、パイプラインを直接呼ぶ短いスクリプトを書いた。
from idol import IdolPipeline

pipe = IdolPipeline.from_pretrained("weights/idol", device="mps")
out = pipe("kana_full.png", mode="synthetic", seed=1, steps=50, num_gaussians=262144)
out.gaussian.save_ply("kana.ply")
pip install -e ./idol-sdk は、CUDA専用のパッケージを要求しないのでそのまま通った。
MPSが対応していない演算をCPUへ逃がす PYTORCH_ENABLE_MPS_FALLBACK は0にして、未対応の演算があればエラーで止まるようにした。
FLUX.2-devのVAEの代わり
Idolは画像の特徴を取るのにFLUX.2-devのVAEを使う。
手元のHugging Faceアカウントでは、FLUX.2-devの利用規約を承諾していなかったのでアクセスが403で拒否された。
同じBlack Forest LabsのFLUX.2-klein-4Bにも vae/ が入っていて、こちらは取得できた。
kleinのVAEの config.json には "_name_or_path": "black-forest-labs/FLUX.2-dev" と書かれている。
ファイルサイズはdevの336,213,556バイトに対してkleinは168,120,878バイトで、ほぼ半分。
IdolはdevのVAEを読み込むときにbf16へ変換して使うので、Idolの config.json の flux2_vae をkleinに書き換えて代用した。
代用して問題ないかは、ComfyUI公式のComfy-Orgが公開しているFLUX.2-devのVAE(Comfy-Org/flux2-dev の split_files/vae/flux2-vae.safetensors)で照合した。
このファイルはdevの本家と同じ336,213,556バイトで、中身はFP32。
kleinのVAEはbf16で、テンソルは251個とも名前と形が同じだった。
Comfy-Org版をbf16に変換すると、251個すべてがkleinの値とビット単位で一致した。
Idolがbf16で読み込む以上、devとkleinのどちらを指定しても計算に入る重みは変わらない。
ただし、Comfy-Org版のSHA-256はHugging Face APIが返すdev本家の値と一致しなかった。
サイズは同じなのでヘッダーの形式が違うのだと思う。
公式デモ画像で動かす
まず、SDKに付属しているデモ画像の fig-knight.webp(騎士のフィギュア)を既定の設定で入れた。
設定は mode="synthetic"、seed 42、50step、262,144個。
最後までエラー無しで通り、MPSが対応していない演算は1つも無かった。
| 項目 | M1 Max(MPS) |
|---|---|
| モデル読み込み | 59.8秒(初回。画像エンコーダーのダウンロード込み) |
| 生成 | 434.1秒(うちサンプリング50stepが7分00秒、1stepあたり8.4秒) |
| メモリのピーク | 14.79GB(torch.mps.driver_allocated_memory() の最大値) |
| 出力 | .ply 17.8MB |
RTX 4090の19.1秒に比べると約23倍かかった。
公式の値は8画像のリクエスト時間の中央値で、こちらは1枚の生成部分の時間なので、測り方は同じではない。
CUDA以外ではCFGの2回の計算がまとめられないので、50stepで100回分の推論を回している。
メモリはモデルカードのピーク7.2GBの約2倍だった。
背景除去のBiRefNetを半精度にする処理もCUDAのときだけ行われるので、MPSではFP32のまま載っている。
同じ画像を、公式デモのHugging Face Space(ZeroGPU)にも同じ設定で投げて比べた。
APIが返すハードウェア名は zero-a10g だった。
Space側は本来のFLUX.2-devのVAEを使い、CUDAの高速化も有効な状態で動いている。
下の画像は左端が前処理後の入力で、続いて正面、斜め前、横、斜め後ろ、背面、反対側の横の順に並べている。
この記事の横長の画像はすべて同じ並び。
| 実行環境 | 結果 |
|---|---|
| M1 Max(MPS) | 正面・背面とも形は出た。盾が左手のものとは別にもう1枚、横の空中に浮いた |
| Hugging Face Space(CUDA) | 盾は1枚で、浮いた盾は無い |
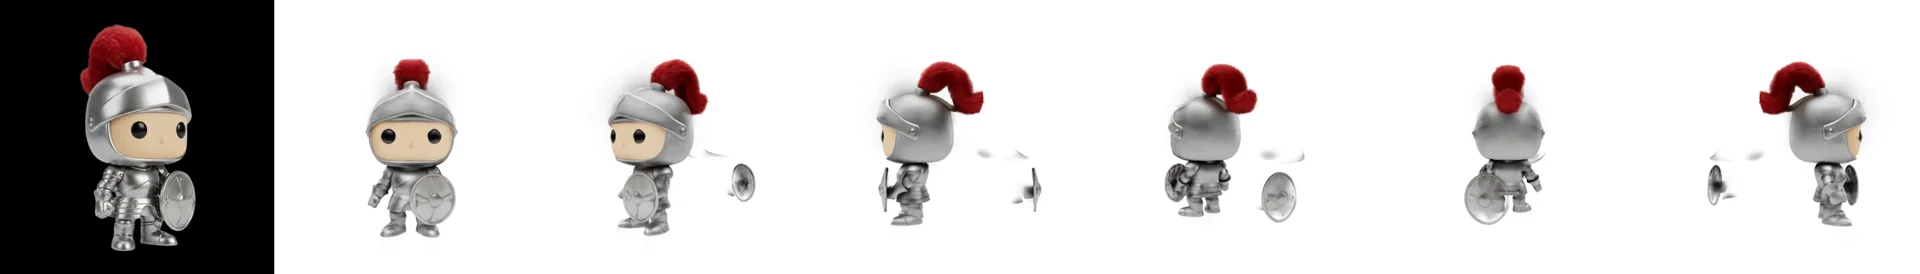
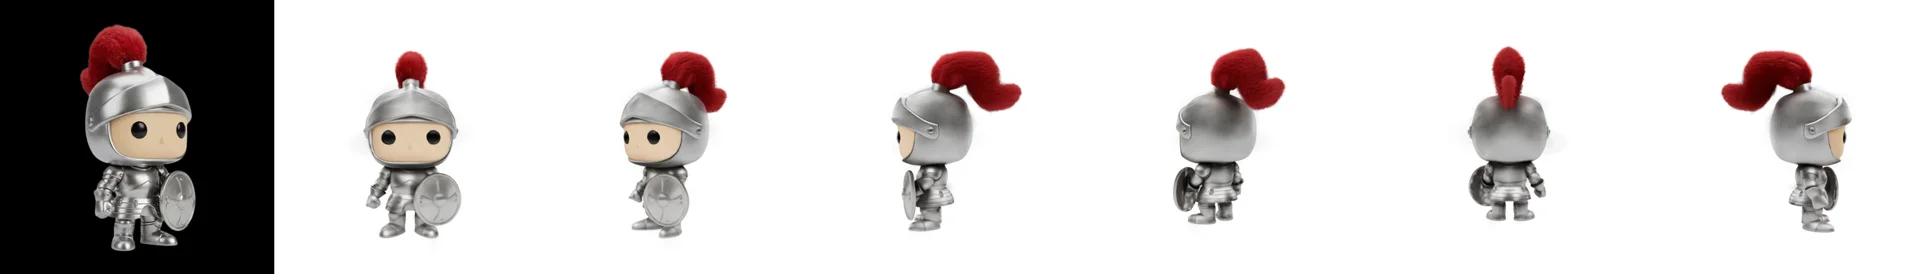
背中側の兜、羽根飾り、鎧の背面は、入力に無いのにどちらも破綻なく埋まっていた。
ただし、PyTorchの乱数はCUDAとMPSで系列が違うため、同じseed 42でも初期ノイズが異なる。
そのため、盾の重複がデバイスの違いによるものかは特定できない。
かなちゃんの立ち絵を入れる
次に、以前ローカルの画像生成で出力したかなちゃんの全身立ち絵を入れた。
832×1216の白背景で、制服姿で腕を下ろしてまっすぐ立っている絵。
設定は騎士と同じ既定値(seed 42)。
生成は427.7秒で終わったが、出てきたのは人の形ではなかった。
どの角度から描画しても、上のほうに黒っぽいしみが数か所あるだけだった。
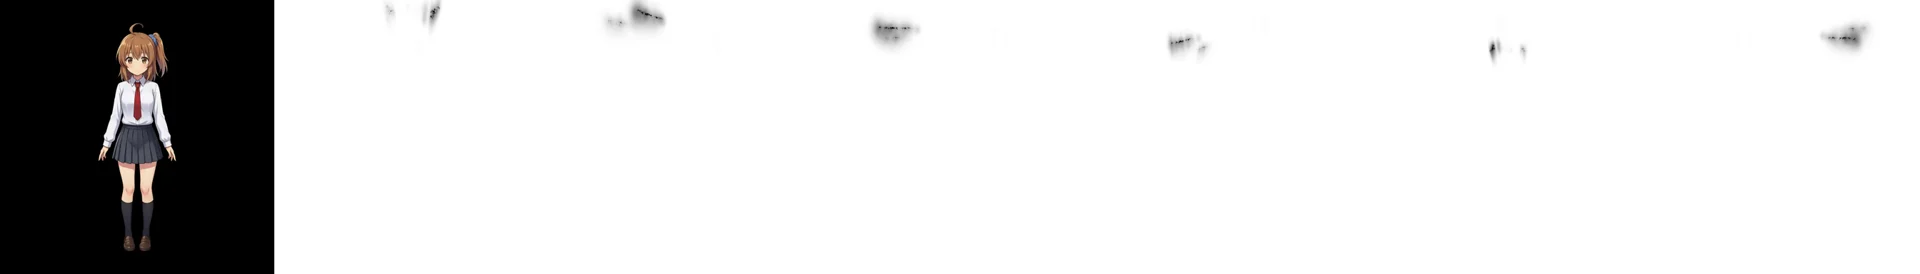
.ply を集計すると、262,144個のGaussianのうち不透明度が0.5を超えるものは28個しかなかった。
騎士はMPS版で50,607個、Space版で45,701個が0.5を超えている。
ほぼ全部が透明で、何も描かれていない状態だった。
前処理後の入力画像は、黒背景の中央にかなちゃんの全身がきれいに切り抜かれていた。
崩れたのは背景除去ではなく、そのあとの生成だった。
Idolは入力画像を撮ったカメラの向きや距離も推定して出力する。
このときの推定は、距離が1000(ほぼ正射影、遠くから望遠で撮った扱い)、上下の角度(pitch)が0.45ラジアンで、騎士のときの距離3.09、pitch 0.01ラジアンとはかけ離れていた。
ここで考えられる原因は2つあった。
1つは、MPSの計算がCUDAとずれていて、騎士の盾もその影響だったという可能性。
もう1つは、アニメ調の細長い立ち絵がモデルにとって想定外の入力だったという可能性。
かなちゃんの画像は外部のSpaceへは上げたくないので、手元でCPUとMPSに同じ入力を与えて、部品ごとに出力を比べることにした。
MPSの計算はずれているのか
CPU版が終わらなかった
最初はCPU版をそのまま動かしたが、30分以上たってもCPUの1コアに張り付いたまま進まなかった。
macOSの sample コマンドでスタックを取ると、CPUでのbf16の行列積で止まっていた。
コードを読むと、FLUX.2のVAEは常にbf16で読み込まれ、入力も images.to(torch.bfloat16) で固定されている。
DiTと2つのデコーダーも、内部の計算型が self.dtype = torch.float16 と埋め込まれ、重みも半精度に変換される。
CPUでのbf16やFP16の計算は遅いので、比較の基準にはCPU側を全部FP32にした版を使った。
もう1つ、VAEは特徴を取るときに latent_dist.sample() で乱数を引いている。
デバイスごとに乱数が違うと、入力が同じでも条件が変わってしまう。
比較の間だけ、乱数を引かずに分布の平均(mode())を使うように差し替えた。
部品ごとの差
CPUの全FP32を基準に、MPSの既定(FP16とbf16が混ざった状態)と、MPSを全FP32にした場合の出力を比べた。
入力はかなちゃんの前処理後の画像で、DiTには3つとも同じ初期ノイズを与えた。
相対誤差は、差のノルムを基準のノルムで割った値。
| 部品 | MPS既定(FP16/bf16) | MPS全FP32 |
|---|---|---|
| DINOv3の特徴 | 1.02% | 0.00016% |
| FLUX.2 VAEの特徴 | 0.84% | 0.0029% |
| DiTの出力(形の潜在表現)t=1000 | 0.11% | 0.00006% |
| DiTの出力(形の潜在表現)t=500 | 0.33% | 0.00038% |
| DiTの出力(形の潜在表現)t=50 | 0.19% | 0.00021% |
| DiTの出力(カメラ)t=1000/500/50 | 0.09%/0.15%/0.26% | 0.0001%以下 |
tはノイズ除去の時刻で、1000がノイズだけの状態、0に近いほど完成に近い。
NaNやInfはどの条件でも出なかった。
MPSを全FP32にするとCPUと6桁一致した。
MPSの演算そのものは正しく計算している。
既定設定で出る0.1〜1%の差は、半精度の丸め誤差の範囲だ。
この比較で言えるのは、MPSの計算がCPUと一致することまで。
MPS自体の計算破綻ではないため、入力とseedを変えて試すことにした。
seedを変える
同じ立ち絵、同じ設定で、seedだけを変えて2回追加した。
| seed | 生成 | 不透明度0.5超 | 推定pitch | 結果 |
|---|---|---|---|---|
| 42 | 427.7秒 | 28個 | 0.45ラジアン | 崩壊(しみだけ) |
| 1 | 409.1秒 | 199,600個 | 0.08ラジアン | 全身が出た |
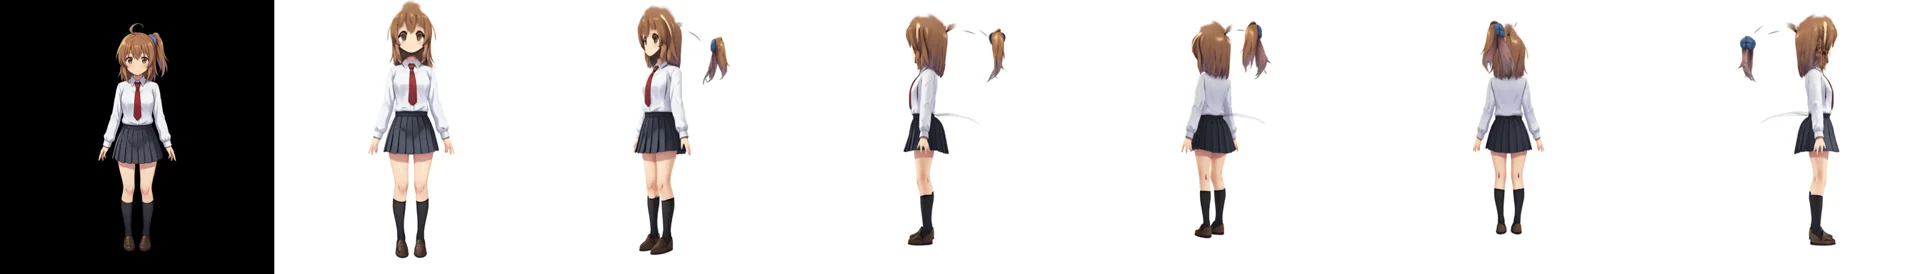
| 2 | 419.4秒 | 214,620個 | 0.20ラジアン | 体は出たが、サイドポニーが頭から離れて浮いた |
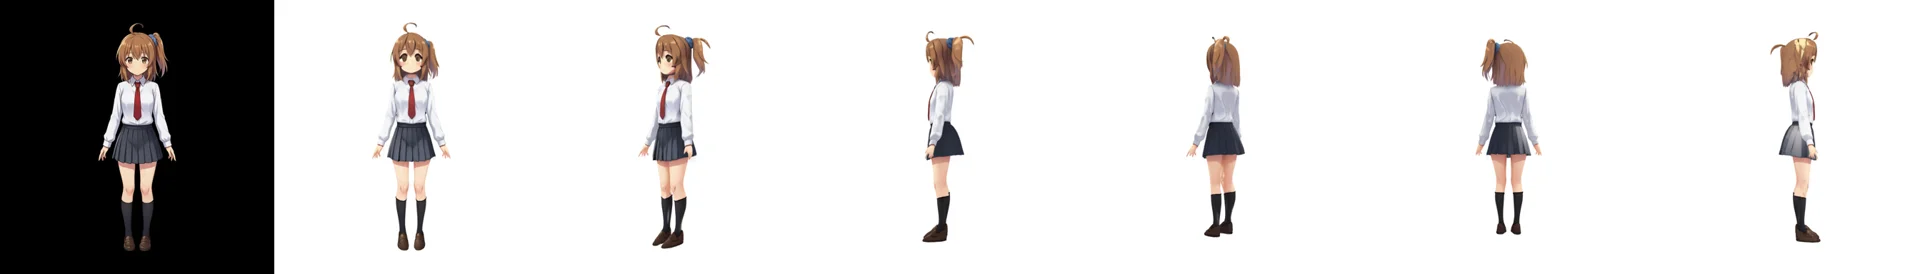
seed 1は、正面からは入力とほぼ同じ立ち姿になった。
横や背面に回しても人の形としてつながっていて、背中側のシャツ、スカートのひだ、ハイソックスと靴が入力に無い向きにも出ている。
seed 2は、体と制服と脚は出たが、サイドポニーとシュシュが頭から外れ、頭の斜め後ろの空中に浮いた。
正面からはポニーが頭の陰に隠れて見えず、横に回すと離れていることが分かる。
騎士の盾と同じように、体から張り出した細い部品が奥行きの位置を間違えて置かれている。
3回のうち、そのまま使える形が出たのはseed 1の1回だけだった。
崩壊したseed 42だけ推定pitchが大きく外れていたので、カメラの推定が外れると形が出ない可能性がある。
seed 1に寄る
seed 1の頭まわりに寄って描画した。並びは同じで、左端が入力。
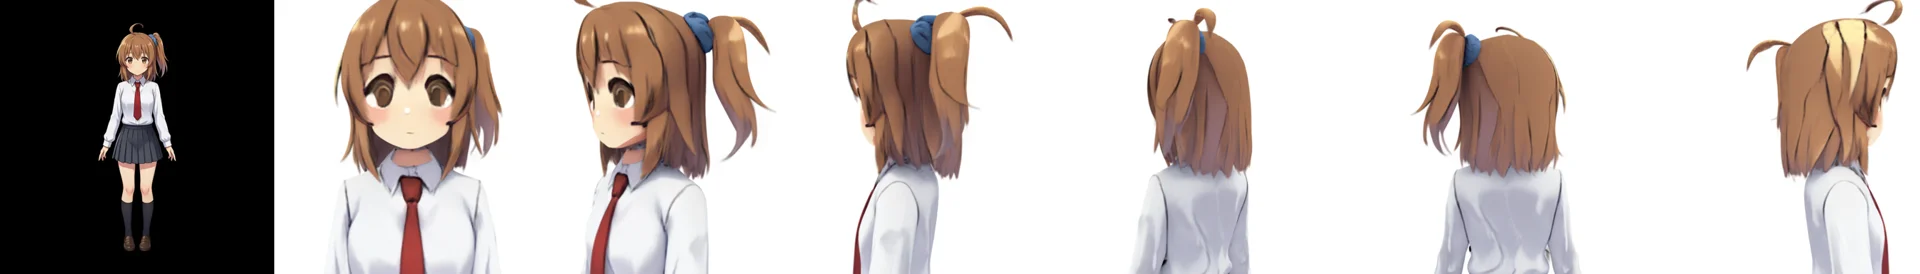
サイドポニーと青いシュシュ、アホ毛は、どれも頭に付いたまま立体になっていた。
後頭部の髪は入力に無い部分だが、肩までの髪として埋まっている。
一方で正面の顔は、目のハイライトと線がぼやけて入力より柔らかくなり、反対側の横の後ろ髪には黄色っぽい明るいまだらが出た。
ちびキャラで入れる
SDKのデモ画像(fig-*.webp)は、どれも頭の大きいフィギュア体型だった。
学習データもそういう物体が中心なら、ちびキャラのほうが合うかもしれない。
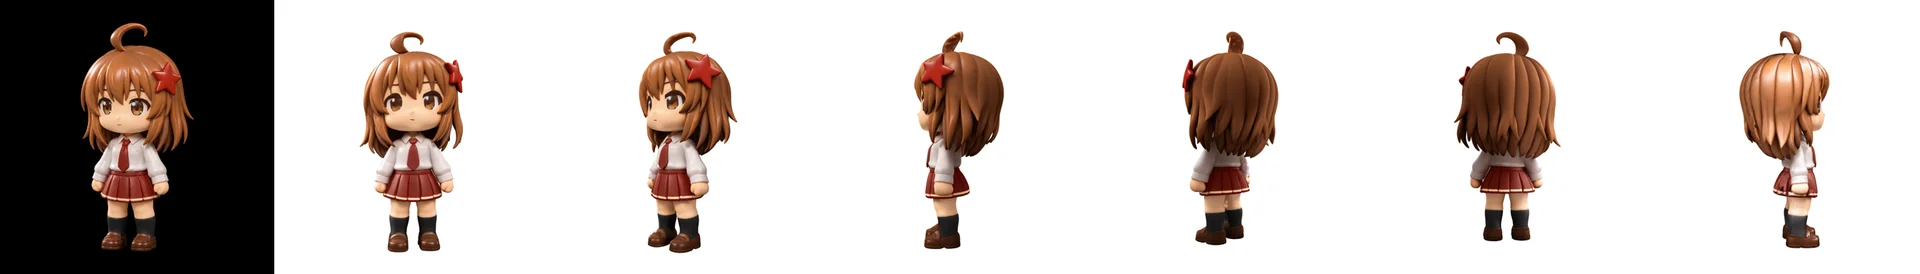
以前出力したかなちゃんのちびキャラの正面図(832×1024、白背景、赤いスカートの制服)を入れた。
| seed | 生成 | 不透明度0.5超 | 推定pitch | 結果 |
|---|---|---|---|---|
| 42 | 414.3秒 | 163,287個 | 0.19ラジアン | 全身が出た。背面でスカートが白くなった |
| 1 | 415.0秒 | 197,486個 | 0.16ラジアン | 全身が出た。背面もスカートが赤い |
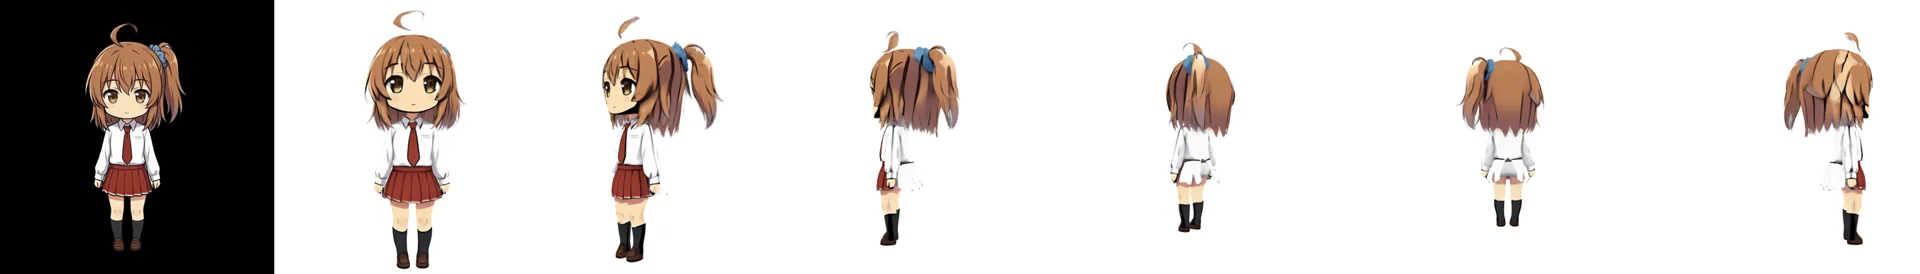
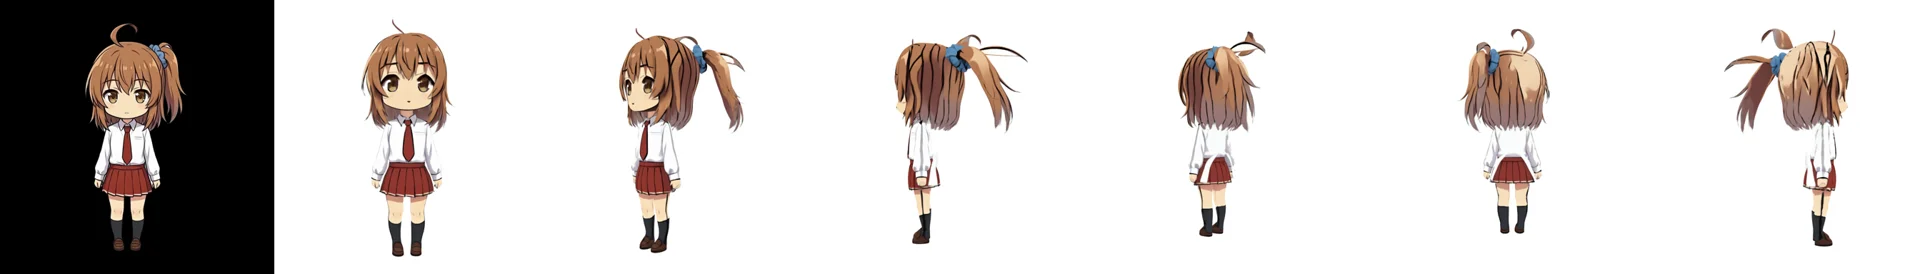
立ち絵で崩壊したseed 42でも、ちびキャラでは形が出た。
2回とも、サイドポニーとシュシュは頭に付いたまま横に張り出している。
seed 42は、背面に回すと赤いスカートの後ろ半分が白くなり、シャツの裾が下まで伸びたような色になった。
seed 1は背面までスカートの赤が保たれたが、後頭部に髪の流れに沿った濃い線が何本も入った。
入力の線画のタッチを、絵に無い裏側にも描き足したようになっている。
フィギュア風の絵で入れる
公式のデモ画像をあらためて並べると、キャラクター系の20枚(fig-*.webp)はどれもソフビやPVCのフィギュアを写真のように描いたCGだった。
nb-dragon-anime.webp という名前のアニメ風のドラゴンも、平らなイラストではなく立体のフィギュアとして描かれている。
| 公式のデモ画像 | かなちゃんの立ち絵 | |
|---|---|---|
| 絵の種類 | フィギュアのCG。陰影、光沢、接地影がある | 平塗りのアニメ絵。黒い輪郭線があり、陰影は薄い |
| 角度 | 少し斜め上からの3/4がほとんど | 真正面 |
| 等身 | 2〜3頭身 | 約7頭身(ちびキャラは約3頭身) |
騎士、ちびキャラ、立ち絵の順で結果が良かったのは、公式のデモ画像に近い順でもある。
立ち絵とちびキャラの画像を参照に渡し、Codex(OpenAIのコーディングエージェント)の画像生成でフィギュア風に描き直させた。
作風の見本として騎士の画像も渡し、黒背景、陰影と光沢あり、少し斜め上からの3/4の角度を指定した。
立ち絵はPVCのスケールフィギュア風で透明な丸い台座付き、ちびキャラはソフビ風にして、それぞれ2枚ずつ(全身A1・A2、ちびB1・B2、どれも1254×1254)作った。
髪型と服は参照のまま保たれている。
| 入力 | seed | 生成 | 不透明度0.5超 | 推定pitch | 結果 |
|---|---|---|---|---|---|
| 全身A1 | 42 | 400.8秒 | 203,056個 | 0.23ラジアン | 全身が出た。足元に台座の影が黒く残った |
| 全身A1 | 1 | 404.3秒 | 203,693個 | 0.11ラジアン | 全身が出た |
| 全身A2 | 42 | 400.6秒 | 172,740個 | 0.10ラジアン | 全身が出た |
| ちびB1 | 42 | 402.0秒 | 243,908個 | 0.17ラジアン | 全身が出た |
| ちびB2 | 42 | 400.7秒 | 239,480個 | 0.16ラジアン | 全身が出た |
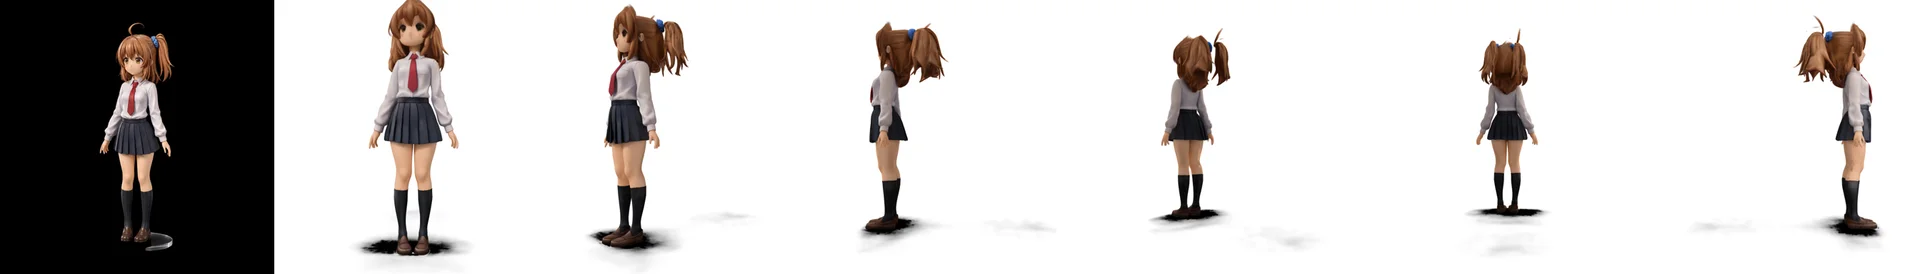
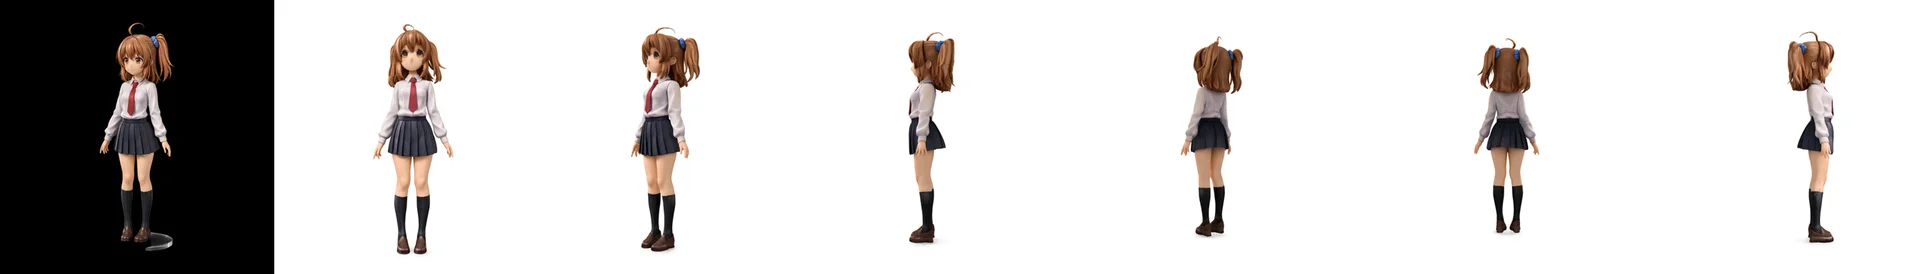
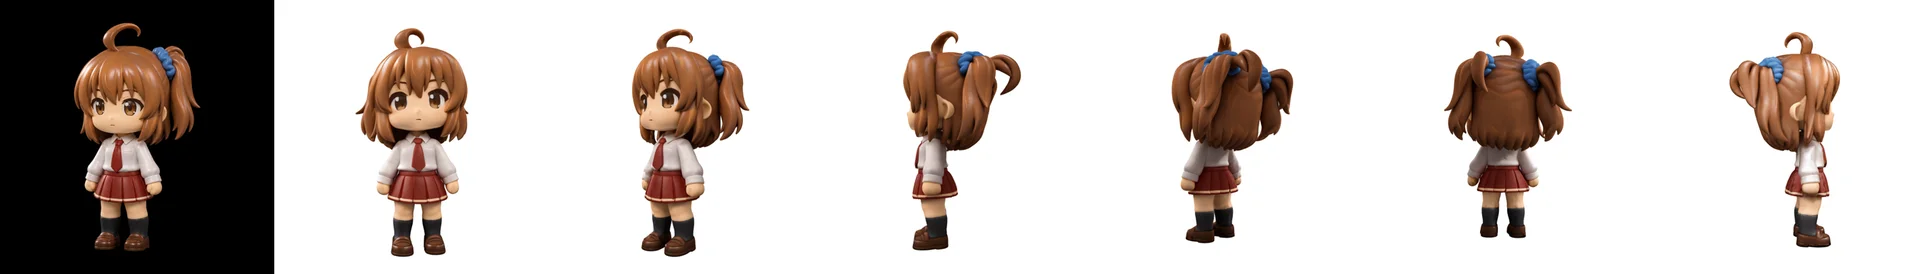
平塗りの立ち絵で28個しか残らなかったseed 42でも、フィギュア風の全身では全身が出た。
5回とも体は崩れず、脚は左右に分かれている。
正面と斜め前は、入力の陰影と光沢まで含めて入力に近い姿で出た。
全身の奥行きは横幅の0.73〜0.74倍で、平塗りの立ち絵のseed 1(0.57倍)より厚みがある。
A1のseed 42だけは、台座の影が足元の黒い円と床のもやとして残った。
一方で、サイドポニーは5回とも後ろ側で2本になった。
入力では本人の左側に1本だけなのに、斜め後ろと背面からは右側にも同じ形の束が生え、青いシュシュも2つになっている。
下の画像は左から、全身A1 seed 1の斜め後ろと背面、ちびB1 seed 42の斜め後ろと背面。
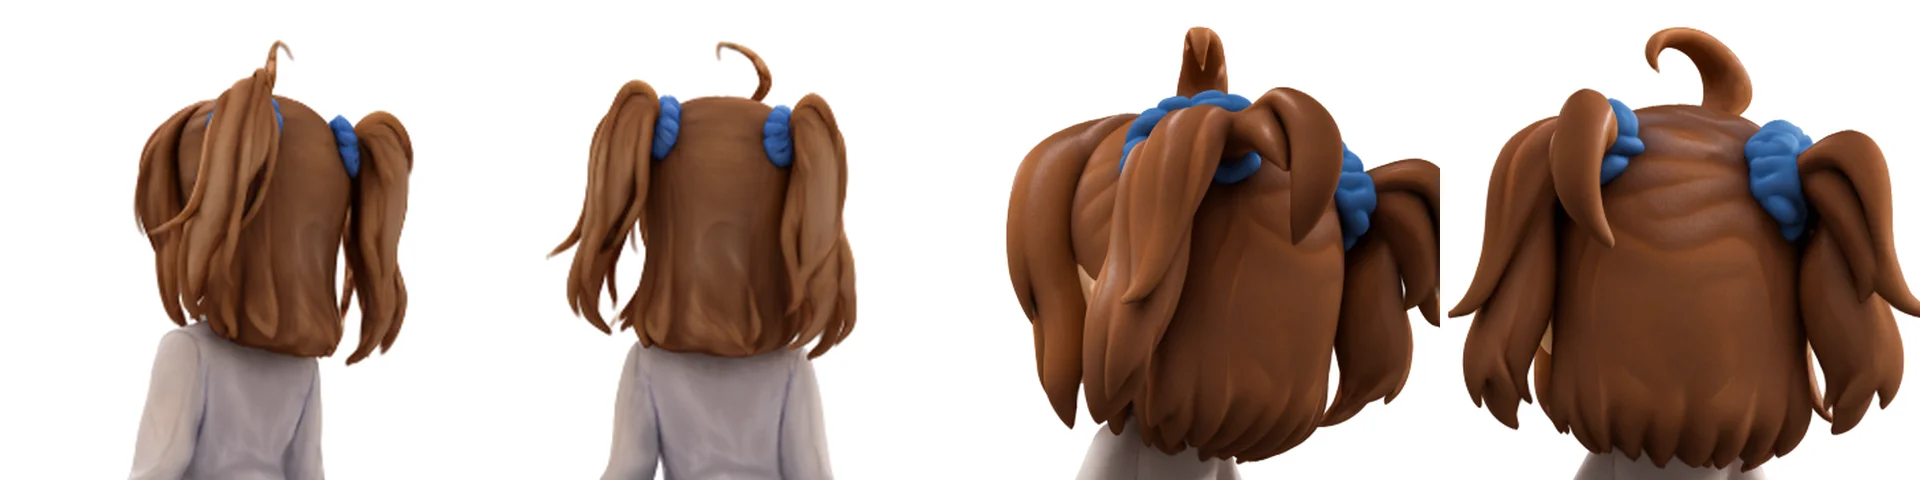
平塗りの立ち絵とちびキャラでは、背面に回してもポニーは1本のままだった。
フィギュア風に描き直すと、体の形は安定したが、見えない側の髪を左右対称に補うようになった。
Idolに渡せる画像は1枚だけで、前と後ろの絵を一緒に入れる方法は無い。
IdolPipeline は画像を1枚受け取り、DiTはその1枚から取った特徴だけを条件に形を作る。
コマンドラインの --image にフォルダを指定しても、中の画像を1枚ずつ別々に生成するだけだった。
入力に写っていない側は、すべてモデルの推定で埋まる。
ポニーの見える角度と、片側だけの髪留め
左右に増えるのがサイドポニーだけなのか、片側にだけある物なら何でも増えるのかを分けるため、ちびB1をもとにCodexで2種類の絵を追加で作った。
C1とC2は、同じちびフィギュアを本人の左側(ポニーのある側)に回って撮った3/4で、C1が約45°、C2が約60°。
ポニーが頭の横から後ろへ突き出ているのが分かり、反対側の頭には何も付いていない。
D1は、ポニーとシュシュを外して髪を下ろし、本人の左側にだけ赤い星の髪留めを付けた絵。
| 入力 | seed | 生成 | 不透明度0.5超 | 結果 |
|---|---|---|---|---|
| C1(約45°) | 42 | 400.8秒 | 243,362個 | 後ろ側で2本。増えた側にはシュシュが無い |
| C1(約45°) | 1 | 401.6秒 | 240,408個 | 後ろ側で2本。シュシュも2つ |
| C2(約60°) | 42 | 402.3秒 | 231,790個 | ポニーは1本のまま。アホ毛が頭から浮いて、ぼやけた塊になった |
| D1(星の髪留め) | 42 | 400.7秒 | 245,313個 | 髪留めは左側の1つだけ |
| D1(星の髪留め) | 1 | 403.9秒 | 240,698個 | 髪留めは左側の1つだけ |
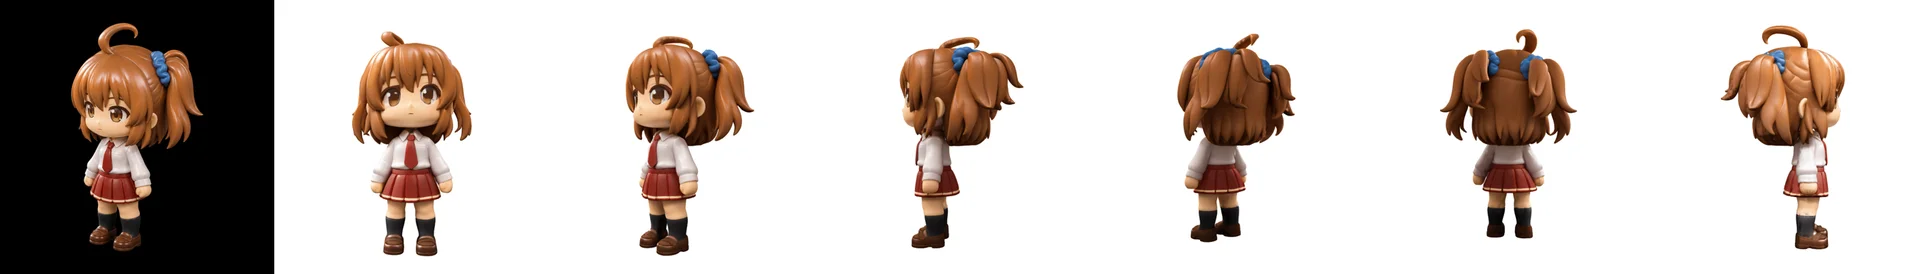
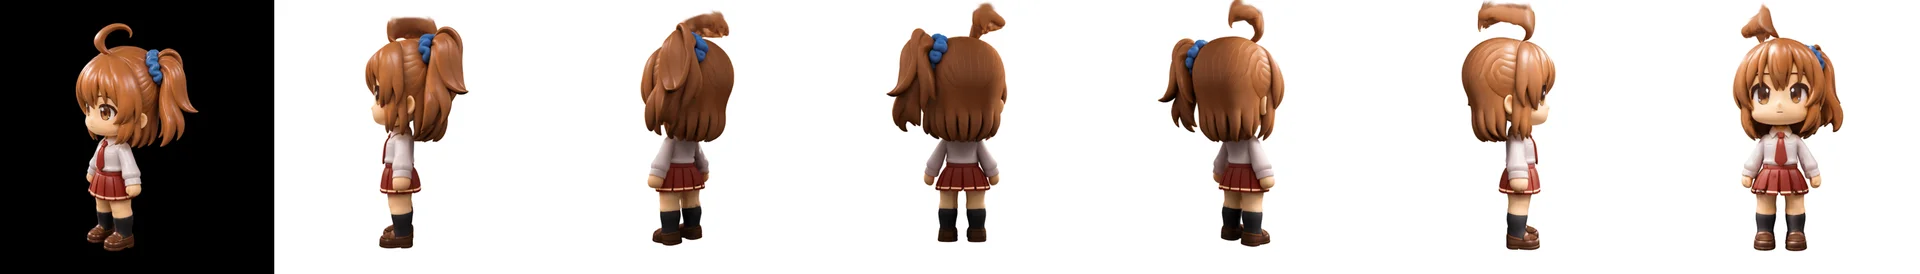
頭まわりに寄って並べた。上からC1のseed 1、C2のseed 42、D1のseed 42で、横の並びはほかの画像と同じ。
C2は、モデルが置いた体の向きがほかと違い、右端の列で顔が見えている。
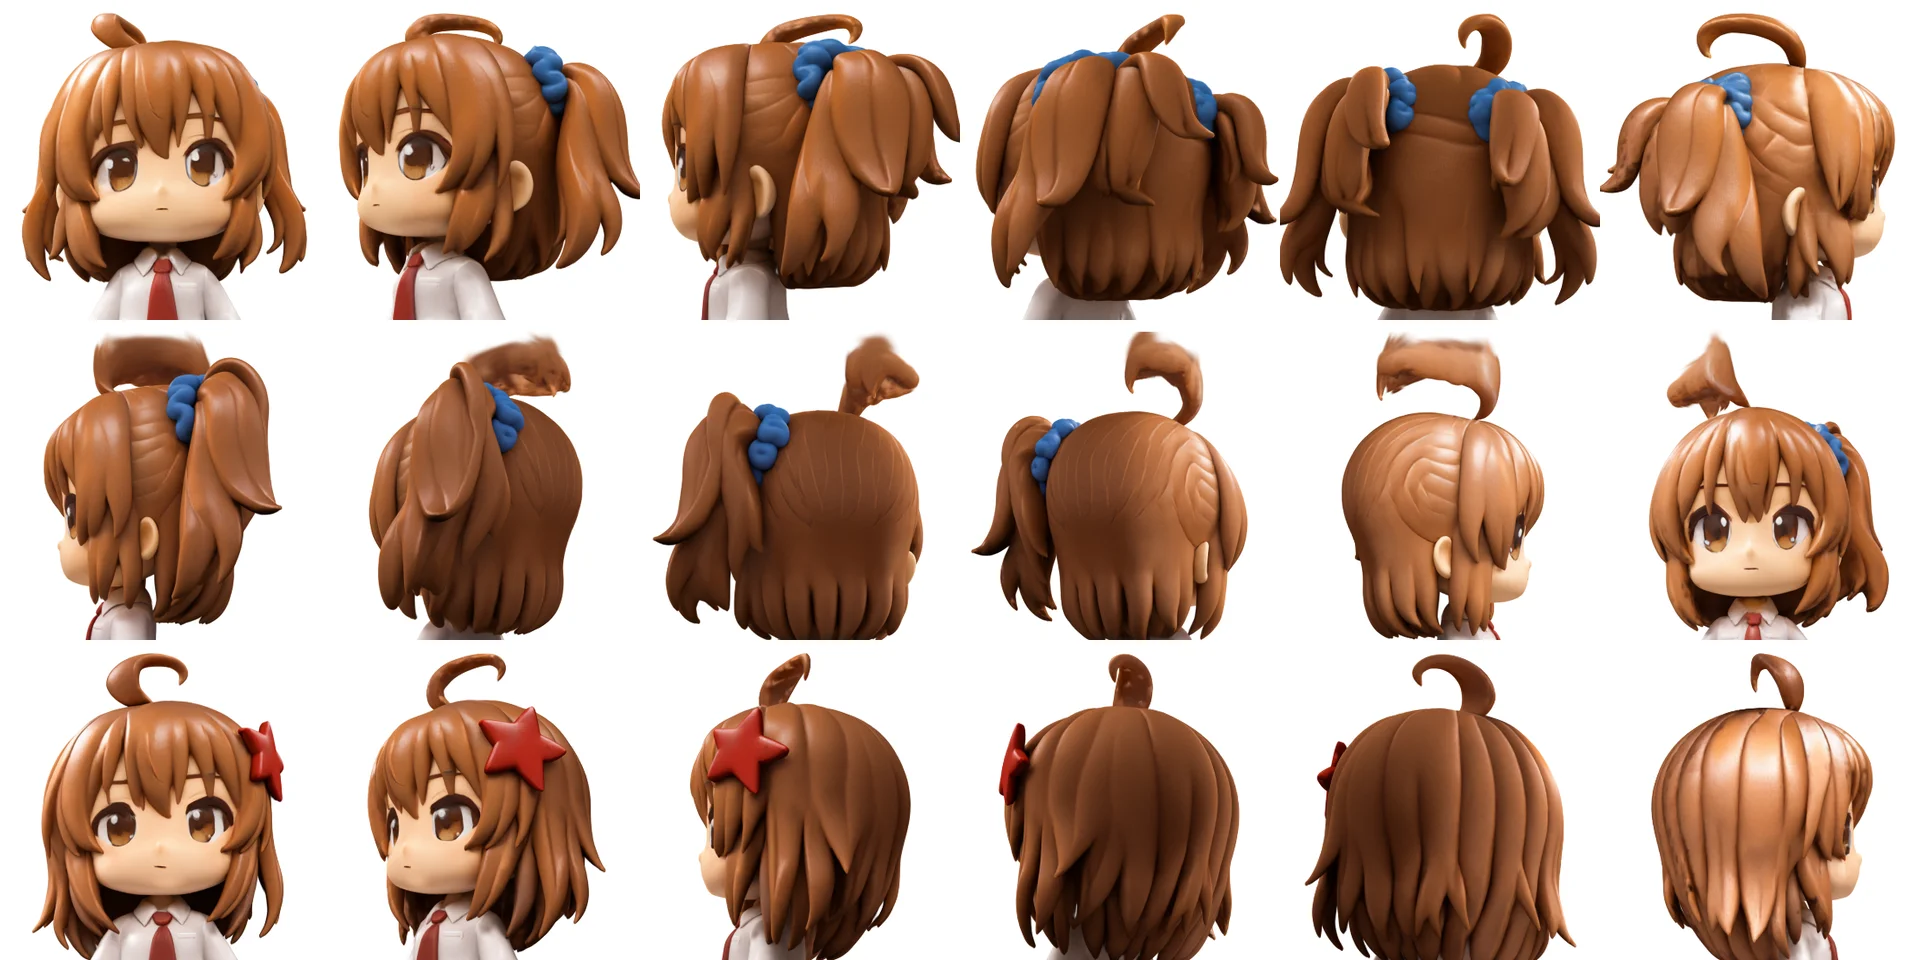
片側だけの星の髪留めは、2回とも反対側に増えなかった。
後ろ髪も1枚の面としてまとまり、背面からは左の縁に髪留めの端がのぞいているだけになっている。
左右に補われるのは、片側にだけ付いた物すべてではなく、頭から張り出した髪の束だった。
ポニーは、約45°から撮ってもまだ2本になった。
約60°まで回してポニーが頭の後ろに付いていることがはっきり写ると、1本のままで出た。
ただしC2はアホ毛が頭から離れて浮き、ぼやけた塊になった。
アホ毛は約60°の入力では頭の上にかかって細く写っていて、その奥行きを読み違えたのだと思う。
正面寄りの絵から、横に張り出した髪の束が片側だけなのか左右にあるのかは、1枚では決めきれず、ツインテールのほうに寄せて埋めているように見える。
何度で1本に変わるかの境界はこれだけでは絞り込めない。
サイドポニーとアホ毛のある本来の髪型では、平塗りとフィギュア風を合わせて13回生成した。
崩壊した1回を除く12回のうち、後頭部まで違和感なく出たものは無かった。
離れて浮いたポニー、左右に増えたポニー、浮いたアホ毛、後ろ髪のまだらや黒い線と、崩れ方は入力ごとに違う。
体の形は陰影のある絵にすると安定したが、1枚の正面寄りの絵から後頭部の髪型までは決まらなかった。
Gaussianの数とステップ数
時間がかかる部分と、品質に影響する部分を分けるため、立ち絵のseed 1でGaussianの数とステップ数をそれぞれ変えた。
Gaussianの数
| 個数 | 生成 | メモリのピーク | .ply |
|---|---|---|---|
| 262,144(既定) | 409.1秒 | 15.61GB | 17.8MB |
| 1,048,576(最大) | 427.3秒 | 15.61GB | 71.3MB |
4倍にしても生成時間は18秒しか延びず、メモリのピークも変わらなかった。
時間とメモリのほとんどはDiTのサンプリングで使われていて、Gaussianの数はそのあとのデコーダーにしか関わらない。
同じseedなので形は同じになる。
下の画像は左から、262,144個の正面、1,048,576個の正面、262,144個の斜め前、1,048,576個の斜め前。
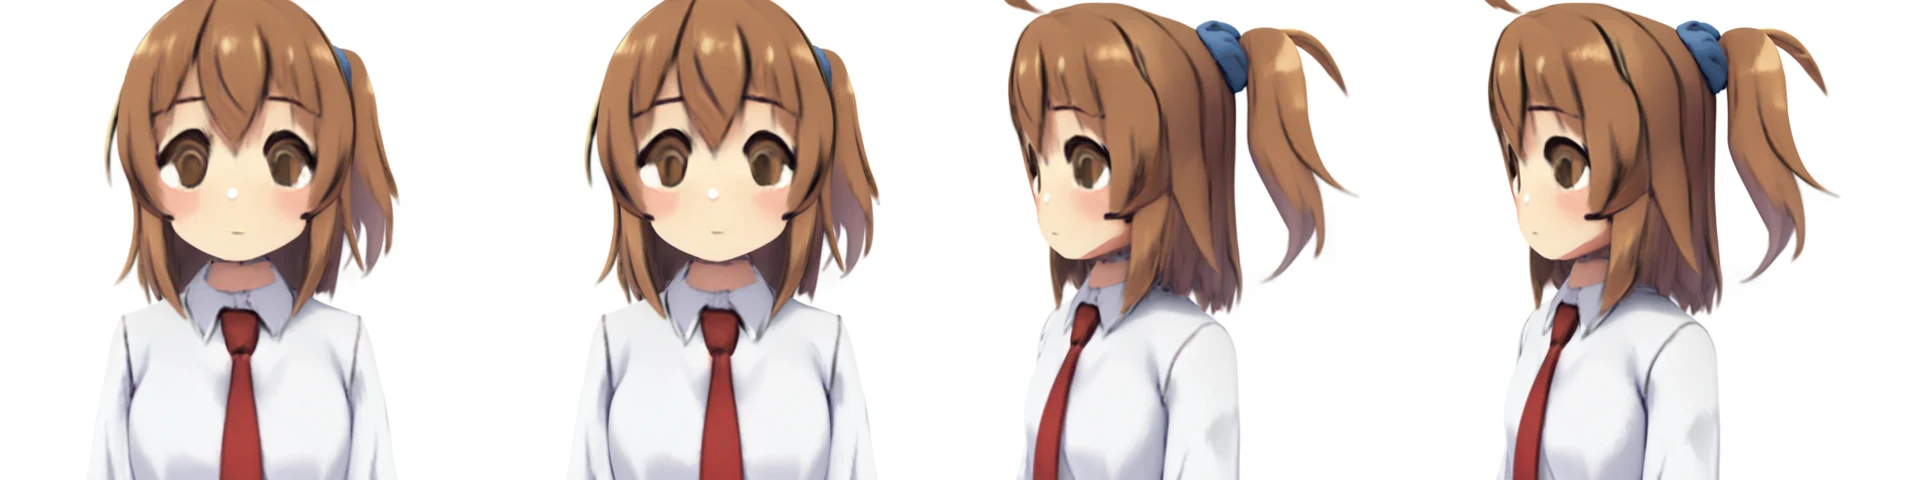
1,048,576個のほうが、髪の毛束の縁と襟の線がくっきりした。
目のぼやけは個数を増やしても変わらず、どちらも鼻の前に白い点が1つ浮いている。
ステップ数
| step | 生成 | 不透明度0.5超 | 結果 |
|---|---|---|---|
| 50(既定) | 409.1秒 | 199,600個 | 全身が出た |
| 25 | 206.9秒 | 167,932個 | 顔が無く、全体がぼやけた塊になった |
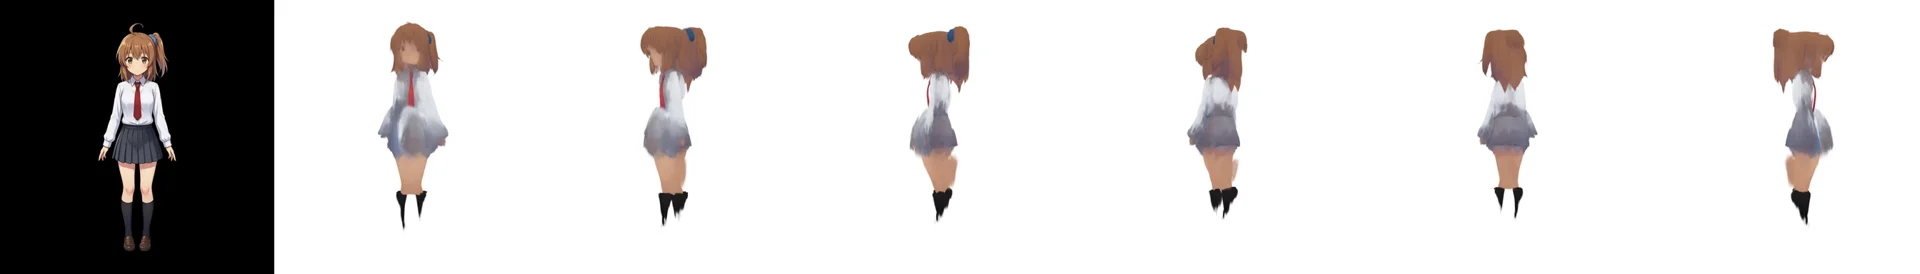
ステップを半分にすると時間もほぼ半分になったが、顔が消え、脚は太く1本につながりかけ、スカートは灰色のもやになった。
READMEは「Fewer are faster but lose some detail」と書いているが、この立ち絵では細部どころか形が崩れた。
推定pitchは0.03ラジアンで外れていないので、カメラではなく、ノイズを除き切れずに終わった崩れ方だと思う。
M1 Maxでは時間のほとんどがDiTの50stepに使われていて、Gaussianの数を減らしてもほとんど速くならない。