Qwen-Image 2.1をM1 MaxでTaylorSeerキャッシュにかけたら1枚10分が3分半になった
 目次
2026-09-22 追記: 表情だけ変える部分編集で位置が保てるかを測り、片方だけの着せ替えと背景の透過も試した → Qwen-Image 2.1の部分編集は、引数1つで位置ずれが約0.1pxになった
前回のQwen-Image 2.1のローカル版をAnimaと比べた記事では、M1 Max 64GBで832×1216の画像を1枚出すのに約10分かかった。参照画像を使う編集は約12分。
Animaのときは少ないステップで出せるTurbo LoRAがあったが、Qwen-Image 2.1向けのものは、9月21日に探した範囲では見つからなかった。モデルを学習し直さずに速くする方法を、生成に使っているDiffusersのスクリプトで試した。
検証環境
| 項目 | 内容 |
|---|---|
| マシン | MacBook Pro、Apple M1 Max、メモリ64GB |
| OS | macOS 27.0 |
| 実行環境 | Python 3.12.12、PyTorch 2.14.0(MPS)、Diffusers 0.41.0.dev0(コミット 80c7ed26) |
| モデル | Qwen-Image 2.1(BF16、ModelScopeから取得した公開重み) |
| 共通の生成条件 | 832×1216、40ステップ、シード42、CFG1.0、ネガティブプロンプトなし |
| 比較対象 | キャッシュなしの生成(前回の記事の出力と計測値をそのまま使った) |
時間は前回と同じく、プロンプトの読み取りから画像への復元までの生成処理を測り、モデルの読み込みは含めていない。各条件1回ずつ計測した。
Qwen-Image 2.1向けの高速化LoRAの有無
旧Qwen-Imageには、4ステップや8ステップで生成できるようにするLightningというLoRAがある。
Qwen-Image 2.1はTransformerの構造が変わっていて、旧版は画像側と文章側を別々に処理する2系統の60層、2.1は1系統の32層になった。層の数も幅も違うので、旧版のLoRAは使えない。
9月21日にLightningの配布元、Hugging Face、ModelScopeを探したが、2.1向けの高速化LoRAや蒸留版は見つからなかった。
Lightningのリポジトリには、2.1への対応予定を尋ねるissue #90が9月21日に立っていて、9月22日の時点で返信はない。
学習なしで使える特徴キャッシュ
9月21日に、Qwen-Image 2.1専用のComfyUIノードComfyui-Spectrum-Qwen2.1が公開された。
拡散モデルは、ステップが進んでもTransformerの内部の値が少しずつしか変わらない。このノードは、数ステップだけ実際に計算し、残りのステップの値は多項式で予測してTransformer本体を飛ばす。元はSpectrumという論文の手法で、モデルの学習はいらない。
生成はComfyUIではなくDiffusersのスクリプトで動かしている。
Diffusers本体にも同じ種類の特徴キャッシュがいくつか入っていて、Qwen-Image 2.1のTransformerは enable_cache() を呼べる作りになっていた。今回はその中のTaylorSeerを使った。前のステップとの差分から、次のステップの値をテイラー展開で予測する。
TaylorSeer Liteの設定
TaylorSeerには、Transformerのブロックを全部飛ばして最後の出力層の値だけを予測するLiteモードがある。Diffusersの説明には、メモリの使用を抑えた軽量版と書いてある。今回はこちらを使った。
| 設定 | 値 | 意味 |
|---|---|---|
use_lite_mode | True | 予測するステップでは32ブロックを全部飛ばし、出力層の値を予測で埋める |
disable_cache_before_step | 3 | 最初の3ステップは必ず実際に計算する |
cache_interval | 3 | そのあとは3ステップごとに1回、実際に計算する |
max_order | 1 | 1次の差分まで使って予測する |
40ステップのうち、実際にTransformerを通すのは、最初の3ステップと、そのあとの5・8・11…38ステップ目の12回で、計15回になる。
from diffusers import TaylorSeerCacheConfig

pipe.transformer.enable_cache(
    TaylorSeerCacheConfig(
        cache_interval=3,
        disable_cache_before_step=3,
        max_order=1,
        use_lite_mode=True,
    )
)
パイプラインの読み込みと生成の呼び出しは、前回の記事のコードと同じ。
KVキャッシュとの併用で出たエラーと回避策
そのまま実行すると、2ステップ目で次のエラーが出て止まった。
RuntimeError: The size of tensor a (3952) must match the size of tensor b (4075) at non-singleton dimension 1Qwen-Image 2.1のパイプラインは、既定でKVキャッシュ(use_kv_cache=True)が有効になっている。
文章と参照画像の部分はステップが進んでも計算結果が変わらないので、1ステップ目で求めた値を保存し、2ステップ目以降は生成する画像の部分だけを計算する。
同じキャッシュという名前でも、KVキャッシュは変わらない値をそのまま使い回すもので、値を予測で埋めるTaylorSeerとは別物。
このため、Transformerの出力の長さが1ステップ目とそれ以降で変わる。前回の記事と同じ俯瞰のプロンプト(832×1216)では、1ステップ目が文章側の123トークンと画像の3952トークンを合わせた4075トークン、2ステップ目以降は画像の3952トークンだけになった。
TaylorSeerは前後のステップの出力の差を取るので、長さが合わずにエラーになっていた。
use_kv_cache=False にすれば動いたが、参照画像を使う編集では参照画像の部分も毎ステップ計算し直すため、実計算1回が17.4秒から31.6秒に増えた。
回避策として、出力の形が変わったら前の値を捨てて、そのステップを初回として扱うようにした。Diffusers本体には手を入れずに、スクリプトの中で TaylorSeerState.update を実行時に差し替えている(モンキーパッチ)。
import diffusers.hooks.taylorseer_cache as ts

_orig_update = ts.TaylorSeerState.update

def _update(self, outputs):
    if not self.is_inactive and self.last_update_step is not None:
        for i, feat in enumerate(outputs):
            prev = self.taylor_factors.get(i, {}).get(0)
            if prev is not None and prev.shape != feat.shape:
                self.taylor_factors = {}
                self.last_update_step = None
                break
    return _orig_update(self, outputs)

ts.TaylorSeerState.update = _update
最初の3ステップは必ず実際に計算する設定なので、1ステップ目を捨てても、2ステップ目と3ステップ目の差分から予測を始められる。確かめたのは、この最初の3ステップを実計算にする設定だけ。
回避策を入れた出力は、use_kv_cache=False にしたTaylorSeerの出力と比べて、画素の平均差(RGB値の差の絶対値の平均、0〜255)が0.0だった。文章だけからの生成でも参照画像を使う編集でも同じで、回避策を入れても出力は変わらなかった。
Diffusersにはissue #14829として再現手順とこの回避策を報告し、メンテナからPRを出してほしいと返信があったので、同じ内容をPR #14831として出した。まだ取り込まれていないので、回避策を入れた生成スクリプトをLiltingChannelLaboに置いた。
俯瞰の生成とかなちゃんの編集での比較
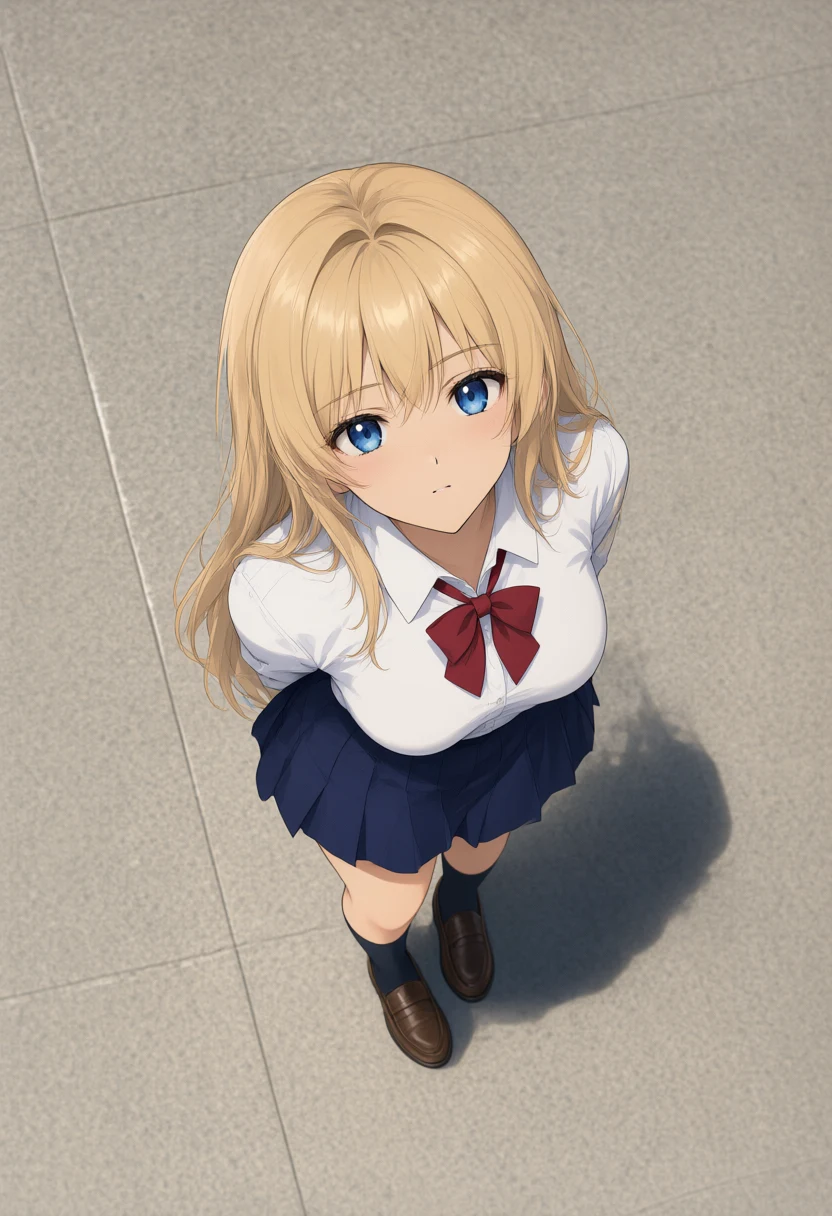
前回の記事と同じ、文章だけから出す俯瞰の画像(表ではT2I)と、オリキャラのかなちゃんの立ち絵を俯瞰へ変える編集の2つで比べた。プロンプトと参照画像は前回と同じ。
| ケース | 条件 | 生成処理 | 実計算 | 実計算1回の平均 | GPU側の確保メモリ・最大 |
|---|---|---|---|---|---|
| T2I 俯瞰 | キャッシュなし | 614.7秒 | 40回 | 15.1秒 | 約45.8GB |
| T2I 俯瞰 | TaylorSeer、KVキャッシュなし | 224.6秒 | 15回 | 14.5秒 | 約45.8GB |
| T2I 俯瞰 | TaylorSeer+KVキャッシュ | 218.8秒 | 15回 | 14.2秒 | 約45.8GB |
| 編集 かなちゃん俯瞰 | キャッシュなし | 721.2秒 | 40回 | 17.4秒 | 約49.0GB |
| 編集 かなちゃん俯瞰 | TaylorSeer、KVキャッシュなし | 484.4秒 | 15回 | 31.6秒 | 約47.0GB |
| 編集 かなちゃん俯瞰 | TaylorSeer+KVキャッシュ | 277.6秒 | 15回 | 16.8秒 | 約48.4GB |
予測で済ませたステップは1回0.1秒もかからないので、生成処理の時間はほぼ実計算の回数で決まった。
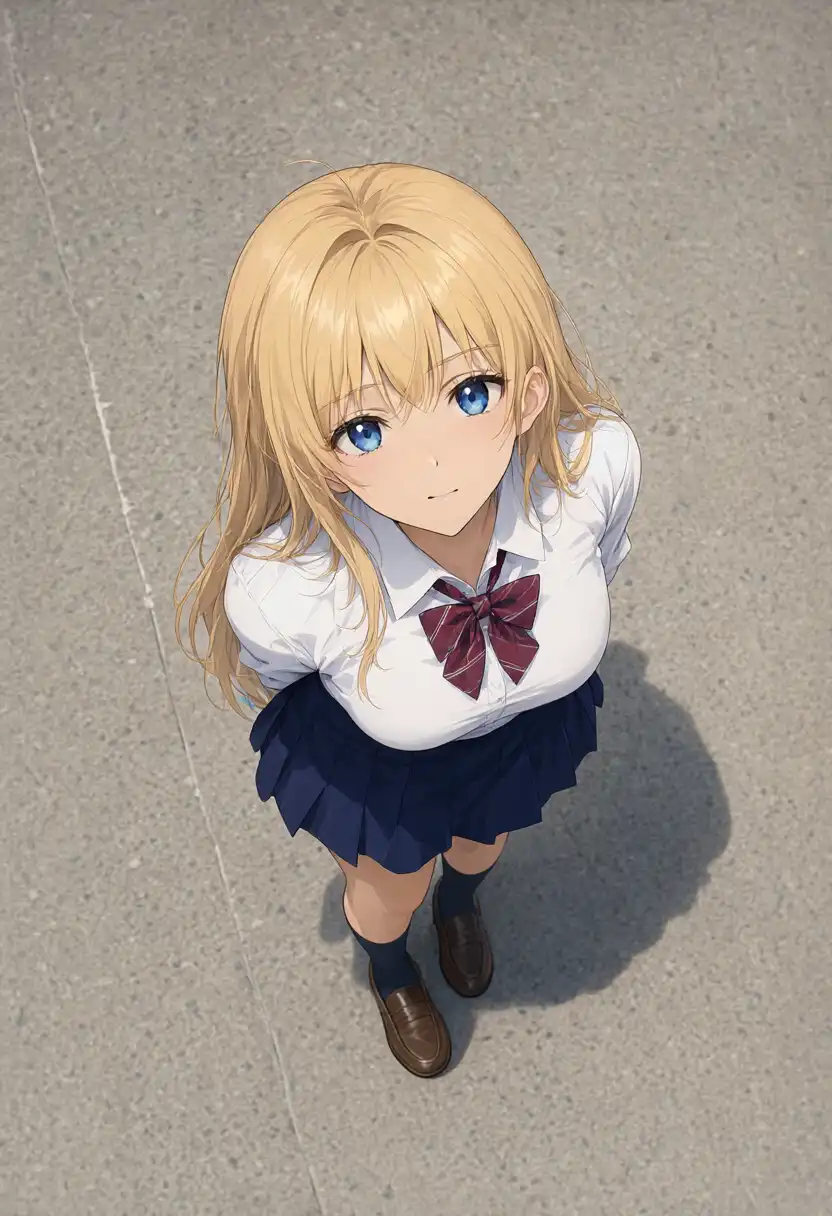
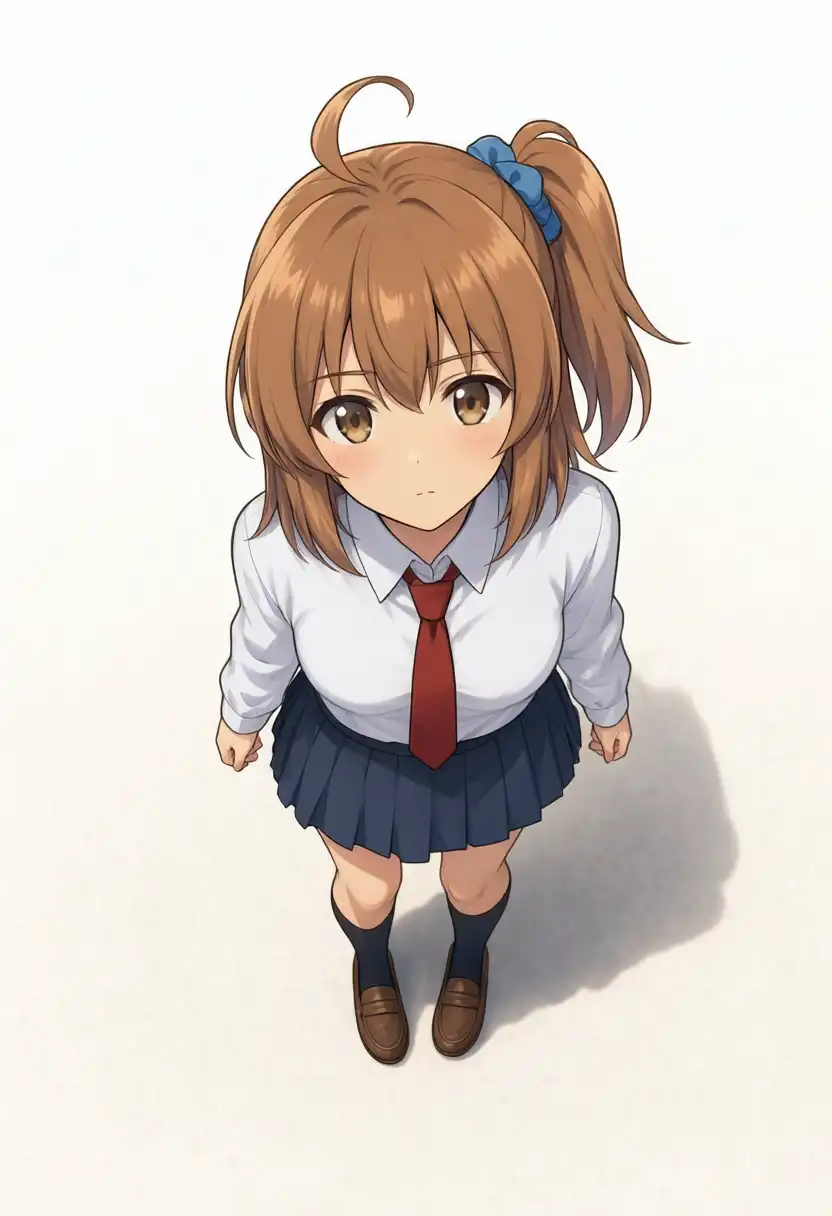
T2Iは614.7秒から218.8秒で約2.8倍。編集は、KVキャッシュを切ると484.4秒で約1.5倍どまりだったが、回避策でKVキャッシュを残すと277.6秒で約2.6倍になった。メモリの最大値はキャッシュなしとほぼ同じだった。
614.7秒
218.8秒
721.2秒
277.6秒
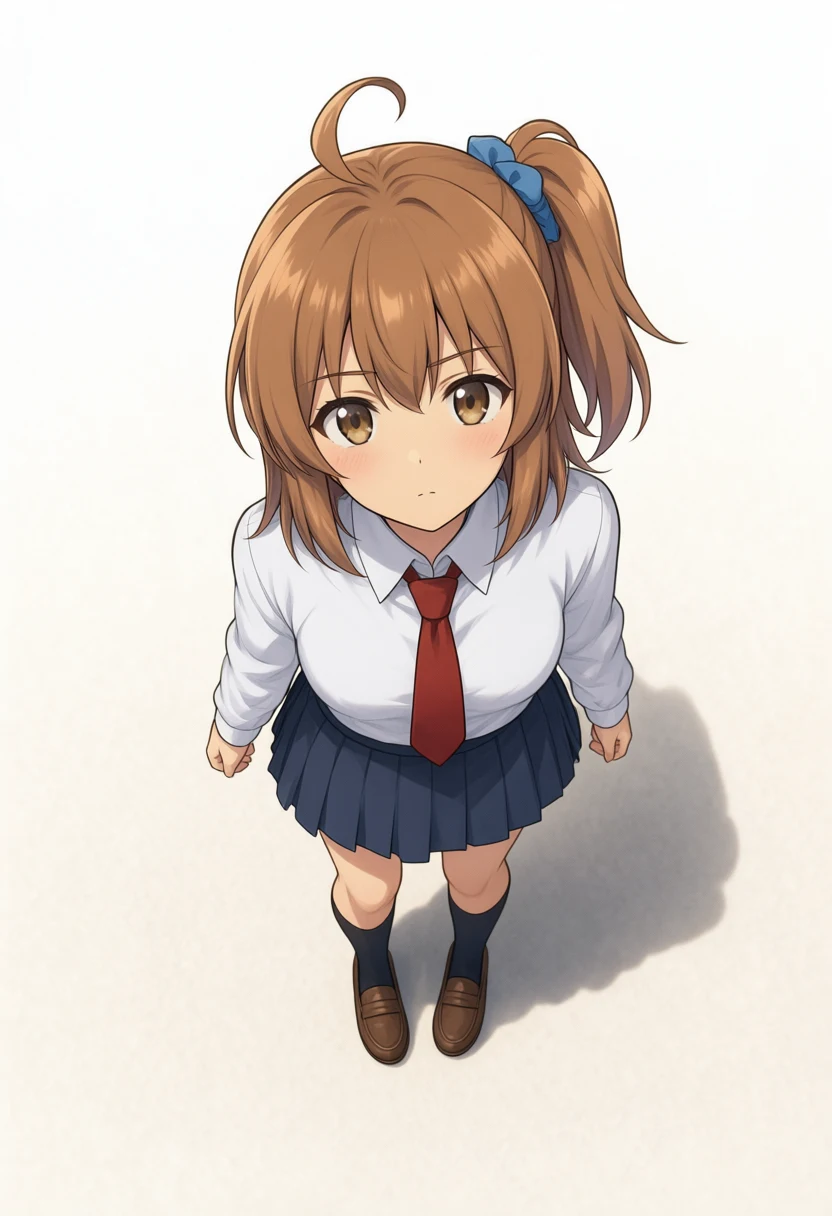
| ケース | キャッシュなしとの違い |
|---|---|
| T2I 俯瞰 | 構図、人物、影の向きは同じ。リボンの柄がストライプからチェックに変わった |
| 編集 かなちゃん俯瞰 | サイドポニー、青いシュシュ、制服、足元の影までほぼ同じ |
立ち絵・走る場面・真後ろでの比較
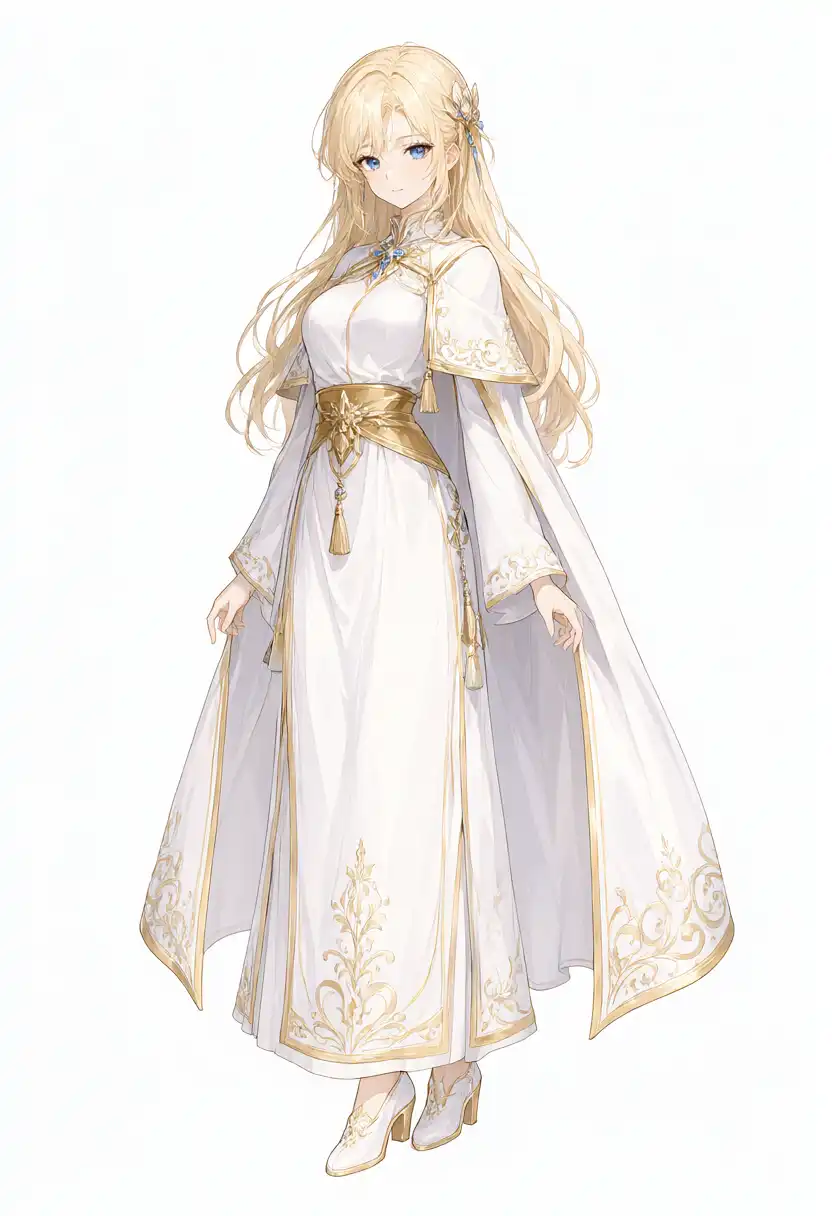
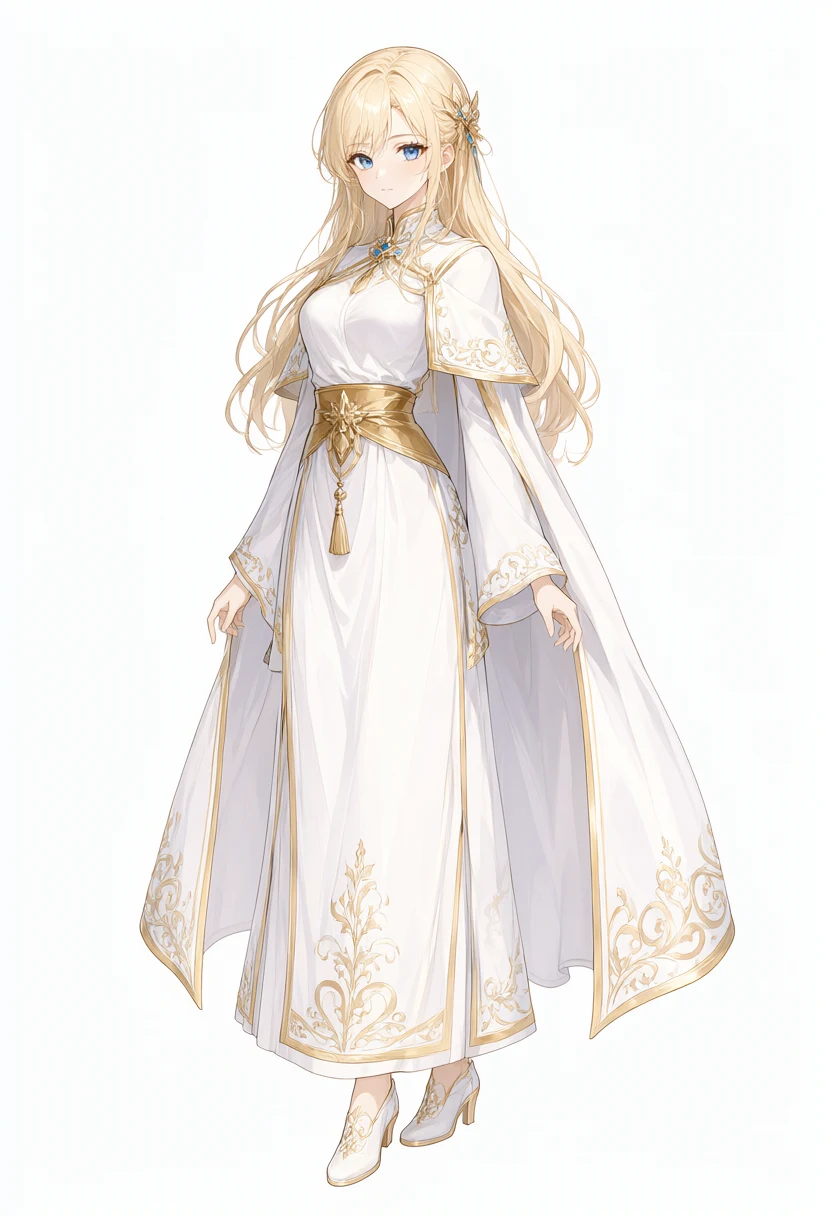
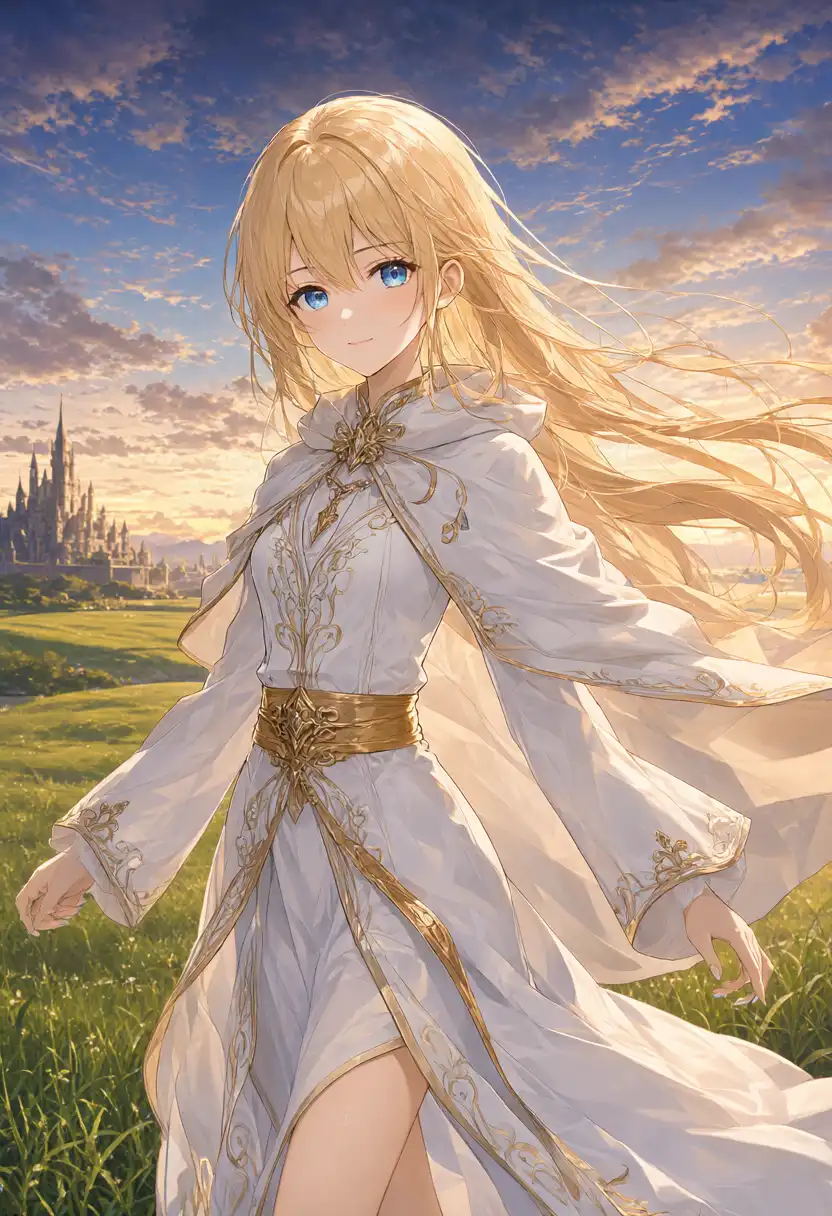
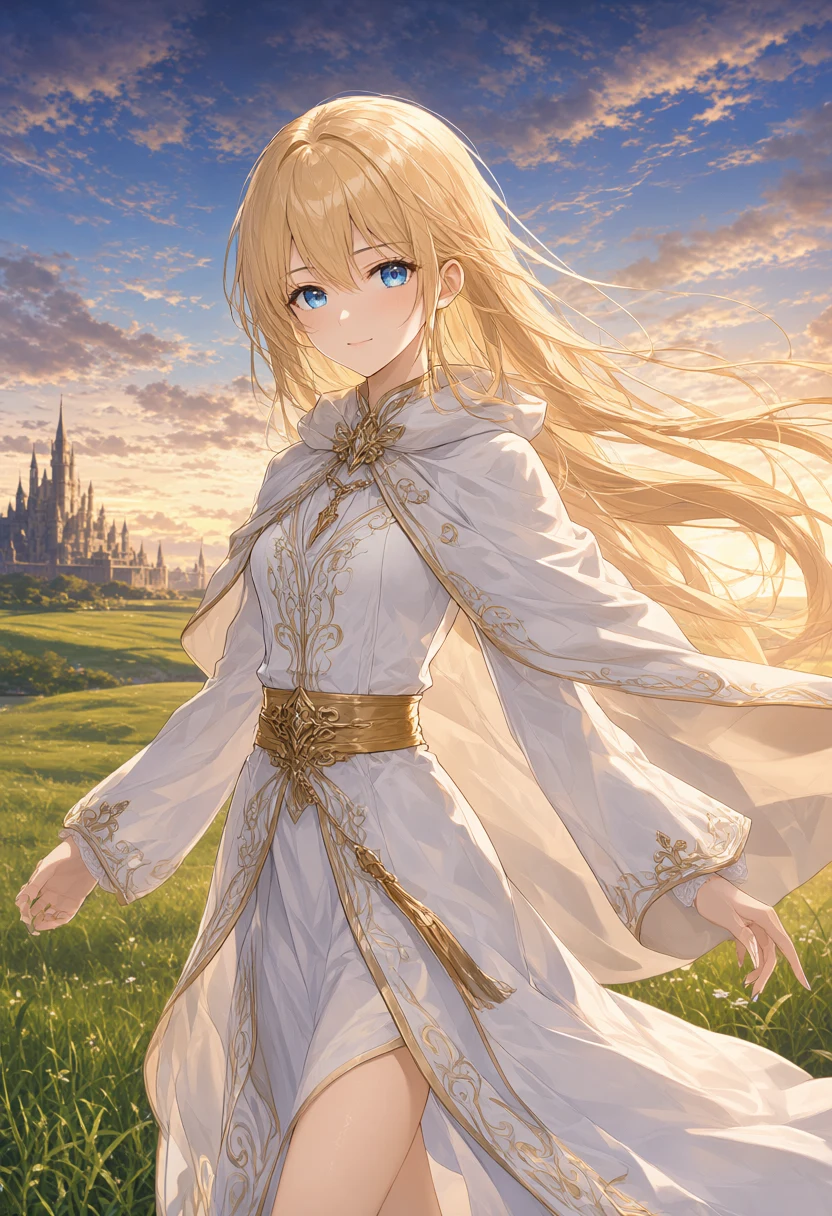
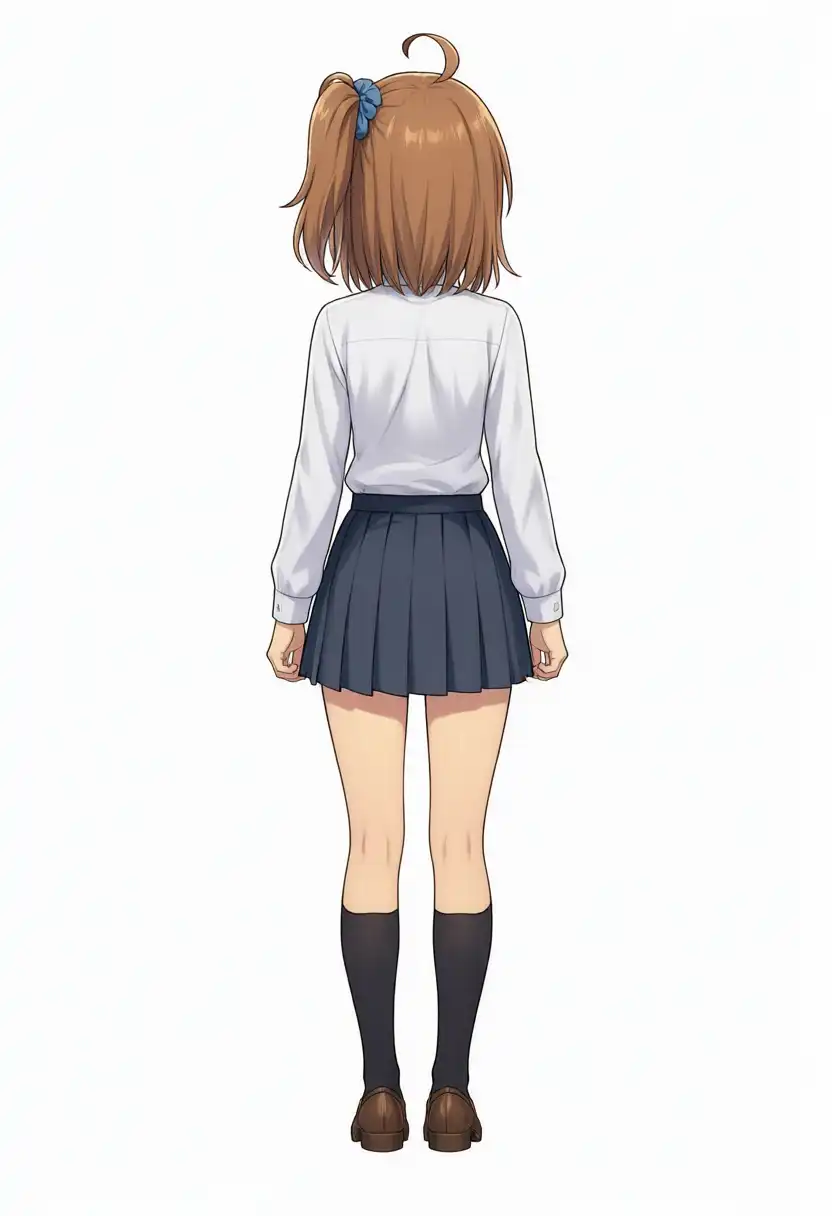
前回の記事でキャッシュなしの出力がある3条件も、同じTaylorSeerの設定で生成した。ローブの立ち絵と走る場面は文章だけからの生成、真後ろはかなちゃんの立ち絵を参照画像にした編集。
| ケース | キャッシュなし | TaylorSeer+KVキャッシュ | 倍率 | 画素の平均差(0〜255) |
|---|---|---|---|---|
| T2I ローブの立ち絵 | 588.2秒 | 216.4秒 | 2.72倍 | 2.76 |
| T2I 走る場面 | 584.1秒 | 218.0秒 | 2.68倍 | 5.98 |
| 編集 かなちゃん真後ろ | 722.0秒 | 280.2秒 | 2.58倍 | 0.62 |
588.2秒
216.4秒
584.1秒
218.0秒
722.0秒
280.2秒
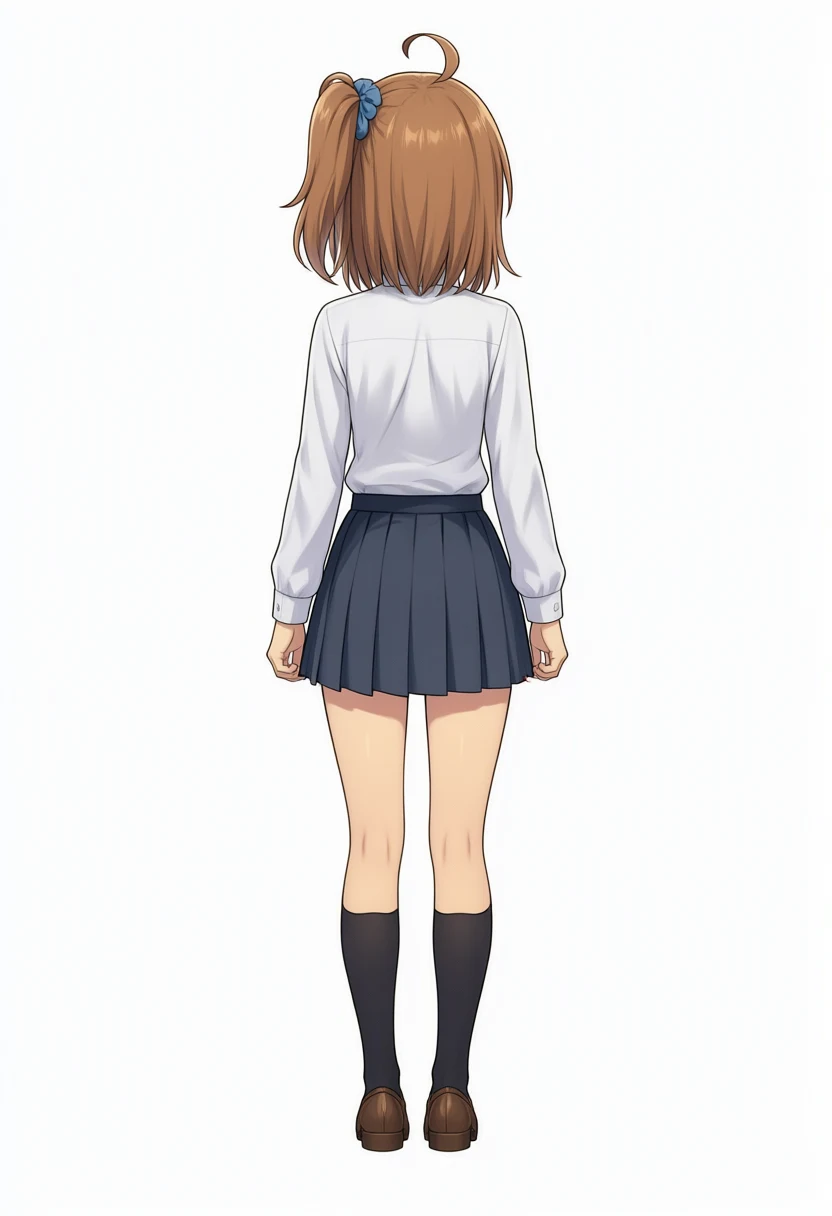
5条件とも約2.6〜2.8倍になった。構図、ポーズ、衣装、キャラの特徴が変わった条件はなく、違いは俯瞰のリボンの柄のような細部だけだった。
画素の平均差は、真後ろの0.62から走る場面の5.98まで開きがある。差がいちばん大きい走る場面でも、人物と構図は同じだった。
実計算の間隔を5と8に広げた場合
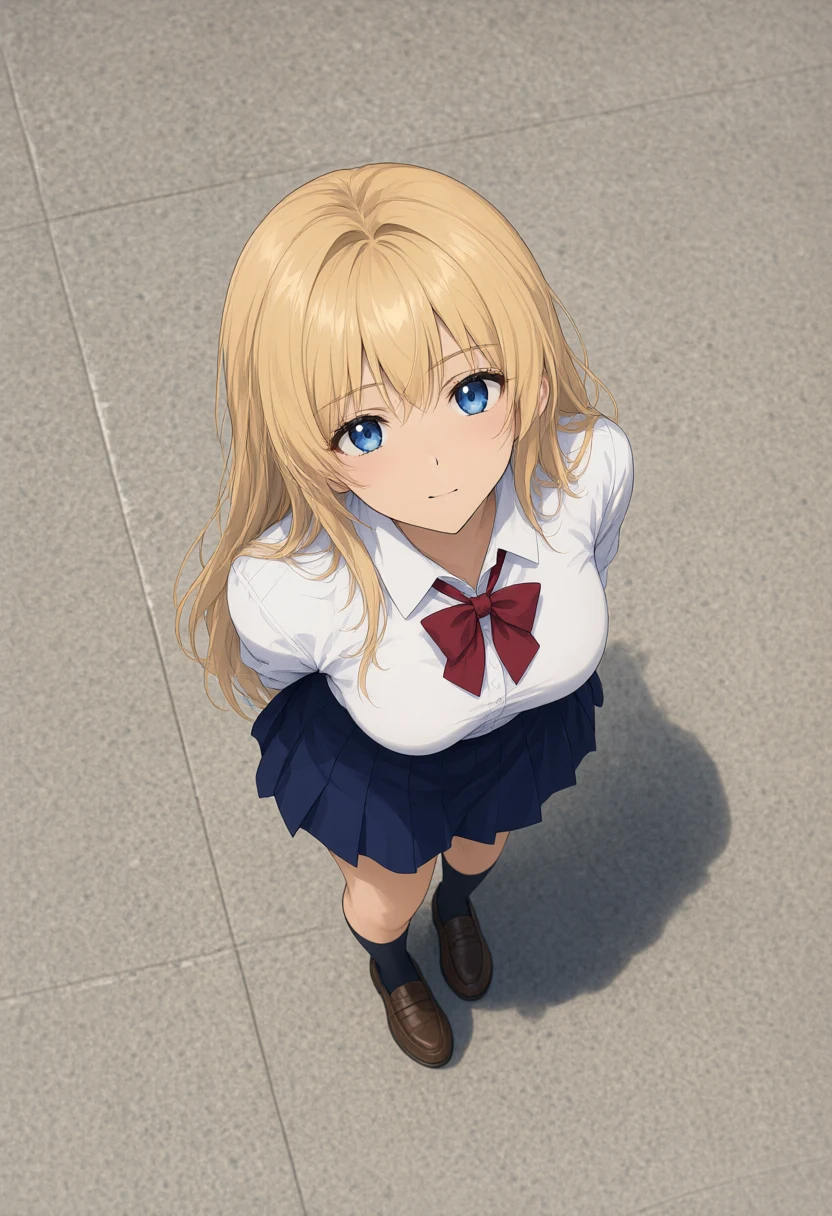
俯瞰のT2Iで、cache_interval を3から5と8に変えて、実計算の回数をさらに減らした。
cache_interval | 実計算 | 生成処理 | 倍率 | 画素の平均差(0〜255) |
|---|---|---|---|---|
| キャッシュなし | 40回 | 614.7秒 | − | − |
| 3 | 15回 | 218.8秒 | 2.81倍 | 4.73 |
| 5 | 11回 | 161.0秒 | 3.82倍 | 7.21 |
| 8 | 8回 | 118.9秒 | 5.17倍 | 13.23 |
614.7秒
218.8秒
161.0秒
118.9秒
顔のまわりを同じ位置で切り出した。
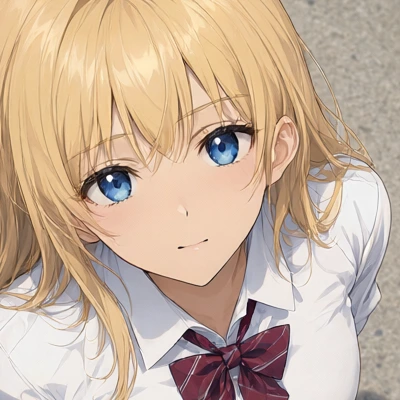
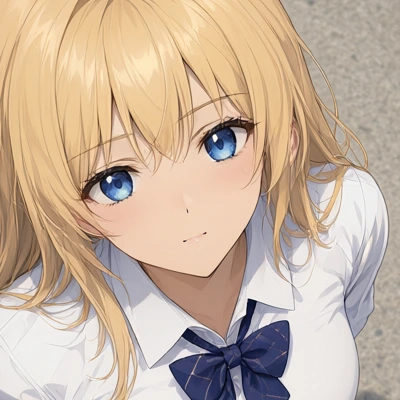
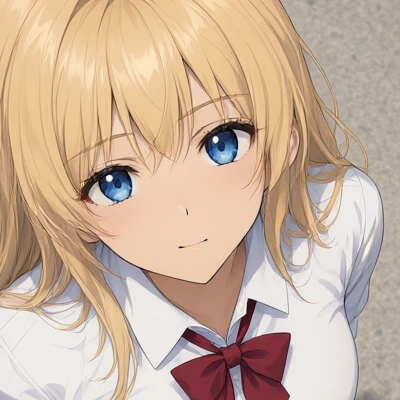
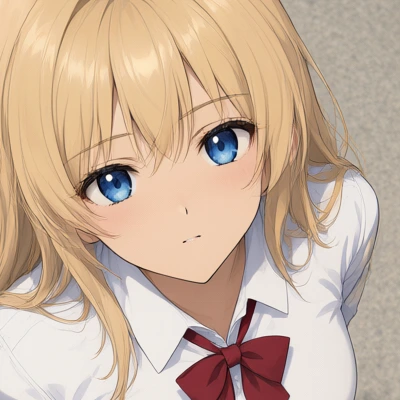
cache_interval | キャッシュなしとの違い |
|---|---|
| 3 | リボンの柄がストライプからチェックに変わった。線の細かさは同じくらい |
| 5 | リボンが無地になった |
| 8 | リボンは無地。髪の細い線が減り、全体に柔らかい |
間隔8でも構図と人物は崩れなかったが、絵は柔らかくなった。
Comfyui-Spectrum-Qwen2.1の作者もREADMEで、出力がベースより柔らかくなると書いている。
関連記事
Qwen-Image 2.1を試した記事。
- Qwen-Image 2.1の早期アクセス版で、効かなかった構図指定とオリキャラの描き分けを試した ModelScope Studioの早期アクセス版で、構図指定10種と4人バンド、かなちゃんの向き・服・ポーズの編集を試した
- Qwen-Image 2.1のローカル版をAnimaと比べた 公開された重みをM1 Max 64GBで動かし、Studioと同じ俯瞰指定と、Anima・WAI-Anima・WAI-Illustriousと同じプロンプトで比べた
- Qwen-Image 2.1の部分編集は、引数1つで位置ずれが約0.1pxになった 表情だけ変える部分編集で位置が保てるかを測り、片方だけの着せ替えと背景の透過も試した