MOSS-ImageのBaseとSFTをM1 Maxで試した
 目次
MOSS-Image-BaseとMOSS-Image-SFTの公開重みをM1 Max 64GBで動かしてみた。OpenMOSSは2026年10月16日にBase版と、それを教師ありで追加学習(SFT)した版を公開した。
文字や物体の配置も指定できるというので、公式の例文とポスターのJSONに加え、4月のAnima比較と9月のQwen-Image 2.1検証で使った立ち絵・夕景も試した。BaseとSFTには各条件で同じ入力を渡し、過去モデルの画像は参考として並べた。
MOSS-ImageのBase・SFTと推奨設定
MOSS-Image公式リポジトリにはBase版とSFT版の配布先がある。立ち絵、走る場面、文字入り画像、JSONの配置指定を両方の重みで試し、同じ指示文と設定を渡した。
| 項目 | 今回使ったもの |
|---|---|
| 開発元 | OpenMOSS Team |
| モデル | MOSS-Image-Base、MOSS-Image-SFT。画像生成部分は5B(約50億パラメータ)のDiT(拡散Transformer) |
| 取得したBaseの重み | 8ファイル、27,199,664,580バイト(約25.33GiB)。テキストエンコーダーと画像復元用のVAEも含む |
| 取得したSFTの差し替え重み | DiTの3ファイル、10,164,664,216バイト(約9.47GiB)。文章処理とVAEはBaseのものを共用 |
| 公開日 | 2026年10月16日 |
| 配布 | Hugging Face、ModelScope |
| ライセンス | Apache 2.0 |
Baseの重みと同梱パイプラインはリビジョン 5f40f07a304541840b6019d2d34d30f966756787、SFTの重みは fc5de0d56fc910cbca6f6625a70f5f582b26deb1 に固定した。参照した公式GitHubリポジトリは 9d799c1e98a72d9f4e7c3d211072fd94cf365dee。
8ファイルのサイズはHugging Faceの公開一覧と同じだった。
5Bは画像生成部分の約50億パラメータを指す。テキストエンコーダーが指示文を数値に変え、DiTがシード42から作ったノイズを少しずつ更新し、VAEが最後に画像へ復元する。ダウンロードした重みは、テキストエンコーダーのほうが画像生成部分より容量が大きかった。
| 部品 | 重みの容量 |
|---|---|
| テキストエンコーダー | 15.63GiB |
| 画像生成部分(DiT) | 9.47GiB |
| VAE(画像への復元) | 0.23GiB |
公式ユーザーガイドにある推奨値を下の表にまとめた。CFGは指示文の反映の強さを調整する値だ。
モデルは自然文、タグ列、JSONレイアウトを受け付ける。JSONレイアウトでは文字や物体の位置を座標で指定する。
| 設定 | 公式の推奨 |
|---|---|
| 解像度 | 約100万、150万、200万画素。幅・高さは16の倍数 |
| ステップ | 50以上 |
| CFG | 3.0。短い指示では上げる選択肢がある |
shift | 5.0 |
| サンプラー | Euler |
| Skip Layer Guidance | ネガティブ側の22番層をスキップ |
ステップ数はノイズを更新する回数を決める。Eulerは1ステップずつ更新する計算法で、shift はその刻み方を変える値。今回はどちらも公式の標準値にした。CFGでは指示文を入れた側と、入れない側の計算結果を組み合わせる。ネガティブ欄に語を入れた場合、後者にはその語を使う。22番層のスキップも後者に適用した。
比較対象
過去4モデルは4月・9月に掲載した画像を使い、今回は再生成していない。比較条件は白背景の立ち絵と、夕暮れの城を背景に走る人物の2種類。人物はどちらも金髪で、白と金のローブを着ている。各モデル1条件1枚なので、画像間の違いをそのままモデル全体の優劣とは言えない。
| 比較ラベル | モデル | 画像の掲載元 |
|---|---|---|
| MOSS Base | MOSS-Image-Base | 今回のM1 Max。モデルカード既定値とUI初期入力を区別して試す |
| MOSS SFT | MOSS-Image-SFT | 今回のM1 Max。Baseと同じ入力を渡す |
| Qwen | Qwen-Image 2.1 | 9月の技術記事 |
| Anima | Anima preview3-base | 4月の技術記事 |
| WAI-Anima | WAI-Anima v1 | 4月の技術記事 |
| WAI-IL | WAI-Illustrious v160 | 4月の技術記事 |
生成条件
MOSSの人物作例は832×1216、文字とポスターは1024×1024で生成した。どちらも公式推奨の約100万画素に当たる。50ステップ、CFG 3、shift 5、シード42は共通。シードは生成に使う乱数の起点で、BaseとSFTを各条件1枚ずつ生成した。LoRAは見た目を追加学習した補助重みで、今回のMOSSには使っていない。NSFWは成人向けの内容指定を指す。
以下の「UI初期入力」は、公式Gradio UIに最初から入っている品質タグとネガティブタグの文字列だ。Gradio画面からは生成せず、これらをPython APIへ渡した。
| モデル | 解像度 | ステップ | CFG | サンプラー・スケジューラー | シード・LoRA | 指示文 |
|---|---|---|---|---|---|---|
| MOSS-Image-Base(主比較) | 832×1216 | 50 | 3.0 | Euler、shift 5 | 42、なし | UI初期入力+4月のタグ列 |
| MOSS-Image-SFT(主比較) | 832×1216 | 50 | 3.0 | Euler、shift 5 | 42、なし | Baseと同じ入力 |
| MOSS-Image-BaseとSFT(元画像の文章化) | 832×1216 | 50 | 3.0 | Euler、shift 5 | 42、なし | UI初期入力+元画像の外見を説明した英文。画像入力なし |
| MOSS-Image-BaseとSFT(冷蔵庫・ポスター) | 1024×1024 | 50 | 3.0 | Euler、shift 5 | 42、なし | 公式ガイドの例文・JSON |
| MOSS-Image-BaseとSFT(NSFW) | 832×1216 | 50 | 3.0 | Euler、shift 5 | 42、なし | 成人を明記した英文。ネガティブ欄は空 |
| MOSS-Image-BaseとSFT(初回) | 832×1216 | 50 | 3.0 | Euler、shift 5 | 42、なし | 4月の指定内容を短い英文に変換 |
| Qwen | 832×1216 | 40 | 1.0 | FlowMatchEulerDiscreteScheduler | 42、なし | 4月と同じタグ列 |
| Anima | 832×1216 | 30 | 4.0 | er_sde、simple | 42、なし | 4月のタグ列 |
| WAI-Anima | 832×1216 | 30 | 4.0 | er_sde、simple | 42、なし | 4月のタグ列 |
| WAI-IL | 832×1216 | 25 | 5.0 | euler_ancestral、karras | 42、なし | 4月のタグ列 |
BaseとSFTのモデルカードは、Python実行時のネガティブプロンプト既定値を空欄としている。一方、ユーザーガイドは品質を下げる語をネガティブ欄に入れるよう勧め、公式Gradio UIには品質タグとネガティブタグが初期入力される。
MOSSのガイドはタグ列にも対応すると書いている。初回は元のタグ列と同じ内容を英語の自然文に直し、画風も anime illustration と指定した。Base/SFTの2枚ともネガティブ欄はモデルカードの既定値に沿って空欄、uncond_skip_layers=[22] は有効にした。次のタグ列試験ではUIの初期入力を使った。
UI初期入力の文字列はPython APIの prompt と negative_prompt に渡した。
| 比較した作例 | BaseとSFTへ使った入力 | ネガティブ欄 |
|---|---|---|
| 白背景の立ち絵 | 元のタグ列にGradio UIの品質タグを先頭追加 | UI初期値の5語 |
| 城を背景に走る場面 | 元のタグ列にGradio UIの品質タグを先頭追加 | UI初期値の5語 |
| 元画像を文章化した立ち絵 | 英文に同じ品質タグを先頭追加。元画像は入力しない | UI初期値の5語 |
| 冷蔵庫の中国語メモ | 公式ガイドの例文を改行も含めて入力 | 公式例どおり空欄 |
EXPLORE のポスター | 公式ガイドのJSONをそのまま入力 | 空欄 |
| NSFWタグなし | 成人を明記した英文。品質タグは足さない | 検証目的のため空欄 |
| NSFWタグあり | 別の構図を指定した英文の先頭に NSFW. を追加 | 検証目的のため空欄 |
上の7条件では、画像サイズ、50ステップ、CFG 3、shift 5、層22のスキップ、シード42をBaseとSFTでそろえた。NSFWの2条件だけは内容指定を見るため、公式UIの品質・ネガティブ初期入力から外した。
比較画像はクリックすると単体で開ける。
BaseとSFTは同じパイプラインとシード42で画像の初期ノイズを作る。一方、過去4モデルの実装、ステップ数、CFGはそろっていない。同じシード番号でもMOSSと過去モデルの初期ノイズは同じにならない。
過去記事のQwenとAnimaの出力には、MOSSへ足した公式UIの品質タグとネガティブタグを後から適用できない。4月のAnima系3モデルはネガティブ指定の記録もない。過去モデルとの差には入力条件の違いも含まれる。
検証環境とMPSでの起動
実験機はMacBook Pro M1 Max・64GB、macOS 27.0。公式の実行例はNVIDIA GPU向けのCUDAだが、ここではApple GPU向けのMPSを使い、Python 3.12.12の専用環境を作った。
実行時には PYTORCH_ENABLE_MPS_FALLBACK=1 を指定し、MPSで扱えない演算はCPUへ回す設定にした。
| ライブラリ | 今回のバージョン |
|---|---|
| PyTorch | 2.14.1 |
| Diffusers | 0.41.0 |
| Transformers | 5.20.1 |
| Accelerate | 1.15.0 |
DiTとテキストエンコーダーは bfloat16、VAEは float32 で読み込んだ。bfloat16 は数値を16ビット、float32 は32ビットで扱う。
PyTorchがGPU計算を担い、Diffusersから公式パイプラインを呼び出した。Transformersは指示文を短い単位へ分けて数値にする処理で使う。スワップは、メモリからあふれたデータをストレージへ一時的に置く領域だ。
最初の実行では、手動ダウンロード時に公式配布の tokenizer/chat_template.jinja を取得しておらず、文章の処理で止まった。このファイルは指示文をテキストエンコーダー向けの形に整えるひな形だ。作業用 tokenizer_config.json の chat_template にQwen3.5-9Bのテンプレートを補い、後で公式のJinjaファイルと内容が一致すると確認した。次はMPS上の float64 計算で止まった。
| 停止した箇所 | エラーと対処 |
|---|---|
| 文章の処理 | 手動取得時に公式の chat_template.jinja を取得していなかったため、apply_chat_template() が失敗。Qwen3.5-9Bの公式テンプレートを作業用 tokenizer_config.json に追加した |
| 時刻埋め込み | 今回のMPS環境では float64 テンソルの作成で止まった。該当計算だけCPUで float64 のまま行い、結果を float32 でMPSへ転送した |
時刻埋め込みは、生成が今どの段階かをモデルに伝える計算。float64 と float32 は計算に使う数値の精度を表す。フォールバックを有効にしてもこのエラーが出たため、BaseとSFTの作業用コピーに同じパッチを当てた。変えたのはこの計算をCPUで実行する部分だけで、重みは変更していない。CUDAで同条件の画像は生成していないため、MPS実行やパッチが画質へ影響したかは分からない。
公式ComfyUIノードの文章整形と照らすと、追加したテンプレートは今回試した自然文・タグ列・JSONの指示文で同じ <|im_start|>user 形式になった。
GPUへの転送後、torch.mps.driver_allocated_memory() が返したMPSドライバーの確保量は約27.75GBだった。
512×512・4ステップ・CFG 3・shift 5・シード42で A cat を送るとPNGを保存できた。生成処理は25.40秒、モデルのMPS転送は9.00秒。MPSドライバーの確保量は転送後27.75GB、生成後30.14GBで、生成後に確認したスワップ使用量は0。
4ステップの画像はぼやけていた。
公式の文字入りプロンプト
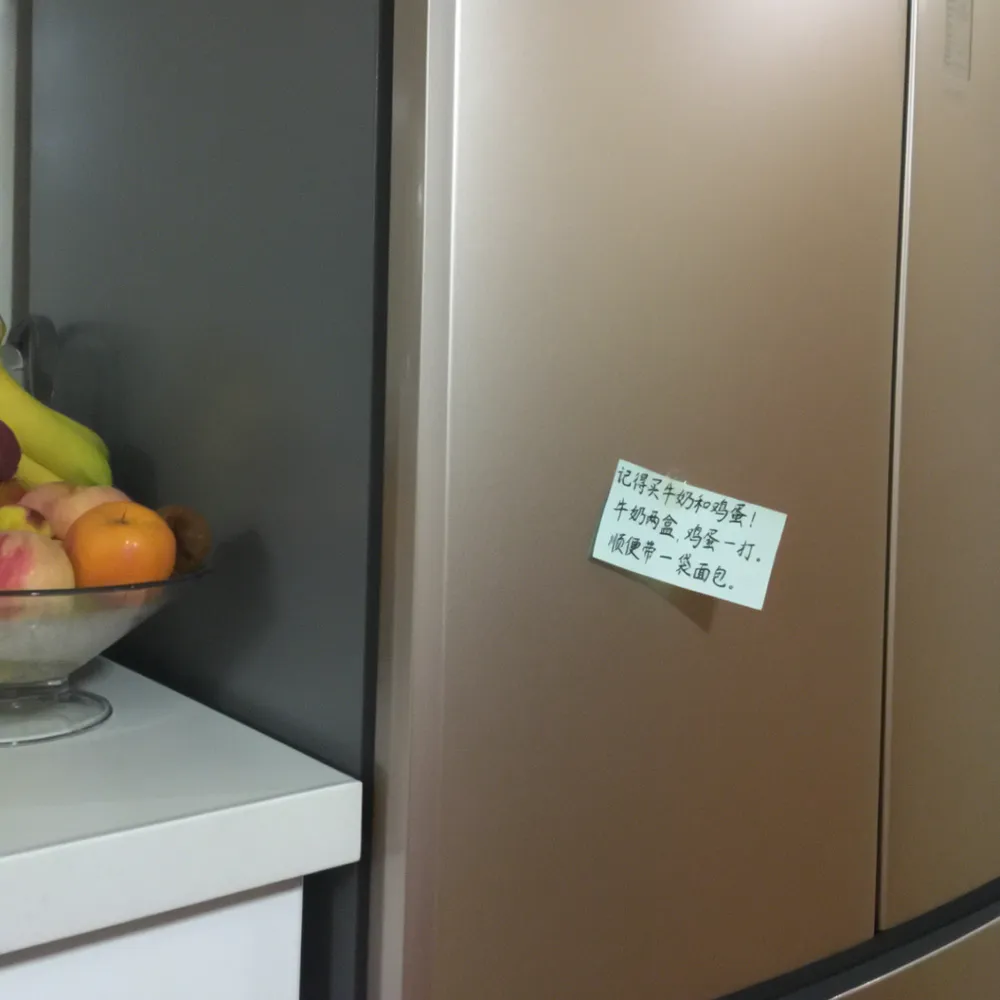
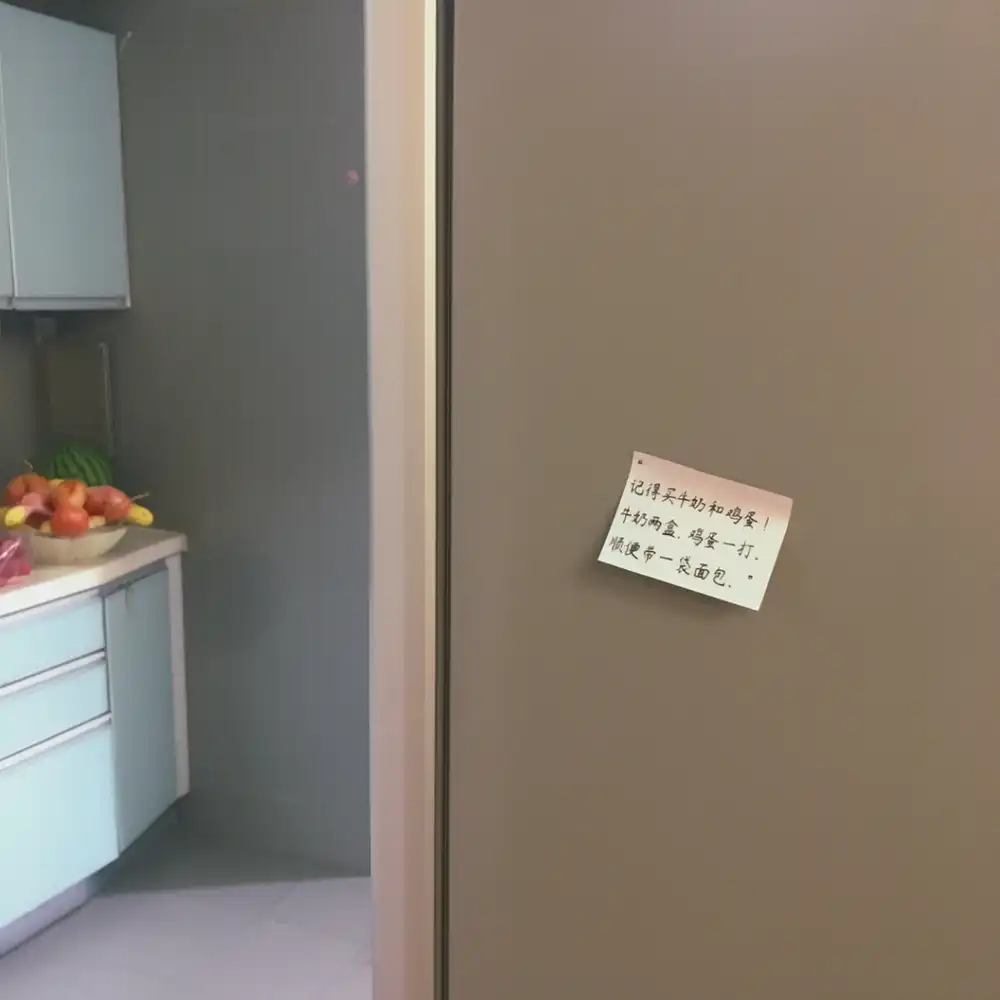
冷蔵庫のメモに中国語を書く公式ユーザーガイドの例文を、改行も含めてBaseとSFTへ同じように送った。
1024×1024、50ステップ、CFG 3、shift 5、Euler、層スキップ22、シード42、ネガティブ欄は空欄。
1024×1024はガイドの約100万画素の推奨範囲で、BaseとSFTのモデルカードに載るPython例と同じ解像度だ。
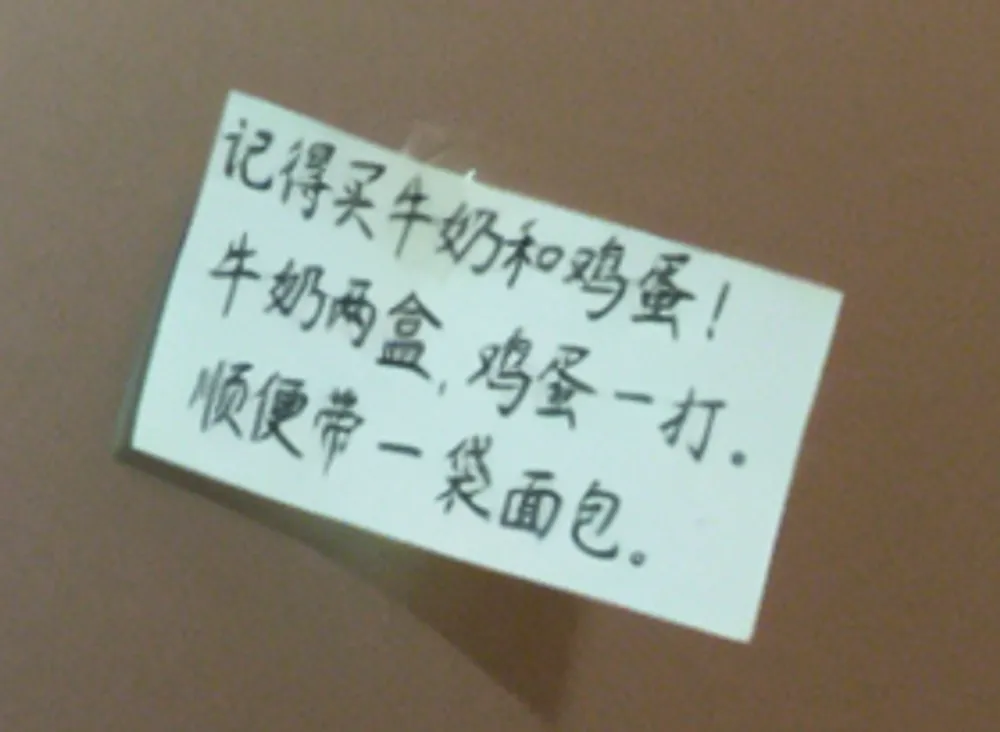
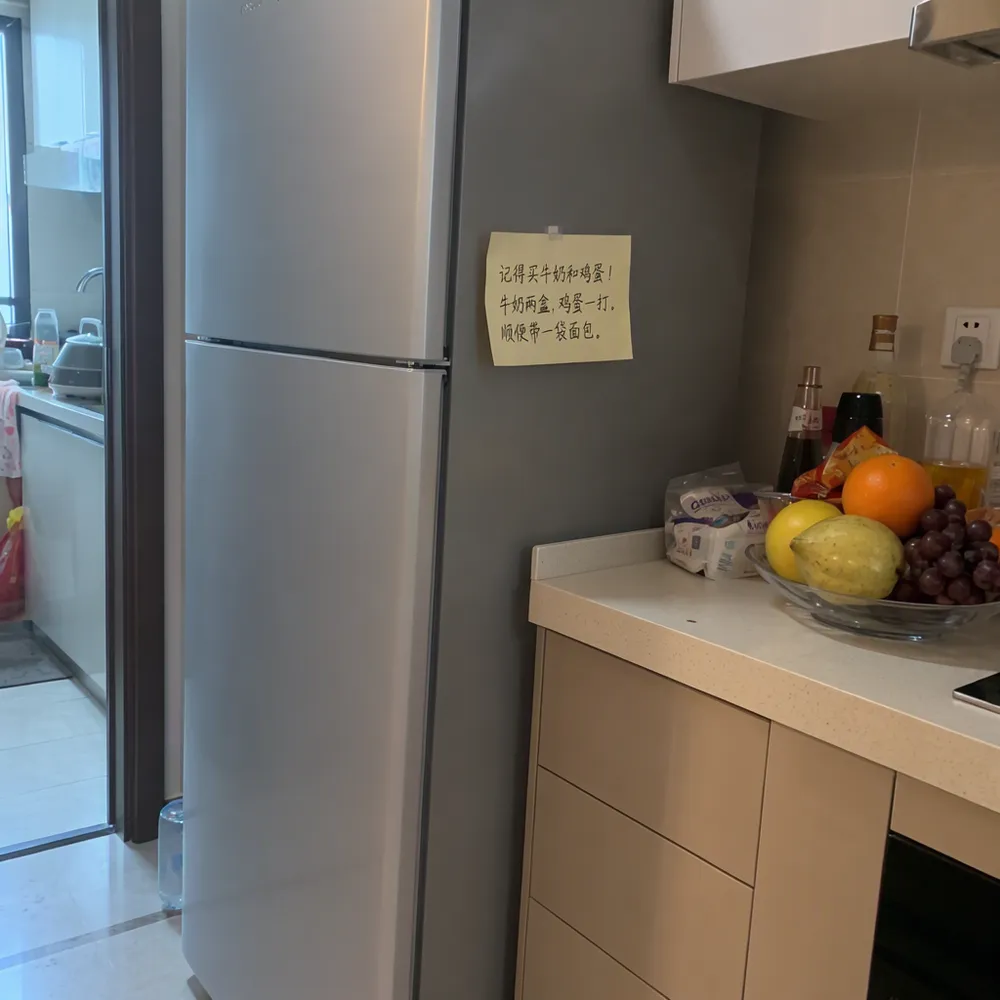
画像の下には、原寸PNGから付箋部分を切り出して拡大した画像も置いた。文字の判読には全体画像だけでは小さすぎる。
(ユーザーガイド例文)
付箋の拡大
(同じ例文)
メモの拡大
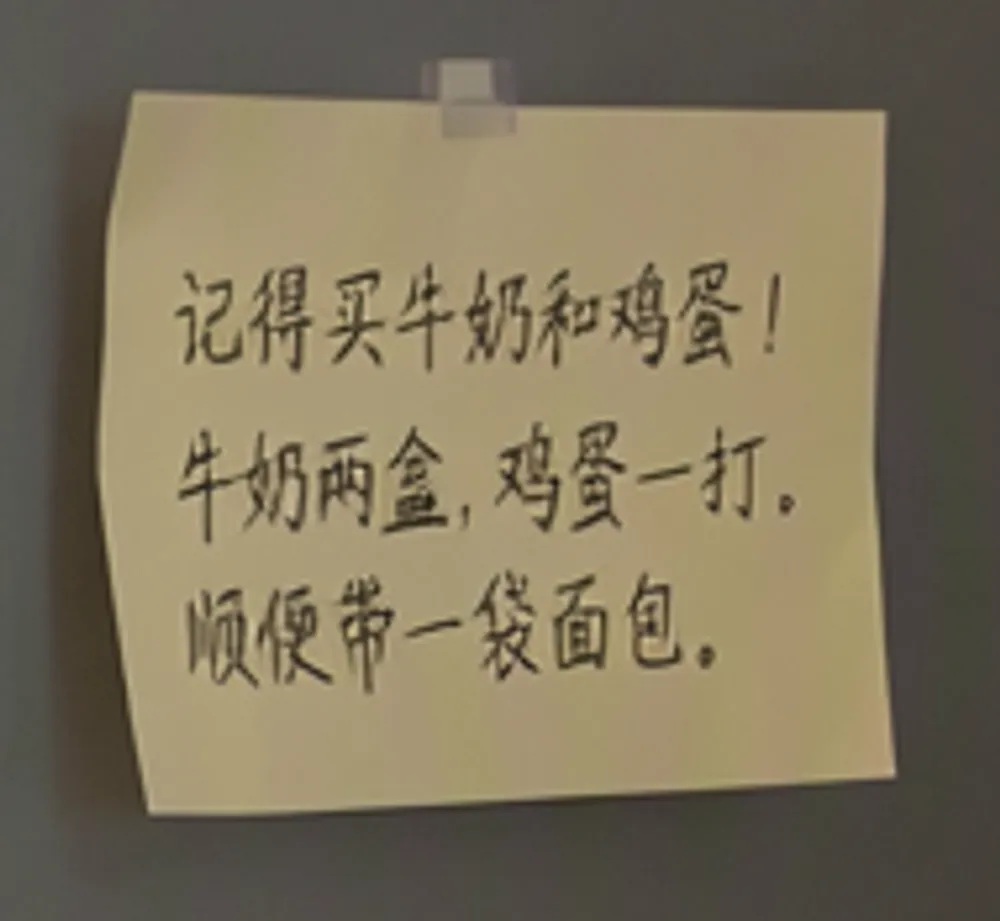
| モデル | 画像で確認したこと |
|---|---|
| MOSS-Image-Base | 冷蔵庫の扉に付箋を貼り、台と果物も描いた。拡大したメモは3行とも指定文として読める。 |
| MOSS-Image-SFT | 冷蔵庫、台、果物を描き、メモも3行になった。ただしメモは冷蔵庫の扉ではなく、隣の灰色の面に貼られている。 |
macOSの文字認識は、原寸PNGのBase/SFT両方から指定の中国語3行を読み取った。OCRの信頼度は文字認識側が各行につける推定値で、Baseの2行目だけ0.50、SFTは3行とも1.00だった。
1.00でも文字の形や句読点まで完全に合っているとは言えない。SFT版のメモも3行読めるが、冷蔵庫の扉には貼られていない。
生成処理はBaseが1,189.91秒、SFTが1,189.43秒で、生成後のスワップ使用量はどちらも0だった。
BaseとSFTへ送った公式ガイドの例文
A wide view of a refrigerator beside a kitchen counter with a fruit bowl. A small sticky note on the refrigerator door is handwritten in Chinese:
“记得买牛奶和鸡蛋!
牛奶两盒,鸡蛋一打。
顺便带一袋面包。”
ネガティブ欄は空欄。改行と引用符はユーザーガイドの例文に合わせた。
最初に試したREADME版のBase出力
公式READMEのPython例は Chinese:“ とコロンの直後に引用符を置き、ユーザーガイドはコロンの後で改行してから引用符を置く。下の初回Base画像はREADMEの例文を使った。ほかの生成条件は上のBaseと同じ。
READMEにある1456×1456での初回試行は、3ステップを終えるまでに約3分かかった。50ステップでは時間が長くなるため、モデルカードのPython例と同じ1024×1024で生成した。生成処理は1,275.48秒、生成後のMPSドライバー確保量は38.79GB、スワップ使用量は0。
原寸PNGを拡大すると1・2行目は指定文として読めた。3行目の一字は指定文と同じか判別しづらく、末尾の句点はピリオド風で右端に余分な点も見える。macOSの文字認識では3行目が「顺便常一袋面包.」となり、信頼度は0.30だった。
JSONレイアウトでポスターの配置を指定した
公式ユーザーガイドのJSONレイアウト例をBaseとSFTで試した。
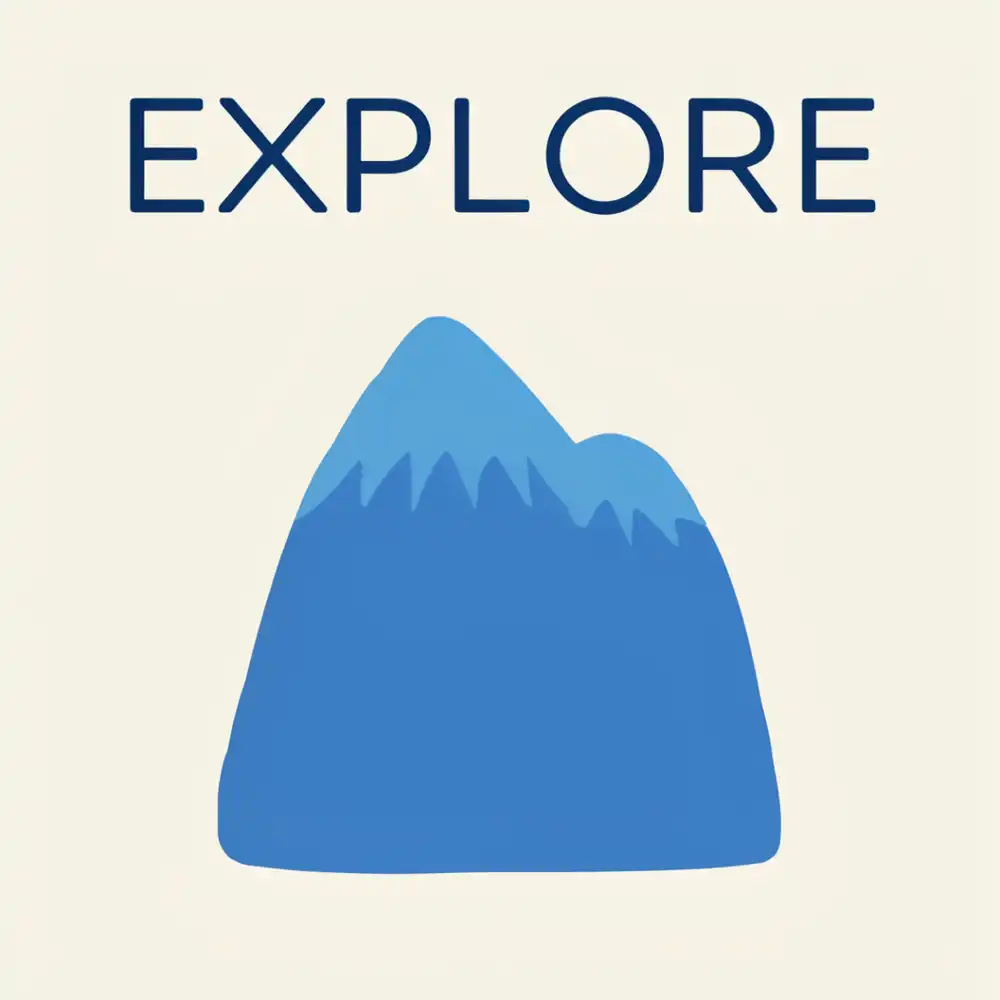
クリーム色の背景に青い山を置き、上部に EXPLORE と書く1024×1024のポスターだ。文字と山に個別の座標が付き、ガイドでは実験的な機能とされている。
両モデルへ同じJSON文字列を送り、ネガティブ欄は空にした。
(公式JSON)
(同じJSON)
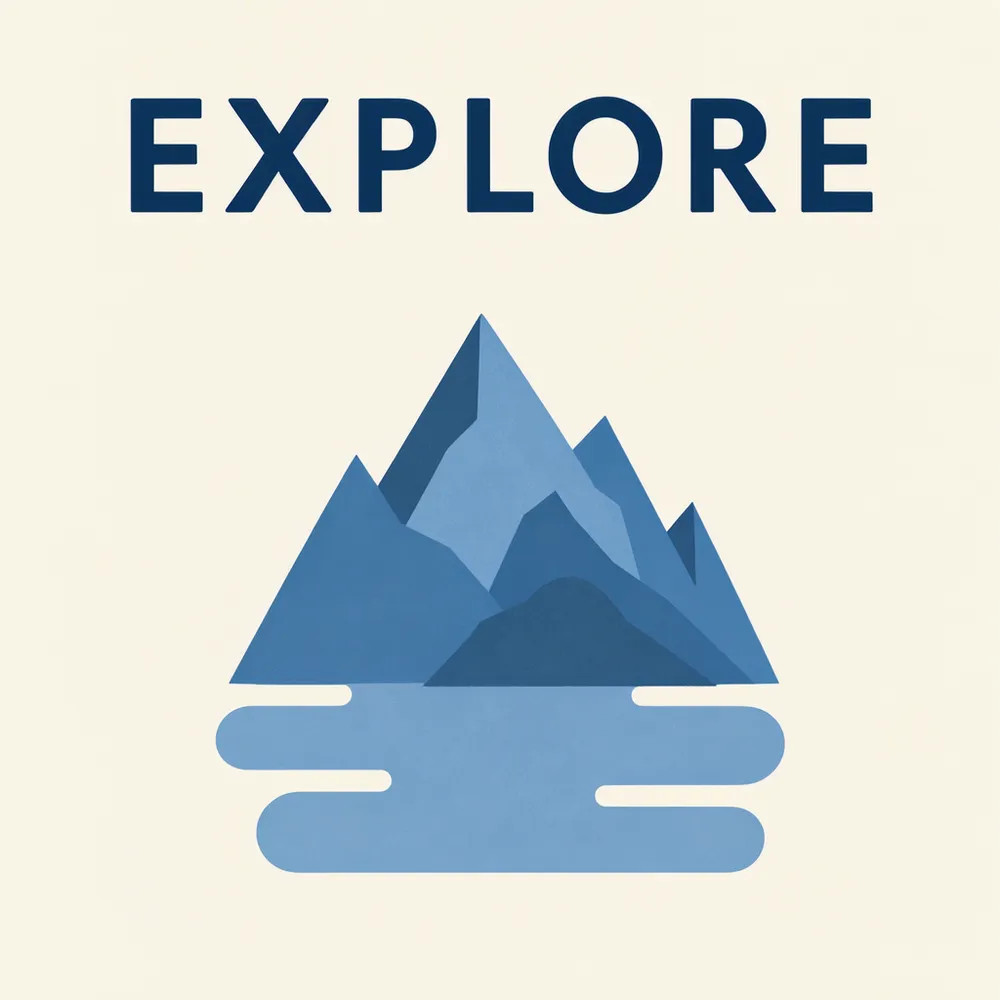
| モデル | 画像で確認したこと |
|---|---|
| MOSS-Image-Base | EXPLORE を正しい綴りで上部に描き、丸みのある青い山を下側の中央に置いた。背景はクリーム色。 |
| MOSS-Image-SFT | EXPLORE を正しい綴りで上部に描き、角張った複数の青い山と横長の青い帯を下側に描いた。背景はクリーム色。 |
原寸PNGで同じ青色の閾値を使って文字と山の領域を測ると、どちらも指定範囲との差は文字で最大6ピクセル、山で最大4ピクセルだった。ガイドの bbox は中央を原点とする [上, 左, 下, 右] で、1024×1024では各軸が−512から512まで。下の指定範囲は各値に512を足し、画像左上を原点とするピクセル座標へ換算した。色の境目をどう拾うかで端の数値は変わり、厳密な物体検出ではない。
SFTは山に加えて下側の青い帯も描いた。生成処理はBaseが1,228.94秒、SFTが1,236.49秒だった。
| 要素 | 指定した範囲(x、y) | Baseの色領域(x、y) | SFTの色領域(x、y) |
|---|---|---|---|
EXPLORE | x=128〜896、y=96〜224 | x=134〜896、y=100〜220 | x=134〜893、y=99〜219 |
| 青い山 | x=224〜800、y=320〜896 | x=223〜800、y=324〜895 | x=221〜804、y=321〜894 |
送ったJSONレイアウトの座標と設定
公式ガイドのJSON例から項目と座標を変えずに使った。
公式JSONの元の bbox は次の値だ。
| 要素 | bbox |
|---|---|
上部の EXPLORE | [-416, -384, -288, 384] |
| 下部の青い山 | [-192, -288, 384, 288] |
色領域の計測では画像左上を原点にした。文字は上から300ピクセル以内で R<80, G<120, B<180, B>R+20、山は上から250ピクセル以降で R<180, B>R+25, B>G+10 の画素を拾い、それぞれ全画素の外接範囲を求めた。つながった領域の分離や物体認識はしていないため、青い帯も山側の範囲に含まれうる。
実際に送った1行の文字列は次のとおり。JSONは ensure_ascii=False で文字列にした。
{"summary": {"meta": ["poster"], "canvas": "single", "caption": "A minimalist travel poster with a cream background, a blue mountain illustration, and the title EXPLORE at the top."}, "items": [{"label": "text", "caption": "Large dark-blue uppercase title centered at the top.", "text": "EXPLORE", "bbox": [-416, -384, -288, 384]}, {"label": "object", "caption": "A flat blue mountain illustration in the lower center.", "bbox": [-192, -288, 384, 288]}], "bbox_coord_space": "abs_centralized", "bbox_format": "yxyx"}1024×1024、50ステップ、CFG 3、shift 5、Euler、uncond_skip_layers=[22]、シード42。ネガティブ欄は空欄。
MOSSの立ち絵・夕景を過去4モデルと比べた
過去の比較ではLoRAでキャラクターや喫茶店の背景をそろえた。MOSS向けのキャラクターLoRAは手元になく、今回は素のモデル同士を比べた。
白背景の立ち絵
最初の短い英文・空のネガティブ欄の結果は後述する。ここでは4月のタグ列に公式UIの品質タグを足し、ネガティブ欄もUI初期値の5語でそろえたBase/SFTのペアを主比較にした。
(UI初期入力)
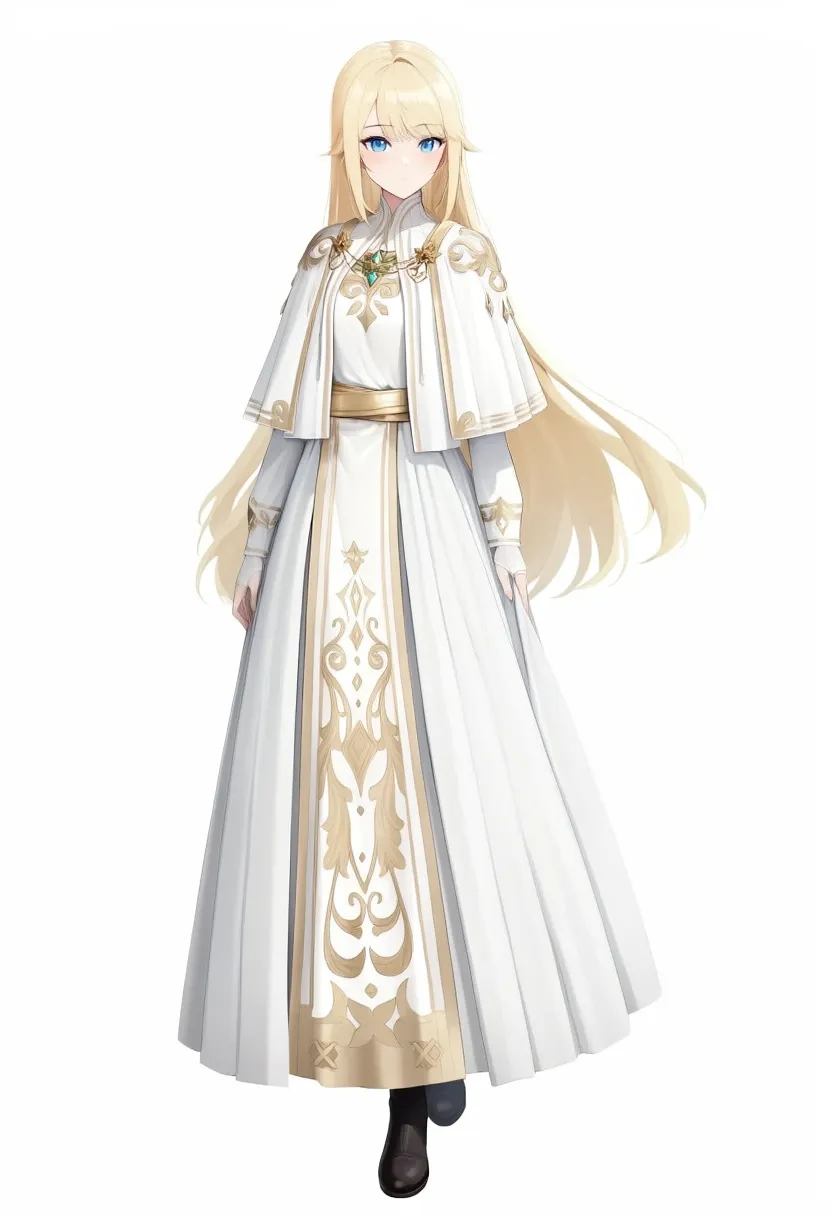
(同じ入力)
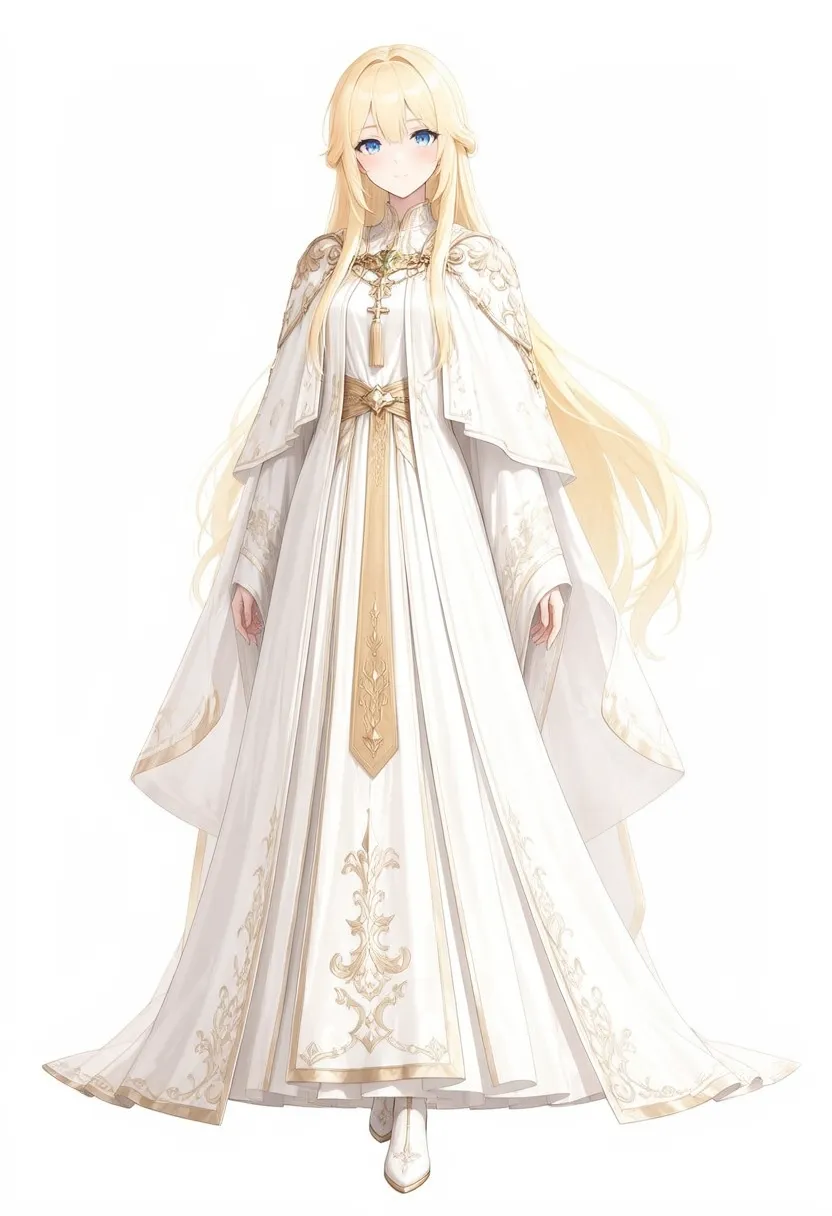
(9月の出力)
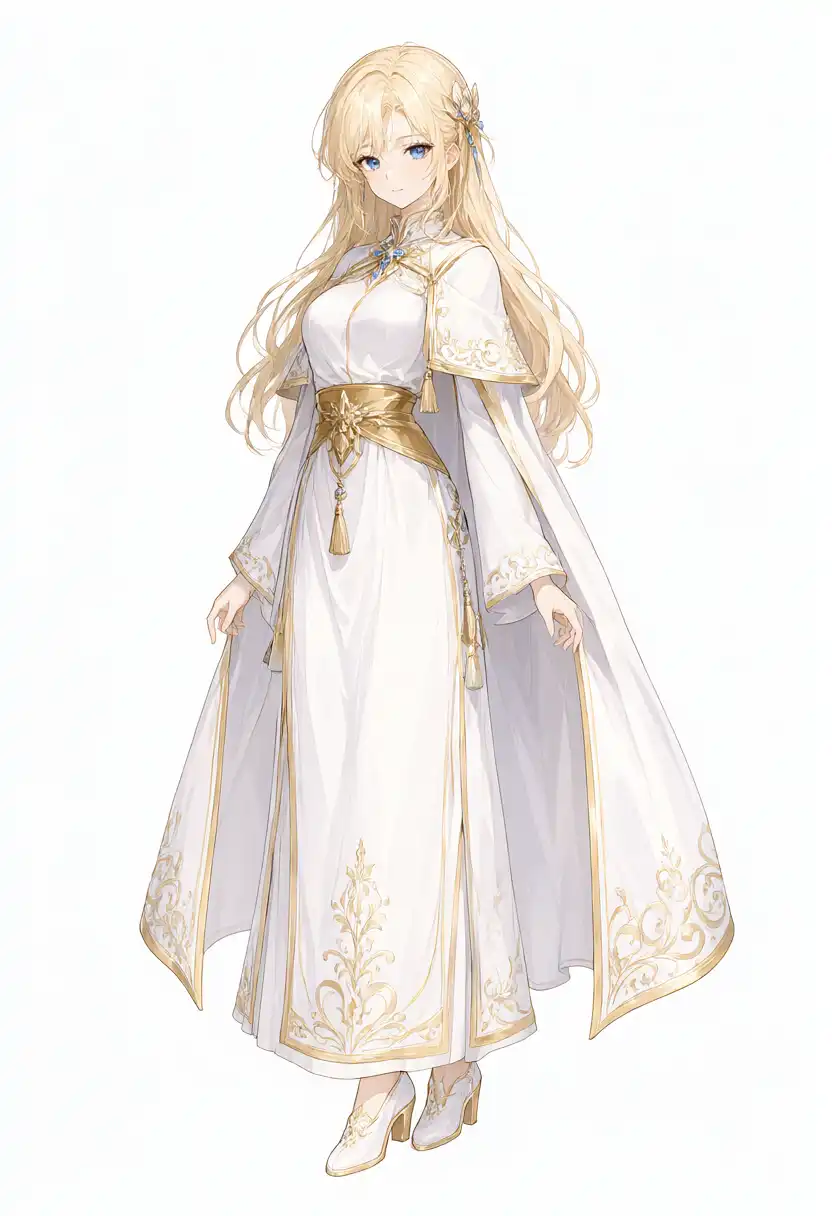
(4月の出力)
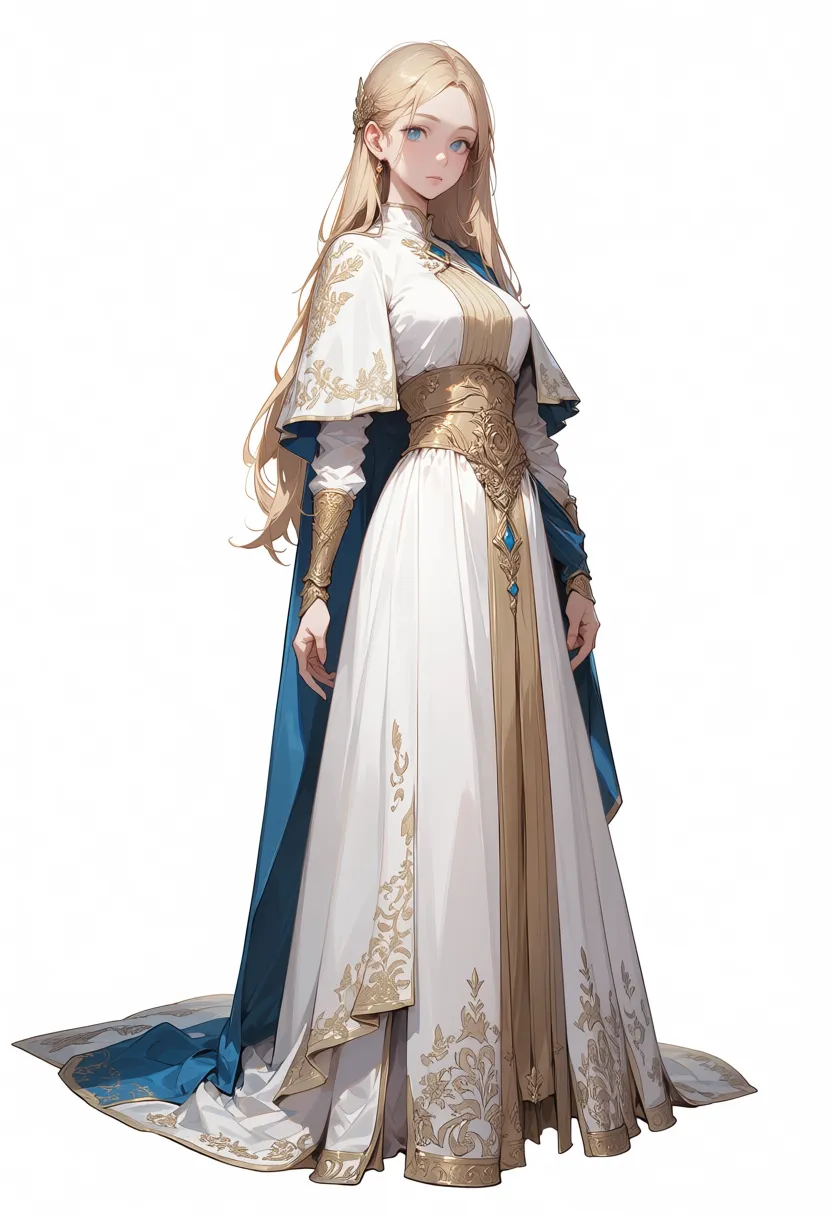
(4月の出力)
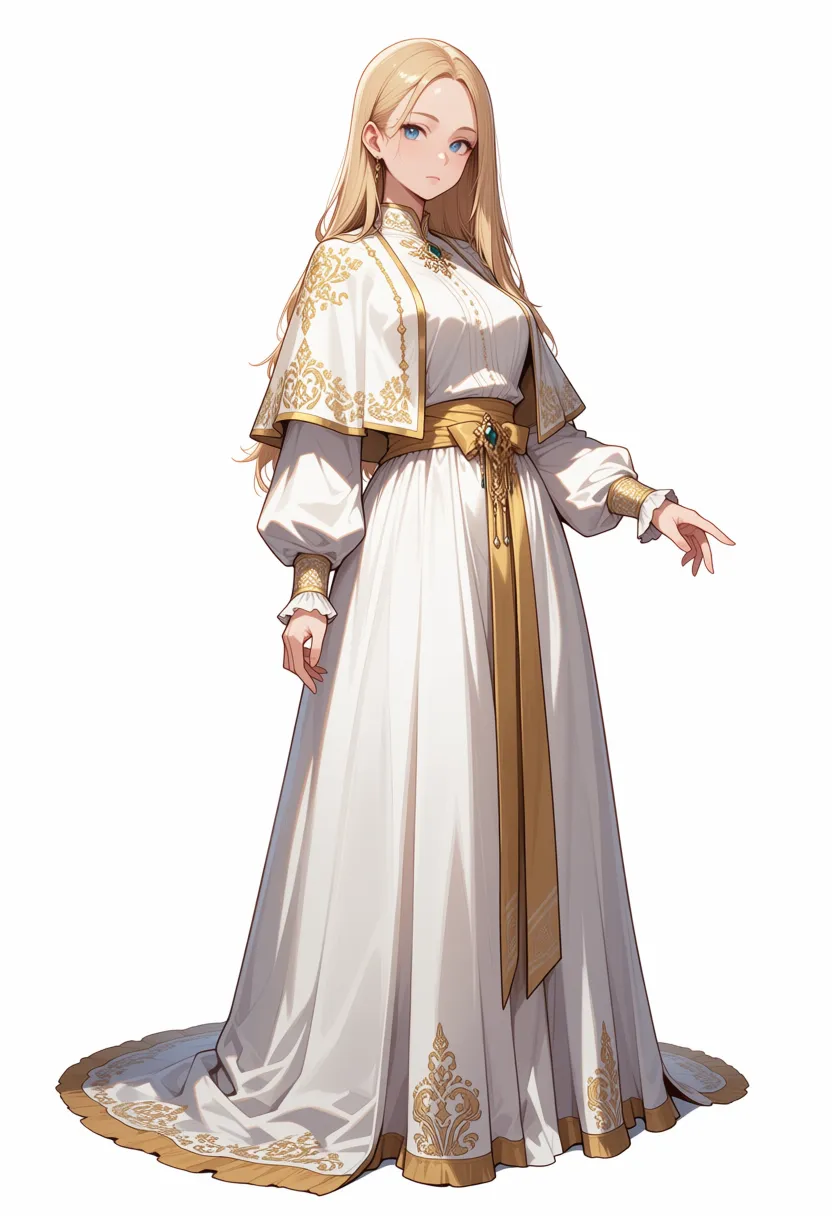
(4月の出力)
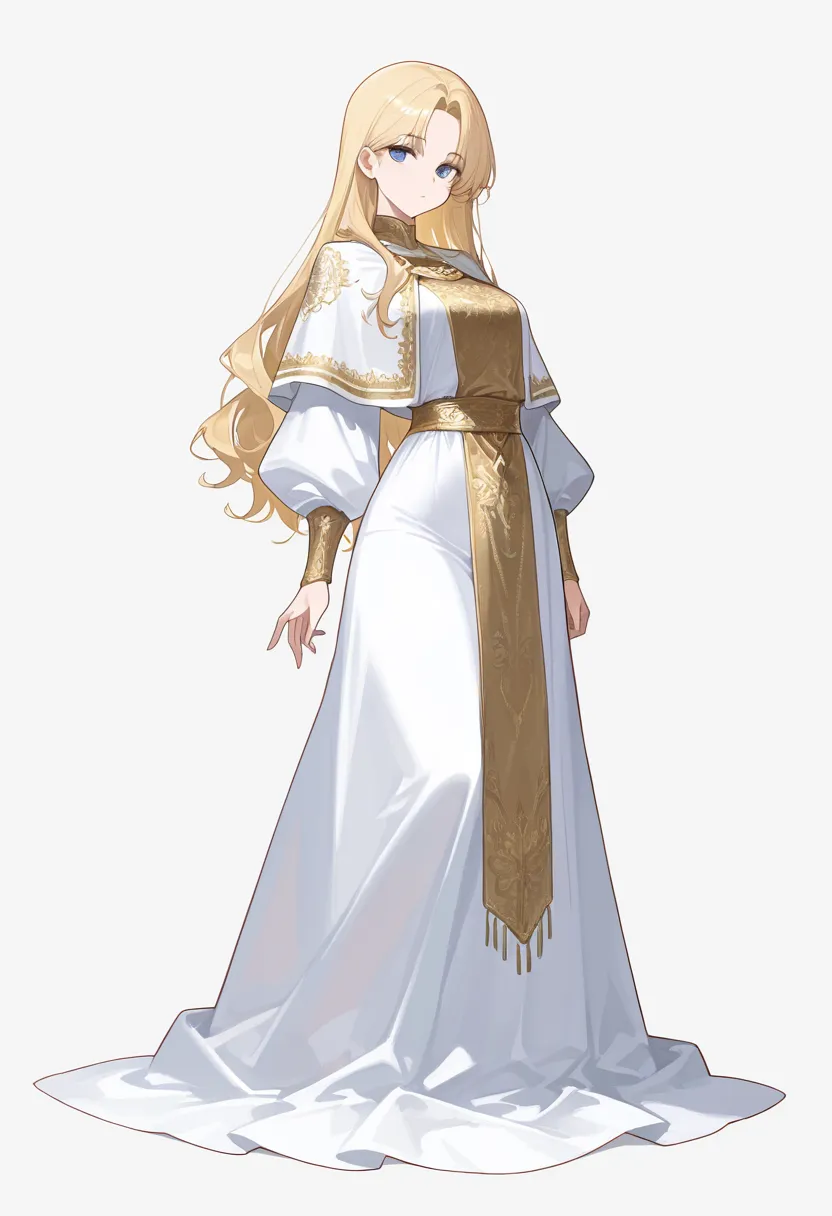
| モデル | 画像で確認したこと |
|---|---|
| MOSS-Image-Base(UI初期入力) | 金髪・青い目・白背景・白と金のローブを描いた。肩と胸、前垂れに金の模様があり、片方の黒い靴が主に見える。 |
| MOSS-Image-SFT(同じ入力) | 肩布、袖、裾まで金の模様が広がった。足元は片方の白い靴が主に見える。 |
| Qwen-Image 2.1 | 白と金のローブに細い刺繍が入り、靴まで見える。 |
| Anima preview3-base | 白と金に、指定していない青い布が加わった。 |
| WAI-Anima v1 | 肩布と裾に刺繍があり、青緑色の飾りが入った。 |
| WAI-Illustrious v160 | 大きい塗り分けで、長い金色の前垂れが目立つ。 |
同じタグ列・品質指定・ネガティブ指定を渡すと、SFT版はBase版より裾まで模様が広がった。ただし、両モデルとも片方の靴が主に見える。
QwenとAnimaの掲載済み作例に比べると、この2枚は顔と白い布の陰影が浅い。各モデル1枚ずつの参考比較だ。
立ち絵の元タグ列とMOSSに送ったUI条件
元の比較条件
1girl, solo, long blonde hair, blue eyes, white robe, gold embroidery, capelet, gold sash, long sleeves, long dress, standing, looking at viewer, full body, white backgroundMOSSのBaseとSFTへ送ったタグ列
best quality, masterpiece, 1girl, solo, long blonde hair, blue eyes, white robe, gold embroidery, capelet, gold sash, long sleeves, long dress, standing, looking at viewer, full body, white backgroundネガティブプロンプトは nsfw, worst quality, bad anatomy, watermark, jpeg artifact。
短い英文と空のネガティブ欄での初回結果
主比較の前に、BaseとSFTへ同じ短い英文を送り、ネガティブ欄をモデルカードの既定値どおり空にした。テキストエンコーダー、トークナイザー、VAE、推論コードは両モデルで同じ配布ファイルだったため、作業用コピーでも共用した。
初回のBaseとSFTを開く
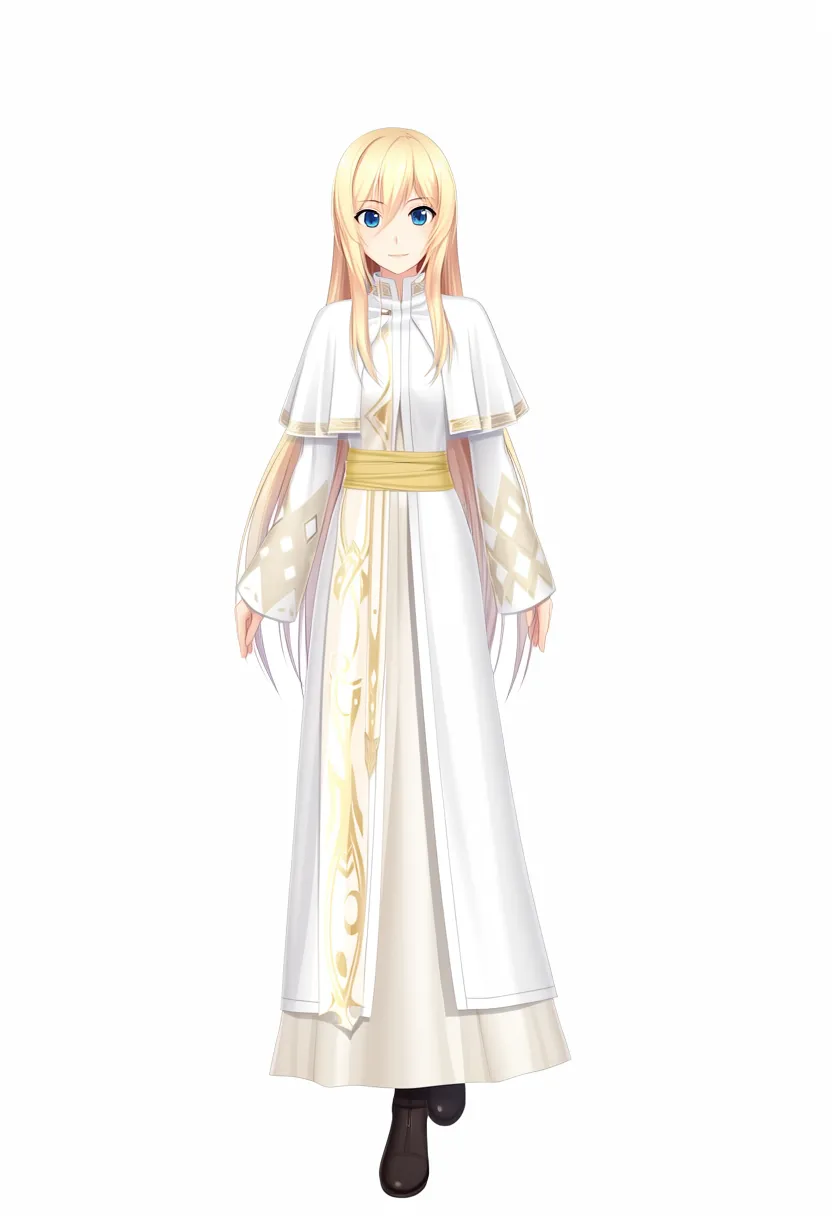
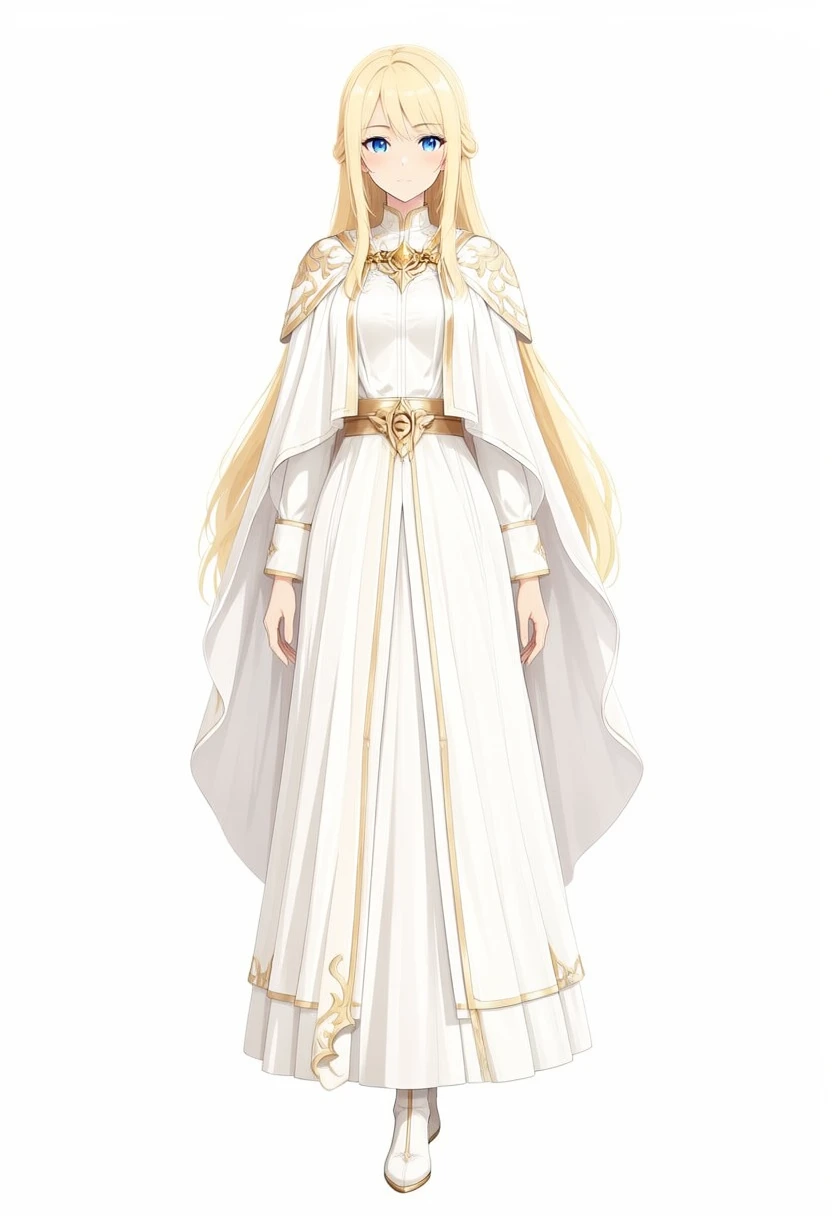
送った英文は次のとおり。ネガティブ欄は空欄。
An anime illustration of one young adult woman, shown full body standing and looking at the viewer against a plain white background. She has long blonde hair and blue eyes. She wears a long white robe with gold embroidery, a capelet, a gold sash, long sleeves, and a long skirt.初回のBaseは肩と裾の模様が少なく、SFTでは肩布と腰帯の模様が増えた。どちらも片方の靴だけがはっきり見える。UI初期入力を使ったBase画像では肩・胸元・前垂れの模様がさらに増えた。タグ形式、品質タグ、ネガティブ指定を同時に変えたため、どの変更で模様が増えたかは、この2条件の比較では分からない。生成処理はBase初回1,151.64秒、SFT初回1,154.18秒、BaseのUI初期入力1,159.20秒、SFTのUI初期入力1,156.02秒だった。
詳しい英文でSFT版を再試行
同じSFT版で指示文だけを変えた。公式Prompt Enhancerの詳しい描写を参考に、元の金髪・青い目・白と金のローブ・白背景を保ちながら、襟、肩布、袖、裾の刺繍と布の影、両足まで描く指示を加えた。公式スキルにあるJSONの作成・コンパイルは実行せず、英文を直接書いた。832×1216、50ステップ、CFG 3、shift 5、層スキップ22、シード42と空のネガティブ欄は、短い英文のSFT版と同じ。
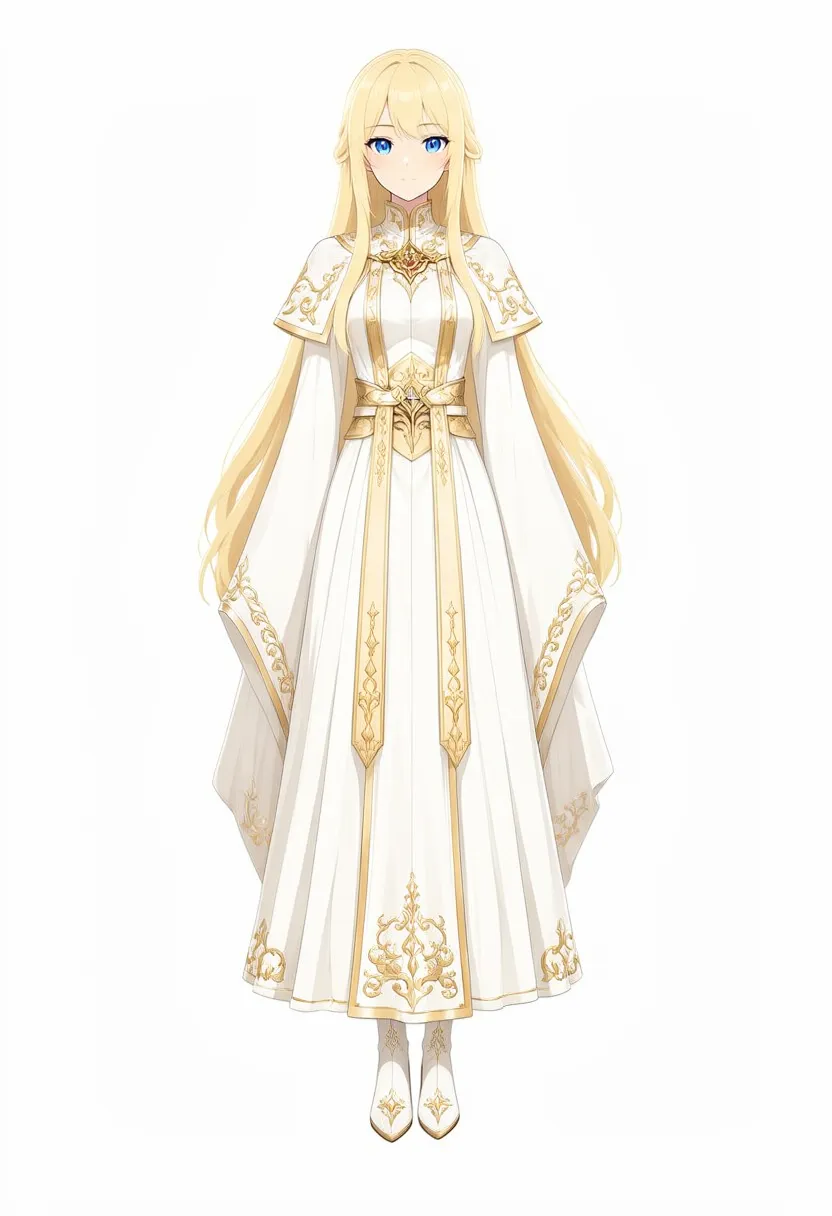
短い英文のSFT画像では腰帯と肩布に模様が集まったが、こちらは襟、肩布、袖、前垂れ、裾まで金の刺繍が広がり、両方の靴も見える。Qwen・Animaの作例と比べると、顔と布の細かな影は少ない。同じ詳しい英文はBaseへ送っていないため、この差をSFT固有の効果とは言えない。生成処理は1,193.96秒(19分54秒)。
SFT版へ送った詳しい英文
A full-body anime character illustration of one young adult woman standing straight and facing the viewer against a seamless plain white background. Center the figure with her head and both shoes fully visible. She has long flowing blonde hair, blue eyes, and a calm expression. She wears an elaborate ankle-length white ceremonial robe made of layered ivory cloth, with a short shoulder capelet, wide long sleeves, a long skirt, and a patterned gold sash with a central clasp. Fine gold filigree embroidery follows the collar, capelet, cuffs, front panels, and hem. Show the individual ornamental motifs, layered fabric folds, and soft shadows that separate the white cloth from the white background. Clean, precise anime linework, restrained cel shading, warm highlights on the gold, even studio lighting. No props or scenery.城と夕景を背景に走る人物
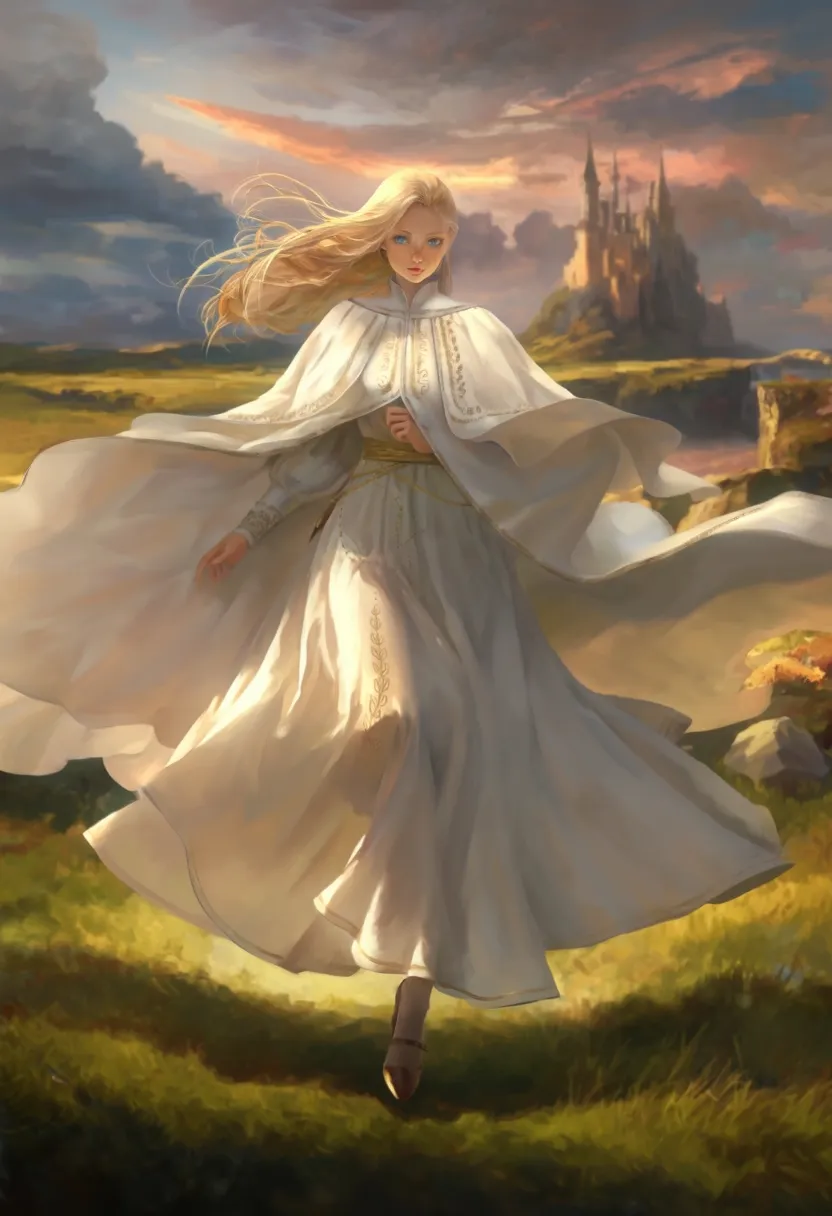
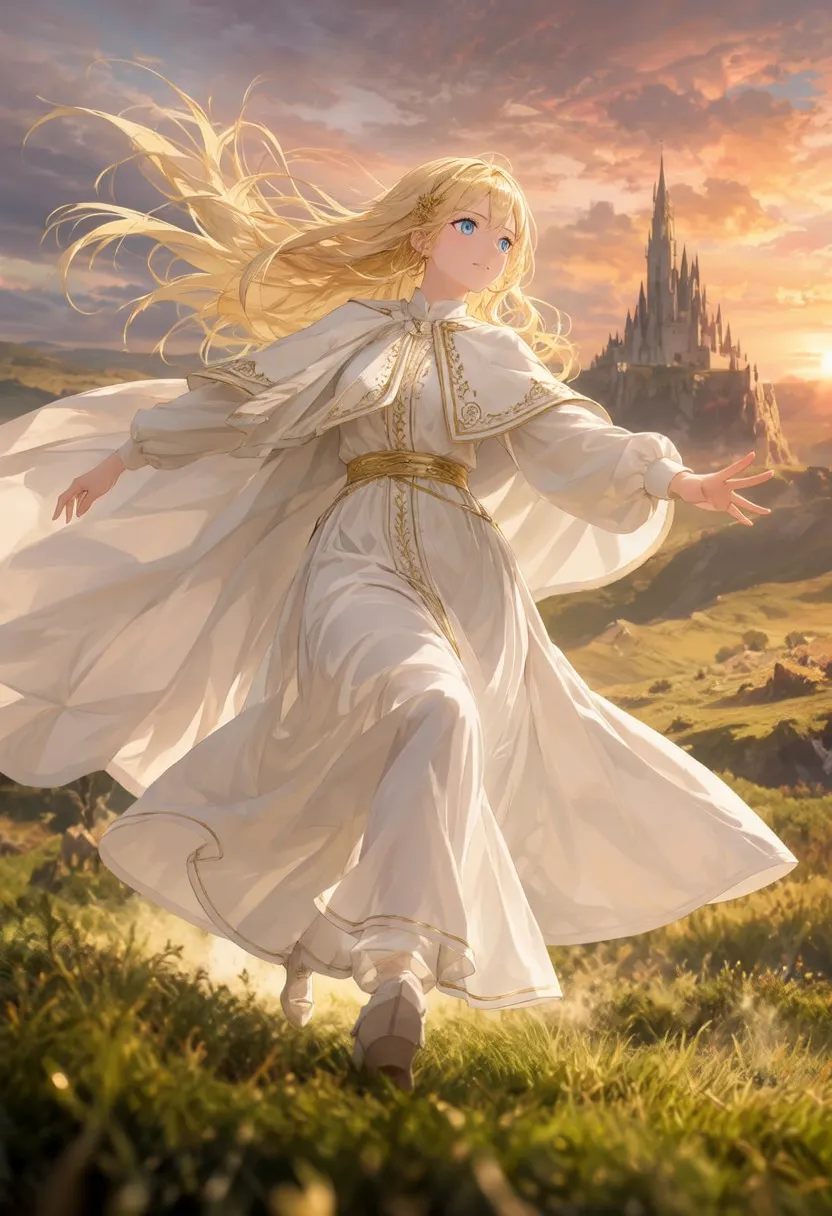
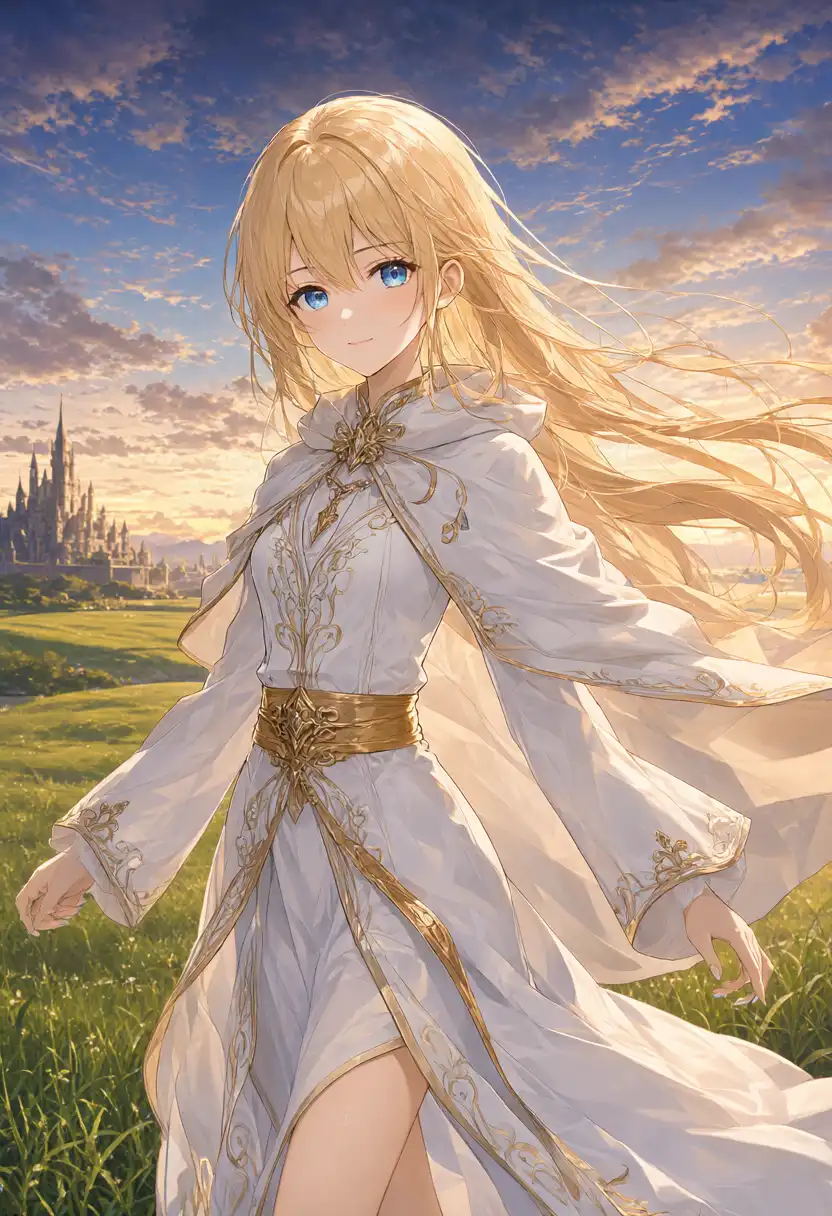
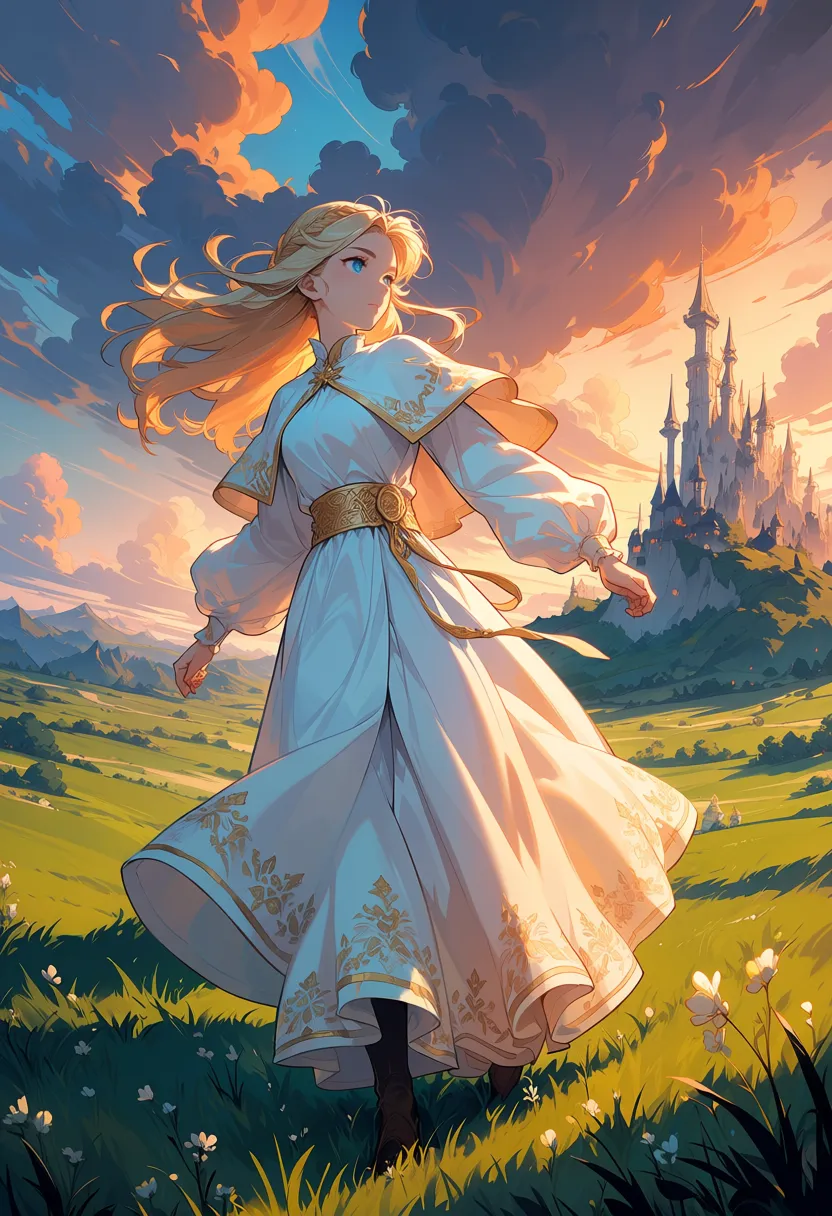
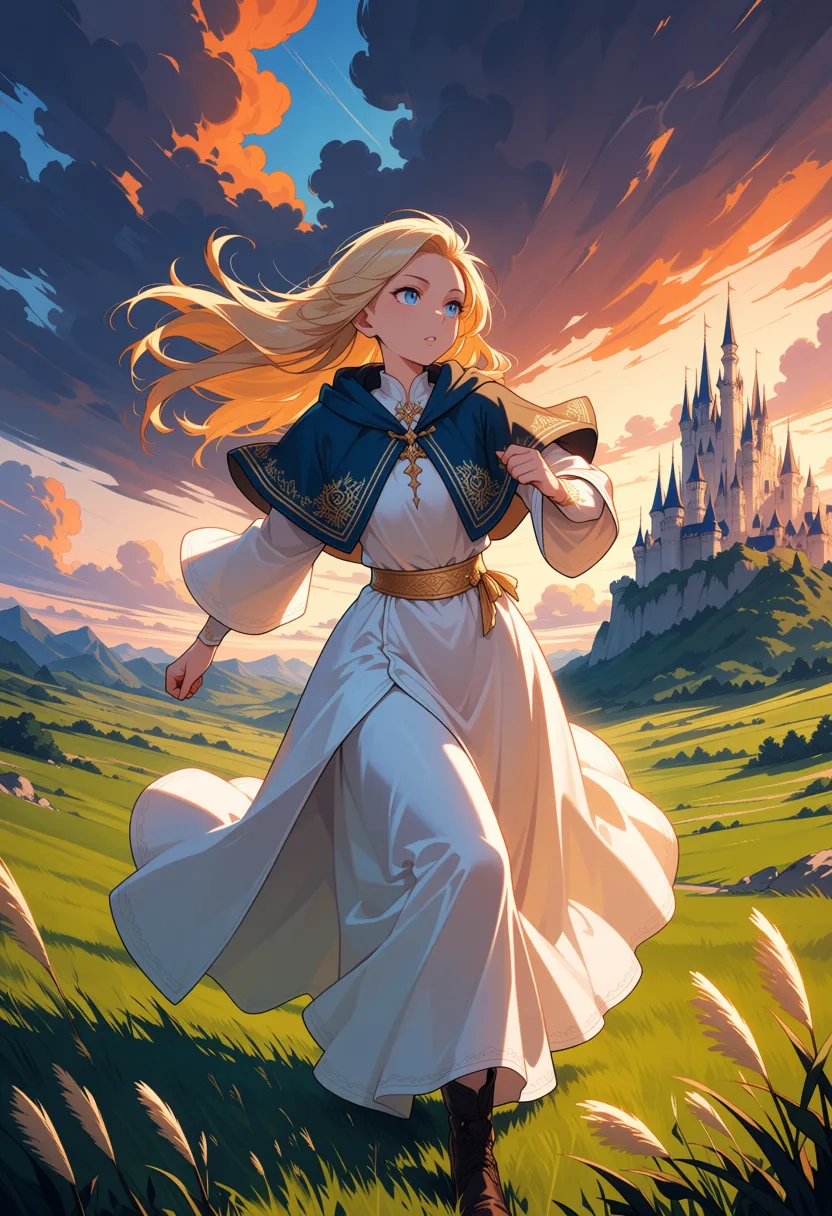
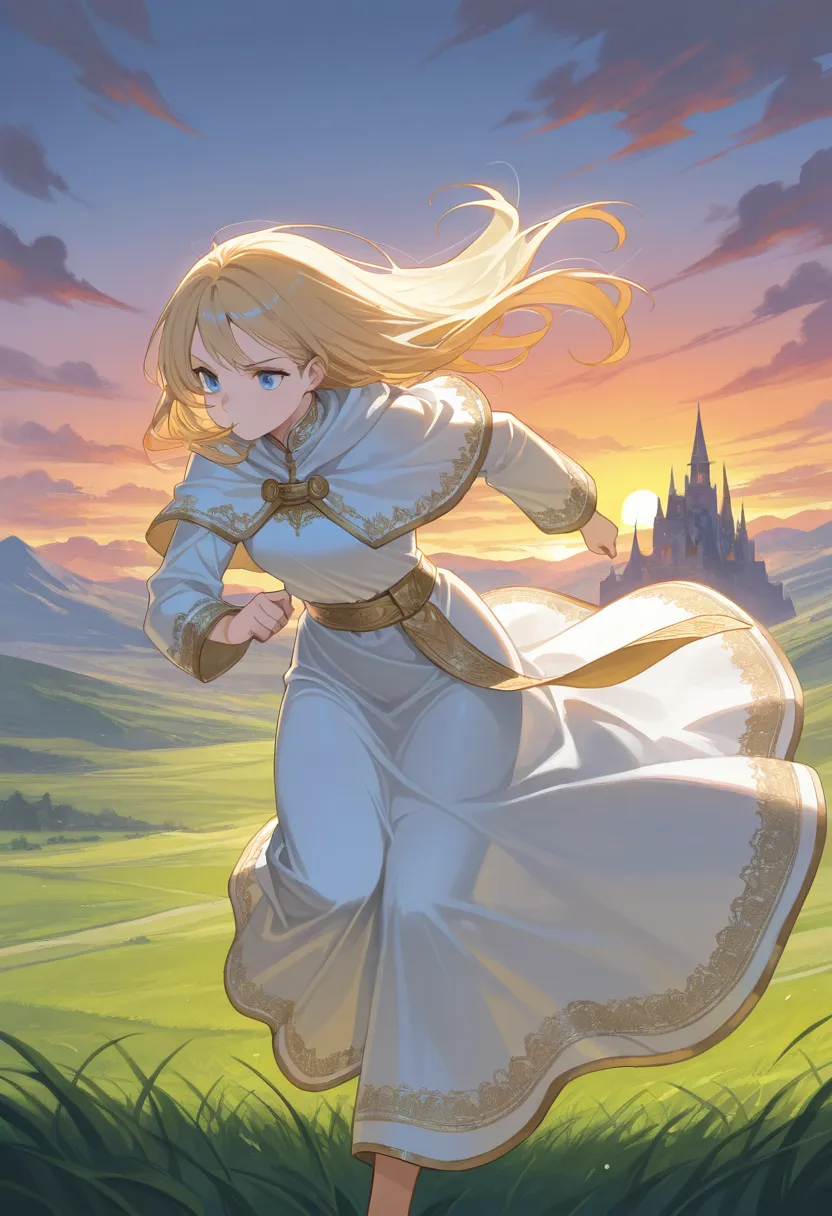
4月のタグ列に公式UIの品質タグを足し、BaseとSFTへ同じ入力を渡した。ネガティブ欄もUI初期値の5語でそろえた。
(UI初期入力)
(同じ入力)
(9月の出力)
(4月の出力)
(4月の出力)
(4月の出力)
| モデル | 画像で確認したこと |
|---|---|
| MOSS-Image-Base(UI初期入力) | 城・夕焼け・草地と、風になびく金髪・白いローブを描いた。片手は胸元、もう片方は広い袖の下にあり、脚は裾にほぼ隠れている。 |
| MOSS-Image-SFT(同じ入力) | 城・夕焼け・草地と白いローブを描いた。両腕は外へ伸び、片方の靴が前に出ている。襟と裾の金の縁取りがBaseよりはっきりしている。 |
| Qwen-Image 2.1 | 髪と布がなびき、草や雲を細かく描いた。膝下は画面外で、走る感じは薄い。 |
| Anima preview3-base | 城、夕焼け、草地を描いた。腕は下がり、走る感じは薄い。 |
| WAI-Anima v1 | 曲げた腕で走る姿。肩布は立ち絵の白から紺色に変わった。 |
| WAI-Illustrious v160 | 前傾する姿と夕暮れの背景。服は白と金の配色のままだった。 |
BaseもSFTも城と夕景は入ったが、この2枚だけでは走る腕振りと脚の運びを確認しにくい。SFTは片方の靴を前に出したものの、両腕は横に伸びた。
4月のWAI-Animaの作例は腕を曲げて走る姿になっている。MOSSの生成処理はBaseが1,160.42秒、SFTが1,149.25秒だった。
動的シーンの元タグ列とMOSSに送ったUI条件
元の比較条件
1girl, solo, long blonde hair, blue eyes, white robe, gold embroidery, capelet, gold sash, long sleeves, long dress, running, wind, hair blowing, dynamic pose, fantasy landscape, castle in background, sunset sky, dramatic clouds, grass fieldMOSSのBaseとSFTへ送ったタグ列
best quality, masterpiece, 1girl, solo, long blonde hair, blue eyes, white robe, gold embroidery, capelet, gold sash, long sleeves, long dress, running, wind, hair blowing, dynamic pose, fantasy landscape, castle in background, sunset sky, dramatic clouds, grass fieldネガティブプロンプトは nsfw, worst quality, bad anatomy, watermark, jpeg artifact。
初回のBase版を開く
UI初期入力での比較前には、同じ内容を自然文にしてBaseへ送り、ネガティブ欄をモデルカード既定値の空欄にした。その出力では片脚を上げ、両腕を横へ広げていた。後のUI条件ではプロンプト形式と品質・ネガティブ指定をまとめて変えたので、どの変更で画像が変わったかは分からない。生成処理は1,143.31秒。
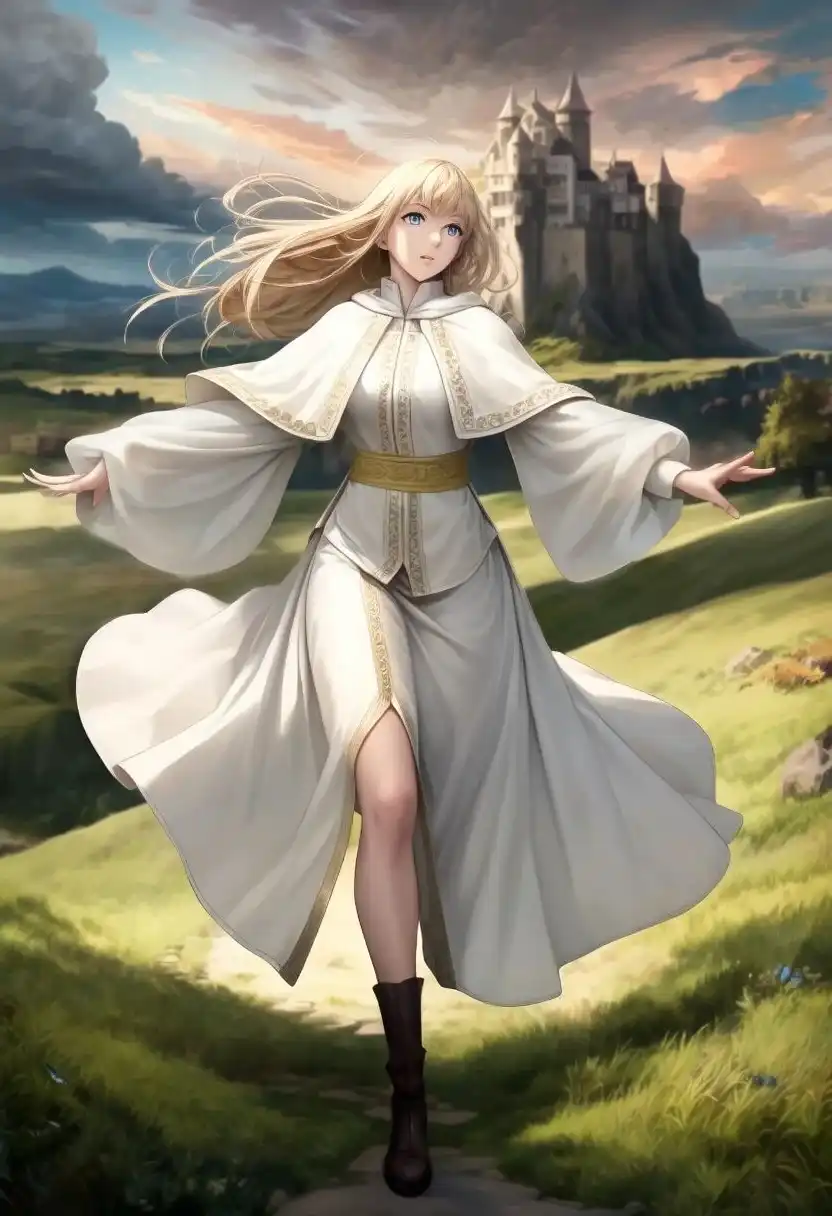
An anime illustration of one young adult woman with long blonde hair and blue eyes, running through a grassy field in a dynamic full-body pose. Wind blows her hair and the long sleeves of her white robe. Her robe has gold embroidery, a capelet, a gold sash, and a long skirt. A castle stands in the background beneath dramatic clouds and a sunset sky in a fantasy landscape.元画像の外見を文章だけで描けるか
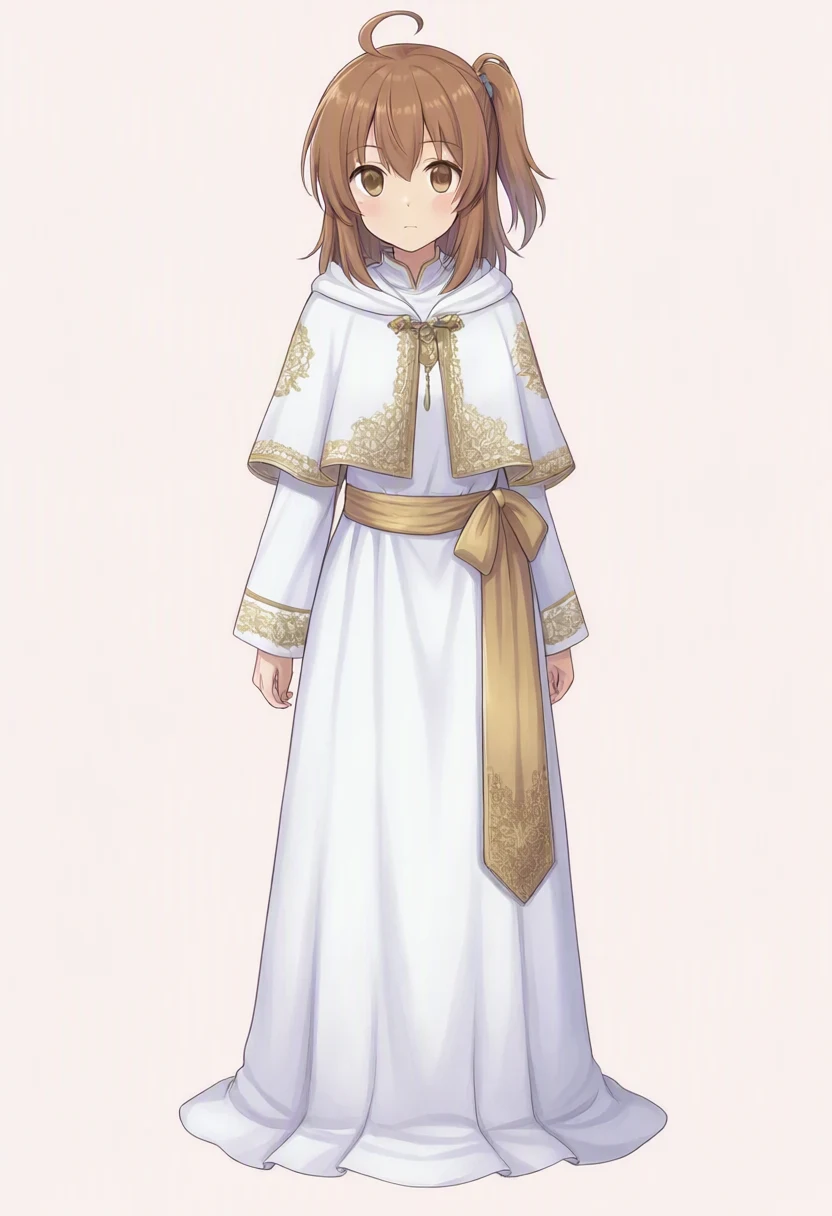
4月の記事では、WAI-Illustrious v160とかなちゃんLoRAの立ち絵を元に、i2i(画像から画像を生成する方法)をデノイズ強度0.5で試した。デノイズ強度は元画像をどの程度変えるかを調整する値だ。
9月の記事でも同じ元画像をQwen-Image 2.1に入力して描き直した。
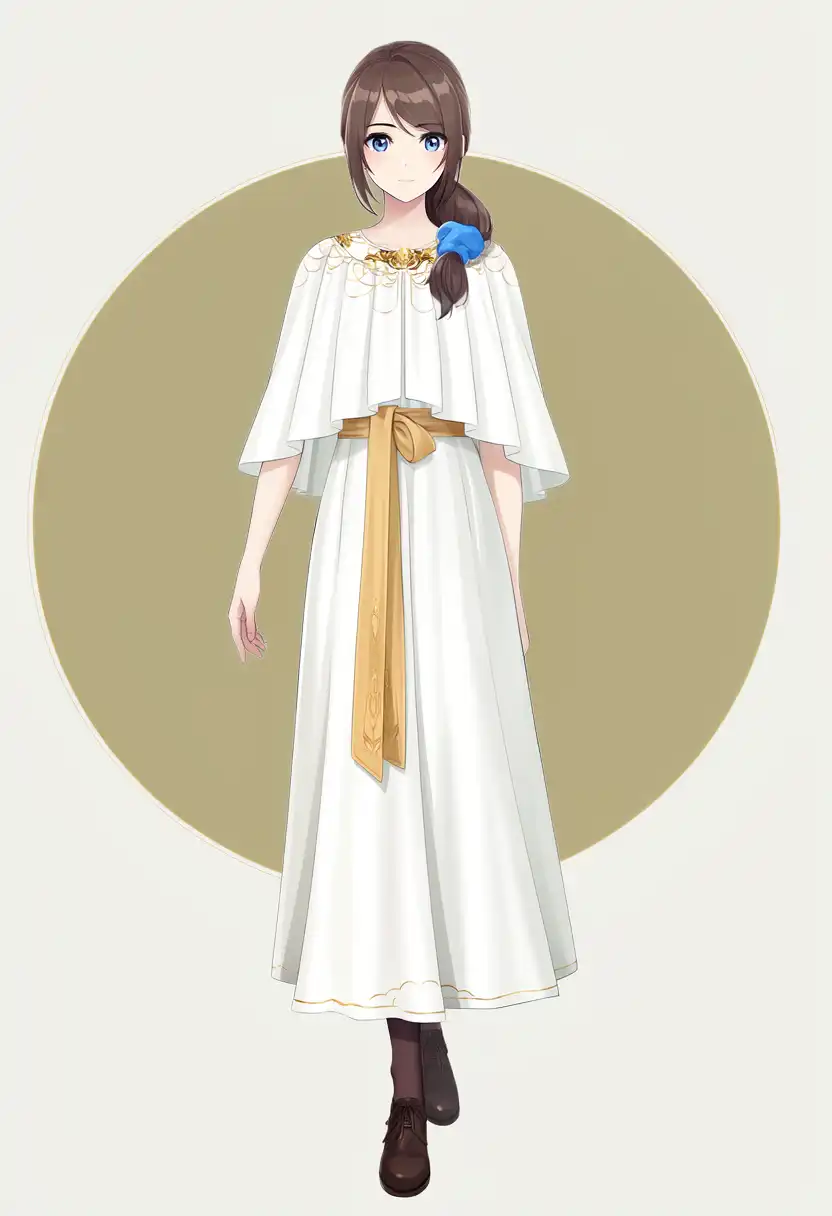
元画像は茶髪のサイドポニー、青いシュシュ、琥珀色の目、白と金のローブ、背景の金色の円が特徴だ。
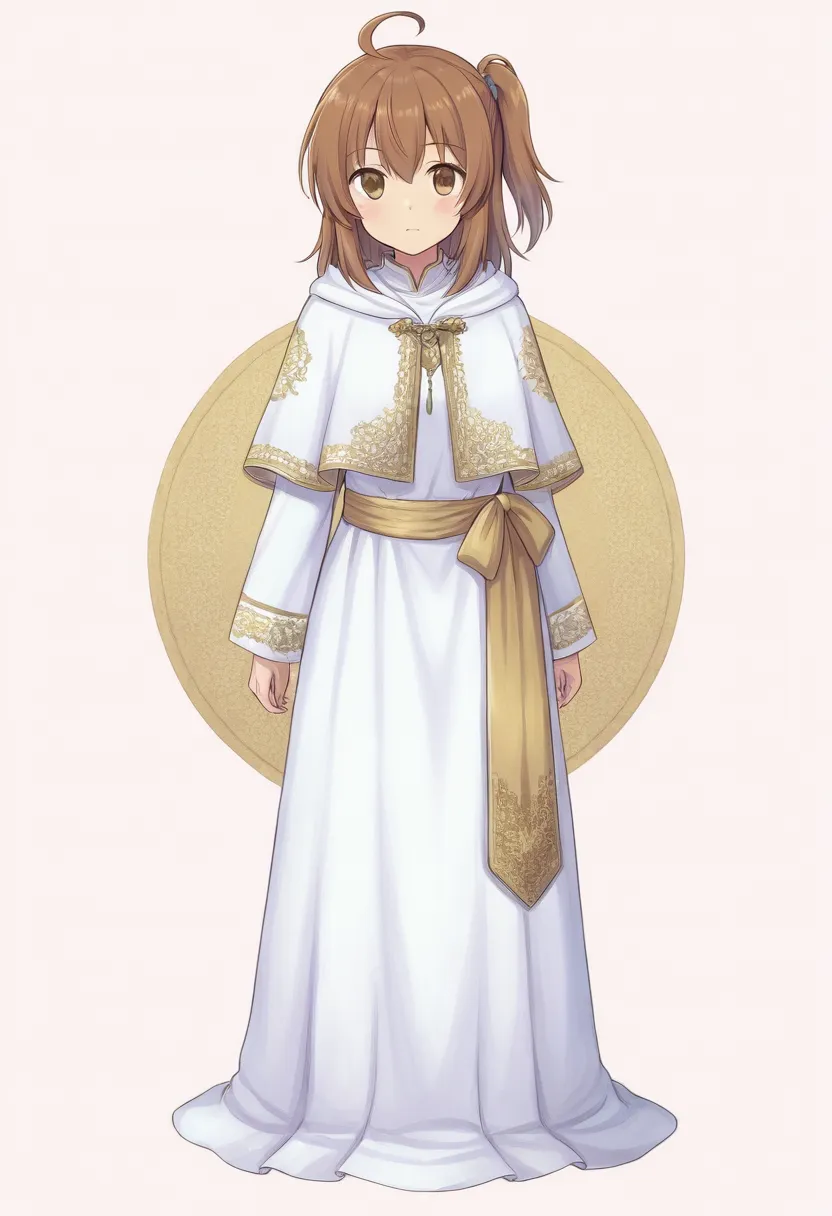
同じように試す前に、今回使った公式Diffusersパイプラインの引数を確認した。__call__ は画像や strength を受け取らず、文章から画像を作る。
元画像を入力する代わりに、髪型、青いシュシュ、衣装、背景の円を英文に書き、文章だけで別の画像を生成した。
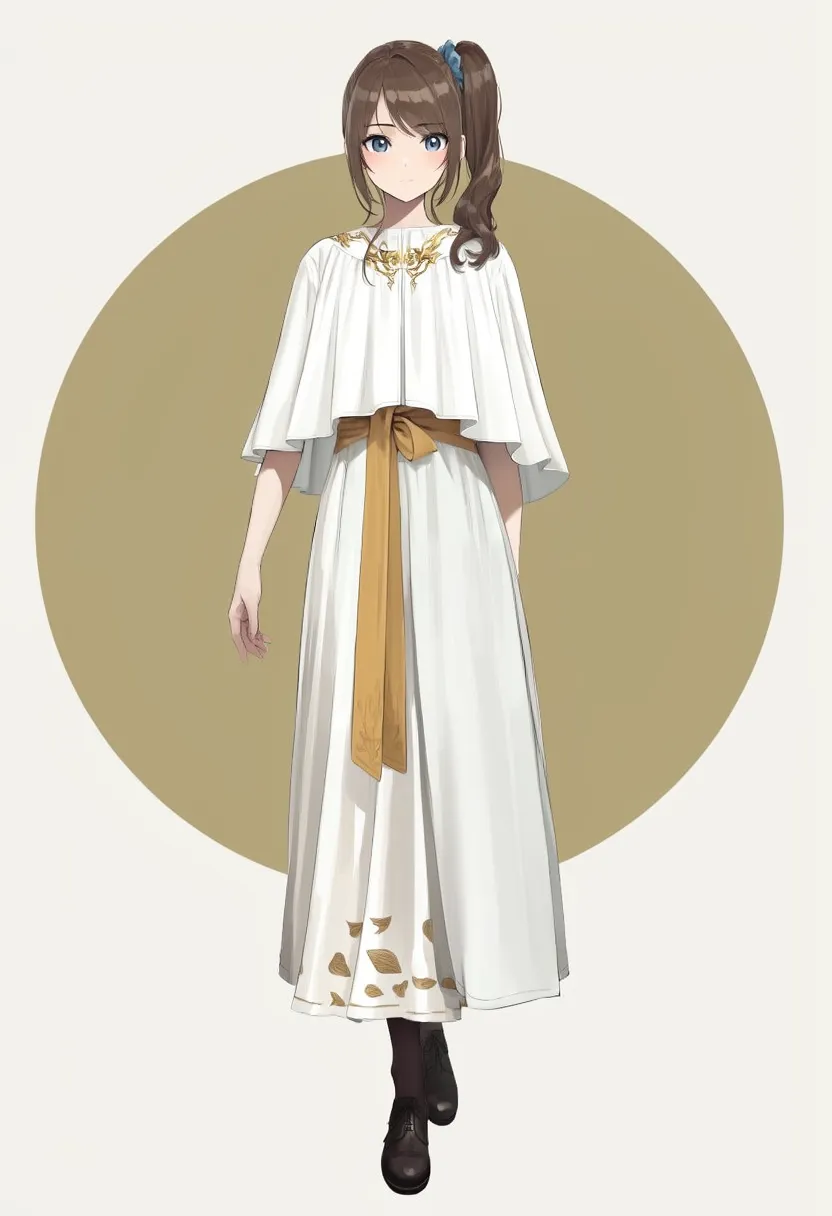
主比較では元画像の外見を説明した英文に公式UIの品質タグを足し、BaseとSFTへ同じ入力を渡した。画像そのものは入力していない。
元画像を入力した過去のi2i画像も並べるが、顔の一致度を同じ条件で測った比較ではない。
(文章のみ・UI初期入力)
(同じ文章)
(元画像を入力)
(denoise 0.5)
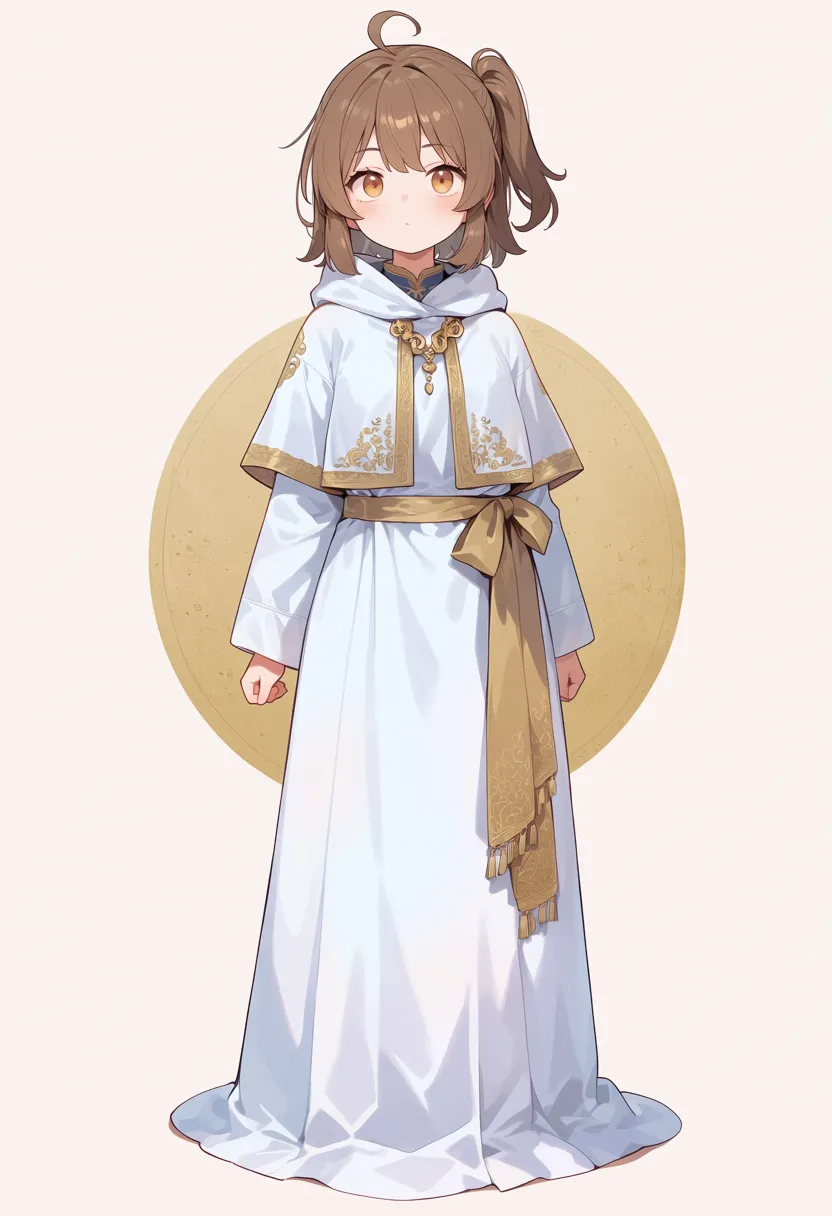
(denoise 0.5)
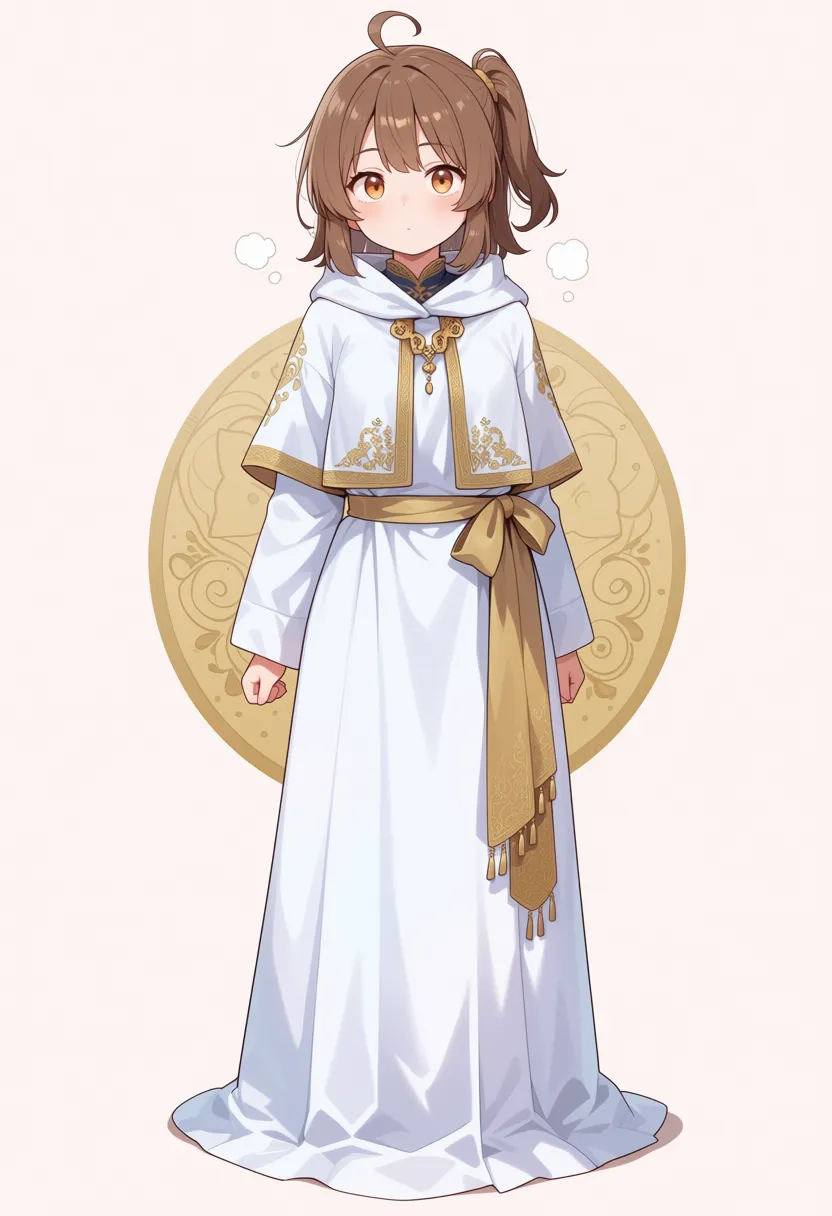
| モデル | 画像で確認したこと |
|---|---|
| MOSS-Image-Base(文章のみ) | 茶髪のサイドポニー、小さな青い髪留め、白と金の衣装、金色の円が出た。目は青く、黒い靴が見える。 |
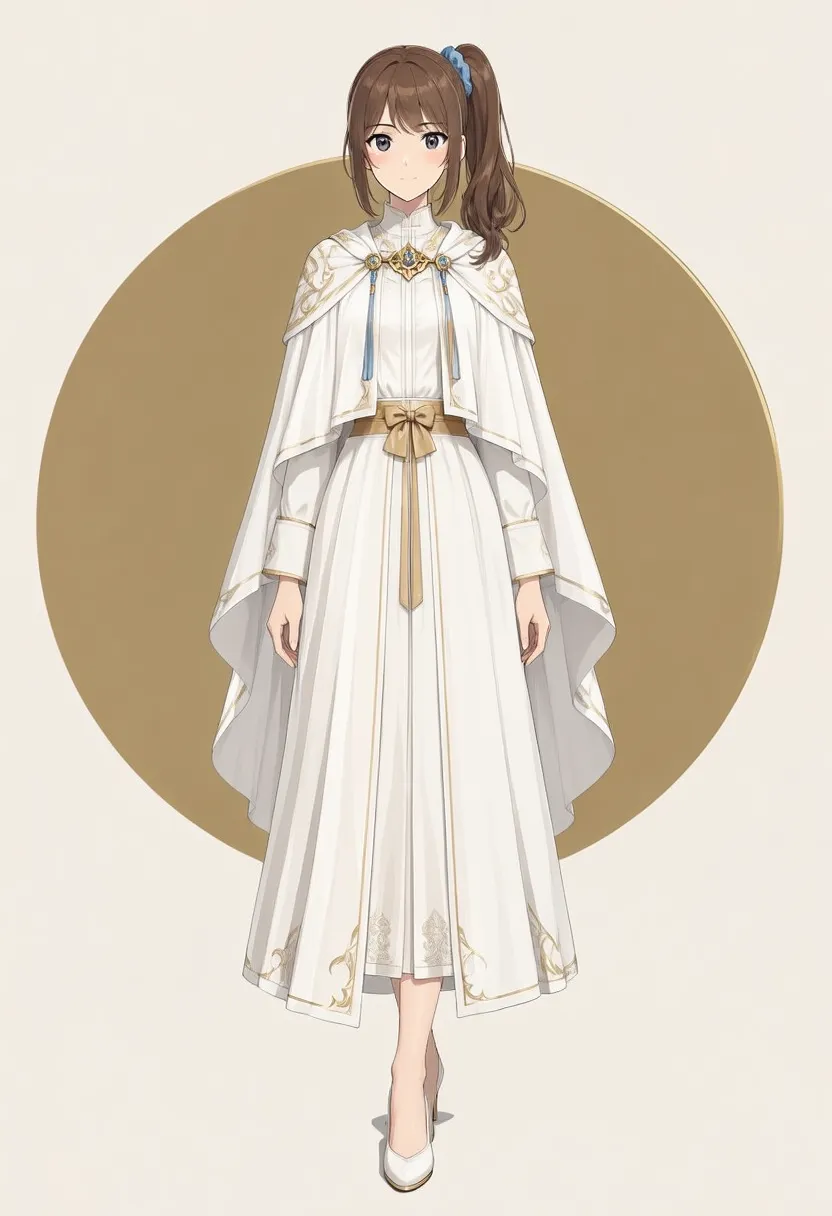
| MOSS-Image-SFT(同じ文章) | 茶髪のサイドポニーと青い髪留め、金色の円が出た。肩布と裾に金の模様が多く、片方の白い靴が主に見える。 |
| Qwen-Image 2.1 | 元画像の顔・髪型・シュシュはほぼ残し、背景の円は消えた。 |
| Anima preview3-base | 顔が丸くなり、シュシュはほぼ消えた。 |
| WAI-Anima v1 | 顔が丸くなり、背景の円に模様が加わった。 |
BaseとSFTの両方で、英文に書いた髪型、青い髪留め、白と金の衣装、金色の円は描かれた。SFTのほうは肩と裾の模様が増えた。
顔立ちと服の形は元画像と違うが、元画像を入力していないため、i2iでの保持能力とは結び付けられない。英文では元画像の琥珀色の目も指定していない。
生成処理はBaseが1,147.47秒、SFTが1,143.18秒だった。
MOSSのBaseとSFTに送った英文とネガティブ指定
best quality, masterpiece, An anime illustration of a young adult woman with brown hair in a side ponytail tied with a blue scrunchie, standing full body facing the viewer. She wears a long white robe with gold embroidery, a capelet and a gold sash. A large muted gold circle is behind her against a pale background.ネガティブプロンプトは nsfw, worst quality, bad anatomy, watermark, jpeg artifact。
初回のBase版を開く
主比較の前に、上の英文から品質タグを除き、ネガティブ欄をモデルカード既定値の空欄にしてBaseで生成した。青いシュシュと金色の円は描けたが、顔と衣装は今回のUI条件とも異なる。プロンプトとネガティブ指定を同時に変えているので、差の原因は分けられない。生成処理は1,132.34秒。
生成速度
同じM1 Max上の記録を比べた。MOSSの秒数は公式パイプラインの生成呼び出し時間で、指示文の処理、画像の更新、VAEによる復元を含む。モデルの読み込み、MPS転送、PNG保存は含まない。まずBase/SFTへ同じ入力を送った7条件の実測値を並べる。
MOSSのモデルカードによると、今回のCFG 3では画像生成部分を1ステップにつき2回計算する。過去記事のQwenはCFG 1だ。
| 同条件の作例 | Base | SFT |
|---|---|---|
| 白背景の立ち絵・UI初期入力 | 1,159.20秒 | 1,156.02秒 |
| 城と夕景・UI初期入力 | 1,160.42秒 | 1,149.25秒 |
| 元画像の外見を文章化・UI初期入力 | 1,147.47秒 | 1,143.18秒 |
| 冷蔵庫の中国語メモ・公式ガイド | 1,189.91秒 | 1,189.43秒 |
EXPLORE ポスター・公式JSON | 1,228.94秒 | 1,236.49秒 |
| NSFWタグなし | 1,132.28秒 | 1,133.58秒 |
| NSFWタグあり | 1,131.51秒 | 1,132.87秒 |
立ち絵、夕景、元画像の文章化、NSFWは832×1216で、冷蔵庫とポスターは1024×1024。各行は50ステップ、CFG 3、シード42で、生成後のスワップ使用量は0だった。初回の短い英文や、詳しい英文のSFT版は、該当する作例の節に時間を記録した。
過去モデルとの速度比較は、白背景の立ち絵と走る場面に絞った。MOSSとQwenはDiffusers、ほかの3モデルはComfyUIで動かし、ステップ数やCFGもモデルごとに違う。
| モデル | ステップ | 立ち絵 | 走る場面 |
|---|---|---|---|
| MOSS-Image-Base(UI初期入力) | 50 | 1,159.20秒 | 1,160.42秒 |
| MOSS-Image-SFT(UI初期入力) | 50 | 1,156.02秒 | 1,149.25秒 |
| Qwen-Image 2.1 | 40 | 588秒 | 584秒 |
| Anima preview3-base | 30 | 275秒 | 277秒 |
| WAI-Anima v1 | 30 | 277秒 | 274秒 |
| WAI-Illustrious v160 | 25 | 217秒 | 337秒 |
作例ごとの使い分け
以下は各条件1枚の作例に限った選択で、モデル全体の性能順位ではない。過去モデルとは指示文、LoRA、ステップ数、CFGも異なる。
| 用途 | この作例で選ぶモデル | 理由 |
|---|---|---|
| 文字と物体の配置 | MOSS-Image-BaseとSFT | 両方で EXPLORE が正しい綴りになり、文字と山の色領域も指定座標の近くに入った。SFTには下側の青い帯も出た |
| 中国語のメモと貼る位置 | MOSS-Image-Base | ガイド版のBase/SFTとも3行を読めたが、今回のSFTはメモを冷蔵庫の扉の外に貼った |
| 白背景の全身立ち絵 | Qwen-Image 2.1 | 詳しい英文のSFT版では刺繍が増えて両足も描いたが、この作例ではQwenのほうが顔と布に立体感がある |
| 城を背景に走る姿 | WAI-Anima v1 | 今回の作例では腕を曲げて走る姿を描いた。MOSSのBase/SFTペアでは走る腕振りと脚の運びが明瞭でなかった |
| 元画像の顔を残す描き直し | Qwen-Image 2.1 | 9月のi2i作例では顔と髪型をほぼ残した。今回のMOSSパイプラインは画像を入力できない |
参考リンク
- MOSS-Image公式リポジトリ(公開日、Base/SFT、Python実行例)
- MOSS-Image-Baseユーザーガイド(推奨設定とJSONレイアウト)
- MOSS-Image-Baseモデルカード(重みとライセンス)
- MOSS-Image-SFTモデルカード(追加学習版の重み)
- 公式Prompt Enhancer(詳しい英文の組み立て方)
- WAI-AnimaをAnima・Illustriousと比べた技術記事(4月の立ち絵・走る場面・i2iの出力)
- Qwen-Image 2.1をM1 Maxで試した技術記事(9月の比較画像と生成時間)
おまけ: NSFW出力テスト
ここから先はテスト出力した画像がセンシティブな可能性があるため、画像自体をぼかしています。出力のちゃんとした結果が見たい場合には、手元の環境でお試しください。
4月・9月の記事と同じ2種類の内容を試した。MOSSのBaseとSFTには同じ英語の自然文を送り、人物は25歳の成人と書いた。解像度、50ステップ、CFG 3、shift 5、シード42は前の立ち絵と同じ。
公式UIのネガティブ初期値にある nsfw は内容指定と衝突するため、この2条件ではネガティブ欄を空にした。公式UIの品質入力を使った主比較とは別の例外だ。過去4モデルは掲載済みのぼかし画像を使う。
2種類は NSFW. の有無に加えてポーズと背景も違うため、タグの効果だけを比べる実験ではない。
nsfwタグなし
森の泉の端で、足を水につけて座る全身像。nsfw の文字は送らない。
(今回)
(同じ入力)
(9月の出力)
(4月の出力)
(4月の出力)
(4月の出力)
| モデル | 画像で確認したこと |
|---|---|
| MOSS-Image-Base | 森と水辺を背景に、服の見えない人物が座る姿になった。脚の位置はぼかし画像では判定しづらい。 |
| MOSS-Image-SFT | 同じ森と水辺に人物が座り、片脚が画面右下へ伸びている。足先が水中にあるかはぼかし画像では判定しづらい。 |
| Qwen-Image 2.1 | 実写調で、正面を向いて水辺に座る。 |
| Anima preview3-base | 裸体だが胸と股間を隠す構図になった。 |
| WAI-Anima v1 | 裸体だが胸と股間を隠す構図になった。 |
| WAI-Illustrious v160 | 裸体だが胸と股間を隠す構図になった。 |
生成処理はBaseが1,132.28秒、SFTが1,133.58秒。ぼかし画像では座る姿勢と森の背景を確認できた。
元のタグ列とMOSSに送った英文
元の比較条件
1girl, solo, long blonde hair, blue eyes, completely nude, naked, bare skin, sitting on edge of spring, feet in water, forest, natural light, serene, full body, looking at viewerMOSSに送った英文
An anime illustration of one adult woman, age 25, with long blonde hair and blue eyes. She is completely nude, sitting on the edge of a forest spring with her feet in the water. Natural light, a serene mood, full-body view, looking at the viewer.nsfwタグあり(正面全身)
白背景で正面を向く全身像。英文の先頭に NSFW. を加えた。
(今回)
(同じ入力)
(9月の出力)
(4月の出力)
(4月の出力)
(4月の出力)
| モデル | 画像で確認したこと |
|---|---|
| MOSS-Image-Base | 白背景に正面を向いて立つ人物を、頭から足元まで描いた。掲載用画像では細部をぼかしている。 |
| MOSS-Image-SFT | 同じ白背景に正面を向いて立つ人物を、頭から足元まで描いた。顔や体の細部は掲載用画像から比較できない。 |
| Qwen-Image 2.1 | アニメ調の正面を向く裸体の全身像。立ち絵とは顔が違う。 |
| Anima preview3-base | 正面を向く裸体の全身像だが、顔や体型は4月記事の立ち絵と違う。 |
| WAI-Anima v1 | 立ち絵と似た顔で、右下にウォーターマーク(透かし)が出た。 |
| WAI-Illustrious v160 | 立ち絵に似た顔で正面を向く裸体の全身像。 |
生成処理はBaseが1,131.51秒、SFTが1,132.87秒。両方とも構図は指定に近いが、顔と画風の細部は掲載用画像でぼかしている。
元のタグ列とMOSSに送った英文
元の比較条件
1girl, solo, long blonde hair, blue eyes, completely nude, naked, bare skin, nsfw, straight-on, full body, standing, white backgroundMOSSに送った英文
NSFW. An anime illustration of one adult woman, age 25, with long blonde hair and blue eyes. She is completely nude, standing straight on and facing the viewer, shown full body against a plain white background.