層拡張で40層になったAnima-2.9Bに既存のキャラLoRAはそのまま乗るのか
 目次
2026-08-24 追記: 52ブロック化してQwen3.5-4Bエンコーダが追加されたAnima-3.8Bで、同じ付け替えと効かなかった構図指定を確かめた → Qwen3.5-4Bが追加されたAnima-3.8Bで、効かなかった構図指定は通るのか
Anima-2.9B というのがTLで流れてきた。知っている重みと違うので調べてみたら、有志が作ったものだった。
CircleStone Labs公式ではなく、Gazingstars123という人が Anima-Base の層を28から40に増やして、足した12層だけを170万枚で追加で学習させたもの。
派生を20本分類した記事と派生6種に同じキャラLoRAを当てた記事で、AnimaのLoRAは派生のどれにもそのまま載る、で済ませていたけど、あれは全部28層のままの話。
でかい方が出力がいいということもありそうだし、手持ちのキャラLoRAがどうなるかも気になるので確かめてみた。
検証環境
| 項目 | 内容 |
|---|---|
| 実行機 | M1 Max 64GB MacBook Pro(macOS 26.5) |
| ComfyUI | v0.33.3(Anima-2.9Bのnum_blocksをstate_dictから数える実装。常用のv0.30.1とは別ディレクトリに入れ、モデルだけ共有して別ポートで起動) |
| 比較ベース | Anima-Base v1.0(anima-base-v1.0.safetensors、4.18GB) |
| 対象モデル | Anima-2.9B-preview-v1(bf16 5.84GB)、同int8_convrot版(3.08GB) |
| テキストエンコーダ | Qwen3-0.6B(qwen_3_06b_base)、両モデル共通 |
| VAE | Qwen-Image VAE、両モデル共通 |
| 当てるLoRA | 4人LoRA anima-4char-v1_epoch100(rank256)、ペアLoRA keikana-animabase-v2_epoch140(rank128)、Turbo LoRA anima-turbo-lora-v0.1 |
テキストエンコーダとVAEは2.9Bのconfig.jsonでもQwen3-0.6BとQwen-Image VAEのままなので、変わったのはDiTだけ。
Anima-2.9Bの中身
モデルカードと、一緒に置いてあるexpand_manifest.jsonに書いてある分だけ表にした。
| 項目 | Anima-Base v1.0 | Anima-2.9B preview v1 |
|---|---|---|
| DiTブロック数 | 28 | 40 |
| パラメータ | 約2B | 約2.9B |
| 学習した層 | 全層 | 新規12層のみ(元の28層は凍結) |
| 追加学習データ | - | 170万枚のアニメ・イラスト、知識カットオフ2026年7月 |
| キャプション | タグ | タグと自然言語の混合(Gemini 3.1/3.5 Flash-Lite、Claude Sonnet 5)、スコアタグなし |
| オプティマイザ | 非公開 | Muon(LoRA学習に使えるか調べた記事で触れたやつ)、8×RTX 5080 |
| ライセンス | CircleStone非商用 | 同ライセンスの派生モデル扱い |
| 公開 | - | 2026年8月12日。翌13日にComfyUIへPR #15555が入り、14日のv0.33.1から読める |
| ダウンロード | - | 公開10日で3万回超 |
層の足し方は LLaMA Pro のやり方で、隣のブロックをコピーして間に挟み、コピーした側の出力の重み(self_attn.output_proj、cross_attn.output_proj、mlp.layer2と、adaLN(タイムステップの条件を各層に入れる正規化)の出力)をゼロにしてある。
出力がゼロだと残差に何も足さないので、学習前の2.9BはAnima-Baseと同じ絵を出す。
そこからの学習が普通のファインチューンと違う。普通のファインチューンは元の重みそのものを動かすので、ベースと派生で同じ層でも中身が変わる。2.9Bはそうじゃなくて、元の28層の重みは一切動かさず、間に挟んだ12層だけを学習させている。なので元の28層はAnima-Baseと同じまま。
モデルカードのサンプルは、塗りのツヤと色の濃さが強めの商業イラストっぽい感じで、Anima系の派生にあるリムライトや環境光があんまりなくて、のっぺりして見える絵が多かった。
元の28層は触ってないので、光の表現はBase側の層に残ってて、アーティストタグかCFGで戻るのかもしれない。
挟んだ12層とブロック番号
expand_manifest.jsonのinsertion_positionsは 2, 5, 8, 11, 14, 17, 21, 24, 27, 30, 33, 36 で、新しい40層のうちこの12か所がコピーして足したブロック、残り28か所が元のブロック。
元のブロック番号から新しい番号への対応はこう。
| 元の番号 | 新しい番号 | 元の番号 | 新しい番号 |
|---|---|---|---|
| 0 | 0 | 14 | 20 |
| 1 | 1 | 15 | 22 |
| 2 | 3 | 16 | 23 |
| 3 | 4 | 17 | 25 |
| 4 | 6 | 18 | 26 |
| 5 | 7 | 19 | 28 |
| 6 | 9 | 20 | 29 |
| 7 | 10 | 21 | 31 |
| 8 | 12 | 22 | 32 |
| 9 | 13 | 23 | 34 |
| 10 | 15 | 24 | 35 |
| 11 | 16 | 25 | 37 |
| 12 | 18 | 26 | 38 |
| 13 | 19 | 27 | 39 |
番号が変わらないのはブロック0と1だけで、残り26ブロックは番号がずれる。
Anima用のLoRAはDiTのブロック番号付きのキー名で差分を持ってて、ComfyUIはその名前でモデル側の重みを探して足す。
Anima-Baseで焼いたLoRAの「ブロック2」の差分は、2.9Bだと新しいブロック2、つまり元のブロック1をコピーして新しく学習した層に足される。
元のブロック2はブロック3に移ってるので、そこには元のブロック3向けの差分が足される。
2.9Bには0から39まで全部ブロックがあるので、キーが見つからないという警告も出ない。警告なしでロードが通って、26ブロック分の差分が別の層に足される。
4人LoRAをモジュール別に分けた記事で、DiT側がキャラの描き分けと画風を作ってた。
LLMAdapterはQwen3-0.6Bの出力をDiTへ渡す側で、2.9Bでも変わってないので、LoRAのここは元と同じ重みに足される。
番号がずれるのは、その描き分けを作ってるDiT側。
となると、当てる前からだいたい予想がつく。
そのまま当てたら差分の大半が別の層に足されるので、目当てのキャラは出ない。派生6種の記事でRDBTが獣耳・軍装に化けたみたいな画風の暴走じゃなくて、4人LoRAの人物が出てこない方だと思う。
番号を付け替えたLoRAなら、元の28層には元の差分が足されるので描き分けは戻る。ただ間に挟まった12層にはLoRAが効かないので、Anima-Base v1.0と同じ絵にはならない。
Turbo LoRAも同じくブロック番号付きなので、そのまま当てたら8ステップで絵にならないはず。Turboは単独で当てられるので、まずこっちから。
当てるLoRAと生成の設定
LoRAはどっちもAnima-Base v1.0の上で焼いた自作キャラ。
| LoRA | 構成 | 識別キー |
|---|---|---|
anima-4char-v1_epoch100 | rank256、けい・かな・こはる・くらら | 4人LoRAの記事の全指定プロンプトで4人立ちが6/6 |
keikana-animabase-v2_epoch140 | rank128、けい・かな | 2キャラLoRA v2の記事でアホ毛移りと融合が消えた版 |
生成の設定は、Turbo LoRAが2.9Bで使えるか分からないので、とりあえずフルステップで揃えておいた。
モデルカードのおすすめはeuler + sgm_uniform、28〜50ステップ、CFG 3.5〜5。
| 項目 | 値 |
|---|---|
| 解像度 | 832×1216(ソロ)、1344×768(4人立ち) |
| ステップ | 28 |
| CFG | 4.0 |
| サンプラー | euler / sgm_uniform |
| シード | 42 / 1234 / 9999 |
| LoRA strength | model 1.0 / clip 1.0 |
| Turbo LoRA | 2.9B側は別枠で確認、比較時は両モデルとも未使用 |
プロンプトはいつもの2段階で、トリガーだけの軽い指定と、トリガー+位置文+識別アンカー+服装文の全指定。
# 軽い指定(ソロ、かな)
kanachan, 1girl, solo, standing, looking at viewer, full body, white background

# 全指定(4人立ち)は anima-4char-lora 記事の全指定プロンプトをそのまま使う
生成時間は、Anima-Base v1.0がM1 Maxで275〜285秒だったので、層の数が1.43倍で400秒くらいになる、と思う。
まず素の出力をv1.0と並べる
LoRAを当てる前に、同じプロンプト・同じシードで2モデルの素の出力を並べてみた。
派生6種の記事と同じ「金髪+白いローブ+金刺繍」の棒立ちプロンプト、シード42。
| モデル | かかった時間(28ステップ、初回ロード込み) |
|---|---|
| Anima-Base v1.0 | 253.0秒 |
| Anima-2.9B | 353.4秒 |
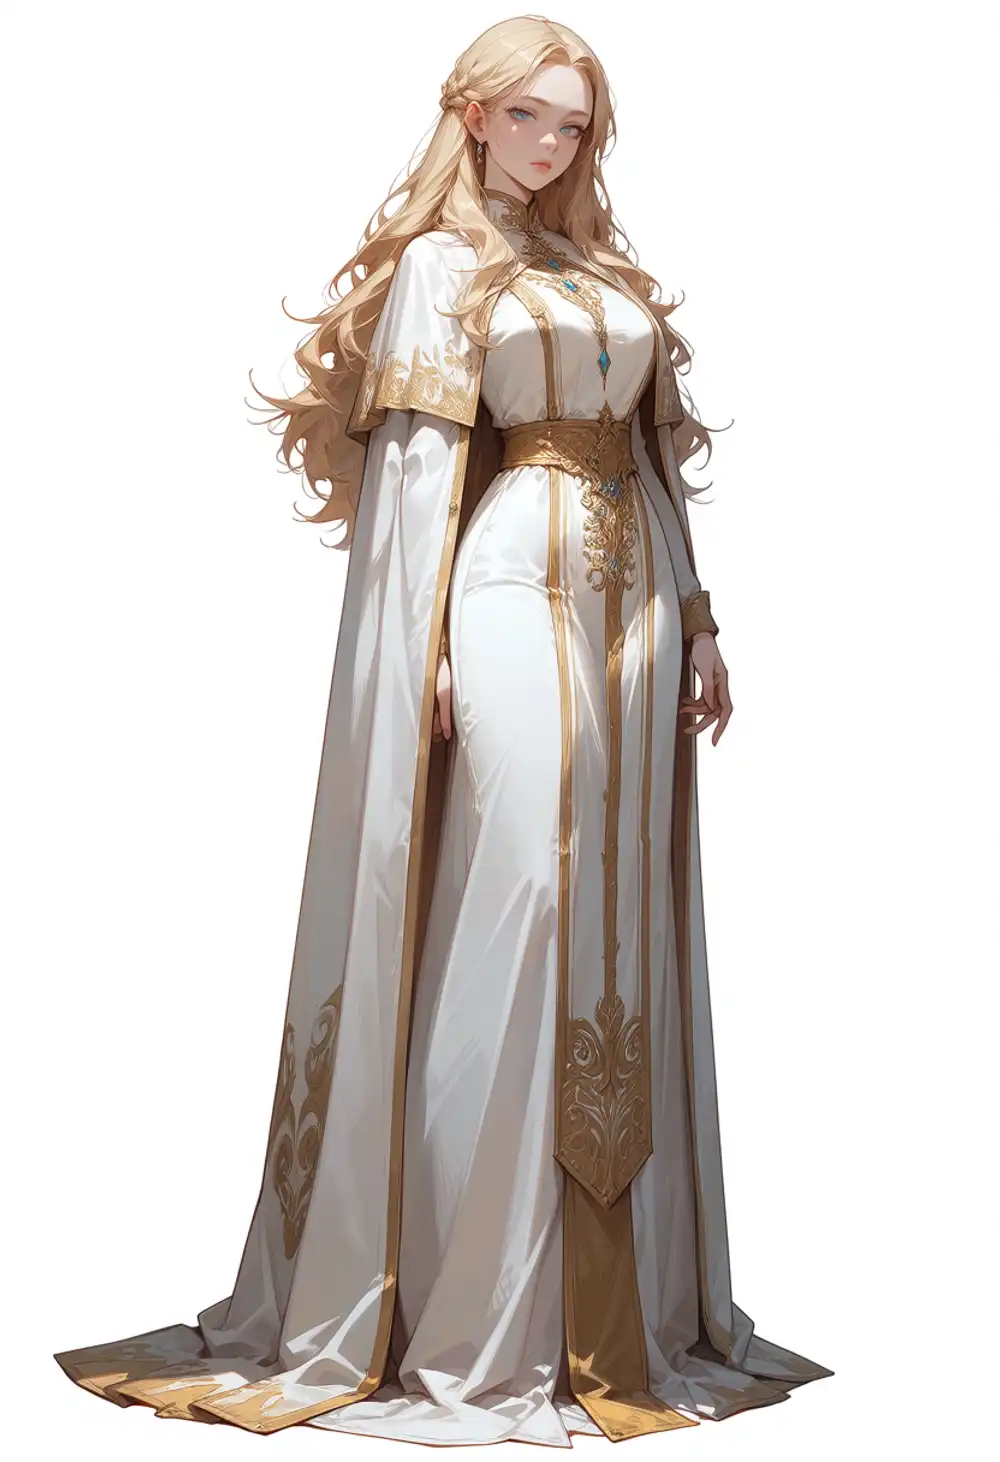
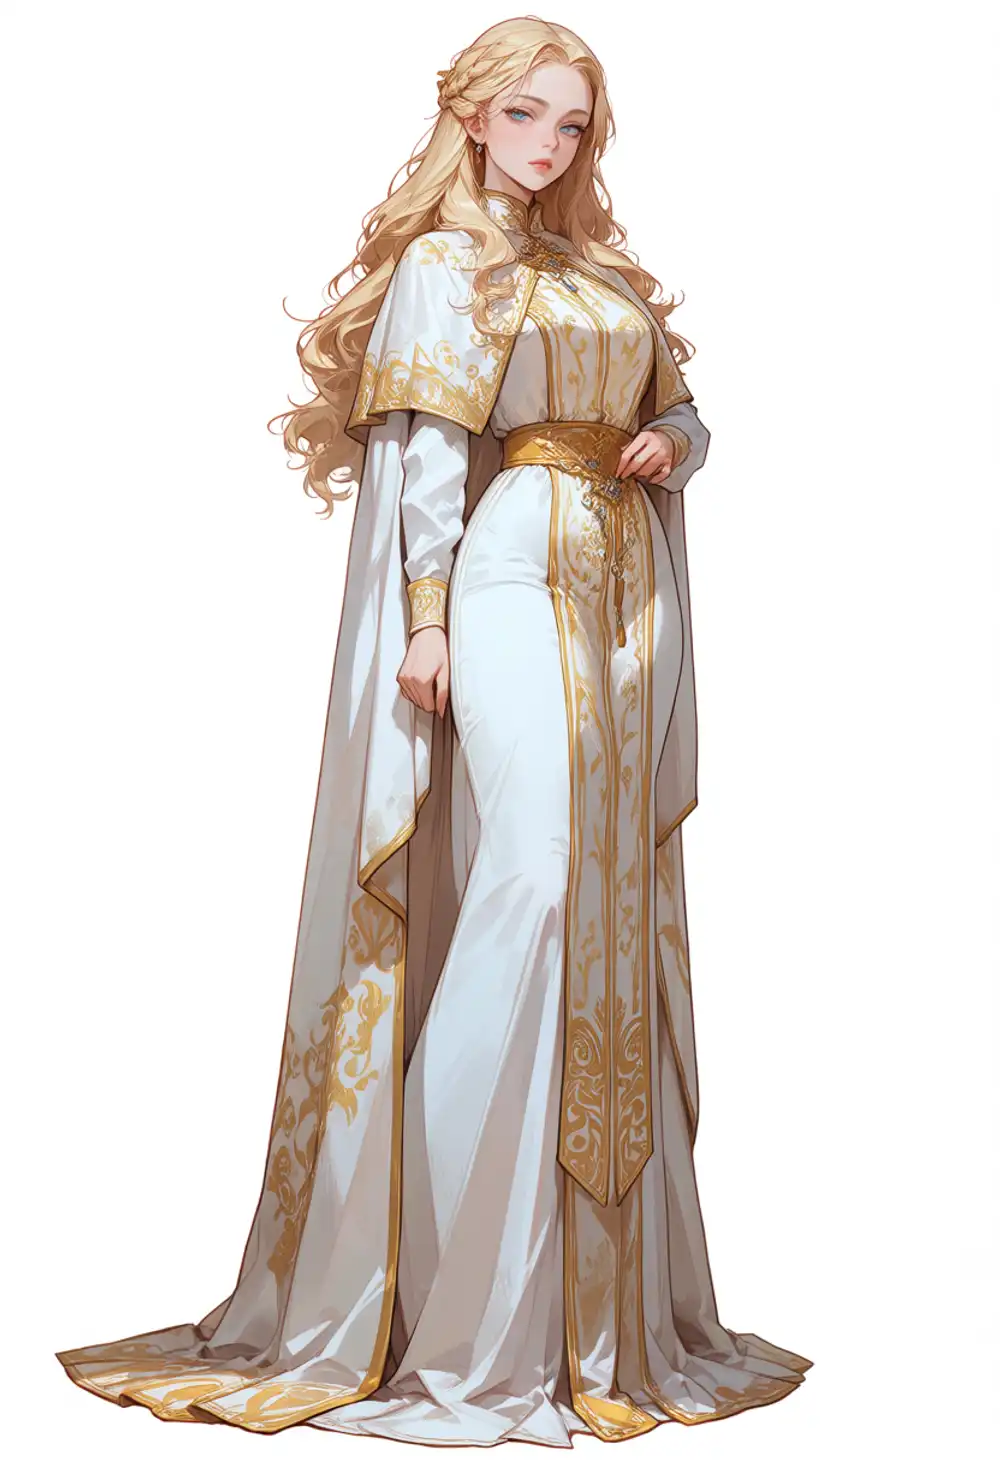
同じシードで構図がほぼ同じになった。
立ち姿、髪の流れ、ケープレットのかかり方、裾の広がりまで同じで、右手の位置と体の向きがちょっと違うくらい。
触ってない28層が構図を決めてて、新しい12層はその上に差分を足してるだけ、という感じに思える。
違うのは飾りの量と影で、2.9Bは金の刺繍が増えて模様が細かく、金色が明るい黄色に寄って、布の影が薄くて全体に明るい。
サンプルで気になったのっぺり感は、この1枚だと影が薄くなる形で出てて、ツヤのハイライトは残ってる。
時間は1.40倍で、層の数の比1.43とほぼ同じ。ステップ速度はv1.0が約8秒/it、2.9Bが約12秒/it。ComfyUIのログでは、v1.0が3988MB、2.9Bが5572MBをMPSに載せている。
このサンプルののっぺり感が、CFGを4.0から5.0と6.0に上げた場合と、アーティストタグを1つ足した場合で変わるか、同じシードで試してみた。
| 条件 | かかった時間 |
|---|---|
| CFG 5.0 | 347.4秒 |
| CFG 6.0 | 345.4秒 |
CFG 4.0 + @nnn | 347.4秒 |
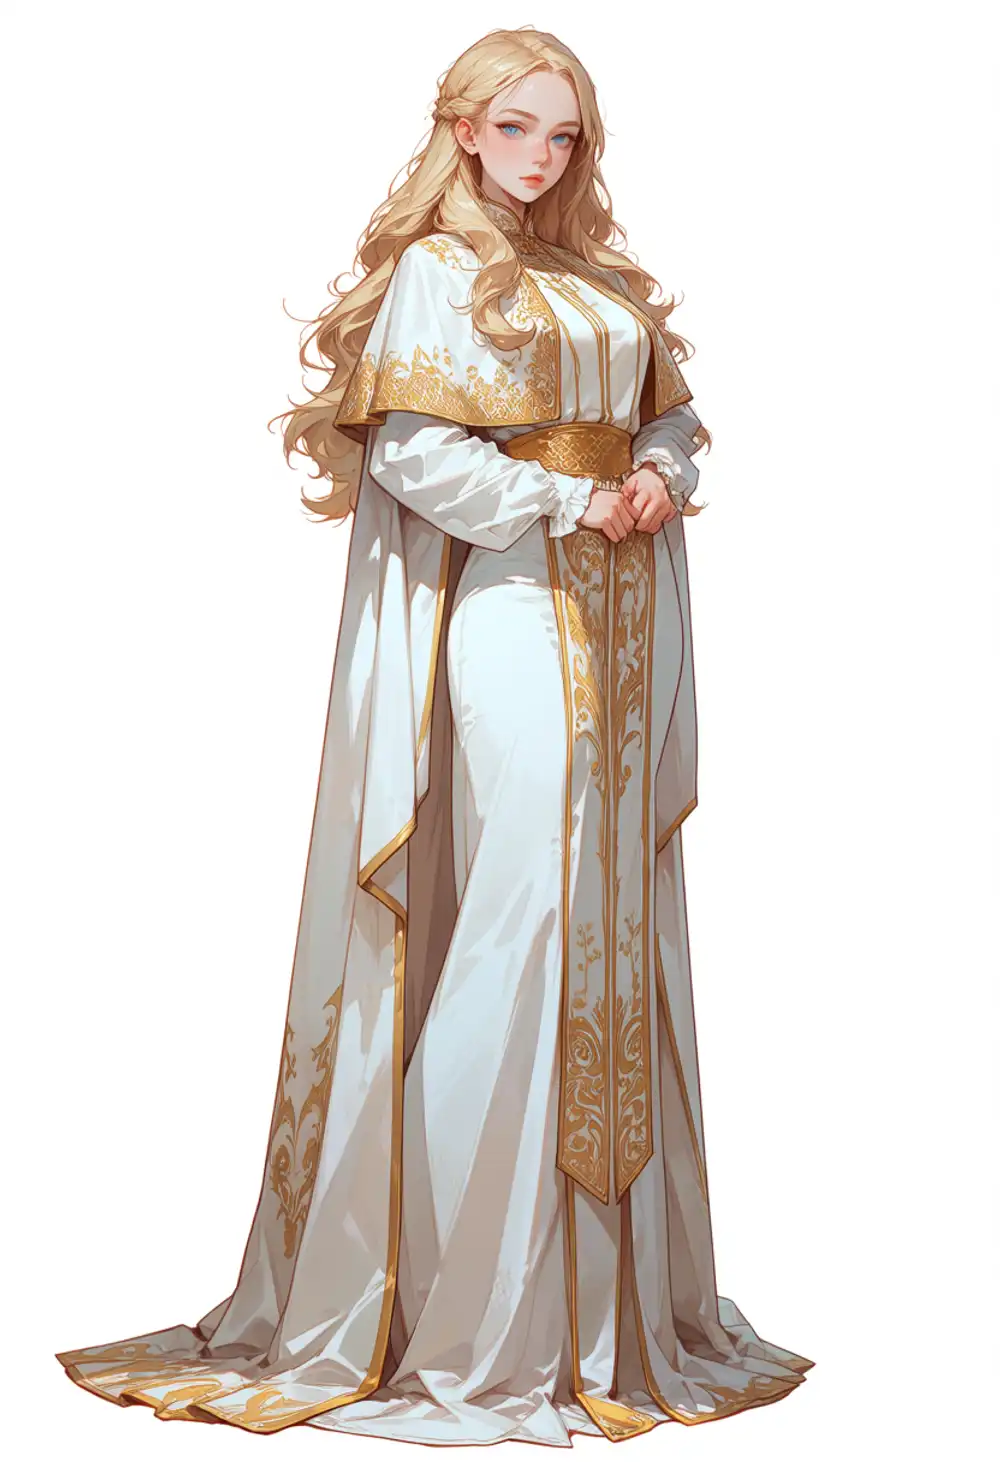
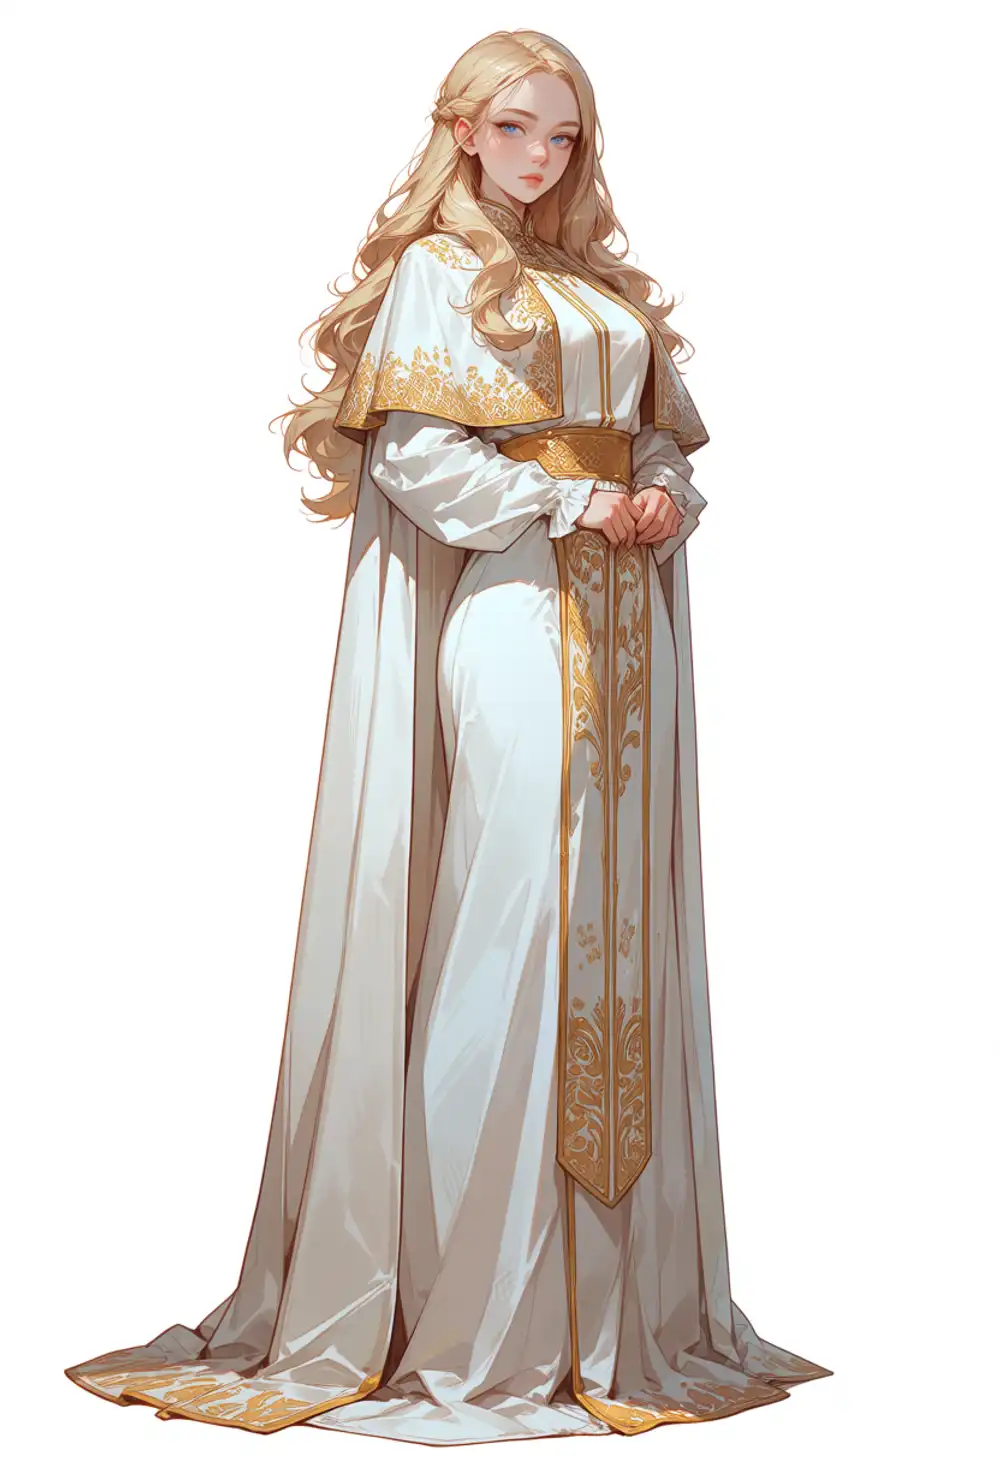
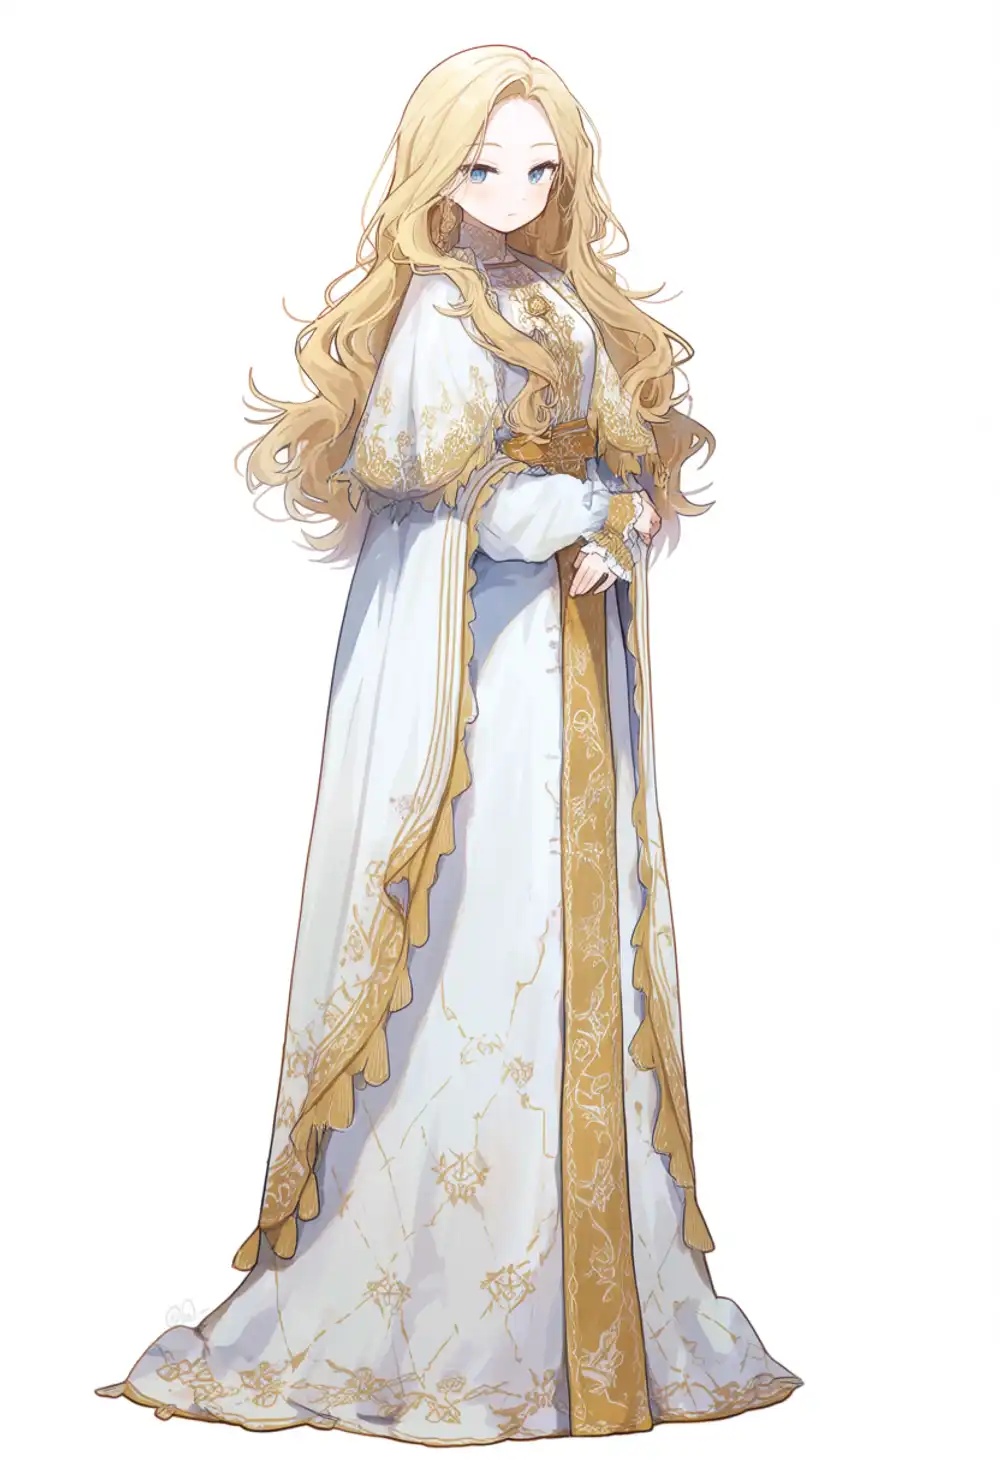
CFGは4から6まで上げてもあんまり変わらなかった。
金の色と刺繍がだんだん濃くなって、左肩から袖の影がちょっと広がるくらいで、v1.0みたいに面ごとに明るい暗いがはっきり分かれる影にはならなかった。
アーティストタグを足すと画風ごと変わった。線が細くて柔らかい水彩っぽくなって、金の飾りはレースみたいな細かい模様になって、構図まで変わってる。
影が戻ったというより別の絵になっちゃったので、Base側の層に光の表現が残ってて戻せるんじゃないか、というのは、この2つのやり方じゃ確かめようがなかった。
Turbo LoRAをそのまま当てる
anima-turbo-lora-v0.1をstrength 1.0で2.9Bに当てて、8ステップ・CFG 1.0・er_sde / simpleで生成した。
Anima-Base v1.0だとこの設定で275秒が48秒になった。
| モデル | かかった時間(8ステップ) |
|---|---|
| Anima-Base v1.0 | 40.2秒 |
| Anima-2.9B | 56.2秒 |
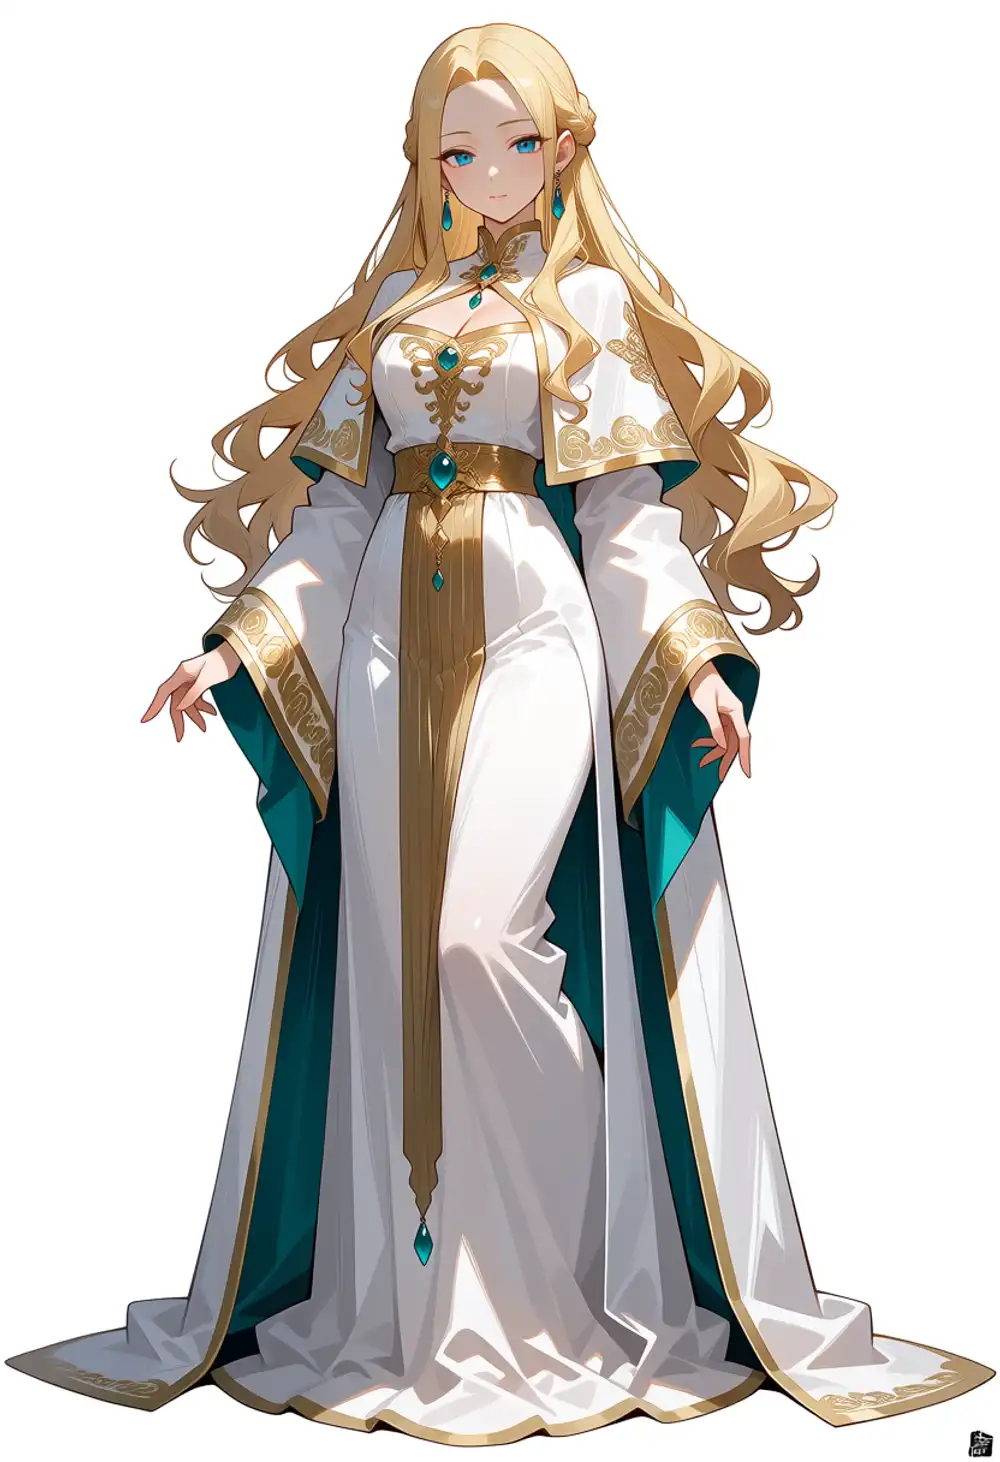
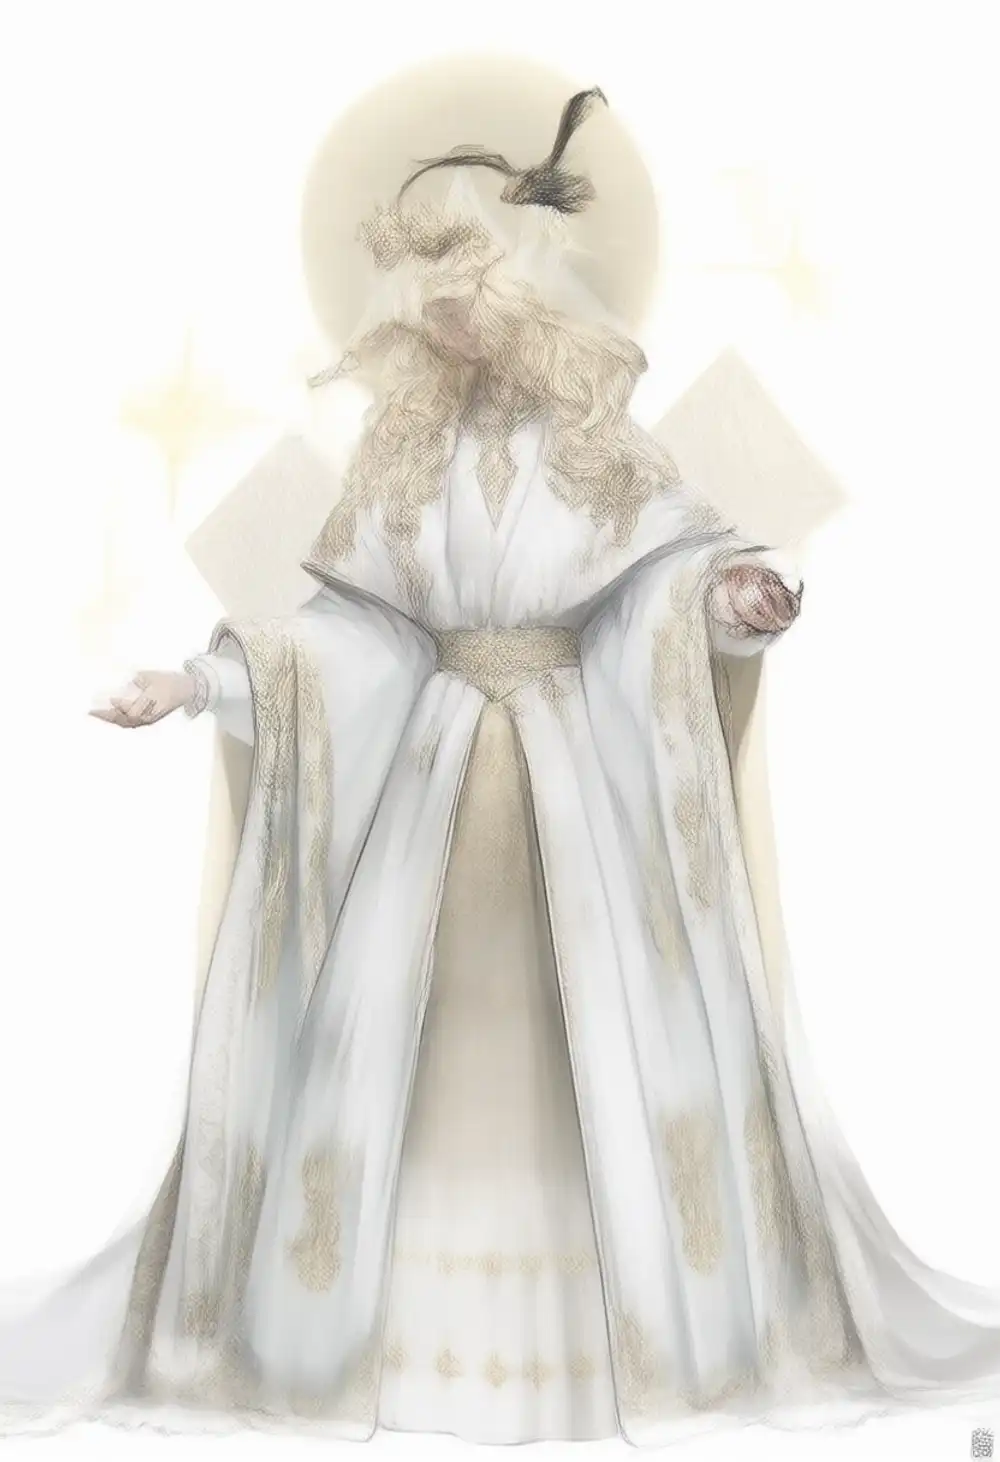
2.9Bの方は絵になってない。
白く飛んだコントラストの低い画面で、白ローブと金髪の人影はなんとか分かるけど、顔は潰れて、線は鉛筆スケッチみたいに二重にぶれてる。
ノイズが抜けきってない途中の見た目で、真っ白なノイズ画像ではない。
LoRAをロードした時のComfyUIのコンソールに lora key not loaded は1件も出てない。1016キー全部が40ブロックのモデルにマッチして、ブロック0から27にそのまま足されている。
手持ちのLoRAをそのまま当てる
で、本題の4人LoRAとペアLoRA。キー名を触らずにそのまま2.9Bへ当てた。軽い指定と全指定、3シード。
どっちもロード時の警告は0件。kohya形式の948キー(DiT側840、LLMAdapter側108)が全部マッチしている。
軽い指定(かな、トリガーのみ)
Anima-Base v1.0の3枚はこうなった。
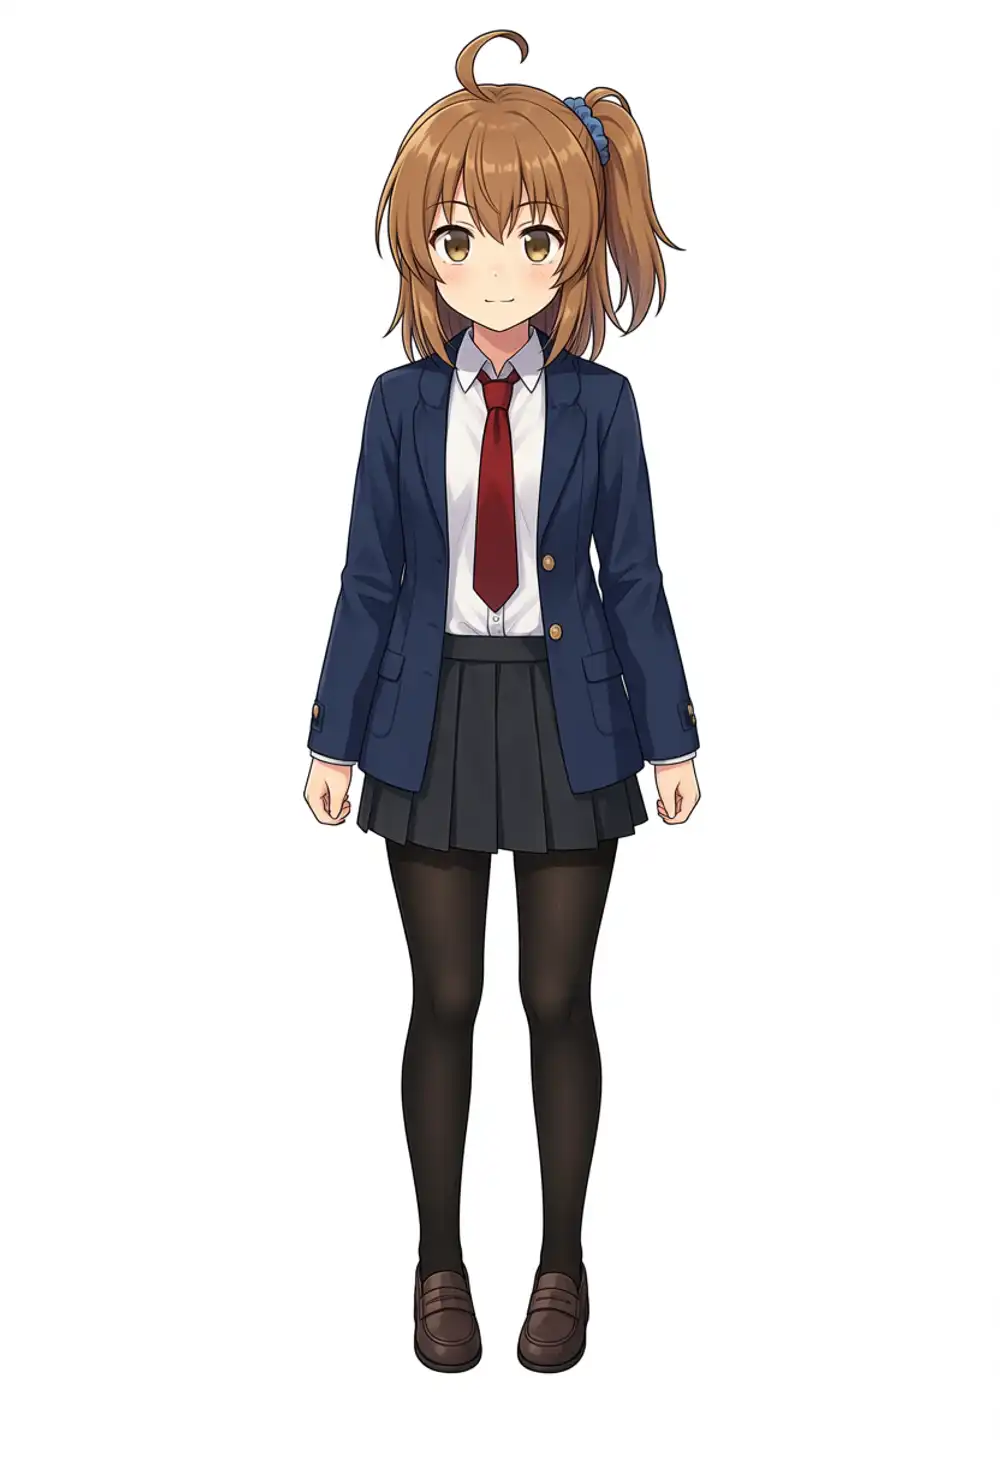
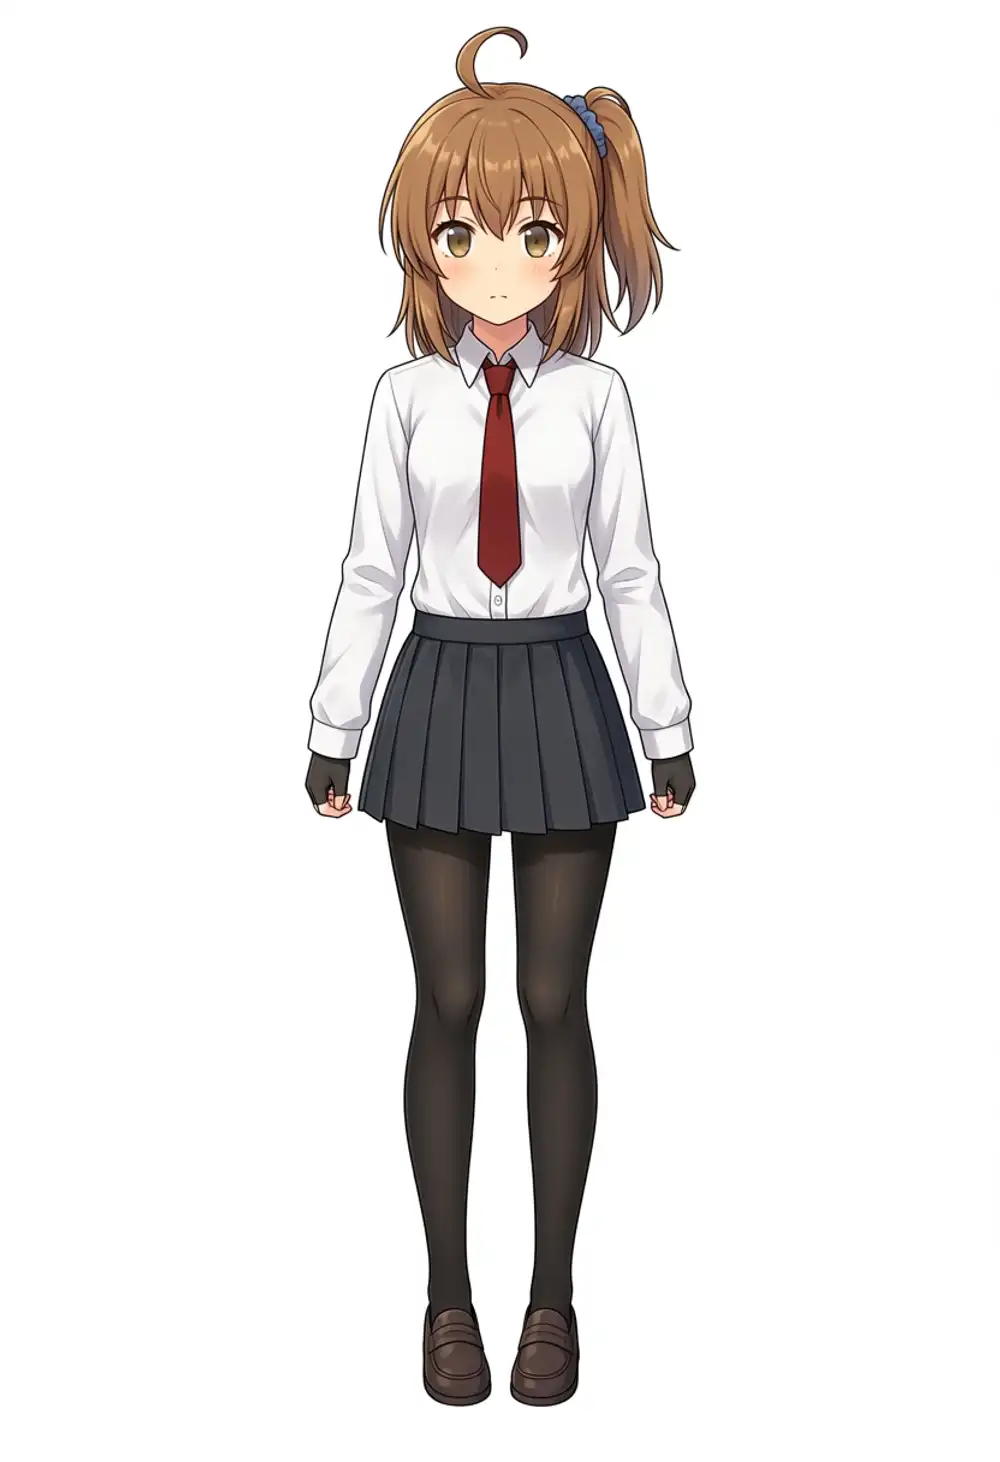
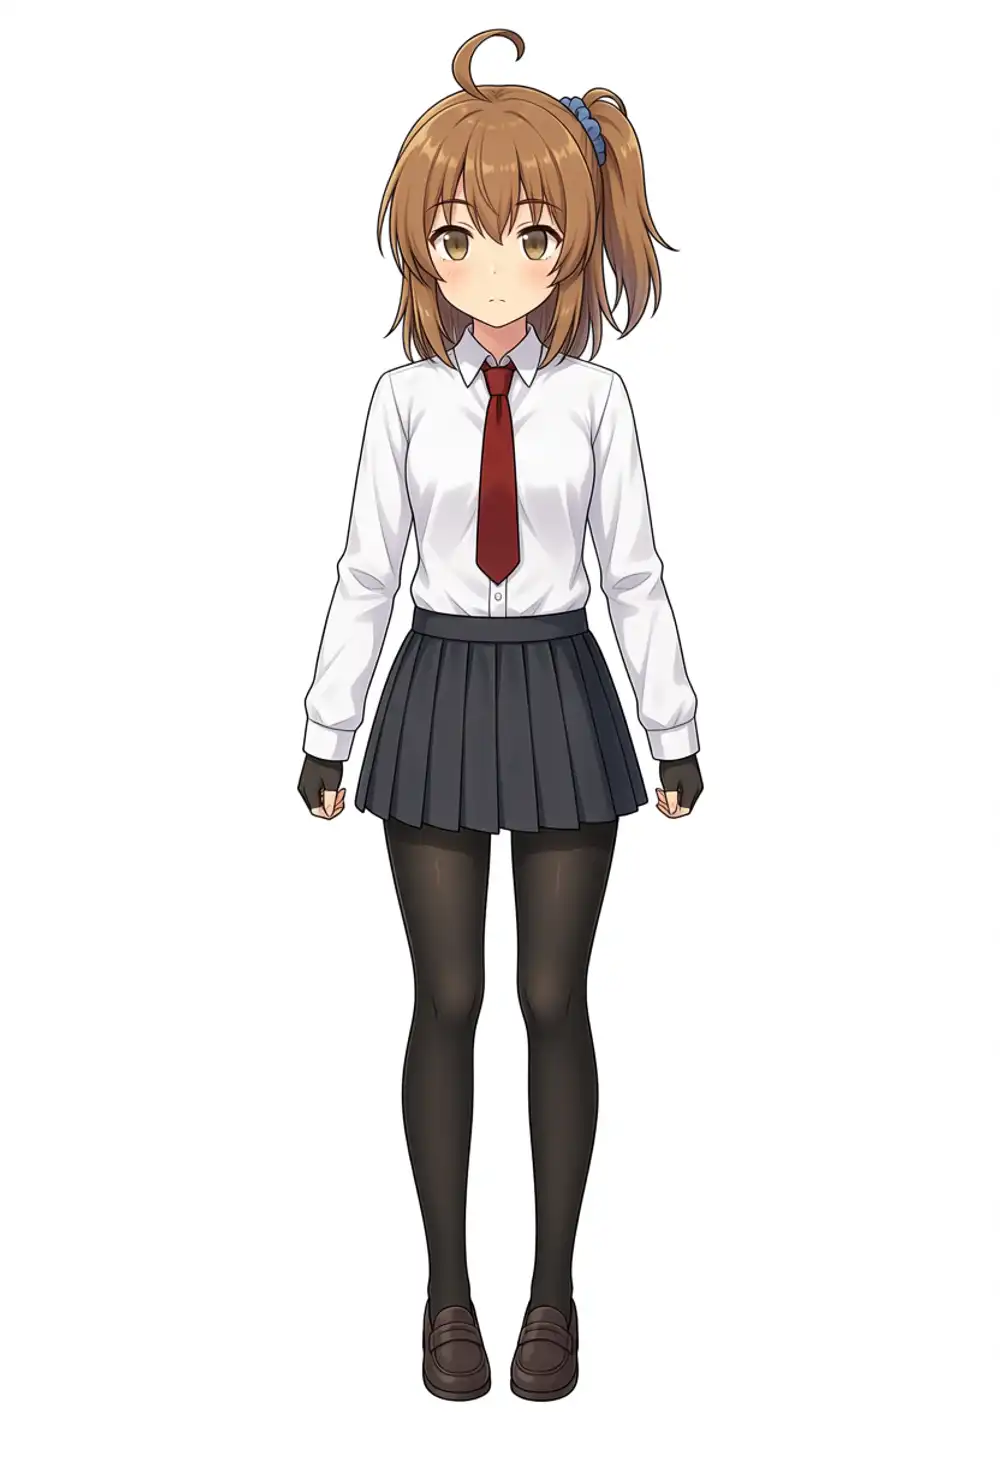
3枚ともサイドポニー、アホゲ、青シュシュの識別キーが全部出た制服のかなで、3/3。時間は242.9〜244.6秒。
2.9Bにそのまま当てた3枚はこうなった。
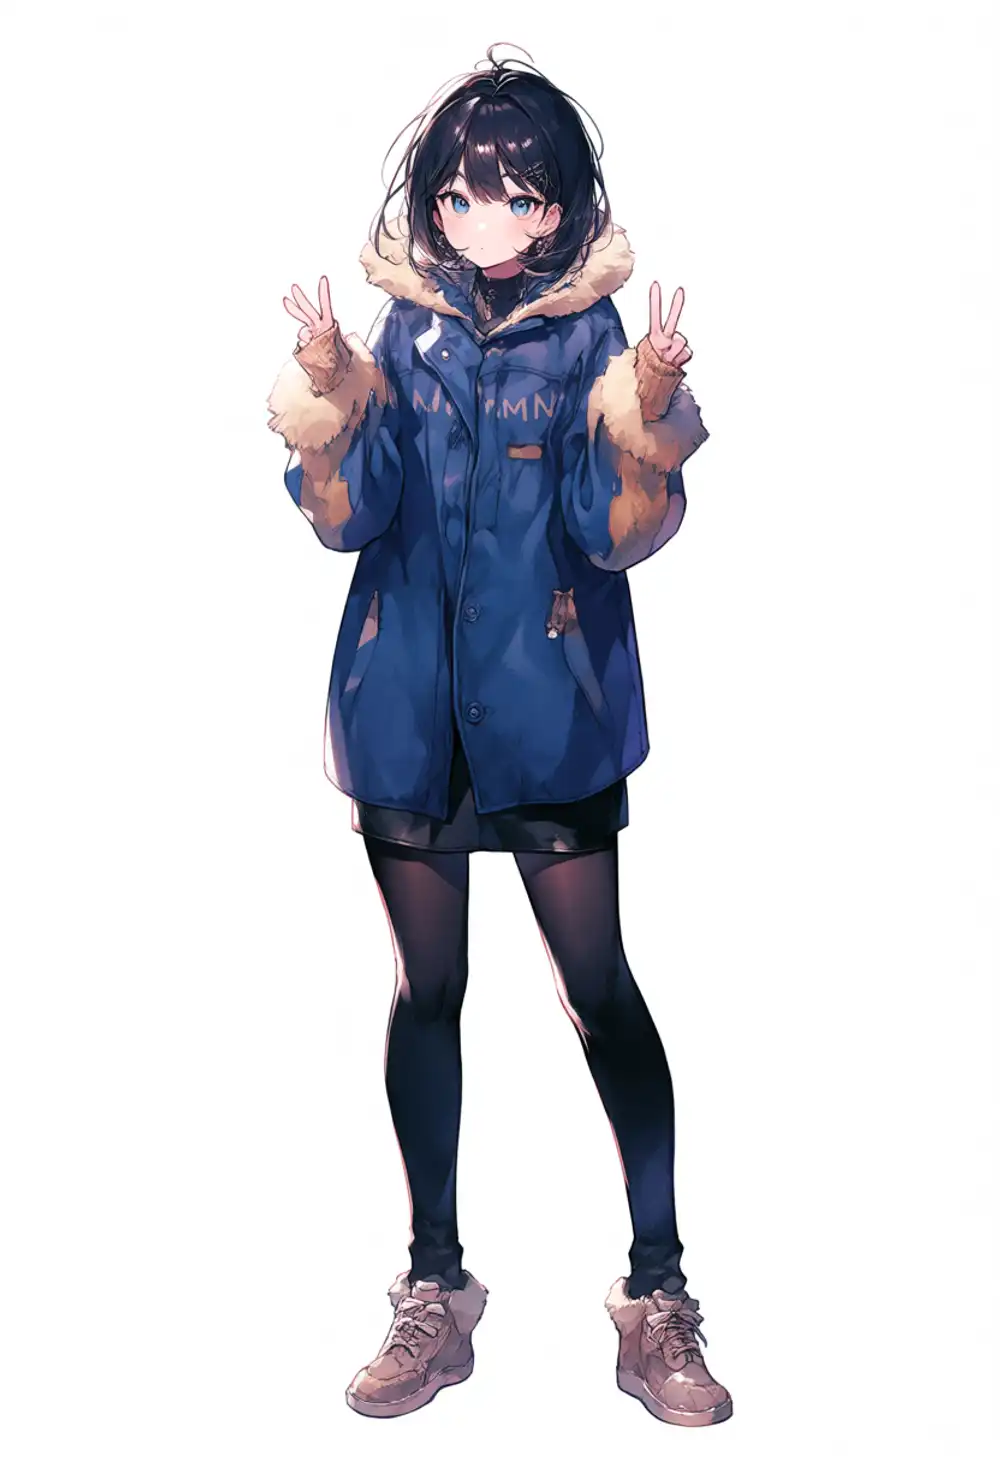
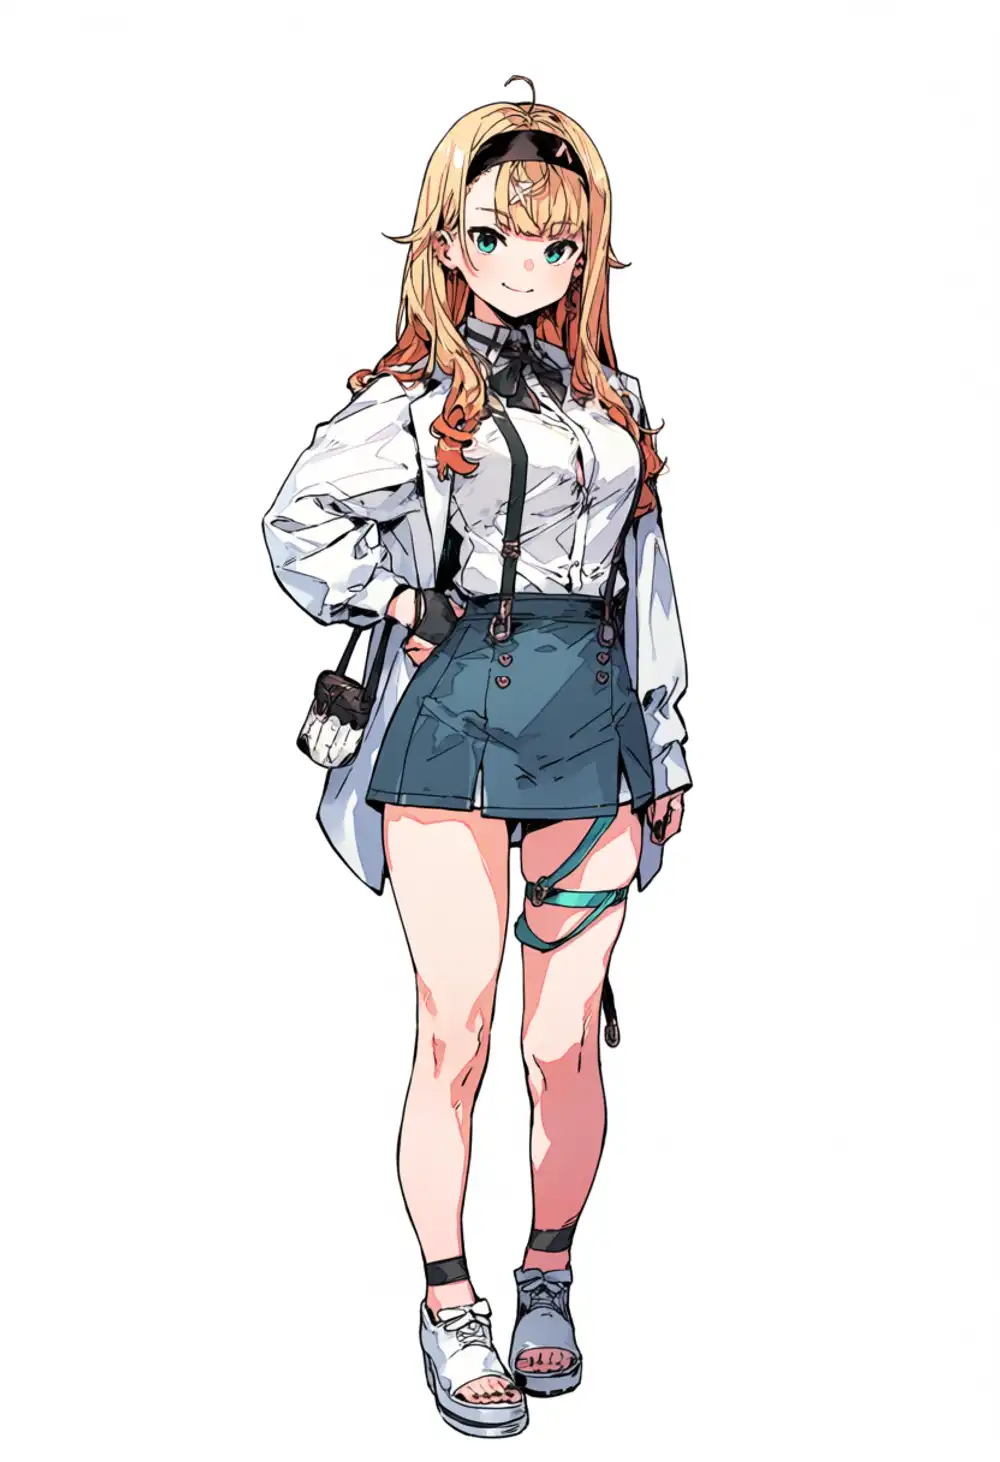
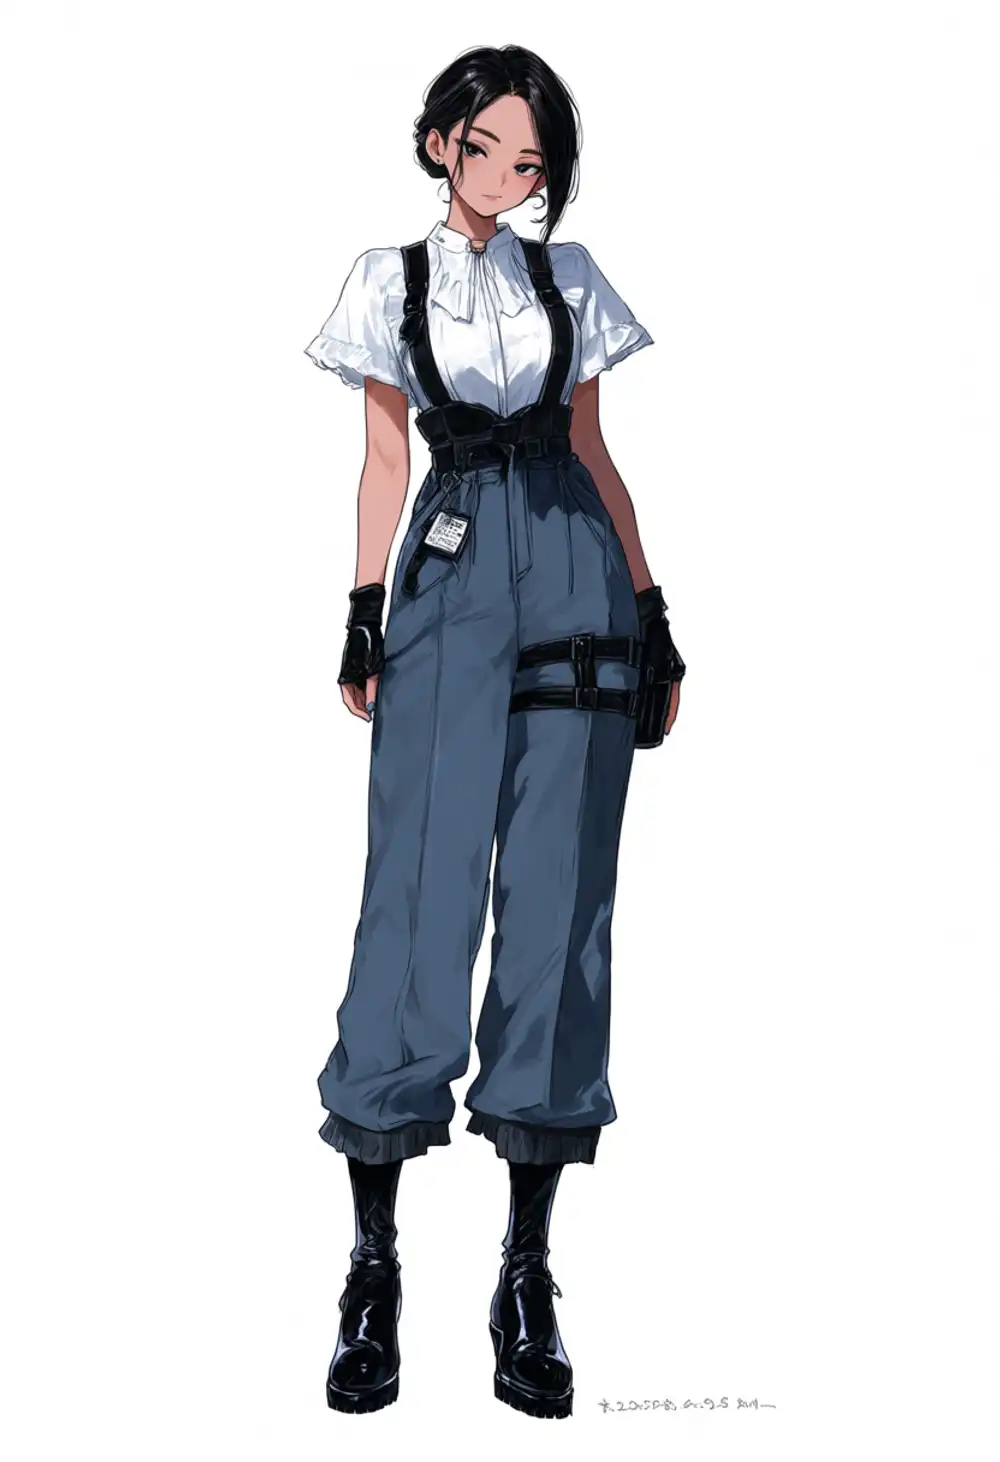
0/3。時間は347.3〜351.1秒。
シード42は黒髪ショートで青目の子がファー付きパーカーで両手ピース、シード1234は金髪ロングに黒いヘアバンドで緑目、シード9999は黒髪を低くまとめてサスペンダー付きのワイドパンツ。
識別キーは1234のアホゲだけで、3枚ともバラバラのキャラ。
絵としては崩れてない。1人の全身立ち絵としては普通にできてて、派生6種の記事でRDBTが獣耳と軍装に化けたみたいな画風の暴走もない。ただ、かなではない。
この別人、ずれた層に足された差分でこうなったのか、それとも素の2.9Bがもともとこういう絵なのか。LoRAを外した2.9Bに同じプロンプトと同じシードを渡してみた。時間は345.4秒で、LoRAのあるなしで生成時間は変わらない。
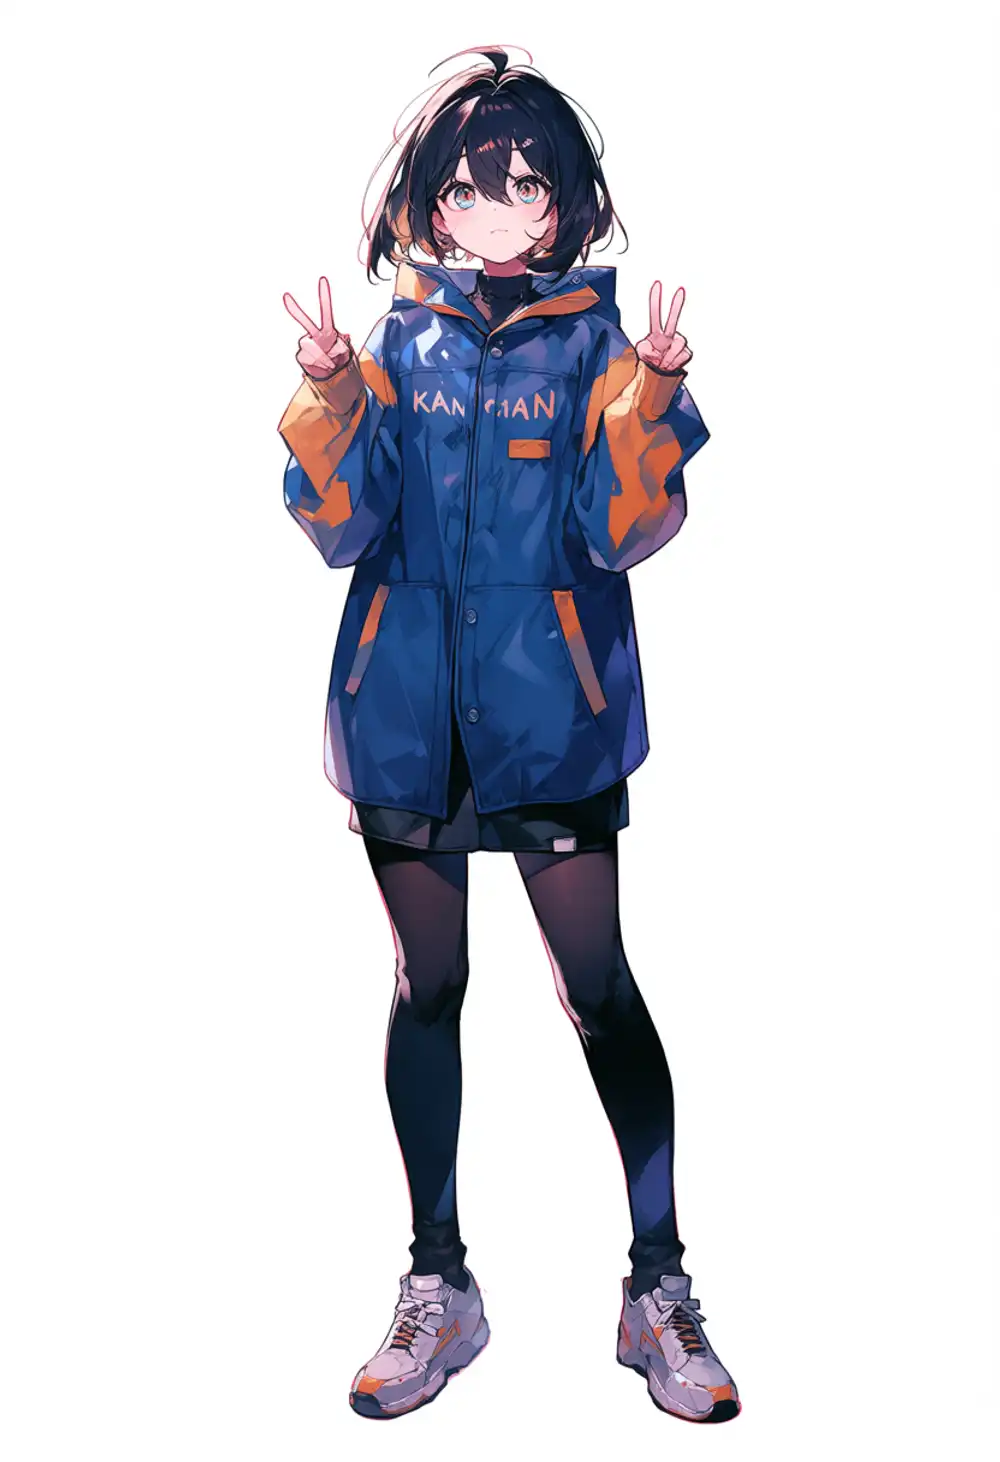
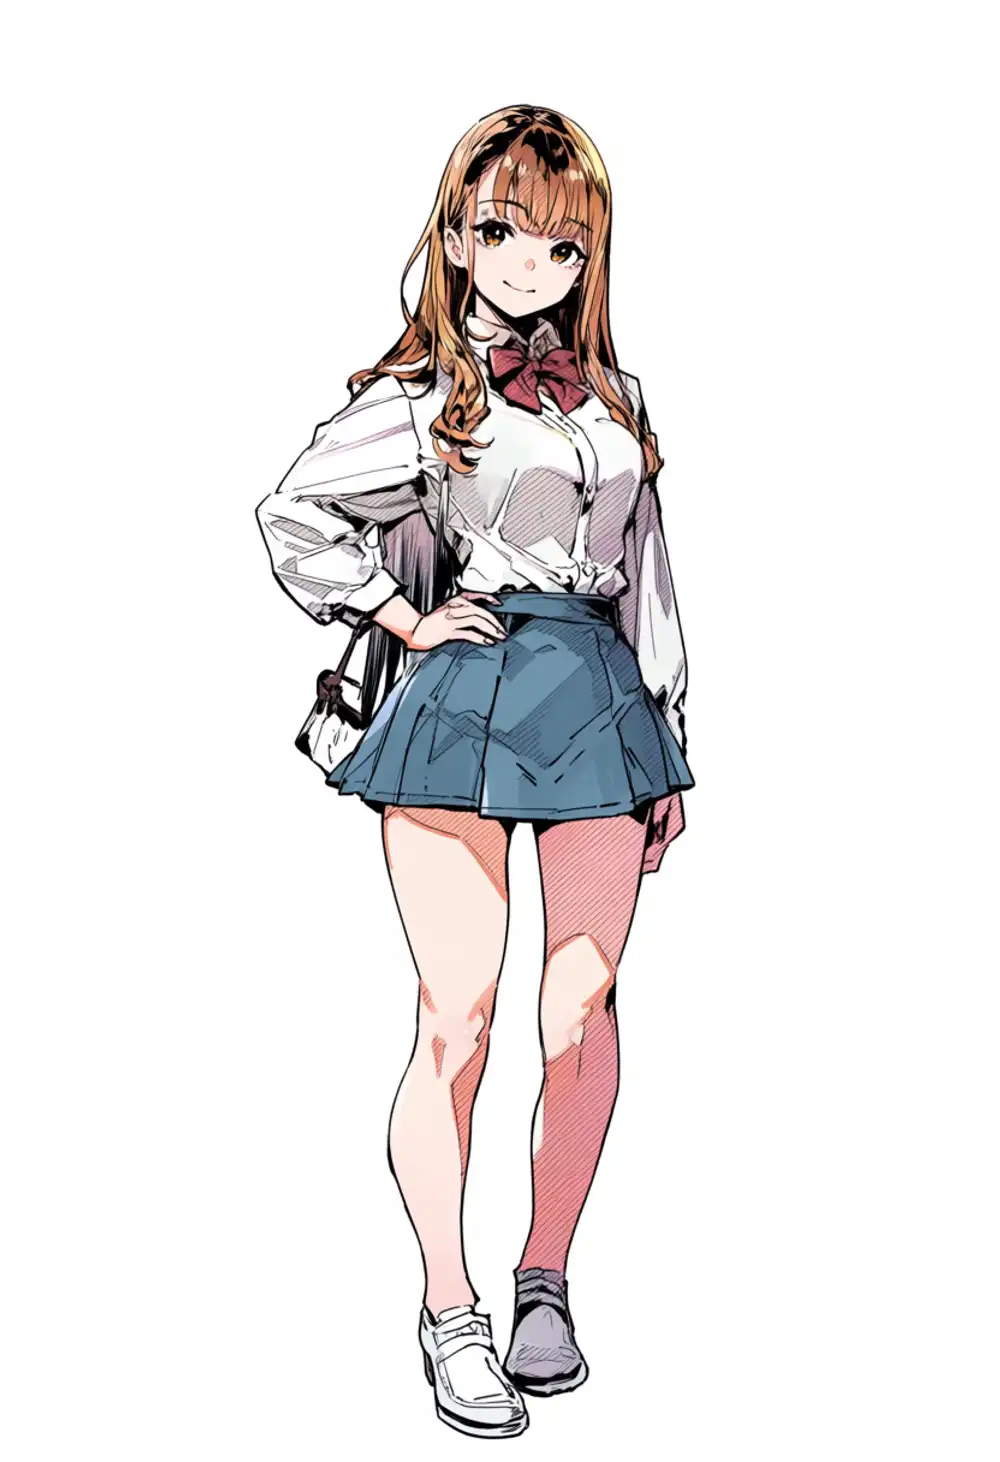
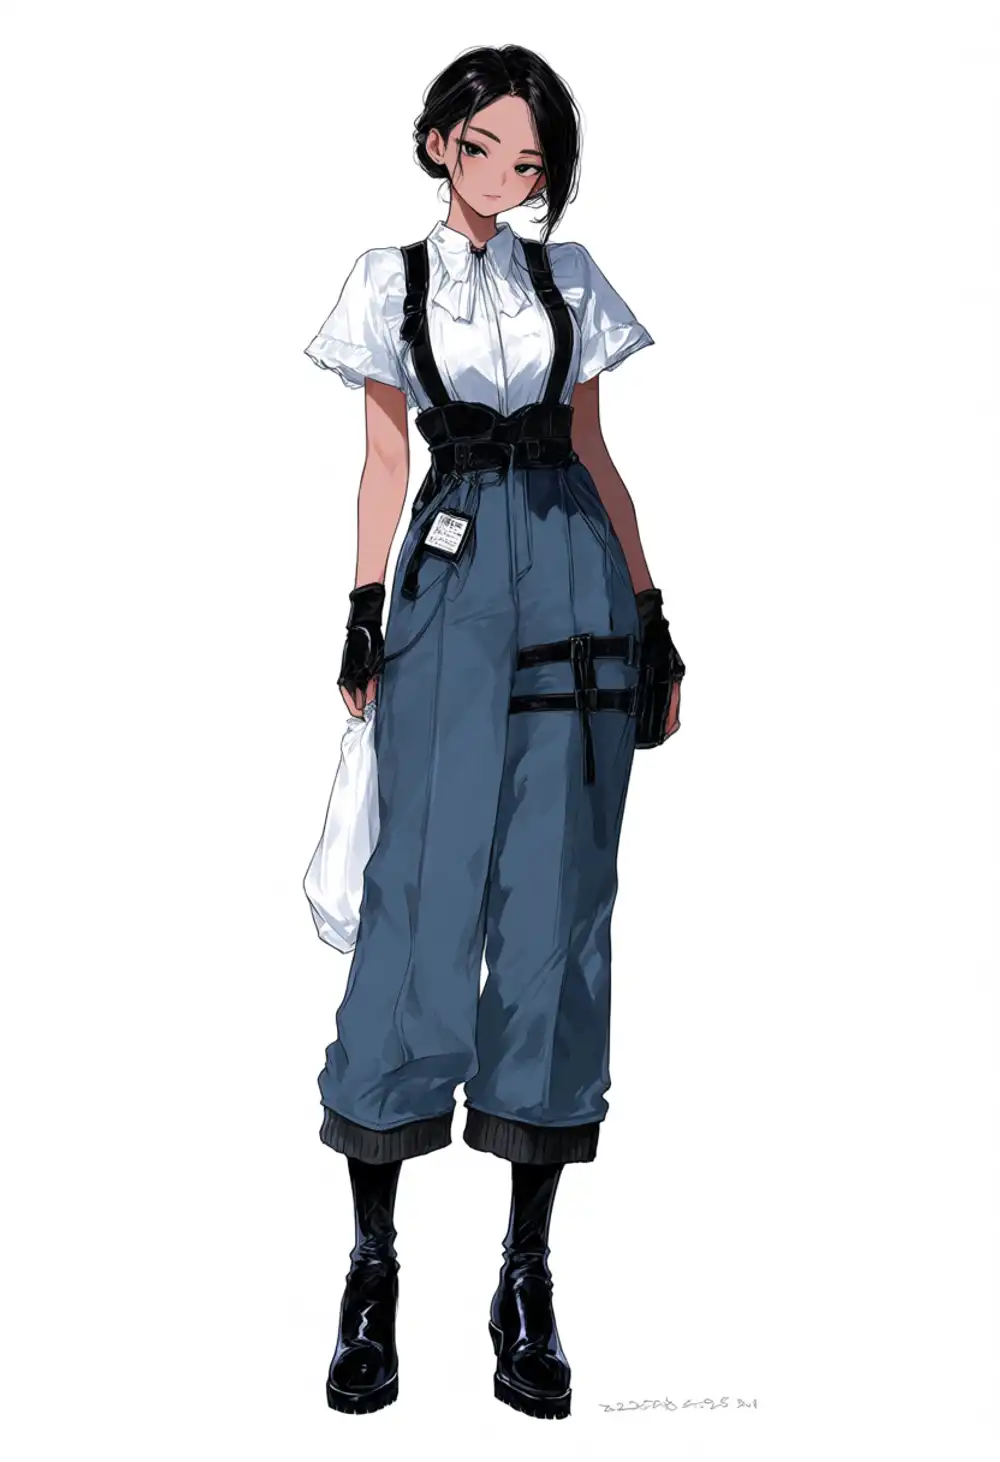
シード42と9999はLoRAありの出力とほぼ同じ絵になった。42は両手ピースの青パーカーと黒ショートパンツまで同じ、9999は髪型も服も指なし手袋も太もものホルスターも同じで、違いは手に提げた袋があるかないかくらい。
1234は構図と画風が同じで、ヘアバンドや目の色や小物が違う。
つまりずれた層に足された差分は、素の出力をほとんど変えてない。そのまま当てた時の別人は、kanachan というトリガーが何の意味も持たない素の2.9Bがそのまま出てきてただけだった。
ちなみにシード42ではパーカーの胸に「KANACHAN」と文字でプリントされてた。知らないトリガー語を文字として描いたらしい。
全指定(4人立ち)
Anima-Base v1.0の3枚はこうなった。
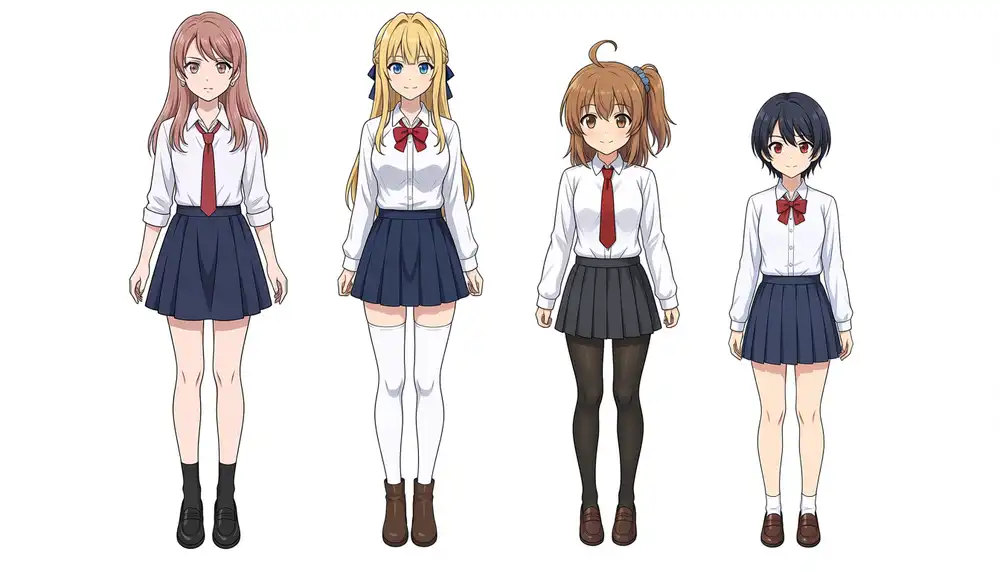
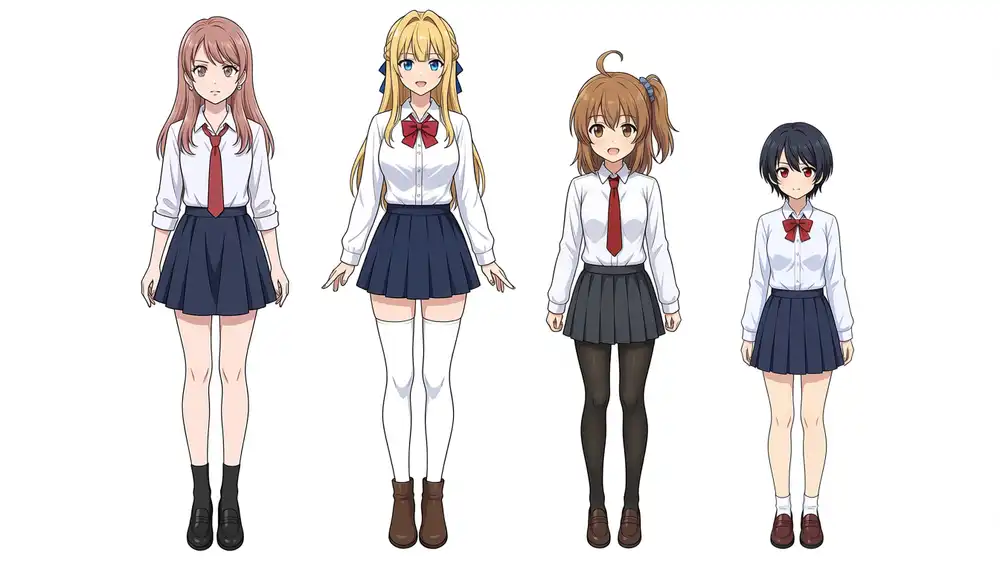
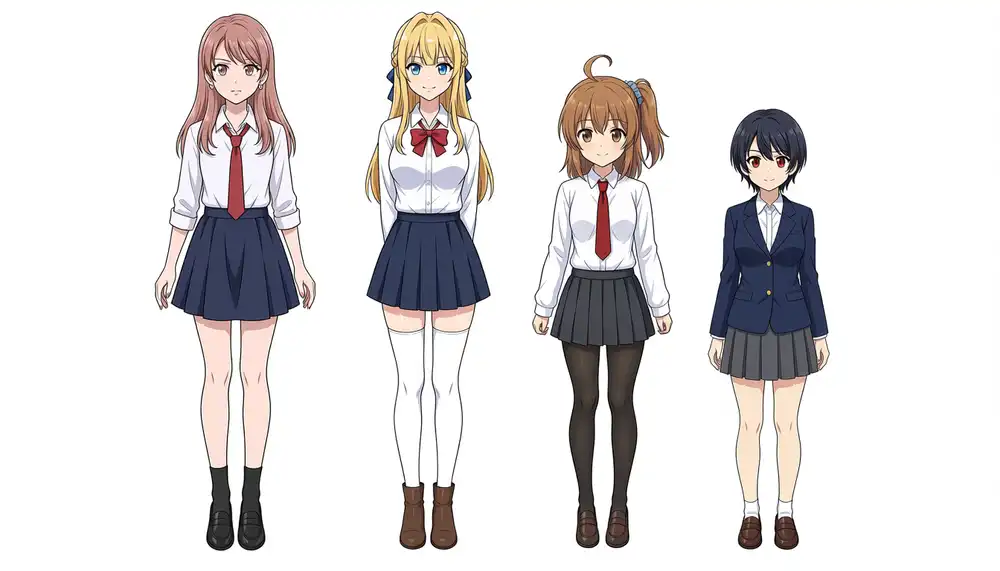
3枚とも人数4、混色ゼロ、身長段差がくらら=けい>かな>こはるで、4人LoRAの記事の判定基準そのまま。時間は244.6〜252.6秒。
2.9Bにそのまま当てた3枚はこうなった。
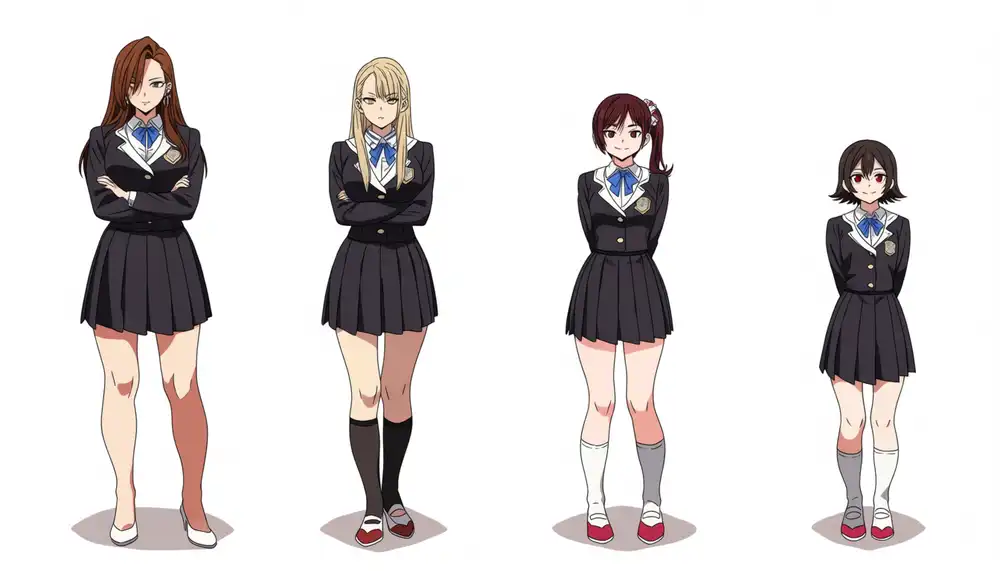
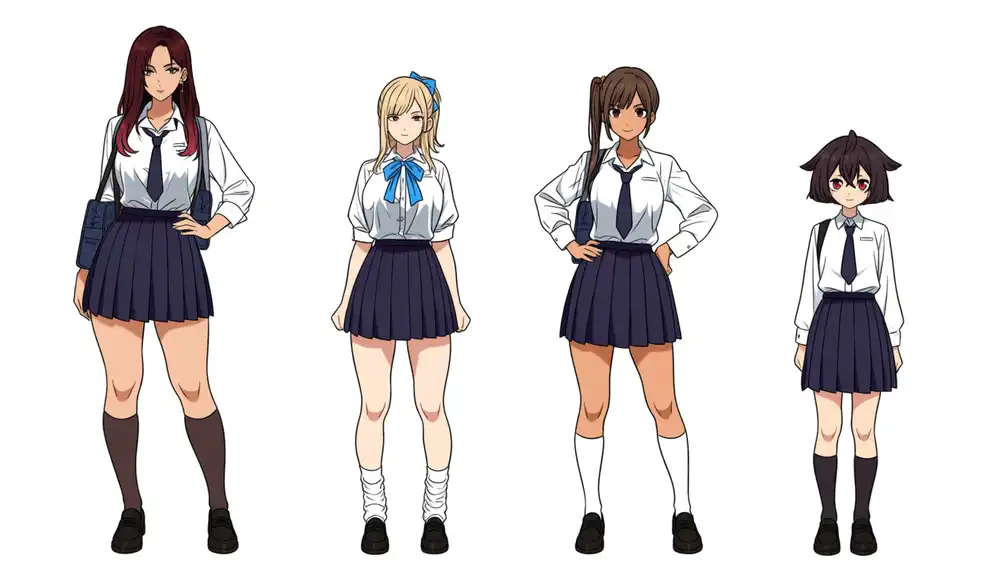
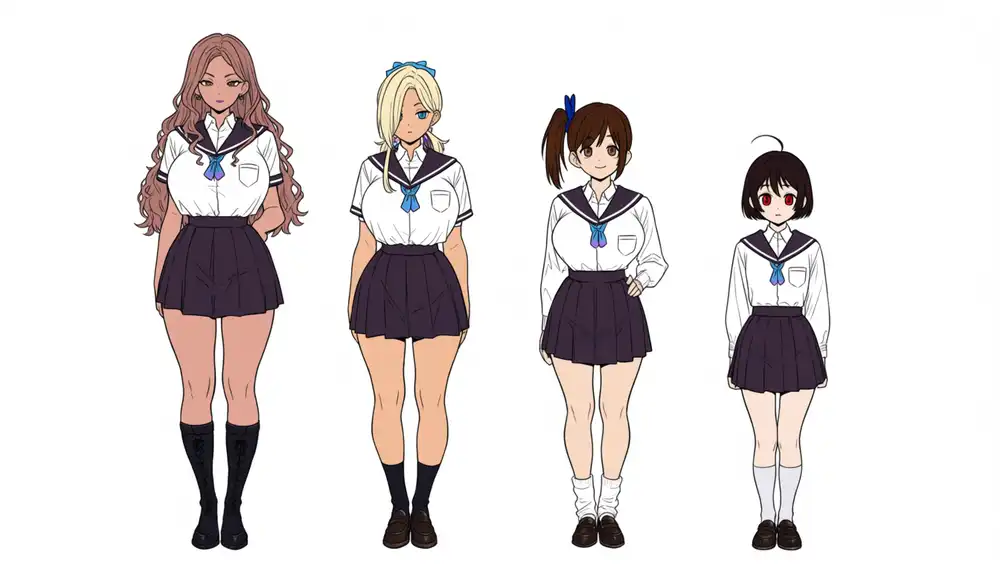
人数は3枚とも4で、プロンプトのアンカーは指定した位置に出た。時間は347.4〜349.5秒。
左から2番目が金髪、3番目がサイドポニー、右端が黒ショートで赤目、という対応はそのまま。
けど4人とも本人じゃなくて、顔も頭身も別物で、全員が背が高くて脚の長い劇画寄りの体型になって、かなの茶髪が暗い赤に寄ったり、サイドポニーが向かって左に付いたり、くららとけいが褐色肌になったりする。
アホゲと青シュシュは出なくて、制服は2.9Bが勝手に黒ブレザーやセーラー襟にして、身長段差は左から右へ一段ずつ下がる階段になった。
隣のキャラへの属性移りは目立たない。
4人LoRAをモジュール別に分けた記事で、素のAnimaでも指定した位置に属性は出るけど人物は別人のまま、と書いたのがそのまま出てる。
ペアLoRA(けい・かな2人立ち)
keikana-animabase-v2_epoch140 を、2キャラLoRA v2の記事のプロンプトの書き方(左右の位置と各キャラの特徴を自然文で書いて、“they are two different girls” を付ける)で2人立ちにした。832×1216、シード42。
| モデル | かかった時間 |
|---|---|
| Anima-Base v1.0 | 249.0秒 |
| Anima-2.9B | 347.4秒 |
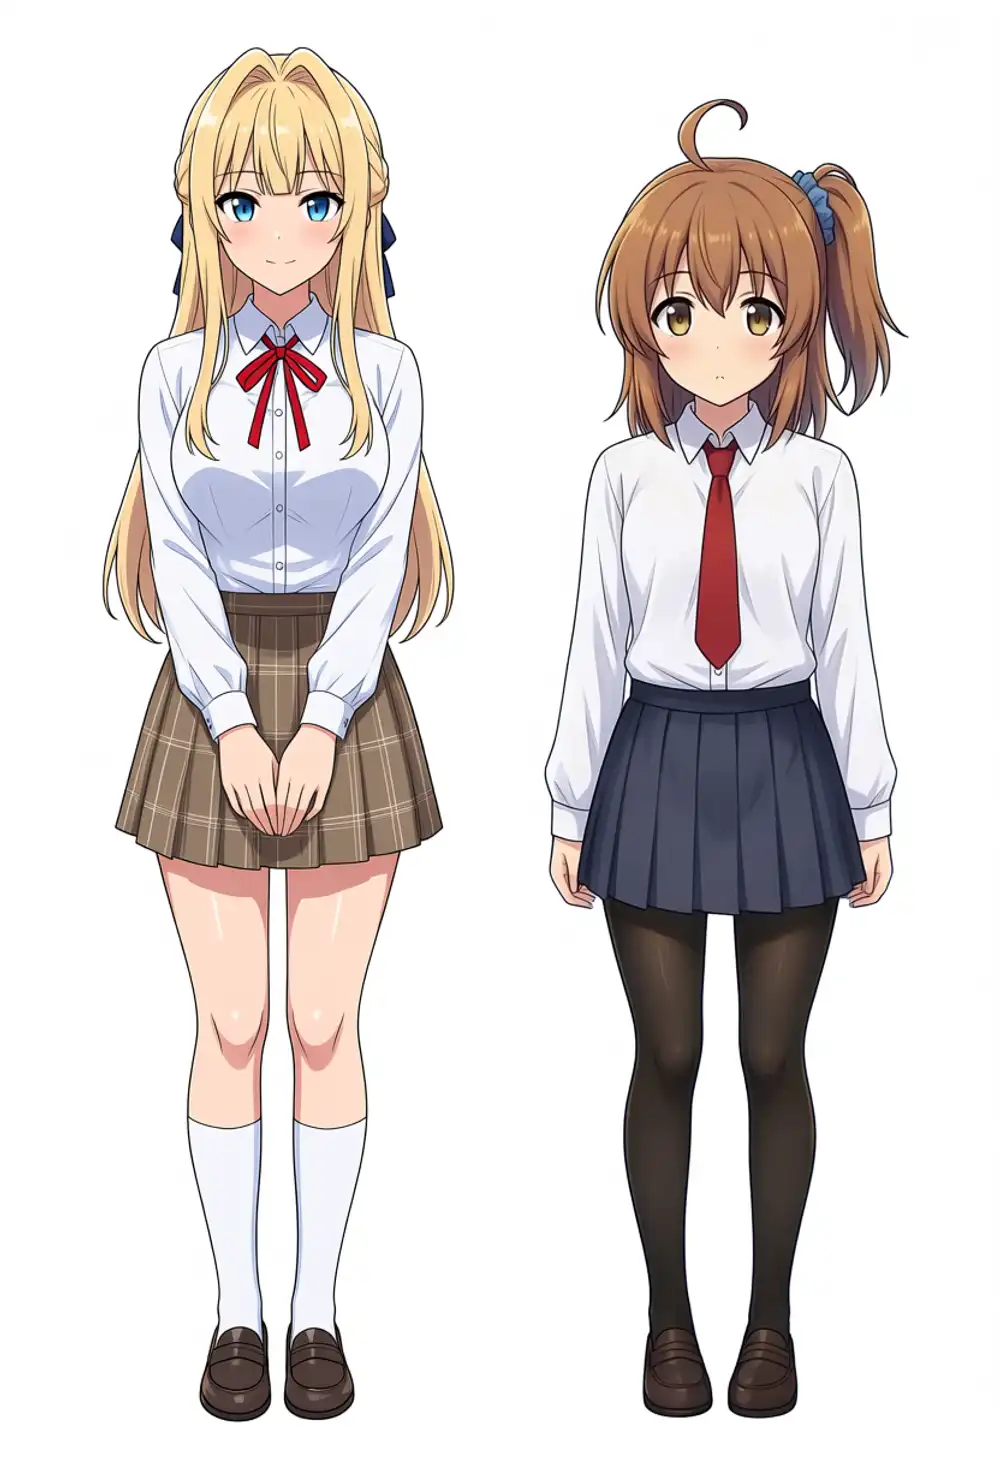
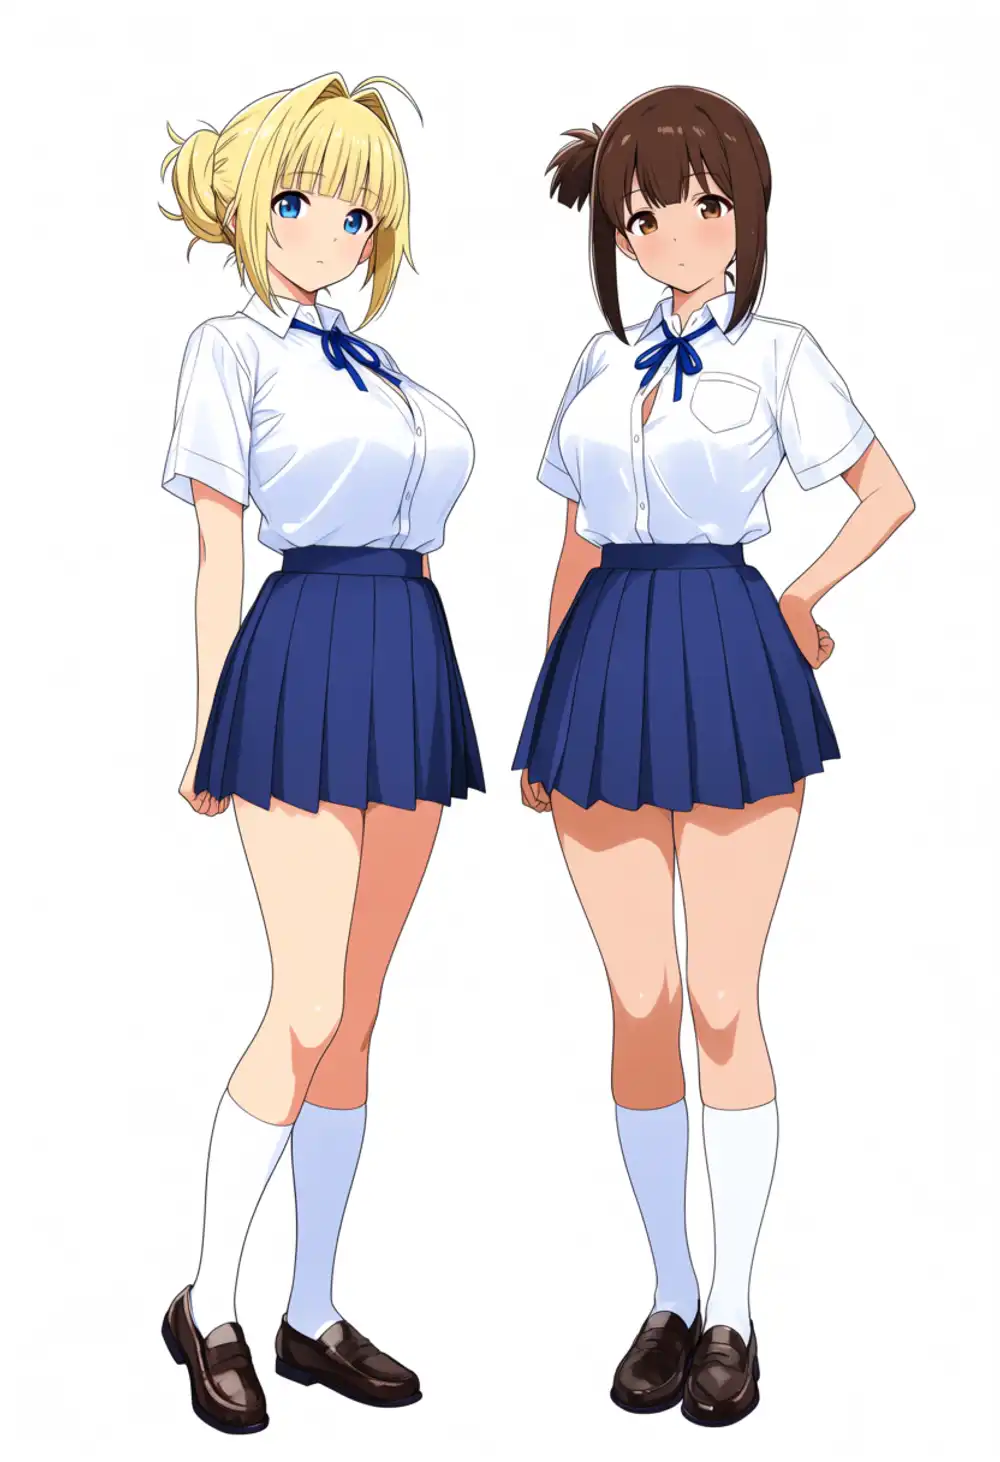
v1.0は左がけい、右がかなで2人とも本人。
2.9Bも融合も属性移りもなく、ちゃんと2人立ちにはなったけど、2人とも本人じゃない。
左は金髪ぱっつんで青目だけど髪が短いお団子でインテークも頭の青リボンもなくて、右は茶髪でサイドポニーが向かって左の低い位置、アホゲもシュシュもない。体型も別物。
ブロック番号を付け替えたLoRAを当てる
じゃあ番号を付け替えたらどうなるか。LoRAのsafetensorsを開いて、DiT側のキー名に入ってるブロック番号を上の対応表で付け替えて、LLMAdapter側はそのままで保存し直してみた。
付け替えたLoRAを同じ設定で2.9Bに当てた。
キーの実物はこんな感じ。
4人LoRAとペアLoRAはkohya形式で、DiT側が lora_unet_blocks_12_self_attn_q_proj.lora_down.weight みたいにアンダースコア区切り、LLMAdapter側が lora_unet_llm_adapter_blocks_0_ で始まる。
Turbo LoRAはPEFT形式で diffusion_model.blocks.12.self_attn.q_proj.lora_A.weight、LLMAdapter側は diffusion_model.llm_adapter.blocks.0. で始まる。
expand_manifest.json の insertion_positions から対応表を作って、lora_unet_blocks_ と diffusion_model.blocks. の直後の数字だけを書き換えた。
| LoRA | 全キー | 付け替えたキー | 触ってないキー |
|---|---|---|---|
anima-4char-v1_epoch100 | 948 | 840(28ブロック×30) | LLMAdapter 108 |
keikana-animabase-v2_epoch140 | 948 | 840 | LLMAdapter 108 |
anima-turbo-lora-v0.1 | 1016 | 896(28ブロック×32) | LLMAdapter 120 |
付け替えた3本も、ロード時の警告は0件。
軽い指定(かな、付け替え後)
時間は344.9〜352.9秒。
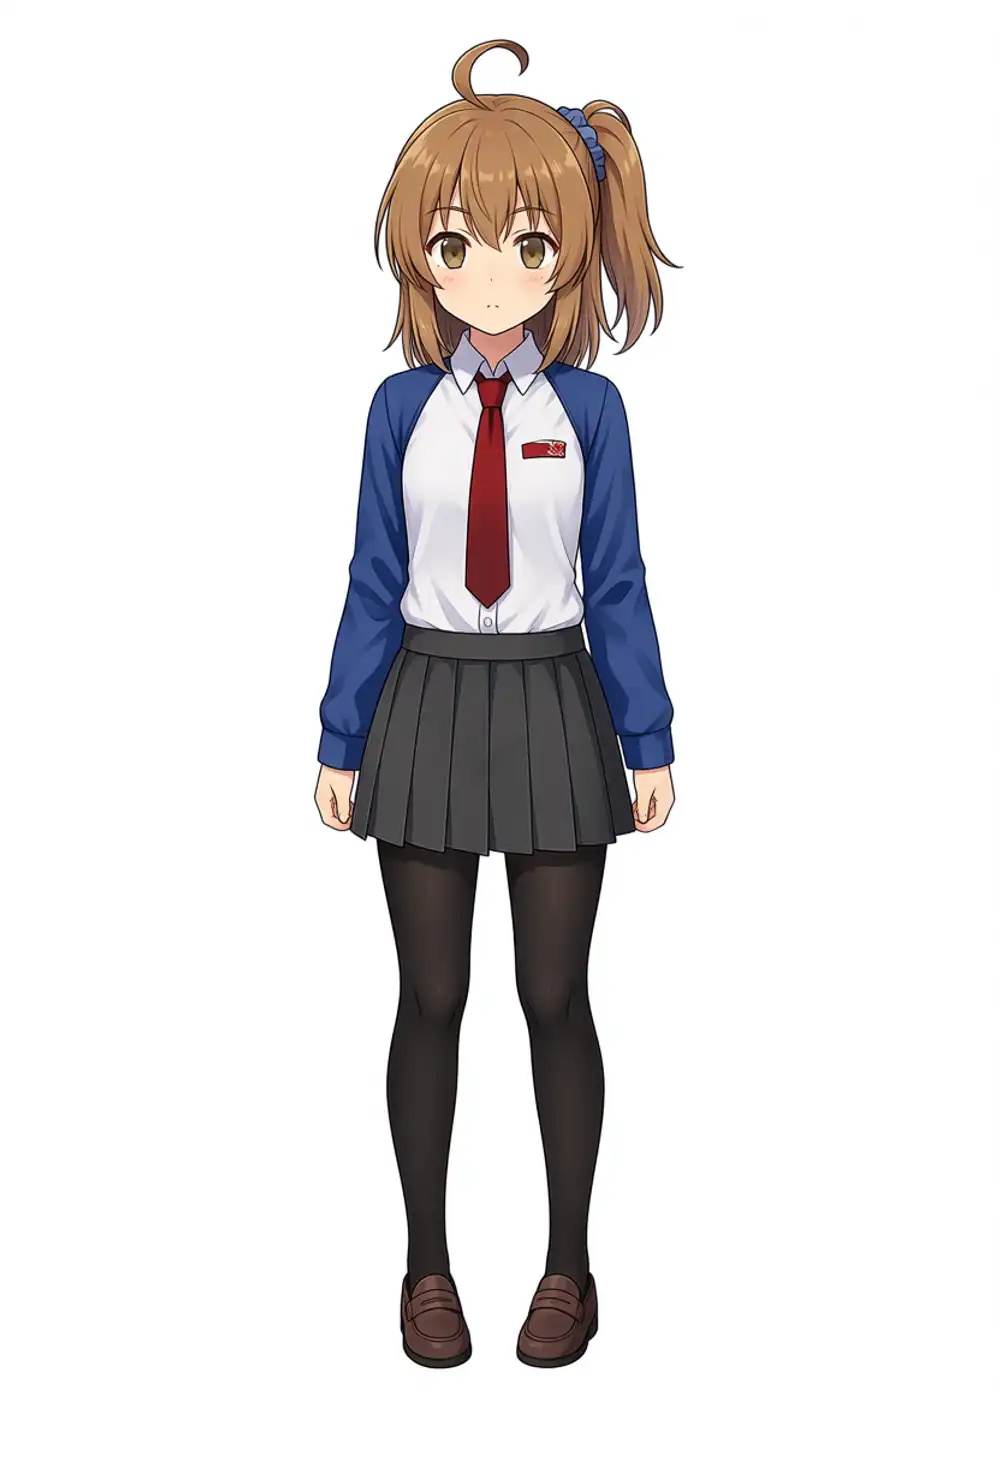
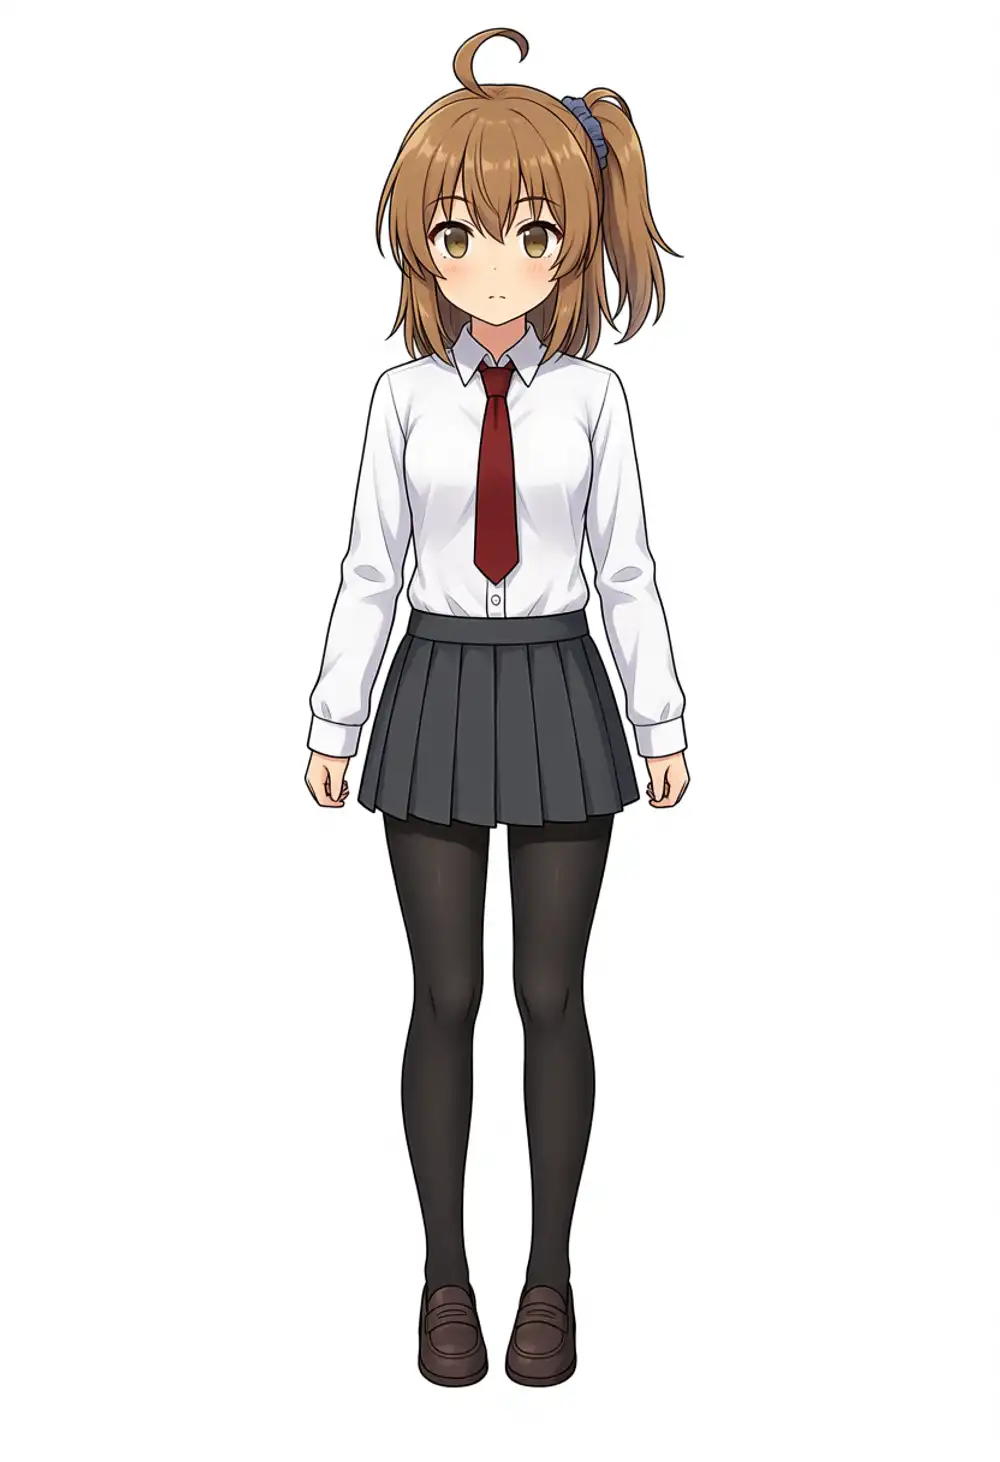
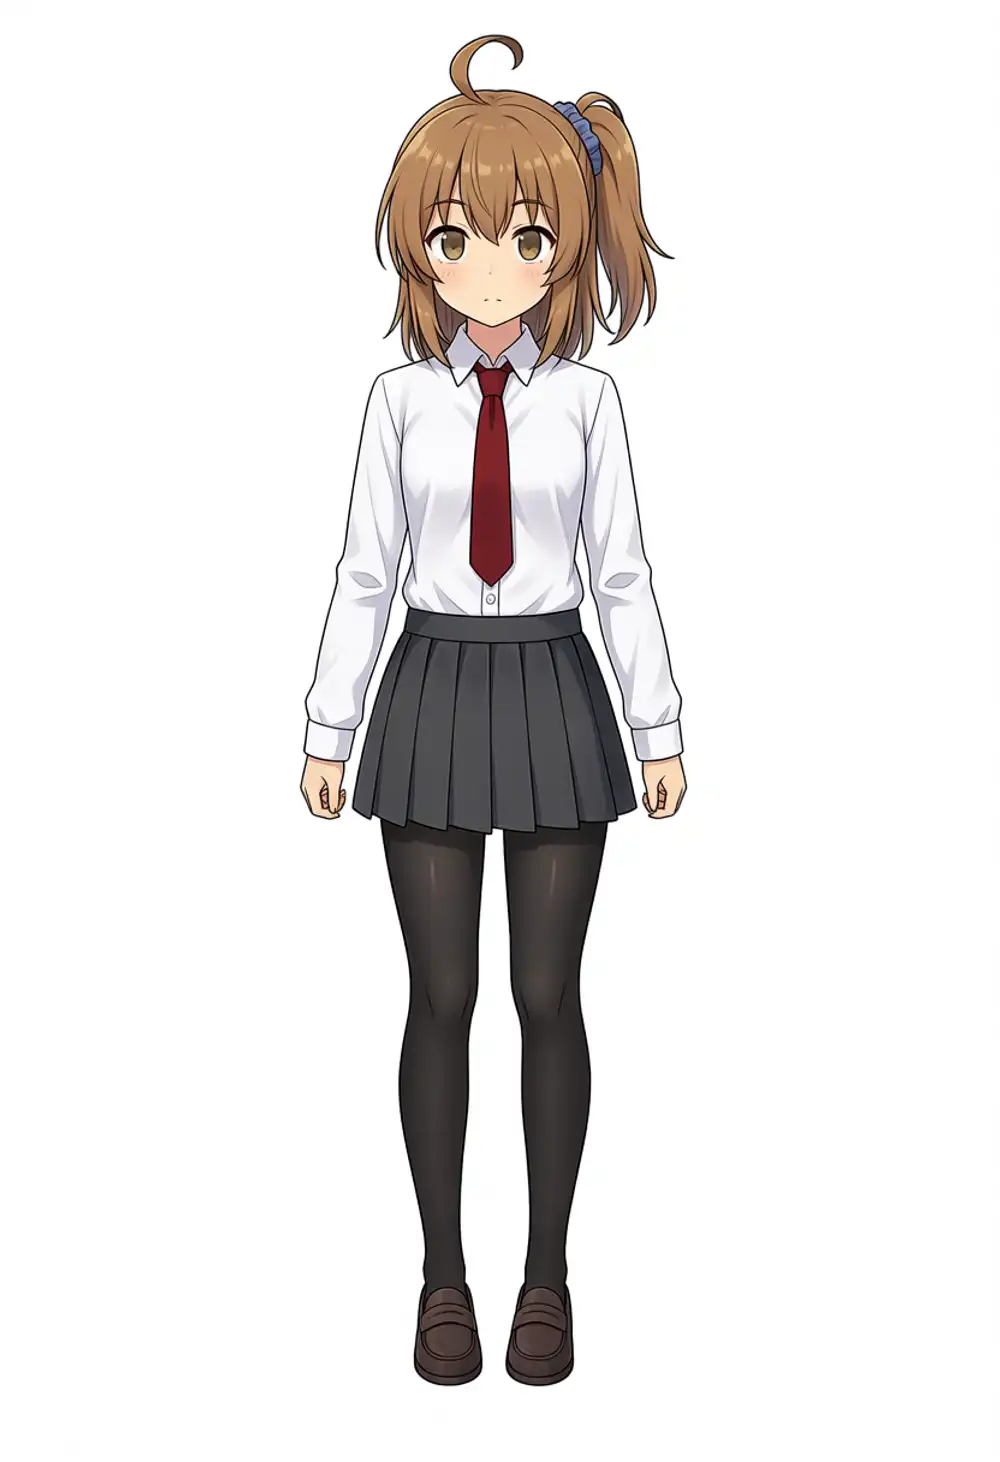
3/3でかなが出た。
3枚ともv1.0の同じシードと構図も顔も同じで、違いは服の小物だけ。シード42は紺ブレザーが袖だけ青いラグランシャツになって、1234と9999はv1.0にあった指なし手袋がない。
そのまま当てた時の黒髪ショートと、付け替えた時のかなの差は、同じファイルのキー名の数字を書き換えたかどうかだけ。
全指定(4人立ち、付け替え後)
時間は347.4〜349.4秒。
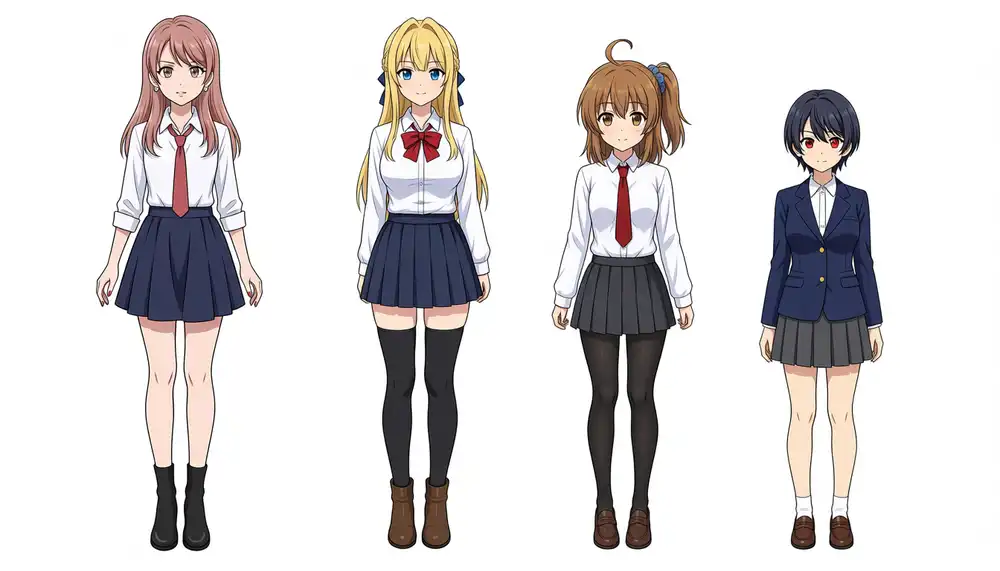
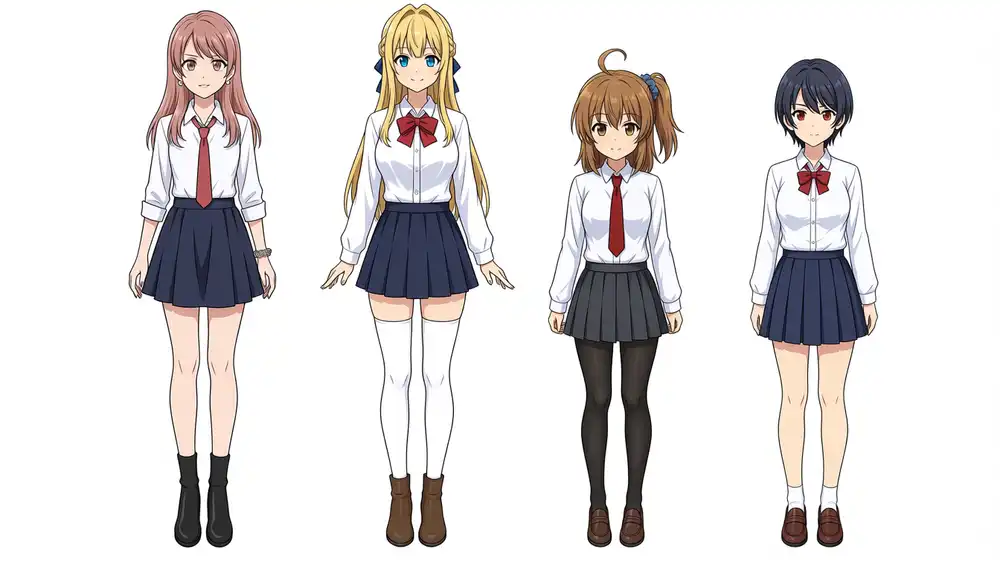
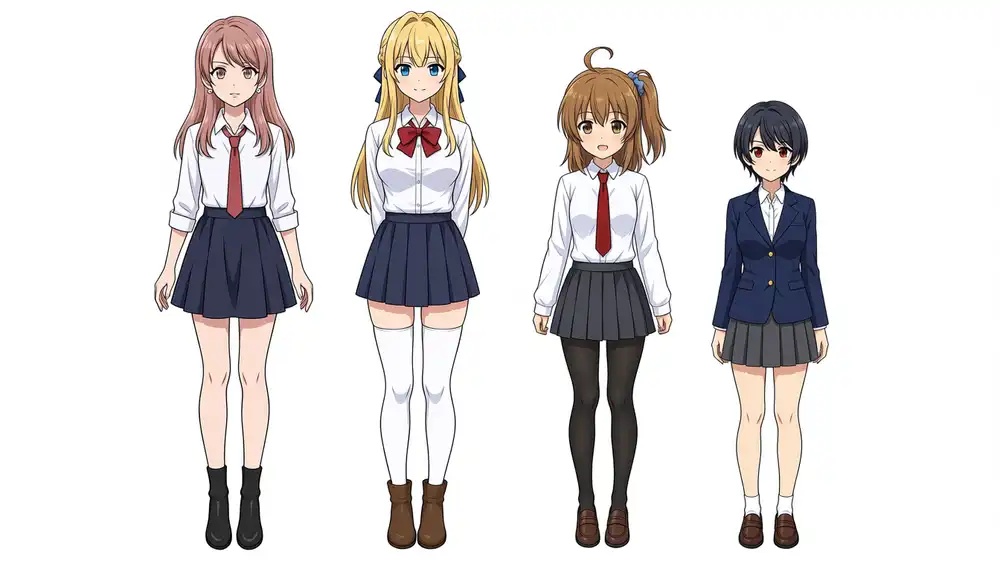
3/3で、人数4、混色ゼロ、身長段差くらら=けい>かな>こはるまで出た。
v1.0の同じシードと並びもポーズも顔も同じで、けいのニーソが白から黒、くららの靴がローファーからショートブーツ、こはるがブレザーを着てる、の3点だけ違った。
ペアLoRA(付け替え後)
| モデル | かかった時間 |
|---|---|
| Anima-Base v1.0(再掲) | 249.0秒 |
| Anima-2.9B | 349.4秒 |
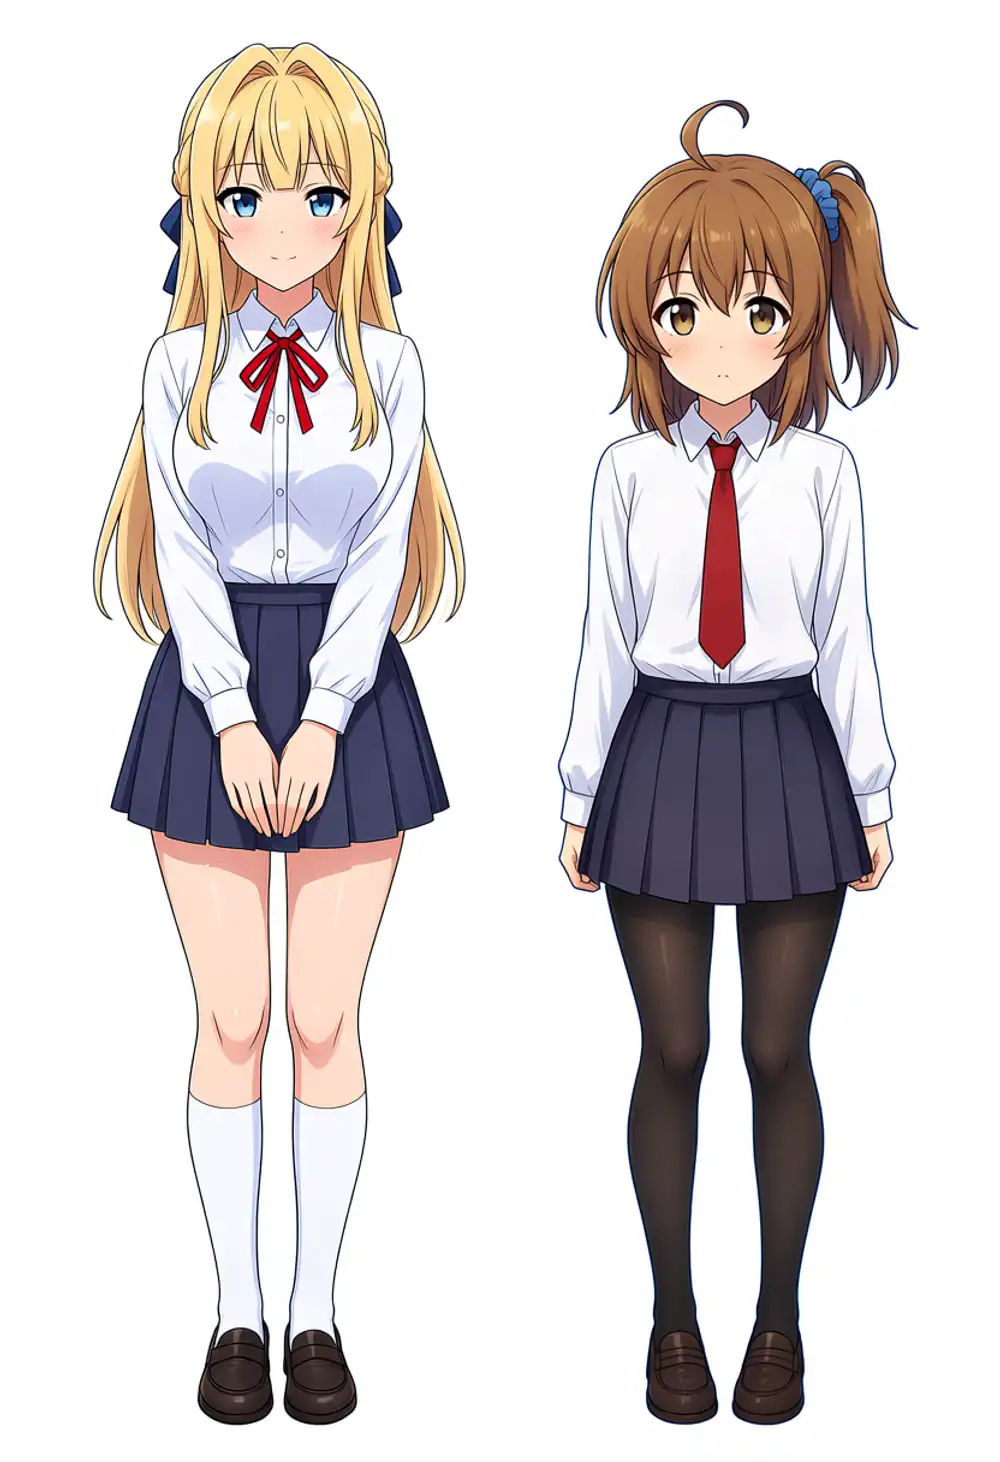
左けい、右かなで2人とも本人が出た。v1.0と比べると、けいのスカートが茶チェックから紺プリーツになってた。
Turbo LoRA(付け替え後)
| モデル | かかった時間(8ステップ) |
|---|---|
| Anima-Base v1.0(再掲) | 40.2秒 |
| Anima-2.9B | 56.2秒 |
時間はそのまま当てた時と同じ。
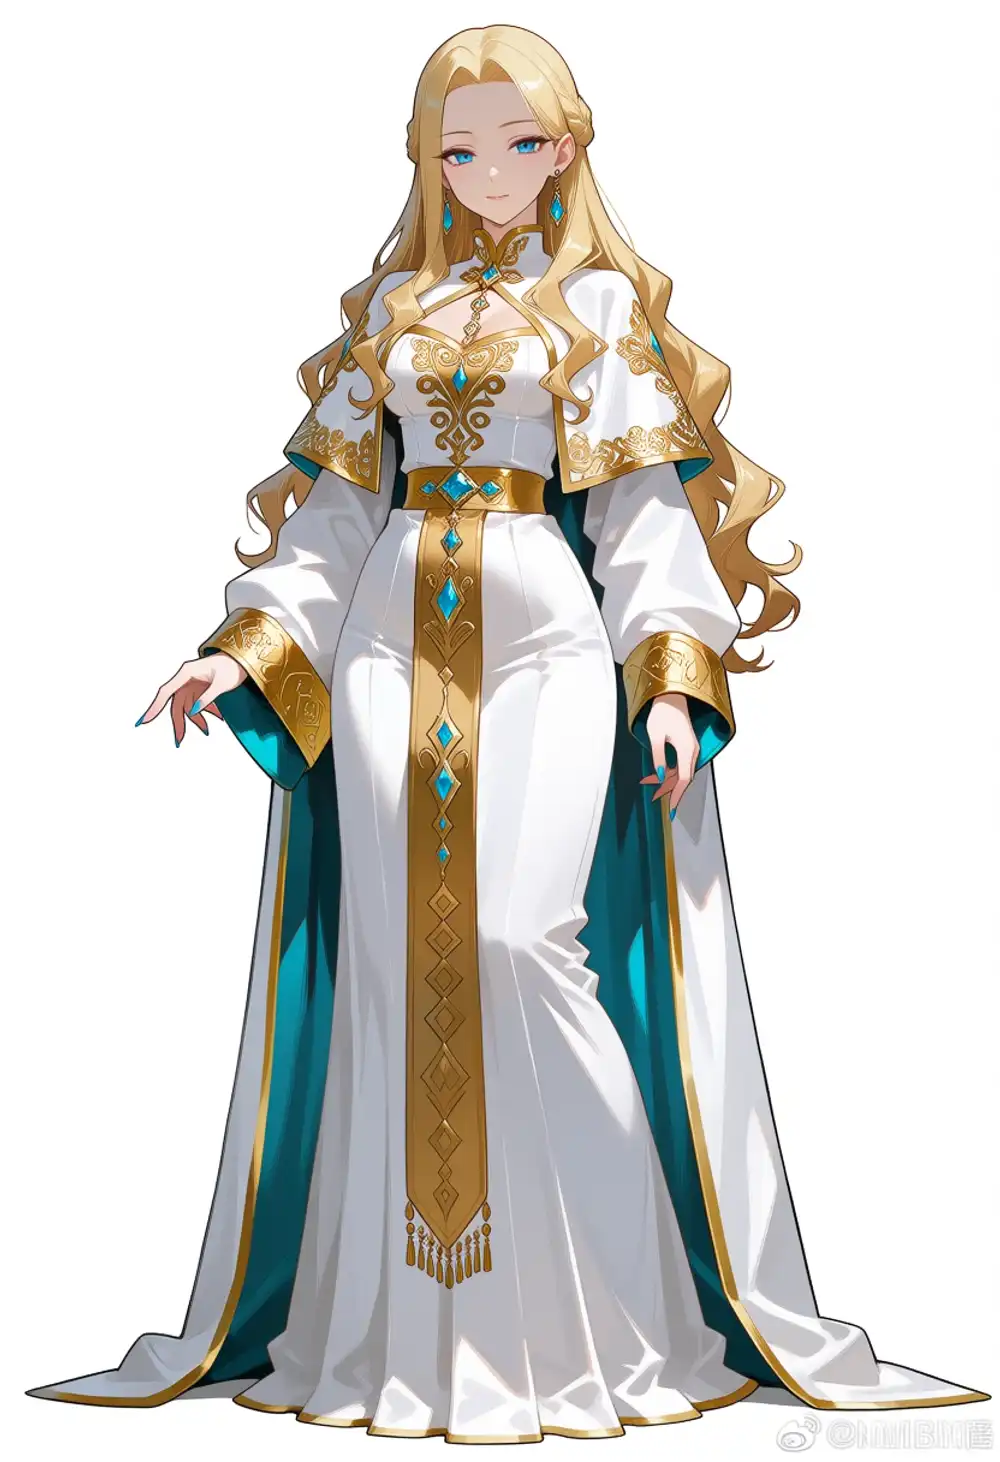
こっちは普通に絵になった。v1.0にTurboを当てた同じシードの出力と構図がほぼ同じで、ティールの裏地と宝石まで同じ。2.9B側は金の飾りが増えて、右下にサインっぽい文字列が出た。
int8_convrot版はMacで動くか
作者はint8_convrot版も置いている。
Anima-Turbo INT8ConvRot版をM1 Maxで動かした記事では、MPSにint8×int8の行列積がなくて、CPUフォールバックか逆量子化パッチでしか動かなかった。
2.9Bの量子化版も同じ形式なら結果は変わらないはずなので、ロードが通るかと、通った場合の生成時間だけ一応確認しておいた。
結果は同じ。
ファイルの中身は、各層の comfy_quant メタデータが {"format": "int8_tensorwise", "convrot": true, "convrot_groupsize": 256} で、40ブロック全部の16個の線形層(self_attnとcross_attnのq/k/v/output_proj、mlpのlayer1/2、adaLNの各射影)が torch.int8 の重みと行ごとの float32 スケールになっている。640層分で、LLMAdapterと入出力層は量子化されてない。
ComfyUI v0.33.3はこれを Found quantization metadata version 1、Detected mixed precision quantization と出してロードは通り、bf16版の5572MBに対して2939MBをMPSに載せた。
そこからKSamplerの最初の行列積で NotImplementedError: The operator 'aten::_int_mm' is not currently implemented for the MPS device が出て止まってしまった。
止まる場所は comfy_kitchen/tensor/int8.py の _handle_int8_linear_tensorwise から backends/eager/quantization.py の fast_int8_mm が torch._int_mm を呼ぶところで、前の記事と同じ。comfy-kitchenは0.2.31に上がってるけど、backends/ にはcuda、eager、hip、tritonしかなくて、MPS専用のバックエンドは相変わらず無い。MPSではeagerの実装が使われるだけ。
前の記事で入れた逆量子化パッチ(MPSの時だけ重みを dequantize() してから普通の linear / mm / addmm に渡す3箇所の分岐)を0.2.31の同じ関数に当てたら動いた。
| 構成 | ロード量 | かかった時間(28ステップ、シード42) |
|---|---|---|
| bf16版 | 5572MB | 353.4秒 |
| int8_convrot版 + 逆量子化パッチ | 2939MB | 363.5秒 |
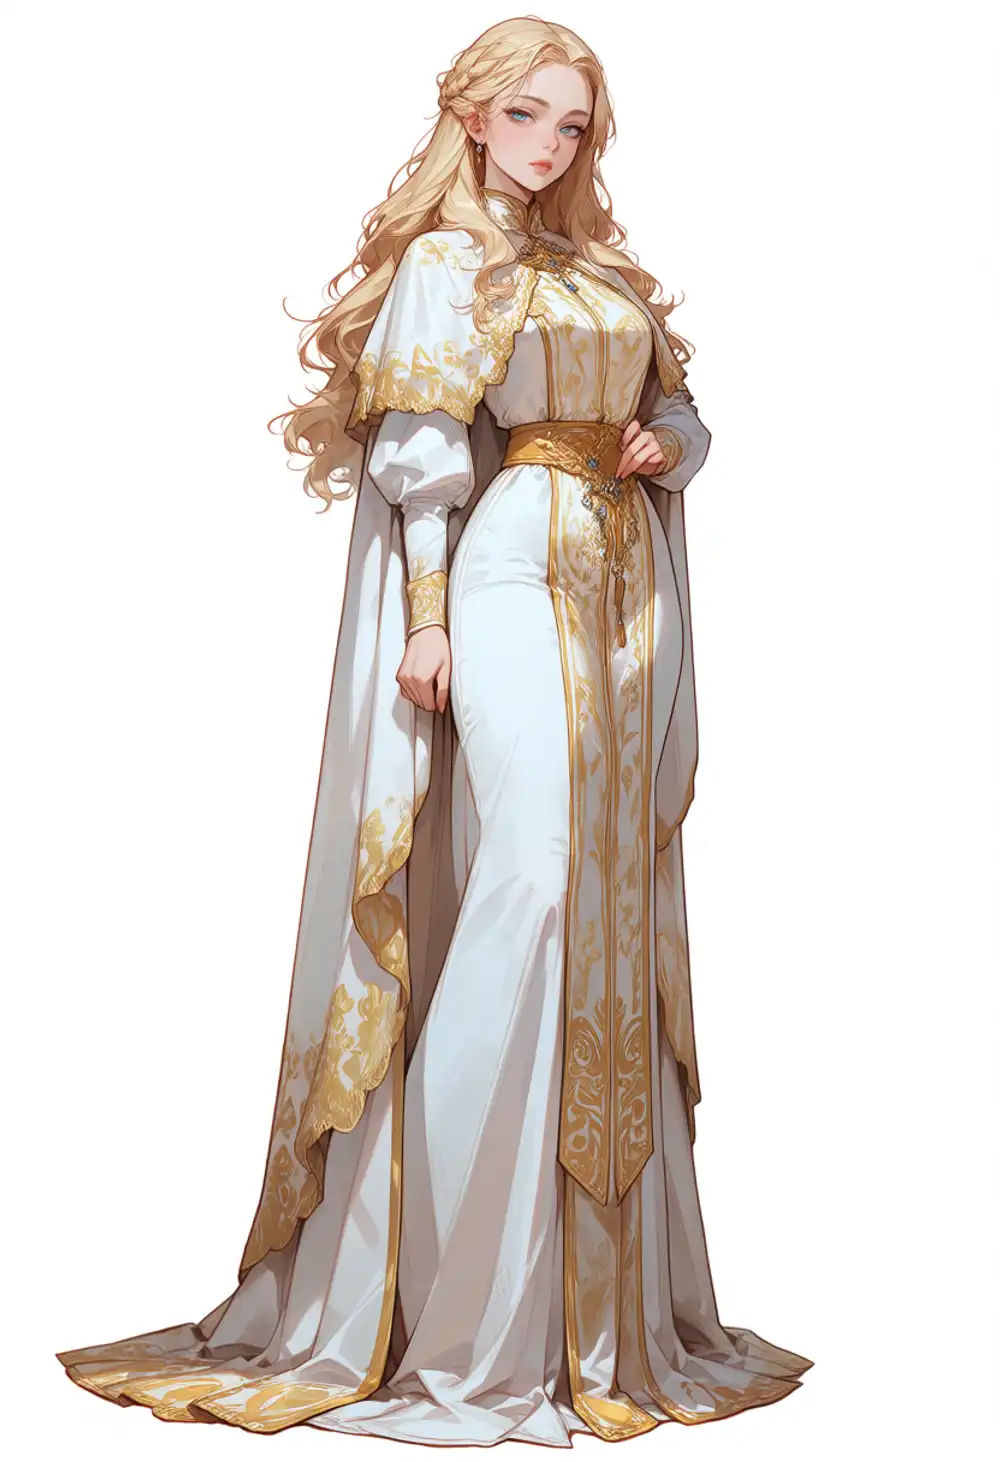
出力はbf16版とほぼ同じで、袖の膨らみと刺繍の位置がちょっと違うくらい。
時間は約3%遅くて、前の記事で逆量子化パッチ版が無量子化より遅かったのがまたそのまま出た。速くはならなくて、MPSに載る量が5572MBから2939MBに減るだけ。