Qwen4でMOSS-ImageのキャラLoRA用キャプションを見直してみた
 目次
前回のMOSS-ImageのキャラLoRAをEVO-X2のROCmで1024px学習するでは、ローカルのROCm環境でかなのLoRAを3000ステップまで回した。ただ、サイドポニーは出るものの、顔立ちや髪色、頭身が学習画像にあまり似なかった。
そこでAnima用から流用していた70枚の画像とキャプションをQwen4とCodexで見直して作り直し、RunPodのA40で5000ステップまで試してみることにした。
検証環境と前提
今回の作業では、画像の見直しと生成の比較をローカルPCで行い、5000ステップの本学習にRunPodのA40(48GB)を使った。MOSS-Imageには素の基盤モデル(Base)と指示に従いやすく調整した版(SFT)があり、学習にはBase、ローカルでの高速な比較生成にはSFTへ4回推論用の高速化LoRA(4ステップLoRA)を重ねて使っている。
| 環境・ツール | 役割 |
|---|---|
| ローカル作業環境 | Piに組み込んだQwen4で画像内容を読み取り、Codexで元の文と照合 |
| ローカル生成環境 | stable-diffusion.cpp(sd.cpp)にMOSS-Image SFT+4ステップLoRAを載せて比較生成 |
| RunPod A40(48GB) | ai-toolkit(コミット d6a18ad)でMOSS-Image Baseの1024px・5000ステップ学習と途中見本を生成 |
元データは元の58枚と後から足した12枚の計70枚で、キャプション(学習画像ごとの説明文)は前回の記事で作った自然文だけのものがv1、末尾にタグを足して試作した未学習のデータセットがv2(今回は単語数の集計比較だけに使う)となっている。元の画像やv1・v2は上書きせず、同じ70枚の画像を別のデータセットへコピーしてから作業を始めた。
自分の環境で試した感触では、サイドポニーはMOSS-Imageがいちばん安定して出せた。ただ、髪を解く指定は効きにくく、Animaのようにポジティブプロンプト(描く指示)から髪型を外してネガティブプロンプトへ入れるやり方はうまく通らなかった。髪型の説明がキャプションに残っていたことだけを失敗と決めず、顔立ちや基本の髪色を保つことと、プロンプトで髪型を変えられることは分けて考えて進めた。
元のキャプションの偏りとQwen4への画像送信
まずは70枚を対象に、元のAnima用キャプション、v1、v2にどんな単語が含まれているか枚数を数えた(同じ語が1枚の中で何回出ても1枚として数えている)。
| 語句 | 元のAnima用 | v1 | v2 |
|---|---|---|---|
young | 58 | 0 | 0 |
slender | 10 | 0 | 0 |
slim | 10 | 0 | 0 |
flat chest | 10 | 0 | 0 |
brown hair | 10 | 0 | 0 |
brown eyes | 10 | 0 | 0 |
side ponytail | 59 | 49 | 59 |
ahoge | 58 | 0 | 58 |
blue scrunchie | 58 | 46 | 58 |
young や体型の語はv1・v2の時点ですでに外れていたが、元の58枚と追加12枚では記述の詳しさにも差があった。たとえば kana_add01 と kana_add02 は、絵の中では黒いタイツを履いているのに、元のキャプションにもv1にも書かれていなかった。
続いてローカルのPiに登録されていた qwen-invite プロバイダーの「Qwen4 (Invite)」(設定上のモデルID qwen-latest-series-invite-1102、公開版の正式モデルIDと同じかは未確認)へ画像を送って内容を読み取り始めた。最初の1枚をPiからそのまま送ると Connection error.: read ECONNRESET で落ちたため、Piに登録されていた接続先とモデルIDを使ってPythonのHTTPリクエストから直接送るように切り替えると応答が返ってきた。
ところが、元のPNGをそのまま送った kana_add03 では白背景を黒と答えてしまい、背景色だけに絞って聞き直しても「黒、確信度1.0」と返ってきた。画素を調べると四隅は白で、透明度を表すアルファ値も画像全体で255(不透明)だったため、透過が原因ではなかった。同じ画像をRGBのJPEG(元の縦横サイズのまま画質95)に変換して送り直すと白と返ったため、以後はAPI送信用にRGB JPEGを作って試すことにした。学習用の元PNGは変更せずそのまま残し、読み取り時の入力画像ハッシュ(識別用の要約値)、プロンプト、モデルID、回答ID、日時、使用トークンを元データとは別に保存している。
70枚を見直してv3を作る
Qwen4には元のキャプションやキャラクター設定を入力せず、構図、ポーズ、表情、服、背景、髪型、髪色、目の色、見えにくい部分を分けてJSONで返させた。いきなり全70枚を流さず、まず追加12枚と構図がかぶらないよう選んだ8枚の計20枚をJPEGで試し、背景の判定などが通りそうだったため残りの50枚も送った(途中でAPIの回数制限HTTP 429が出た分だけ再送して70枚をそろえた)。
そのあとCodexが70枚の一覧画像と判断が難しい画像の原寸表示を確認し、Qwen4の読み取り候補と、元のタグ・自然文・v1・v2を比べた。
JPEGに変えても kana_0018 と kana_0031 は白背景を黒と答えたため、なぜ再発したかまでは特定できていないが、背景色は元画像の画素を確かめて直している。kana_0059 の背景もQwen4の「薄い青」から実画像に合わせて青緑(teal)へ修正した。また、髪型や背景の認識が実際と食い違った kana_0016、0018、0035、0026 は問題の項目だけ聞き直したが、再回答でも白背景を黒としたり見えている青い髪飾りを「不明」と返したりしたため、回答はそのまま正解にせず、目で確かめた内容だけを採っている。
学習用キャプションへ残す要素を決めた
| 情報 | 読み取りJSON | v3のキャプション |
|---|---|---|
| トリガー(キャラを呼び出す語) | 外見の推定には使わない | 全文を Anime-style illustration of kanachan で始める |
| 構図・動き・表情・服 | 見えるものを記録 | 見えるものだけ書く。背中側で隠れるネクタイなどは足さない |
| 背景 | Qwen4の候補を保存し、画像と照合 | 確認した色を1文で書く |
| 髪と目の色 | 見える場合だけ候補を記録 | 今回は毎回書かない。名前だけで色が出るかは追加学習後に確かめる |
| 顔の形・年齢・体型 | 不明な部分を補わない | young、slender、slim、胸の大きさ、数値の年齢などは書かない |
| 髪型と髪飾り | 画像上の位置と見え方を記録 | サイドポニー・シュシュ・アホ毛の見えている状態を書く。隠れた髪飾りは断定しない |
| 品質・スコア・レーティング(安全区分)のタグ | 元の文は比較用に保存 | masterpiece、best quality、score_7、safe などは入れない |
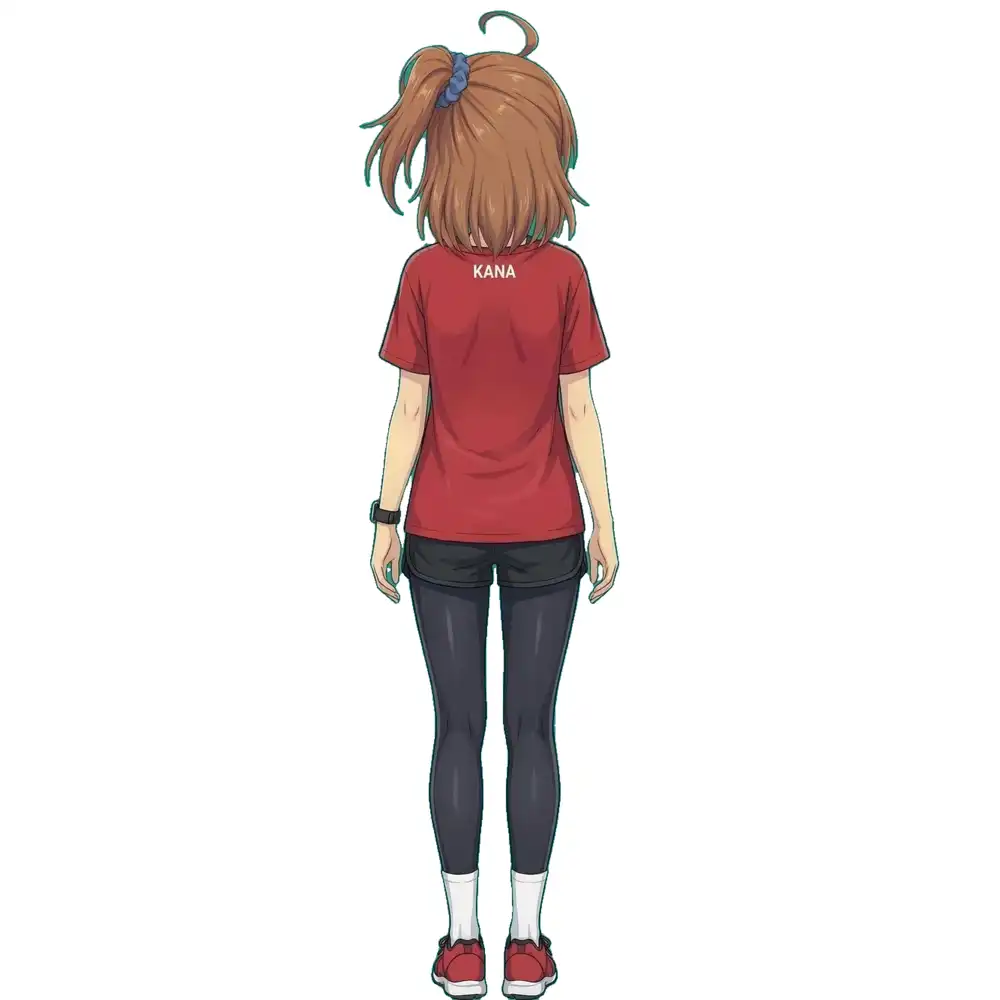
| 画像内の文字 | 実際の文字を照合 | 読み取れた文字はそのまま書く。背中の白い文字は KANA |
集めた70枚はすべて髪を結んだ絵で、髪を解いた状態の画像との比較はデータ側にないが、名前だけでサイドポニーを固定するやり方にせず、画像ごとの状態として髪型を書く方針にした。
画像を確認して直した例
下の3枚はいずれも学習用の元画像で、調整後の出力ではない。
| 画像 | 元の文やQwen4の候補 | v3での修正内容 |
|---|---|---|
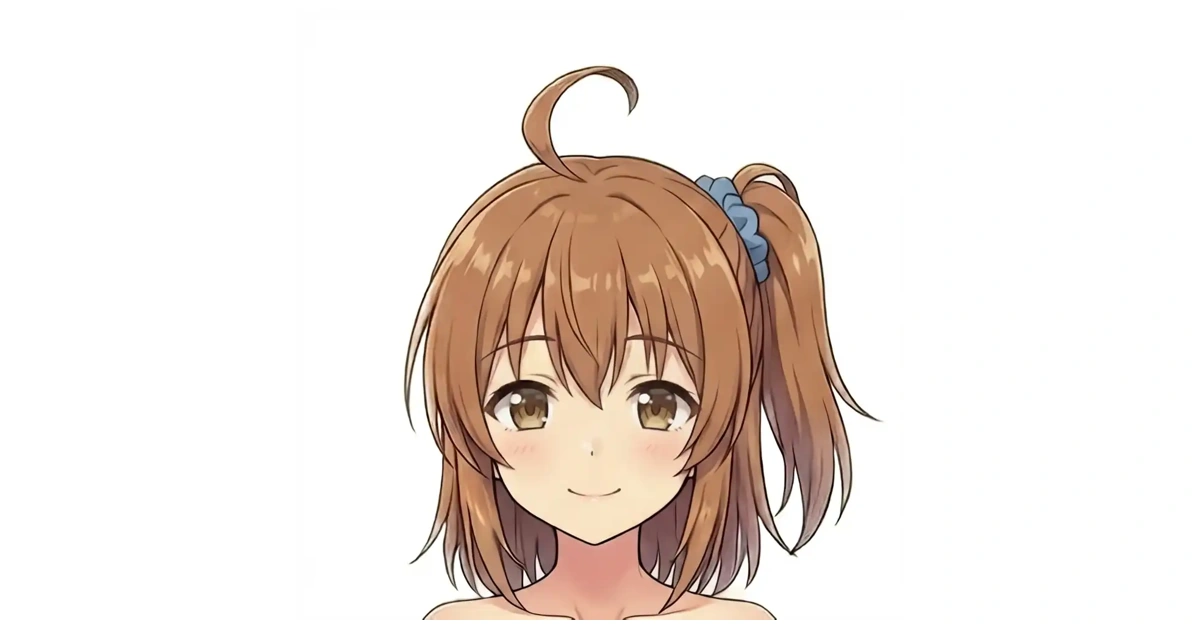
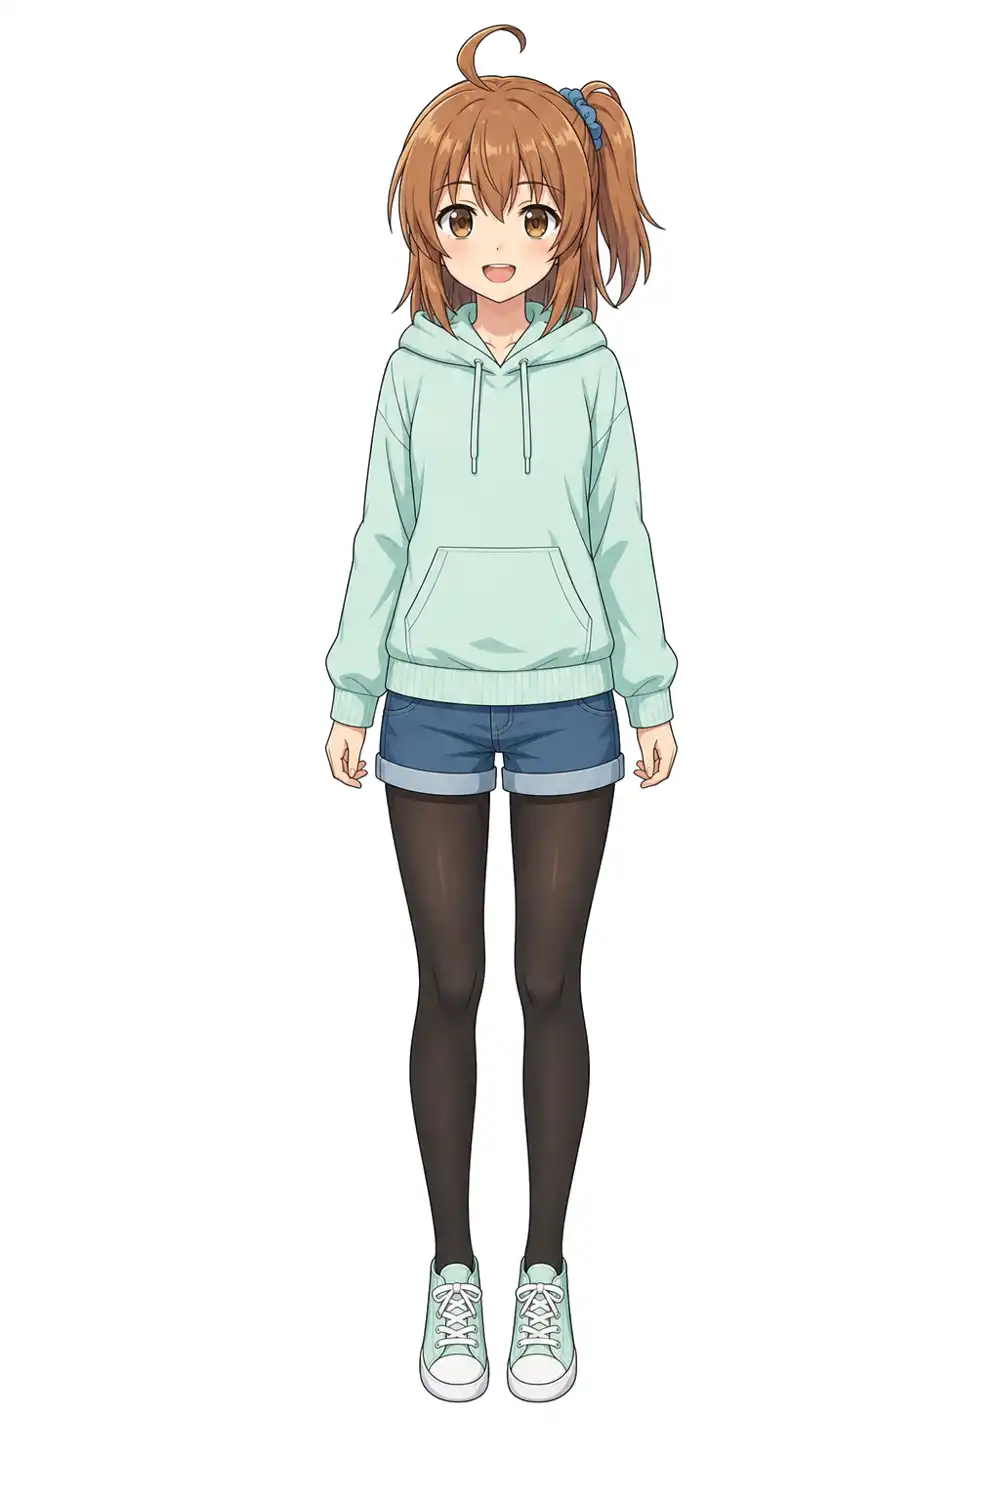
kana_add01 | 元の文とv1には黒タイツがなく、髪型の記述もなかった | 黒タイツ、見えているサイドポニー、青いシュシュ、アホ毛を追加した |
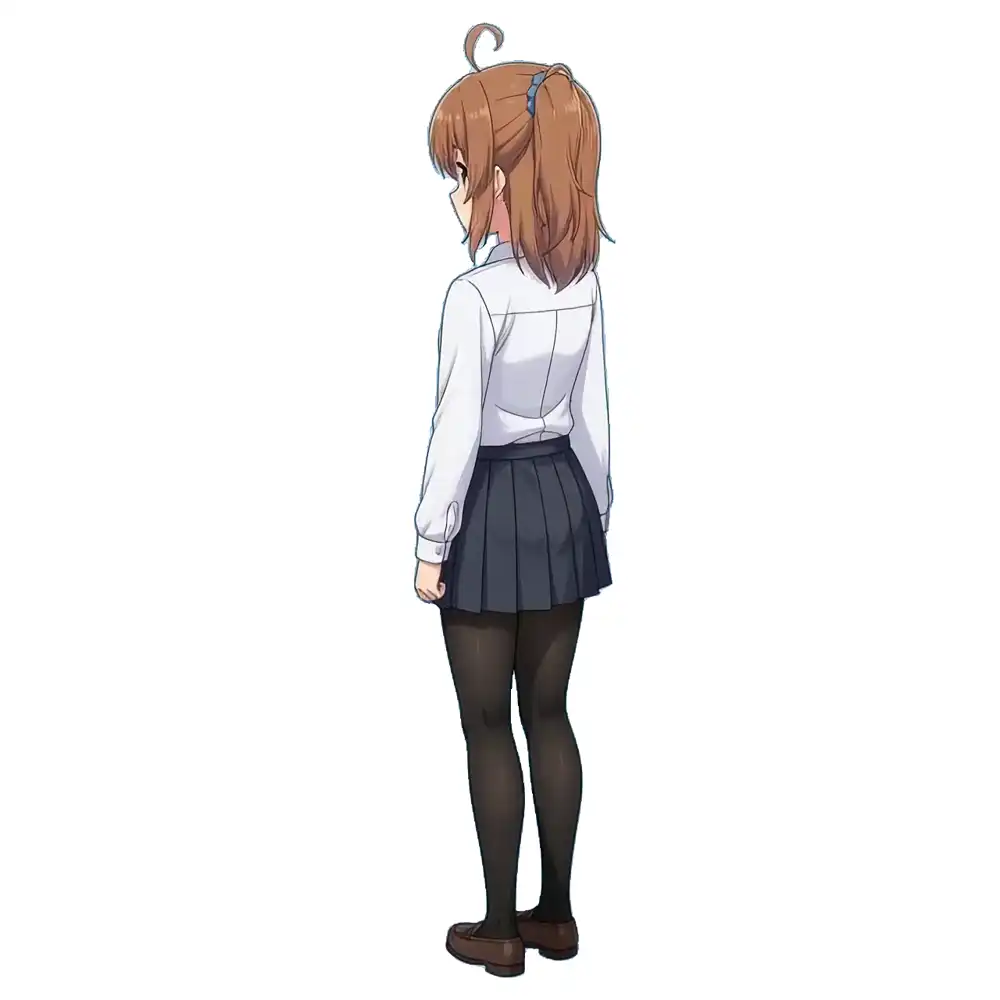
kana_0016 | Qwen4はハーフアップと表現し、聞き直しても髪飾りを不明、背景を黒と答えた | 斜め後ろから見た構図で画像右に見える結び目と青いシュシュを書き、白背景へ直した。見えないネクタイや表情は書かない |
kana_0043 | Qwen4の文は「背中に白い文字がある」という記述だった | 画像を拡大して KANA と書き写した。後ろ姿なので、正面の顔や表情は補わない |
kana_add01。
kana_0016。
kana_0043。
kana_add01 のv1はこんな感じ。
A full-body front view of a girl named kanachan standing and facing the viewer directly, wearing a mint green hoodie, denim shorts, and sneakers. She has a cheerful grin. Anime-style illustration with a plain white background.v3ではこう直した。
Anime-style illustration of kanachan standing full-body facing forward, arms relaxed at sides with fingers gently curled, smiling cheerfully with open mouth, wearing a mint green hooded sweatshirt with front pocket and drawstrings, cuffed blue denim shorts, black tights, and matching mint green sneakers with white laces. The background is plain white. A side ponytail on the image right is secured with a blue scrunchie. A curled ahoge rises from the crown.なお、横顔などで隠れ方が違う5枚については、髪飾りが隠れることや一部だけ見えている状態を個別に書き分けている。
できあがったv3はPNG 70枚とTXT 70個になり、語数は最短39語、平均64.5語、最長110語になった。コピー先のPNGは元のPNGとSHA-256(一致確認用のハッシュ値)を比べて全70枚で一致を確かめており、リサイズやJPEG変換はしていない。
v1とv3を100ステップずつ追加して比べた
v3で本学習に入る前に、まずv1とv3でどれくらい違いが出るか短く比べるため、ローカルのROCm環境と ai-toolkit で代表8枚・512px・12ステップの動作確認から始めた。1回目は保存前に終了コード143で止まったため端末から切り離して動かし直したところ、約94.5秒で完走し、保存された504テンソル(学習重みの数値配列)にも異常値はなかった。
続いて前回の記事で作ったv1・3000ステップのLoRAを出発点にして、v1とv3それぞれで同じ70枚・512px・100ステップずつ追加学習してみた。両条件とも重みだけをロードし、オプティマイザー(重み更新の状態管理機構)は初期化している。設定はランク16、アルファ16、最適化手法AdamW、学習率1e-4、バッチサイズ1、学習シード42、ドロップアウト0(学習時に要素を抜く割合)でそろえ、キャッシュした画像ラテント(潜在表現)のテンソルデータも全70枚で同じものを使った。
| 条件 | 追加ステップ | 読み込み・キャッシュ・保存込みの時間 |
|---|---|---|
| 追加前 | 0 | 比較の基準 |
| v1 | 100 | 612.86秒 |
| v3 | 100 | 544.59秒 |
どちらも正常に終わり、504テンソルが追加前から更新されていた。なおv1側を先に実行しているため、この時間差だけでキャプション形式による速度差とは言い切れない。
出力の比較はローカルの sd.cpp で、MOSS-Image SFTに4ステップLoRAを重ねて行った。768×768、Euler(サンプラー)4ステップ、CFG(指示反映度)1、シグマ(ノイズ除去強度の推移値)1, 0.910, 0.717, 0.024, 0 で、キャラLoRAと4ステップLoRAの強度はともに1、ネガティブプロンプトは空にしている。シードは42と43の2つを試した。
共通のプロンプトはこんな感じ。
Anime-style illustration of kanachan. A front-facing head-and-shoulders portrait, looking directly at the viewer with a gentle closed-mouth smile, wearing a plain white T-shirt. Plain light grey background.| 追加する指定 | シード42・43の出力の違い |
|---|---|
| 名前だけ。共通文への追加なし | 追加前は髪下ろし。v1・v3の追加後は結んだ髪が出た。青いシュシュはv1側の42で明確に出たが、v3側では確認できなかった |
Her hair is tied into a side ponytail on the right side of the image with a blue scrunchie. A curled ahoge rises from the crown. | 3条件とも青いシュシュ付きサイドポニーとアホ毛が出た |
Her hair hangs loose, worn down and fully untied, falling freely on both sides of her head. A curled ahoge rises from the crown. | 3条件とも髪を下ろせたが、胸元まで伸びていて元の髪の長さより長くなった |
下の比較はすべて左から追加前、v1で100ステップ追加、v3で100ステップ追加で、各指定ごとにシード42、43の順に載せた。
名前だけ、シード42。
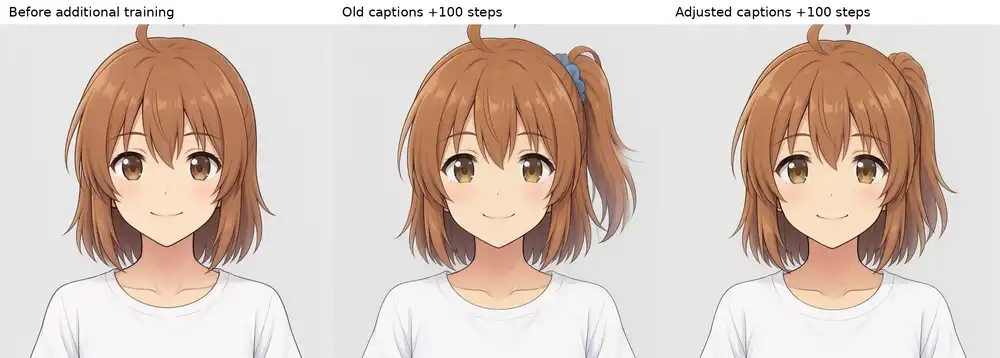
名前だけ、シード43。
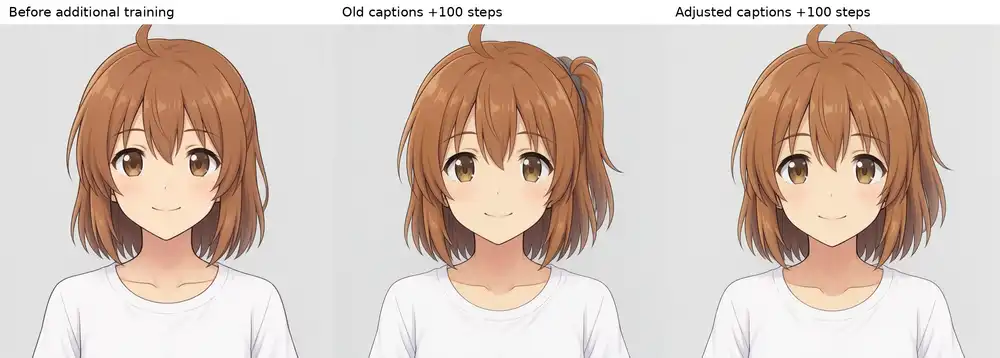
サイドポニー指定、シード42。
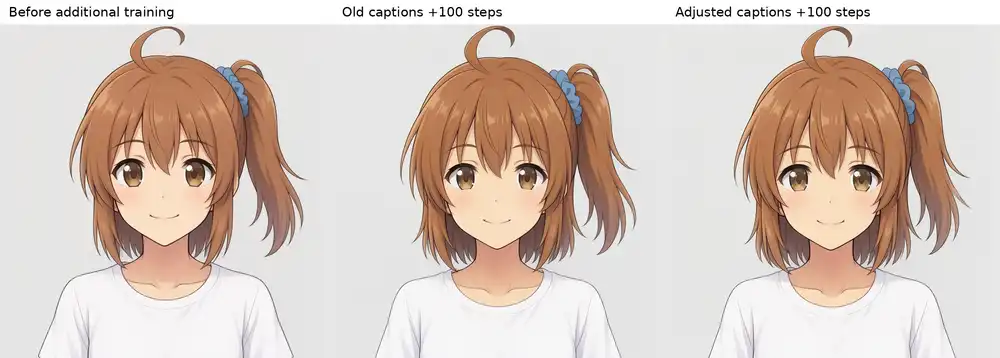
サイドポニー指定、シード43。
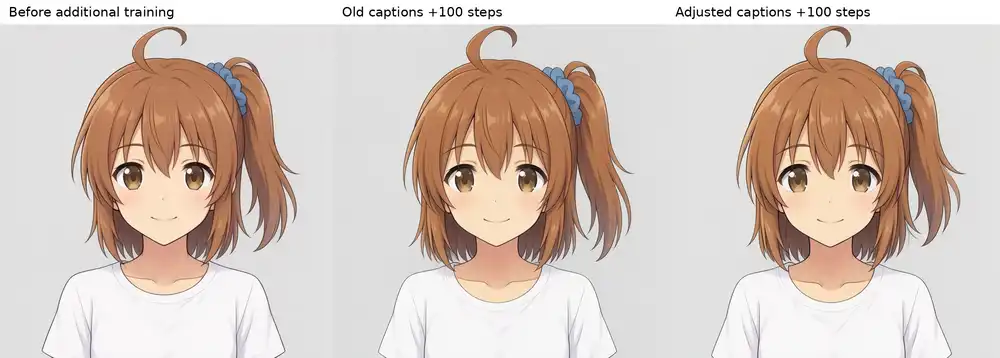
髪下ろし指定、シード42。
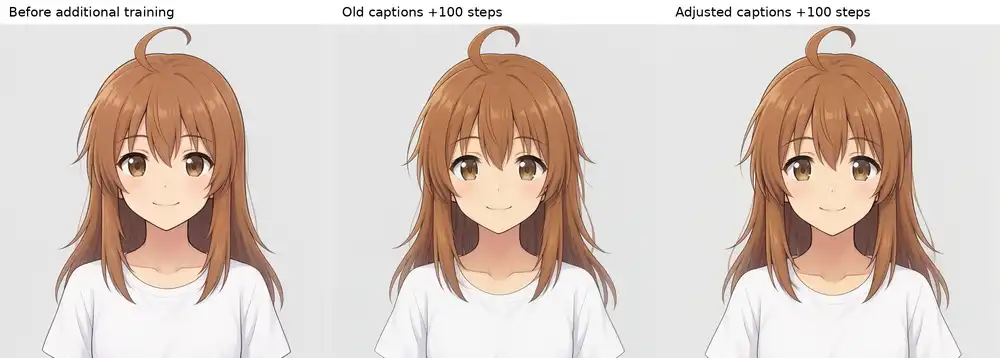
髪下ろし指定、シード43。
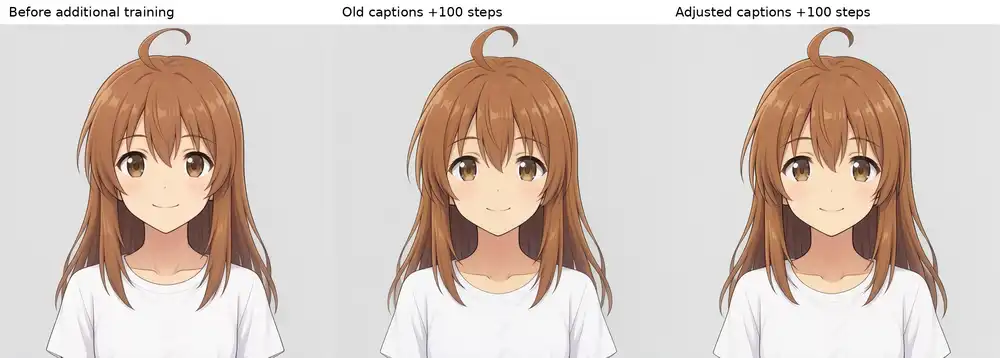
ここで3条件とも髪を下ろせたのがLoRAの効果なのかを確かめるため、髪下ろしのプロンプトをキャラLoRAだけ外した同じ条件(シード42・43)で出してみたところ、こちらも両方とも髪を下ろせており、髪を下ろせること自体はLoRAの効果ではなかった。
追加前と比べるとキャラに似て余計な物も減ったものの、v1を100ステップ足した側にも似た変化が出ていて、すでにv1で3000ステップ学習済みの重みに100ステップ足すだけではv3のほうがはっきり良いとまでは言えなかった。そこでBaseからv3単体で新しく学習し直してみることにした。
A40で5000ステップまで学習した
48GBのGPUと学習環境
ローカルのROCm環境で1024pxの学習を何パターンも回すのは時間がかかるので、クラウドGPUのRunPodへ移すことにした。使いたいのはこれまでと同じ ai-toolkit(コミット d6a18ad72da9abca3ffb67ea8e42c25764eee61a)の量子化なし設定(low_vram: false)だ。
参考として sd-scriptsのMOSS-Image学習ガイド には、1024px、バッチサイズ1、ランク16、AdamW、gradient checkpointing(勾配再計算の節約設定)、潜在データおよびテキスト埋め込みキャッシュありのbf16(16ビット浮動小数点)構成で、RTX PRO 6000 Blackwell上で起動時15.3GB、学習中13.2GB、CPU RAM 17.2GBという実測値が載っている。文書には24GB向けの構成もあるが、学習ツールが違うので今の ai-toolkit の設定と同じにはならない。
ai-toolkitのモデル配置処理とQwenの読込対象、それに手元にある重みのヘッダーから計算すると、テキスト専用部分とDiT(拡散処理の本体)の単純な合計だけで約26.0GBになる。実際にはこれに加えてVAE(画像の圧縮復元部)や処理用のメモリも別に要るため24GBには足りず、32GBでも起動・学習・生成のピークを確かめる手間がかかる。48GB枠でL40Sに空きがなかったことから、A40 48GBを選んだ。
起動画面の構成はホストRAM 50GB、9 vCPU(仮想CPU)、ディスク合計200GBで、料金はGPUが $0.59/時、ディスク込みの表示で $0.62/時だった(RunPodの料金ページでもA40は $0.59/時)。Podの環境はPyTorch 2.8.0+cu129、CUDAランタイム12.9で、ドライバー595.91.07はCUDA 13.2対応だった。
データと5000ステップまでの実行記録
v3のデータセット、比較用のv1、読み取り記録、基準LoRA、固定コミットの ai-toolkit、実行スクリプトを約441MiB(1024進のメガバイト)のアーカイブにまとめてPodへ移し、DiT・テキストエンコーダー・VAEのモデル3本(合計29,807,179,428バイト)はPod側で取得してSHA-256を照合した。
| 学習項目 | 設定 |
|---|---|
| 出発点 | MOSS-Image Base。既存LoRAを引き継がず新規に開始 |
| データ | v3の70枚、1024pxの縦横比バケット(縦横比ごとの分類枠) |
| LoRA | ランク16、アルファ16、bf16、量子化なし |
| 学習 | AdamW、学習率1e-4、バッチサイズ1、学習シード42、ドロップアウト0 |
| メモリ | gradient checkpointing、潜在データとテキスト埋め込みをキャッシュ、テキストエンコーダーは更新せず固定して解放 |
| 保存 | 100ステップごと。通常の途中保存は最大12個 |
| 途中見本 | 開始時と250ステップごとに名前だけ・サイドポニー・髪下ろし(後の2つはアホ毛の文も共通で含む)の3枚 |
| 見本の生成 | Baseモデル、768px、50ステップ、CFG 3、シード42固定 |
本学習の前に回した12ステップのテストは202.23秒で正常終了し、学習ループ自体は約46秒(約3.85秒/ステップ)、1秒間隔の記録でVRAM最大25,549MiB、CPU最大メモリ(RSS)は約26.4GiB(27,702,648KiB)だった。なお見本生成を切って測った数値なので、生成時のピークは入っていない。
本学習は2000ステップで一度見本を確かめてから(この区間のVRAM最大は25,509MiB)、1000ステップずつ追加して5000まで回した(追加時は重みとオプティマイザーを引き継いでいる)。
| 到達ステップ | この区間の学習 | 読み込み・途中見本・保存込みの実行時間 |
|---|---|---|
| 2000 | Baseから2000 | 9037.52秒(約2時間30分38秒) |
| 3000 | 2000から1000追加 | 4601.36秒(約1時間16分41秒) |
| 4000 | 3000から1000追加 | 4617.40秒(約1時間16分57秒) |
| 5000 | 4000から1000追加 | 4513.92秒(約1時間15分14秒) |
通常見本は1枚約41秒で3枚ごとに約2分かかっており、上の表には次節の構図別テストの生成時間は入っていない。また、100ステップごとの通常保存は最大12個までしか残らないうえ、区切りごとに保存する最終LoRAがすべて同じ kana_runpod_qwen4.safetensors 名で上書きされるようになっていた。2000と3000は事前に退避してあった分を戻し、4000・5000とともに lora-milestones/ へステップ数付きで保存し直している(間の250刻みである3750や4250などの重みファイルはない)。
途中見本の正面と全身・反対側を比べた
2000ステップまでの正面見本では、髪型指定を入れると顔や髪色がそろう一方、名前だけでは違いが出た。ただ、サイドポニーと髪下ろしの両方にアホ毛の文を入れていたため、髪型の語だけでそう変わったのかを確かめる目的で、2000の重み・Base 50ステップの条件を固定し、4種類の指定をシード42・43で8枚出してみた。
下の画像は左から「名前だけ」「アホ毛だけ」「サイドポニーとシュシュだけ」「髪下ろしだけ」で、上段がシード42、下段がシード43。
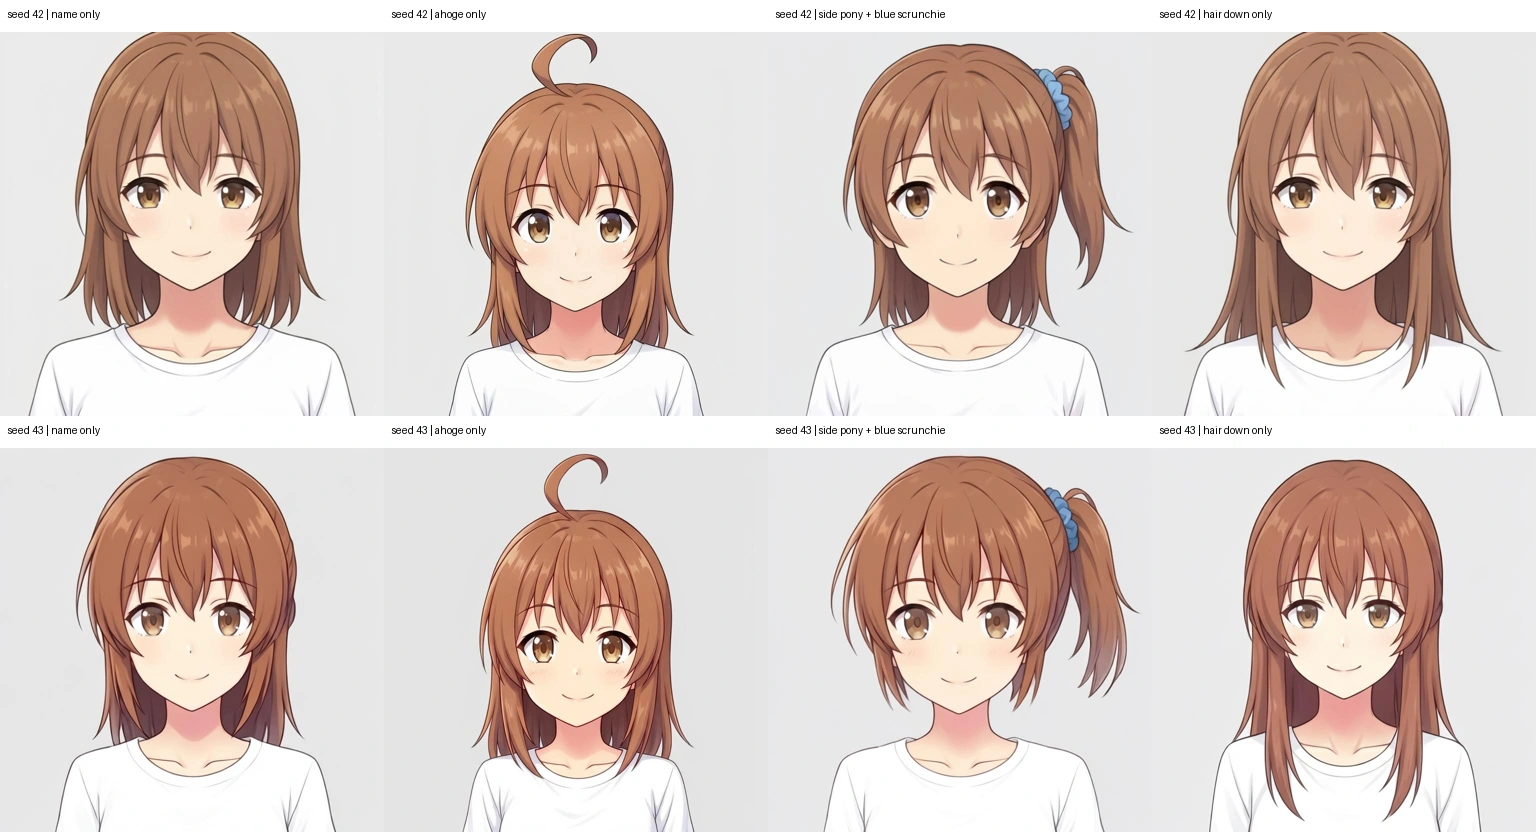
アホ毛だけでも顔の輪郭や目、頭の位置が変わっていて、髪型やアホ毛の指定が髪以外の部分にも影響している。
2000の時点で名前だけでは似ず、正面見本だけでは全身のバランスや反対側の向きが分からないため、3000・4000・5000の段階でもBase・50ステップ・768×1024・CFG 3の条件で5構図をシード42・43で確認した。服は白いTシャツ(全身では紺のスカートと白いスニーカー)、髪型はサイドポニー・青いシュシュ・巻いたアホ毛を指定している。
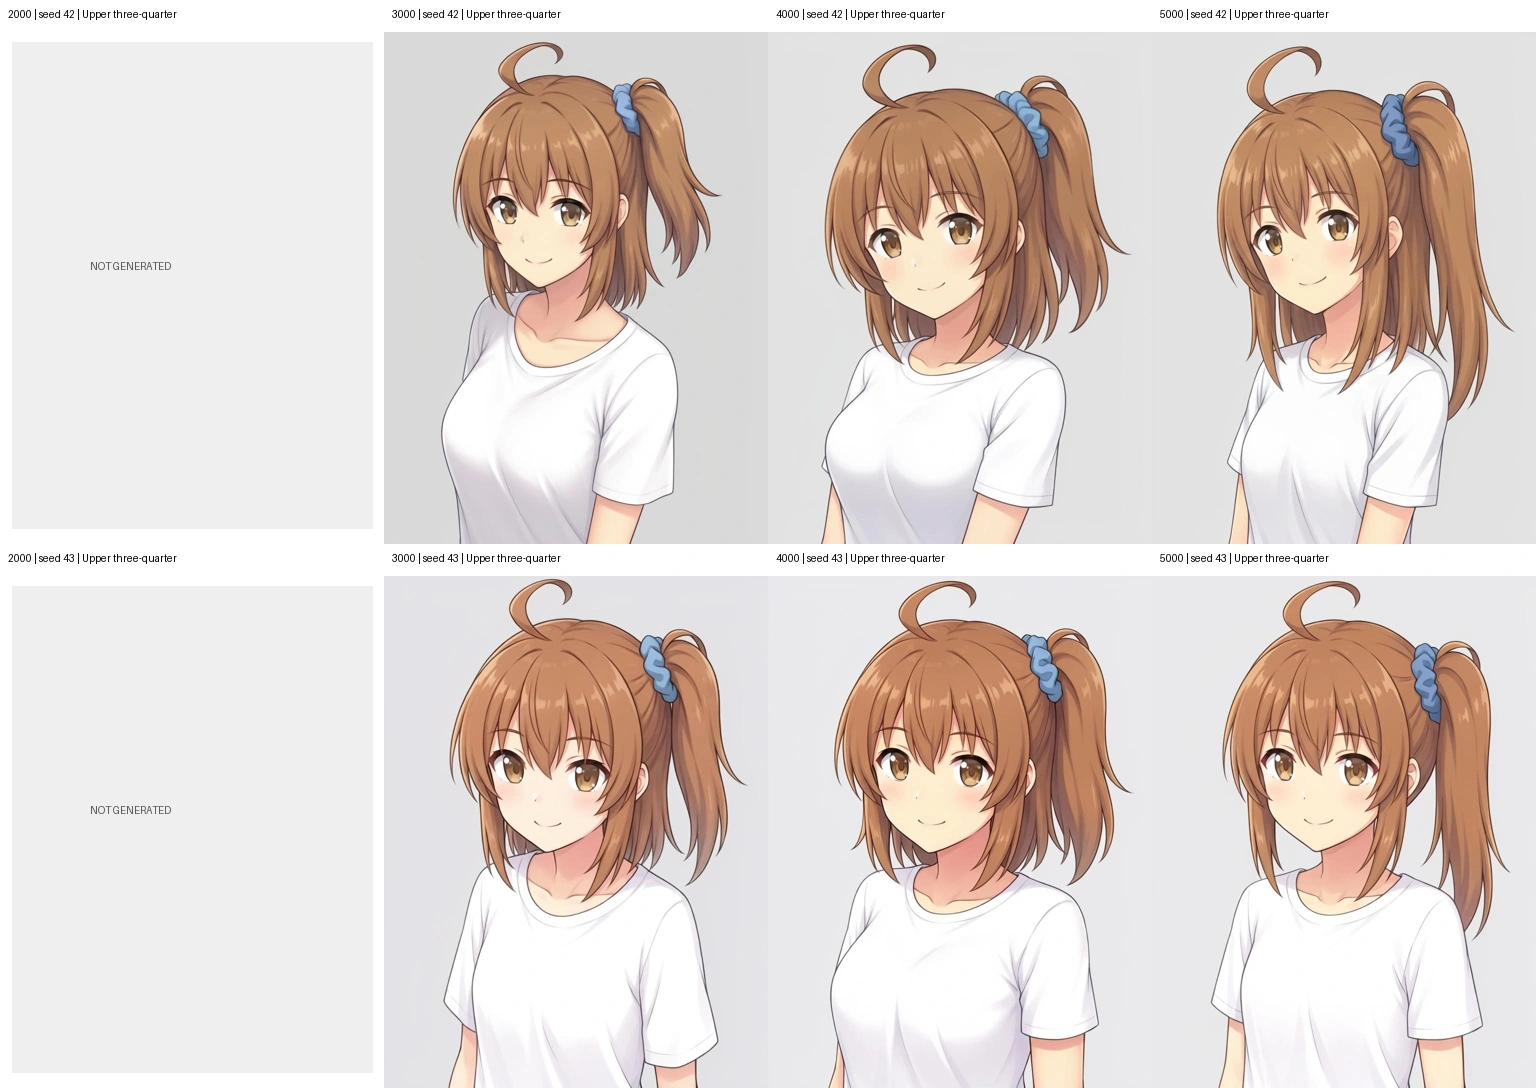
段階別の出力は構図別の段階比較ページにまとめた(斜め・反対側の2000は未生成、3000・4000・5000は各2シードがある)。
上半身斜めは左から2000(未生成)、3000・4000・5000で、上段がシード42、下段がシード43。
全身の頭身が変わっているように見えたので、2000の全身正面も同じ文・シードで2枚追加した。下は人物を囲む四角枠(外接枠)の高さをそろえて左から2000・3000・4000・5000、上段シード42、下段シード43で並べた比較で、アホ毛と靴も含むため頭身の正確な計測値とは異なる。
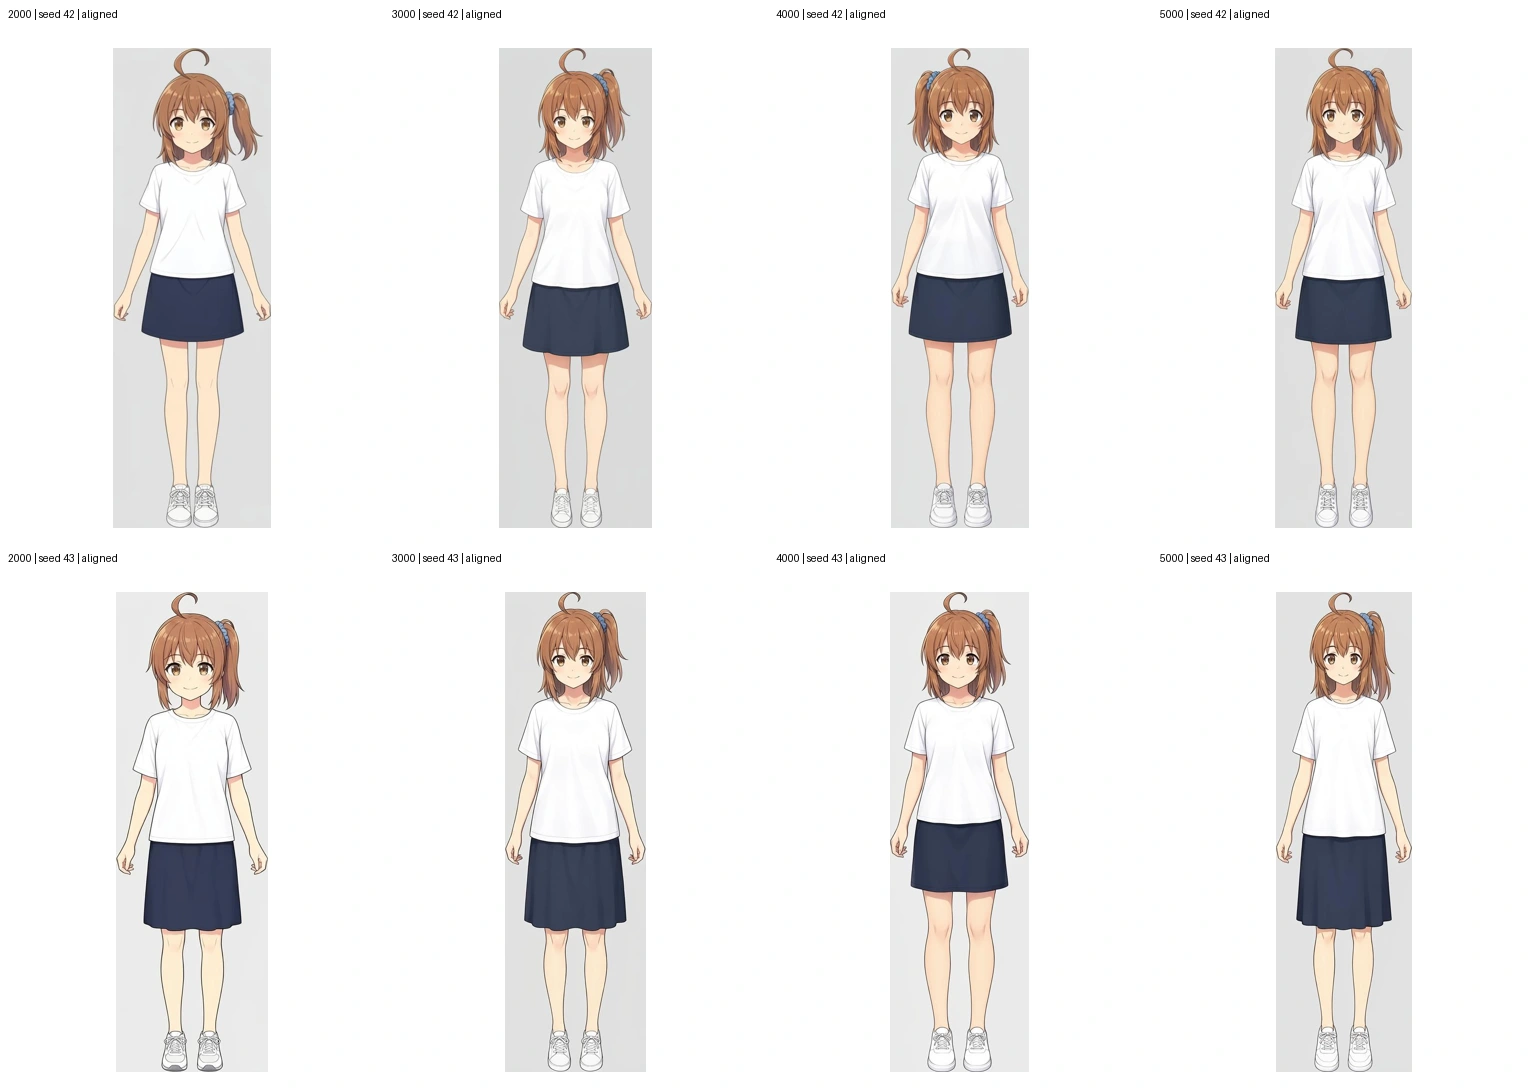
5構図それぞれの結果は下の表のとおり。
| 構図 | 指定 | 確認すること | 結果の傾向 |
|---|---|---|---|
| 全身正面 | 頭から靴まで、正面 | 顔、頭身、髪型 | 4000〜5000で頭が小さく細長く見える回がある |
| 全身斜め | シュシュ側から45度 | 全身と結び目の位置 | 正面寄りになりやすい |
| 上半身斜め | シュシュ側から45度 | 顔と髪型の位置関係 | 3000〜5000で安定して出力される |
| 全身・反対側 | カメラはシュシュと反対、結んだ側は奥 | 結び目が手前へ移らないか | 反対側を指定しても結び目が見える側に出た |
| 上半身・反対側 | 同じ反対側の指定 | 隠れるはずの結び目が出ないか | こちらも結び目が見える側に出た |
後半は頭が相対的に小さく、体が細長く見える出力が出たうえ、反対側を指定しても結び目が手前へ見えてしまい、全身が良くなっているとも言えず6000までは進めなかった。
ローカルで3500〜4000を細かく比べた
構図別比較では一度4000を候補にしたものの、3000は少し甘い出来で、5000は髪型が安定しなかった。そこで追加学習はせず、保存済みの重みを使ってローカルで細かいステップを比べ直してみることにした。
ここからは生成環境を sd.cpp(MOSS-Image SFT+4ステップLoRA、768px、Euler 4ステップ、CFG 1、シグマ 1, 0.910, 0.717, 0.024, 0、両LoRA強度1)に切り替え、テキストエンコーダーは Qwen3.5-9B Q8_0(8bit量子化)、VAEはFlux2を使った。RunPodのBase・50ステップとは条件が違う。
| 構図 | シード |
|---|---|
| 公園を歩く全身斜め | 173 |
| ベンチに座る膝上斜め | 3187 |
| 低い視点からの全身 | 9124 |
| 反対側からの振り返り | 20261 |
| 草の上に寝そべり、真上から見る髪下ろし | 86421 |
まず3500・4000・4500の3モデルで同じ5構図・シードを各5枚、計15枚(483.65秒、平均32.24秒/枚)生成し、同じ行が同じプロンプトとシードになるよう3500・4000・4500の比較ページへ並べた。並べて比べると3500のほうが頭身が低く、4000、4500はさらに高く見えたので、4500は外して3500寄りへ絞り、保存してあった3600・3700・3800・3900の重みでも同じ5組を20枚(644.94秒、平均32.25秒/枚)出した。3600〜3900の比較ページでは、前の3500と4000も再生成せず両端へ置き、合計30枚で比べられるようにしてある。
下の画像は上から表の5構図の順で、左から3500・3600・3700・3800・3900・4000の100ステップ刻みになっている。
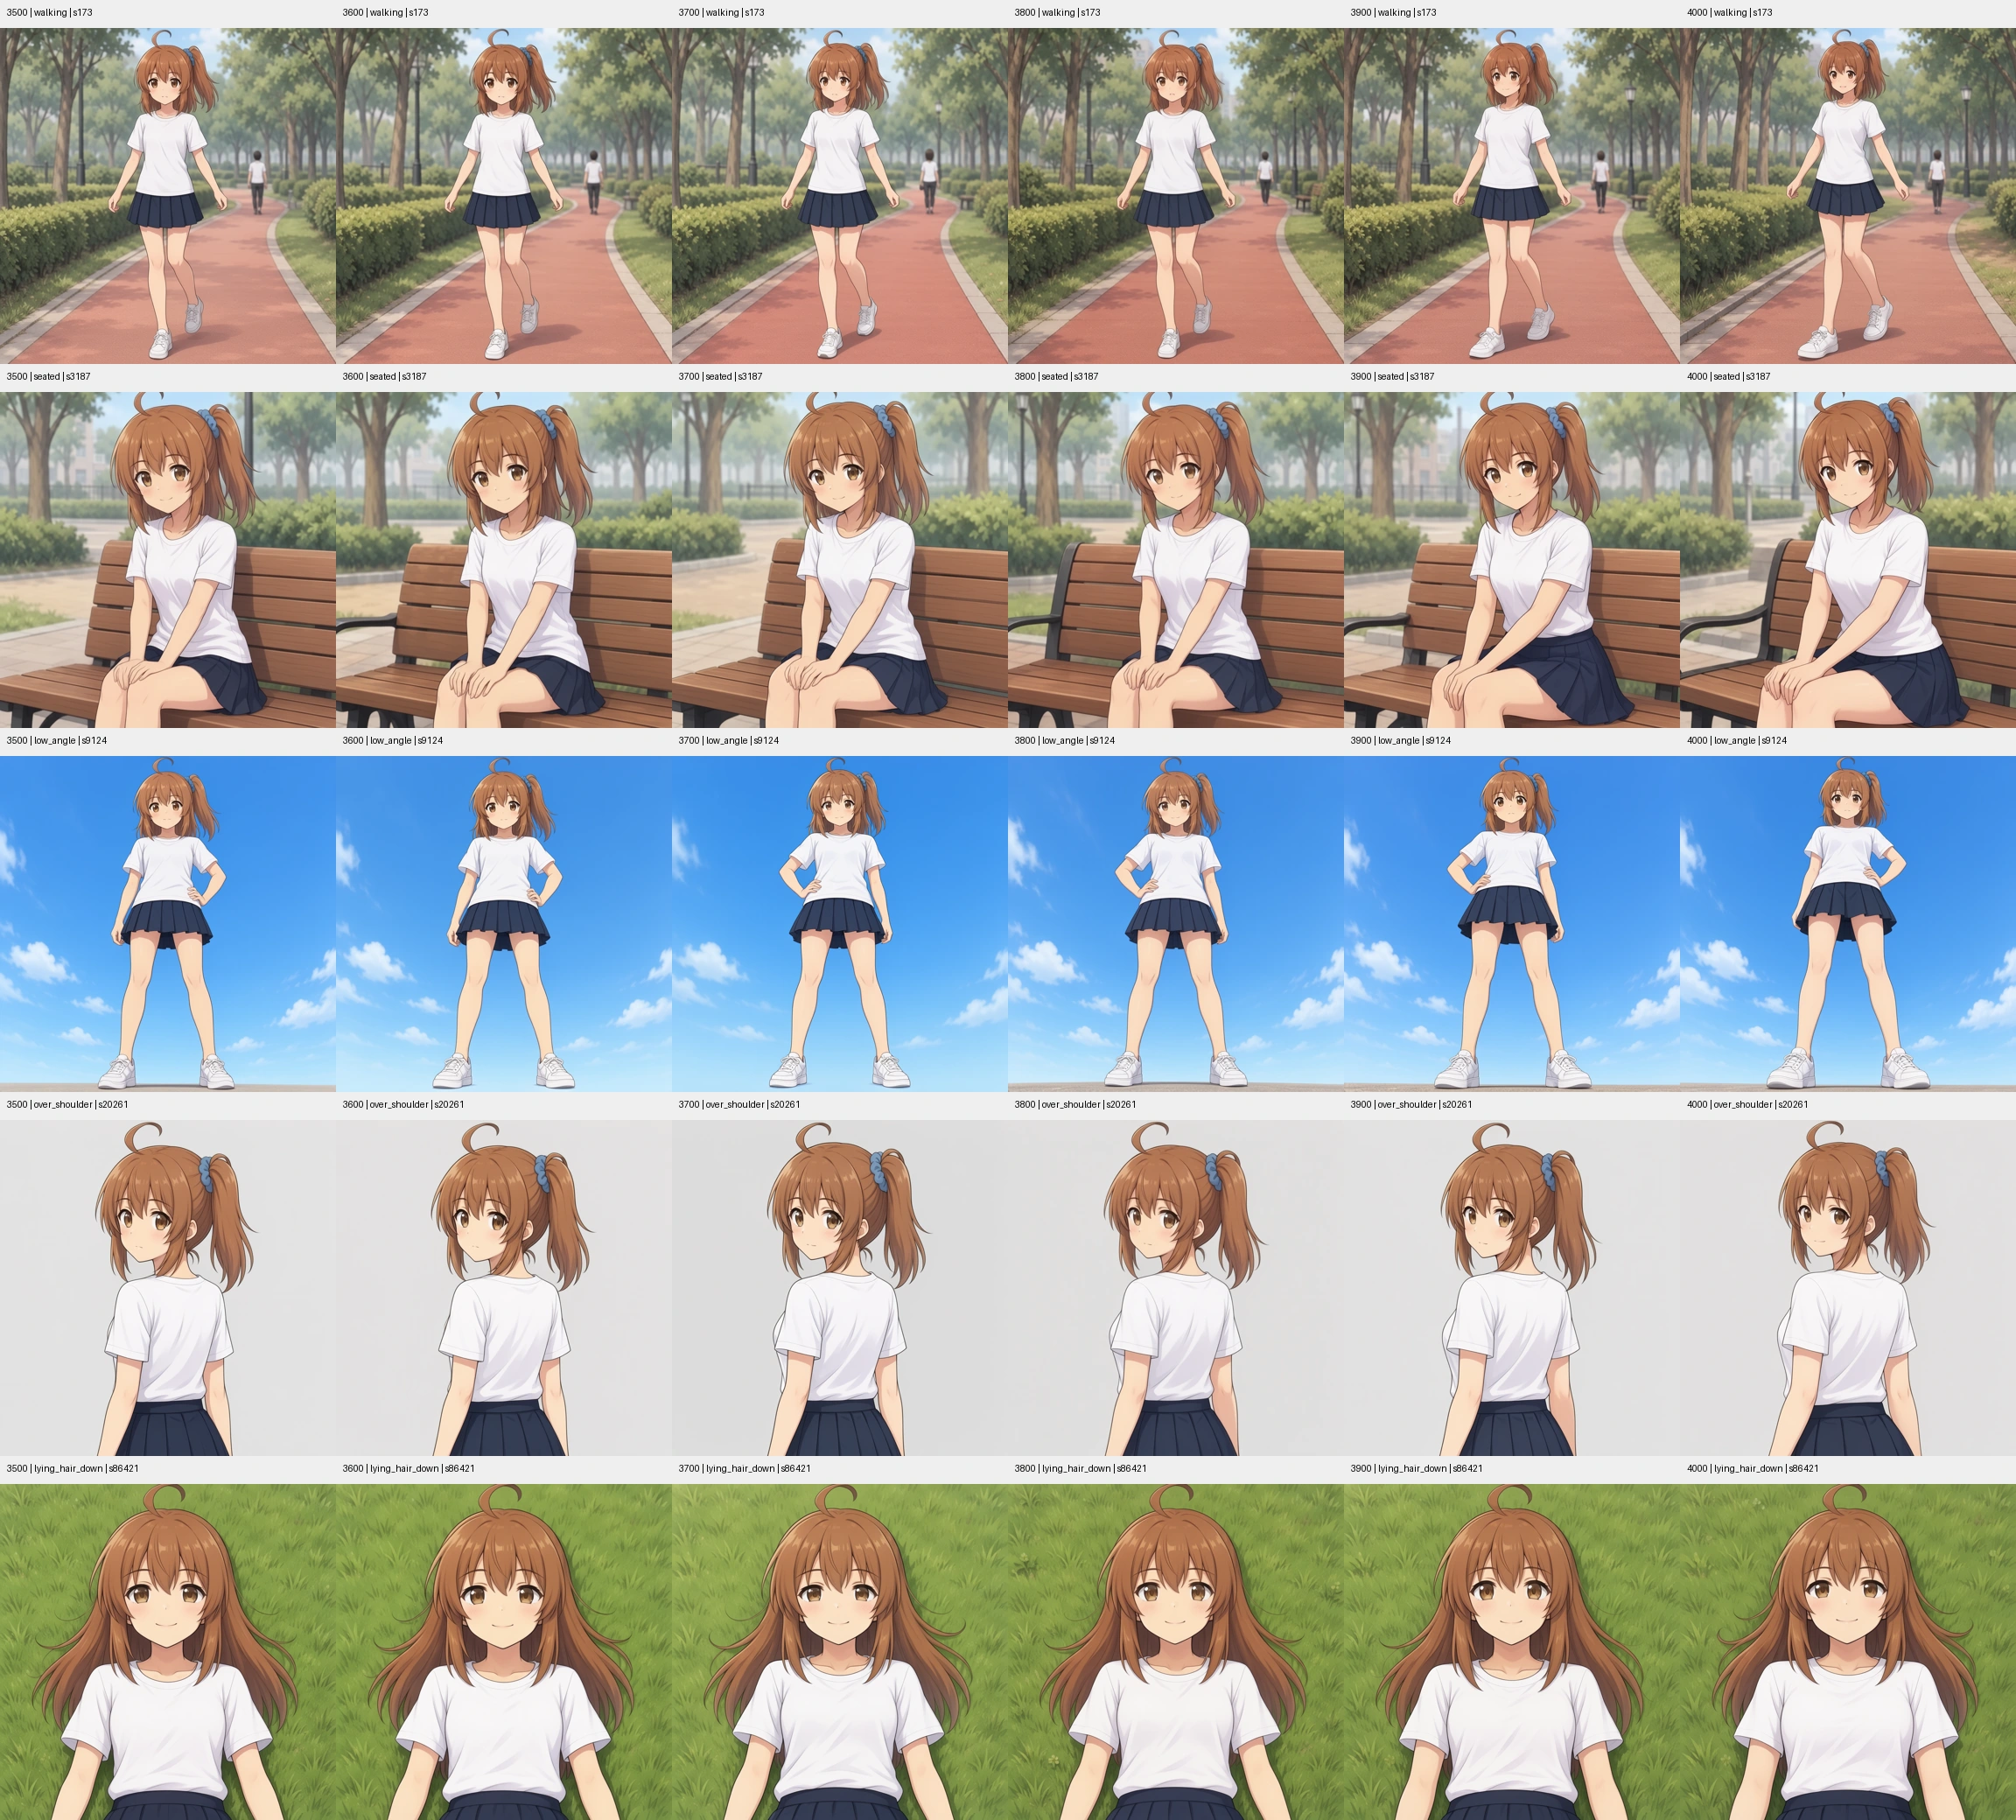
歩く・低い視点の構図では3600が3500に近く、3900は4000寄りの見た目になった。3700・3800にも姿勢や顔の変化はあるが、どの構図でも同じように変わるわけではない。ここでは3600または3700を候補として残したが、振り返り構図で結び目が見えて髪型が合わない点は両方に残った。
結び目が隠れる側を指定してみた
かなのサイドポニーは正面で画面右(本人の左側)に付いているため、本人の右側へカメラを置く構図なら結び目は頭の奥に隠れるはずだ。相対的な「シュシュと反対側」の指定だと手前に出てしまったため、今度は本人の左右を固定し、同じくローカルのSFT+4ステップ生成で試してみた。
正面で画面右に結び目がある向きに合わせて、本人の左に結ぶ指定にし、カメラは本人の右に置いて右頬・右耳が見え、鼻が画像右へ向くと明記した。結び目は頭の奥で遮られ、見える側は下ろした髪と指定している。角度を変えた3件に加えて、原因になりそうなシュシュの色とアホ毛の説明を外した条件(シード89014)も試した。
| 指定 | シード | 3600・3700での結果 |
|---|---|---|
| 右側からの斜め | 50173 | 顔の向きは変わるが、結び目は手前に見える |
| 右の真横の横顔 | 73251 | 横顔にはなるが、青いシュシュと結び目が見える |
| 右後ろの背面寄り | 75399 | 背面寄りにはなるが、結び目は見える |
| 見える側の下ろした髪を中心に記述。シュシュの色とアホ毛の説明は外す | 89014 | 黒いゴムへ変わったが、結び目自体は隠れない |
左が3600、右が3700で、上から表の順に並べてあり、原寸とプロンプトの比較ページも残した。
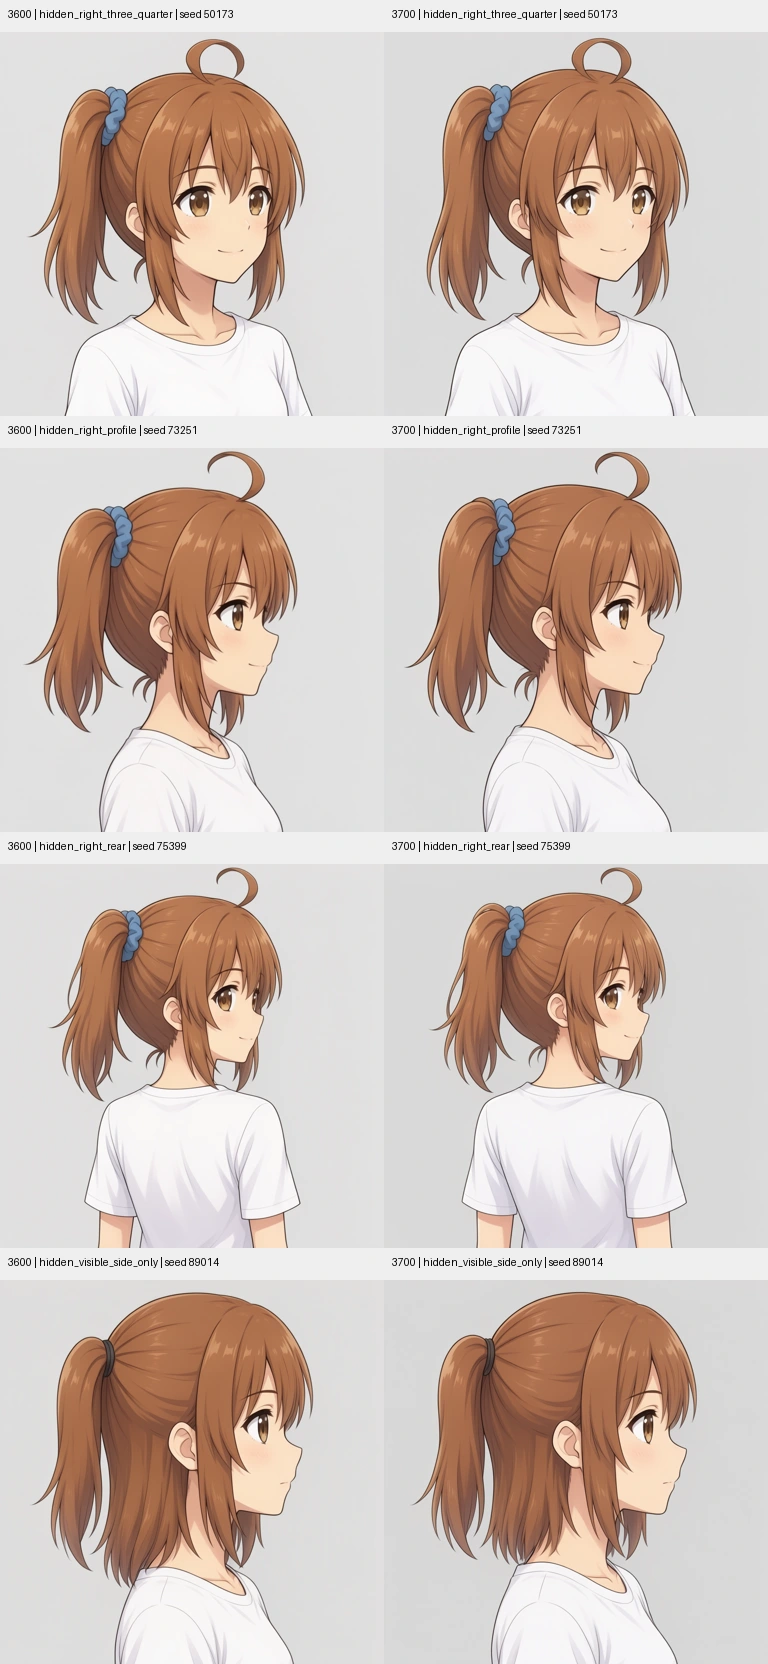
8枚とも結び目が頭で隠れた絵にはならず、3600と3700の差も出なかった。5000まで増やした実験でも同じ失敗が起きていたため、まずv3キャプションと元画像を見直したうえで、キャラLoRAを外した対照でも起きるか調べてみることにした。
原因の切り分け
キャプションと元画像を点検し直した
学習前の見直しでは画像ごとの誤認識や不要語の削除を中心にしていたため、視点をまたぐ左右や隠れ方の記述がv3の70枚でどうなっているかを数えてみた。
| v3の確認項目 | 件数 |
|---|---|
side ponytail を含む文 | 66/70 |
| 結び目が隠れると明記した文 | 1/70 |
nape・back hair・bob・shoulder-length など、襟足や下ろした後ろ髪の独立した記述 | 0/70 |
左右は主に on the image right や on the image left という画面上の位置で記述しており、結び目の見えない横顔 kana_0017、kana_0034 や、奥に飾りの一部が見える kana_0035 は side ponytail ではなく ponytail や tied section と書いていた。
続けて横・後ろ向きの元画像9枚を拡大し、全70枚の一覧ももう一度確認した。結び目が隠れる横顔と見える横顔の両方が入っていて、明確な左右反転の矛盾はなかった。後ろ髪は角度や切り取り方でも見え方が変わるので、そこが違って見えても元画像が矛盾しているとは言えない。
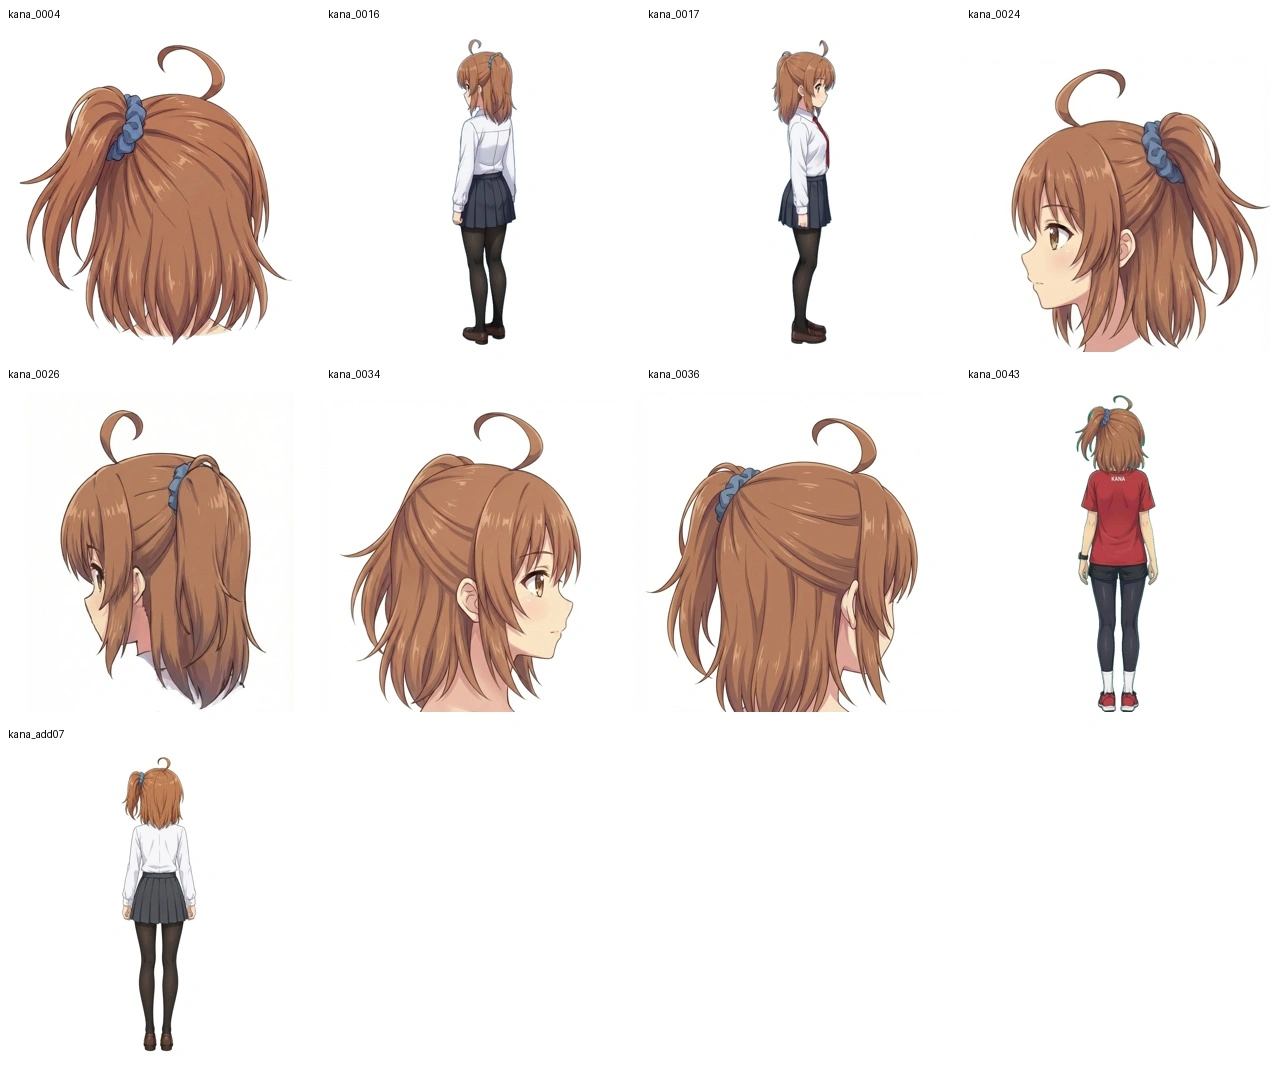
なお kana_0036 には with expression and. という途切れた文が残っていたが、今回の比較では今のデータを変えずに進めた。公式のキャプション指針は画像に見える情報だけを記述する方針なので、見えない結び目を全画像へ推測で書き足すことは避けた。
同じプロンプトとシードでキャラLoRAだけを外した
次に、キャプションやキャラLoRAが原因かを確かめるため、まずローカルのSFT+4ステップ(sd.cpp、Qwen3.5-9B Q8_0、Flux2 VAE、768px)で両条件に4ステップLoRAを入れ、3600あり(前節の4枚を再利用)と キャラLoRAなし を同じプロンプト・シードで比べた。あわせて、同じ構図でも結び目が見える左横顔なら成立するかどうかの基準(シード73251)も1組追加している。
| 生成条件と指定 | シード | キャラLoRAなし | 3600あり |
|---|---|---|---|
| SFT+4ステップ、隠れる斜め | 50173 | 結び目が見える | 結び目が見える |
| SFT+4ステップ、隠れる横顔 | 73251 | 結び目が見える | 結び目が見える |
| SFT+4ステップ、隠れる背面寄り | 75399 | 結び目が見える | 結び目が見える |
| SFT+4ステップ、見える側だけを中心に書く補助指定 | 89014 | 結び目が見える | 結び目が見える |
| SFT+4ステップ、結び目を見せる左横顔 | 73251 | 見える側として成立 | 見える側として破綻なし |
| Base・50ステップ、隠れる右横顔 | 73251 | 結び目が見える | 結び目が見える |
SFT+4ステップは左がキャラLoRAなし、右が3600ありで、上から表の最初の5行に対応している。
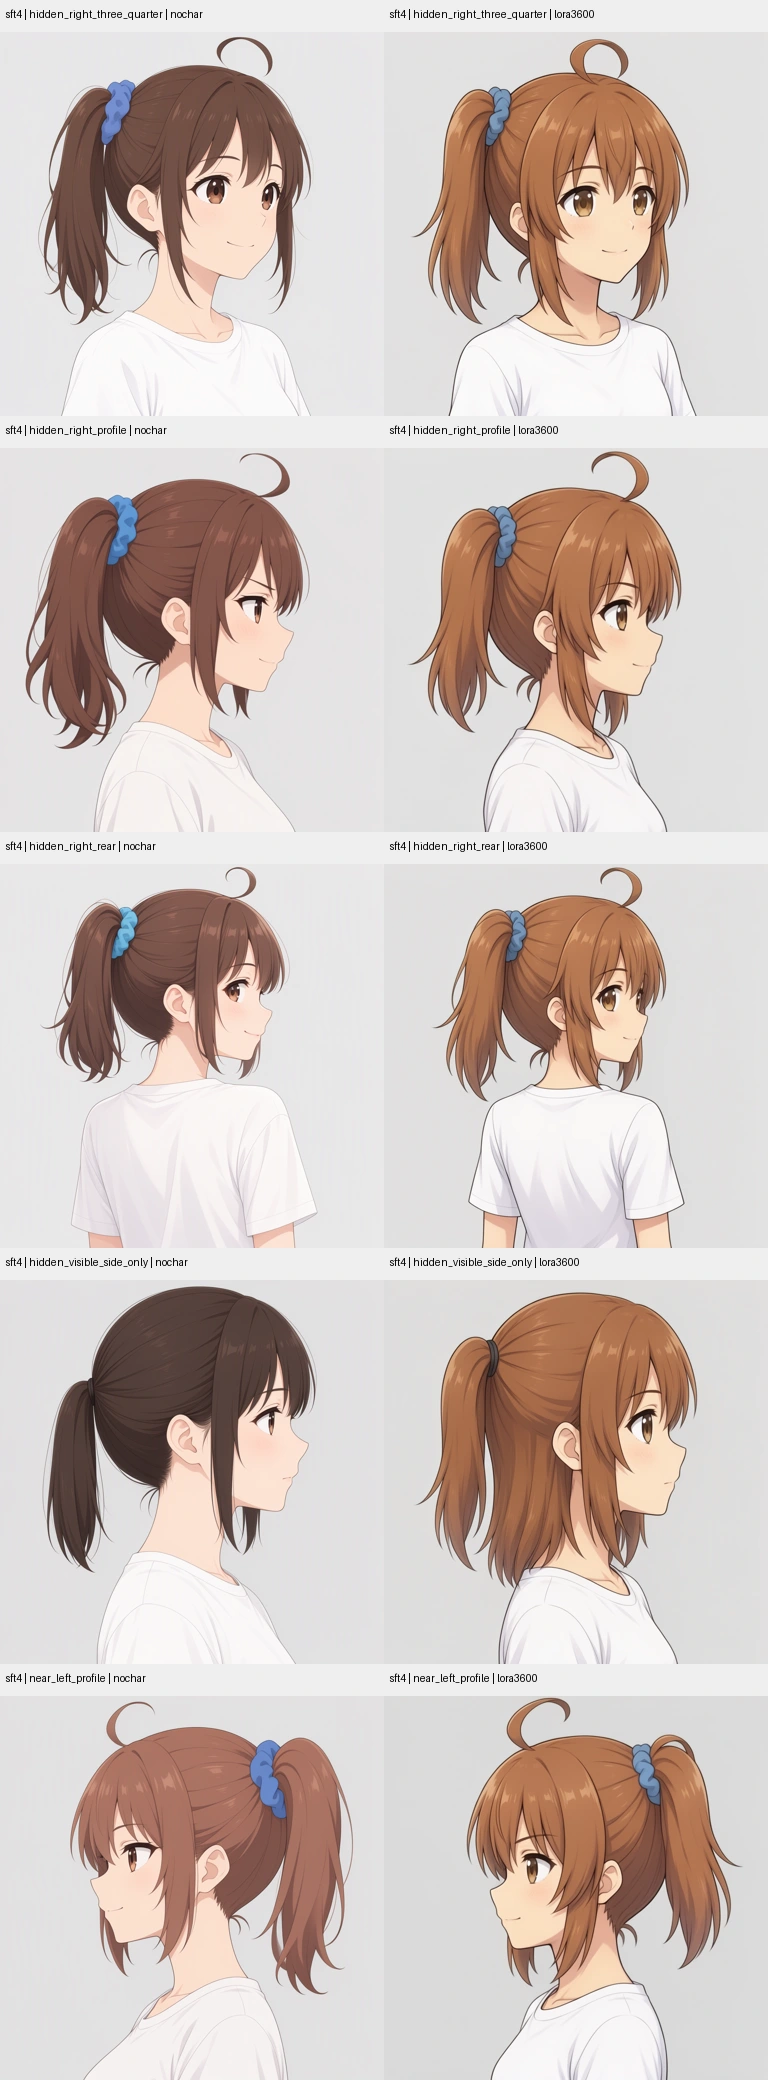
左横顔は成立した一方、隠れる右側はキャラLoRAを外しても4条件とも結び目が見えてしまった。4ステップLoRAやSFTの影響を切り分けるため、さらにBase・50ステップ(CFG 3、シフト値5、4ステップLoRAなし)でも隠れる右横顔(シード73251)をキャラLoRAあり・なしで出してみた。キャラLoRAなしは524.18秒、3600ありは531.44秒かかり、上の表の最後の行に対応している。各画像の原寸とプロンプトは切り分けの比較ページにまとめた。
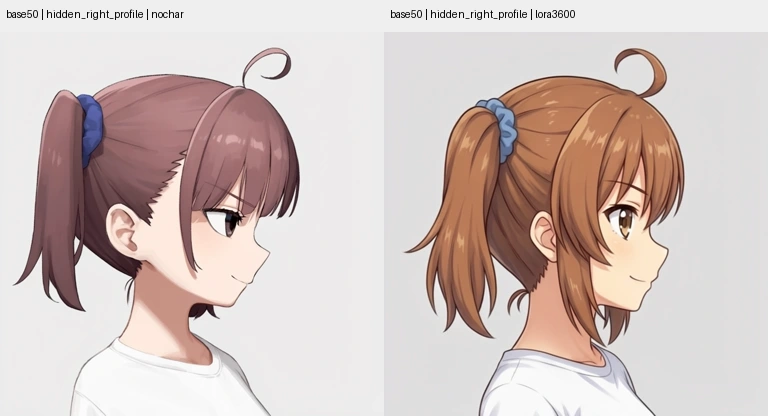
キャラLoRAも4ステップLoRAも外したBaseの50ステップで同じように結び目が見えたため、今回の学習キャプションや4ステップ化だけがこの失敗の原因ではなかった。ただ、今回の検証は sd.cpp とQ8_0のテキストエンコーダーを使った環境でBase側は1種類のプロンプトとシードだけの対照なので、MOSS全体の仕様とまでは言い切れない。
後ろ髪の変化
SFTの対照では、キャラLoRAなしが髪をほぼ一束にまとめた髪型になり、3600ありは襟足から下ろした髪が出た。一方、今回のBase・3600ありの横顔では襟足が下ろされた形にならず、同じ3600の重みでも生成モデルと設定によって後ろ髪の出方が変わっている。