MOSS-ImageのキャラLoRAをEVO-X2のROCmで1024px学習する
 目次
GMKtec EVO-X2(Ryzen AI Max+ 395、Radeon 8060S)のROCm環境で、MOSS-Image BaseのキャラクターLoRAを1024pxで学習してみた。
LoRA(Low-Rank Adaptation)はモデル本体を書き換えるのではなく、追加の軽量な差分重みを学習する手法。Anima用に用意していた70枚のデータセットからキャプションをMOSS-Image向けに書き換え、ai-toolkitを使って3000ステップ(重みの更新回数)まで完走させた実測の記録。1ステップの所要時間やGPUメモリの推移、ステップごとの出力の変化、プロンプトの記述による頭身・配色の調整、アニメ系派生モデルへの適用結果をまとめる。
環境と前提
学習に使うのはGMKtec EVO-X2。Ryzen AI Max+ 395、内蔵GPUはRadeon 8060S(gfx1151)、メモリは64GBでCPUとGPUが共有する。GTT(Graphics Translation Table)は、統合メモリ環境でGPU側がアクセスできるホストメモリの割り当て領域を指す。
| 項目 | 内容 |
|---|---|
| OS | Ubuntu 26.04.1 LTS、カーネル 7.0.0-43-generic |
| GPUが使えるメモリ | GTT 56GiB(mem_info_gtt_total が60129542144)。カーネル引数 ttm.pages_limit=14680064 で広げてある |
| PyTorch | 2.12.0a0+rocm7.13.0a20260411(AMDのgfx1151向け開発版) |
| 学習ツール | ostris/ai-toolkit d6a18ad(2026年11月13日のコミット)、Python 3.12 |
| 学習するモデル | MOSS-Image Base bf16(素の基盤重み、量子化なし) |
| テキストエンコーダー | Qwen3.5-9B bf16。埋め込みをキャッシュしたあと解放する |
| VAE | FLUX.2のVAE |
学習前の時点で、llama-serverやComfyUIなどGPUを使うプロセスは動いていなかった。空きメモリは55GB。
環境構築と動作確認は先行作業で終えていて、そのときの実測は下の表のとおり。データは動作確認用の9枚で、キャラクターの学習ではない。
| 解像度 | 1ステップ | 全体の時間(読み込みとキャッシュ込み) | 最大メモリ(RSS) |
|---|---|---|---|
| 512px | 4.4秒 | 12ステップで2分26秒 | 28.0GB |
| 1024px | 34.4秒 | 6ステップで6分35秒 | 26.8GB |
1024pxで2000ステップ回すと、34.4秒×2000で約19.1時間の見込みになる。
先行作業では512pxを勧めていたが、手元の学習画像は1024px以上なので、今回は1024pxで回す。
そもそもこの構成でキャラLoRAの学習が最後まで回り、使えるものができるのかが分かっていない。対象は「かな」1キャラだけに絞った。
MOSS-Imageの学習キャプションの仕様
学習画像は、Anima用に作った4キャラ合体LoRAのデータセットから流用する。キャプションはAnima向けなので、MOSS-Image向けに変える必要がある。
公式ユーザーガイド(2026年11月8日のコミット時点)から、関係する記述を拾った。
| 項目 | 公式ガイドの記述 |
|---|---|
| 入力形式 | 自然文、タグ列、JSONレイアウトを受け付ける |
| 言語 | 学習データが最も多い英語を推奨 |
| タグ列の順序 | Quality → Score → Meta → Year → Character → Series → Artist → General |
| 追加学習 | テキストエンコーダーは凍結したままにする |
| キャプション生成 | VLMにlong・medium・shortの3種類をJSONで出させる。longは構図、主な被写体、動作、場所、色、光、画風を詳しく書く |
| 画像内の文字 | 翻訳やローマ字化をせず、見えるとおりに書く |
| 透かし | キャプションには書かず、別の欄に記録する |
| キャプション用のモデル | Gemma 4、Qwen 3.5 27B、Qwen 3.5 35B-A3Bを推奨 |
公式ガイドにはキャラLoRA用のトリガーワードや、キャラの固定特徴を書くかどうかの記述はない。そこは解説記事を3本読んだ。
| 出典 | キャプションについての記述 |
|---|---|
| airmore.ai | 詳細な自然文を推奨。トリガーワードはキャプションの先頭。髪・服・背景のように毎回同じ特徴を全キャプションへ書き写すと、意図しない結び付きができると注意している |
| imagelora.dev | 素の自然文で学習できる。あとから変えたいものを書き、LoRAに焼き込みたいものは書かない |
| noteのai-toolkit解説 | 画像と同名の .txt を置く。トリガーワードは造語1語。自然文かタグかの指定はない |
ai-toolkitのMOSS-Image実装(extensions_built_in/diffusion_models/moss_image/moss_image.py)も読んだ。キャプションはQwen3.5-9Bのチャットテンプレートに入れてから埋め込みにしていて、上限は4096トークン。長めの自然文でも切られる心配は小さい。
画像とキャプションの抽出・変換
元データは merged-4char-dataset(518枚)。ファイル名が kana_ で始まるソロ画像は75枚あった(kana_NNNN が63枚、kana_addNN が12枚)。ペアやトリオの画像は使わない。
75枚のうち、レーティングタグが safe ではない5枚(sensitive が4枚、explicit が1枚)は外した。残りは70枚。
元のキャプションは次の形をしている。
masterpiece, best quality, score_7, safe, 1girl, solo, kanachan, A close-up portrait of a young girl with an angry expression and a slight frown looking directly at the viewer. Her side ponytail with a blue scrunchie is visible on the right side of the image, and a small antenna of hair rises from the top of her head. side ponytail, ahoge, double parted bangs, medium hair, blue scrunchie, angry, frown, looking at viewer, portrait, bare shoulders, white background, simple background先頭に品質タグとレーティングタグ、次に 1girl, solo とトリガーワード kanachan、そのあとに自然文、最後にdanbooruタグ列が並ぶ。
これを次のように変えた。
| 元のキャプションの部分 | MOSS用での扱い |
|---|---|
masterpiece, best quality, score_7, safe | 削除。Animaの品質・スコア・レーティングの書式で、MOSS-Imageで同じ語が反映されるか確かめていない |
1girl, solo | 削除 |
トリガーワード kanachan | 自然文の主語へ入れる。a young girl を a girl named kanachan に置き換えた |
| 自然文 | そのまま残す。サイドポニーが画像の左右どちらに見えるかの文も残した |
| 末尾のdanbooruタグ列 | 削除。髪型・髪色・目の色などの固定特徴のタグもここで消える |
| 背景 | タグにしか無かったので、Anime-style illustration with a plain white background. の1文を末尾に足した |
変換後はこうなる。
A close-up portrait of a girl named kanachan with an angry expression and a slight frown looking directly at the viewer. Her side ponytail with a blue scrunchie is visible on the right side of the image, and a small antenna of hair rises from the top of her head. Anime-style illustration with a plain white background.固定特徴を全部消すかどうかは解説記事の間でも書き方が分かれる。今回は、髪色や目の色のタグは消し、サイドポニーの位置の文だけ残した。
かなのサイドポニーは向かって右に付く。後ろ姿では左に見える。Animaの学習では、この左右が反転しないかを監視項目にしていた。画像ごとに変わる情報なので、変えたいものを書くという方針にも合う。
背景色がタグに無い6枚(simple background だけのもの)は、画像を見て色を決めた。ベージュが1枚、クリーム色が5枚。
kana_addNN の12枚は元がタグ主体だったので、タグと添え文の内容だけを使って自然文に書き直した。画像を見て新しい情報を足すことはしていない。
変換後のキャプションは最短31語、平均48.3語、最長71語。
変換スクリプトは ~/train/build_kana_moss_dataset.py、出力先は ~/train/datasets/kana_moss_v1/(PNG 70枚とTXT 70個)。元と変換後の対応は ~/train/kana_moss_v1_captions.jsonl に残した。
画像の縦横比は次のとおり。ai-toolkitが縦横比ごとのバケットに振り分けるので、リサイズや切り抜きはしていない。
| 縦÷横 | 枚数 |
|---|---|
| 1.0 | 48 |
| 1.38〜1.39 | 7 |
| 1.49〜1.5 | 10 |
| 1.78〜1.81 | 2 |
| 2.0 | 3 |
一部の画像は右下に小さな星形の透かしが入っている。公式ガイドに合わせて、キャプションには書いていない。
縦長画像での事前テスト
gfx1151のROCm版PyTorchには、bf16で縦横比が極端な画像を扱うと不具合が出るという報告がある(ROCmのissue #6034。原文は未確認で、先行作業の引き継ぎメモに書かれていた内容)。
70枚のうち縦÷横が1.78以上の5枚だけを別フォルダーに入れ、1024px・5ステップで先に回した。本番で10時間回ったあとに落ちるのを避けるためだ。
| 項目 | 結果 |
|---|---|
| バケット | 720x1456が3枚、752x1392が1枚、768x1360が1枚 |
| 1ステップ | 平均36.0秒(34.8〜37.8秒) |
| 損失 | 0.073、0.222、0.478、0.078、0.081。NaNは出なかった |
| 全体の時間 | 10分30秒(読み込みとキャッシュ込み) |
| 最大メモリ(RSS) | 27.06GB |
| 終了コード | 0 |
5ステップなので、長時間回したときに同じ不具合が出ないことまでは確かめられていない。
1024px・2000ステップの本番学習
設定は先行作業のひな形から、データセットの場所と解像度だけ変えた。
| 項目 | 値 |
|---|---|
| 解像度 | 1024(縦横比バケットあり) |
| LoRA | rank 16、alpha 16 |
| オプティマイザー | AdamW(8bit版ではない)、学習率1e-4 |
| バッチ | 1、勾配の累積なし |
| ステップ数 | 2000。70枚なので約28.6エポック |
| 保存 | 250ステップごと。bf16 |
| キャプションのドロップアウト | 0.05 |
| タイムステップの選び方 | 指定なし(ai-toolkitの既定値 sigmoid) |
| gradient checkpointing | あり |
| 量子化 | なし(DiT、テキストエンコーダーとも) |
| 学習中のサンプル生成 | なし |
ai-toolkitが作ったバケットは8種類だった。1024pxに満たない画像は拡大されず、小さいバケットに入っている。
| バケット | 枚数 |
|---|---|
| 1024x1024 | 45 |
| 832x1248 | 10 |
| 864x1200 | 7 |
| 720x1456 | 3 |
| 880x880 | 2 |
| 928x944 | 1 |
| 752x1392 | 1 |
| 768x1360 | 1 |
2026年11月15日3時22分47秒に起動した。モデルの読み込み、70枚分のテキスト埋め込みとlatentのキャッシュが終わり、最初のステップが出たのは3時32分台。準備に約9分かかった。
最初のステップは35.6秒で、ai-toolkitの残り時間表示は19時間46分だった。
計測は2系統で取っている。プロセス全体は /usr/bin/time -v で包んだ。学習中は60秒ごとに、ステップ数、損失、プロセスのRSS、GTTとVRAMの使用量、GPU使用率、空きメモリ、スワップ、GPU温度、GPU電力を ~/train/kana_moss_v1_metrics.jsonl へ1行ずつ追記している。
250ステップ時点の計測
5時56分に250ステップ目のLoRA(74MB)が保存された。最初のステップから2時間24分かかっている。60秒ごとの記録145件を集計した。
| 項目 | 値 |
|---|---|
| 1ステップの平均 | 34.7秒(ステップ1から250までの経過時間÷249) |
| バケットによる差 | 1024x1024は約35秒、880x880は約21秒(最初の5ステップの進捗表示から) |
| プロセスのRSS | 12.68GBで一定。ただしこれは計測スクリプトが拾っていたDataLoaderのワーカープロセスの値で、学習本体ではなかった(手順7で訂正) |
| GTT使用量 | 最小17.1GB、平均35.3GB、最大40.9GB |
| 空きメモリ(MemAvailable) | 最小3.7GB |
| スワップ使用量 | 1.19〜1.25GBで、学習前からほぼ変わらない |
| GPU使用率 | 平均99.9% |
| GPU温度 | 63〜71℃、平均66.7℃ |
| GPU電力 | 平均85.1W |
| 損失(60秒ごとに拾った値の平均) | 前半0.330、後半0.314 |
損失はステップごとの揺れが大きく(0.07〜0.8)、この時点では下がったとは言えない。
メモリは先行作業の6ステップの計測(GTTの最大25.4GB)より大きく増えた。GTT使用量は一定ではなく、約6.8GBずつ段階的に上がっていった。
| 時刻 | ステップ | GTT使用量 | 空きメモリ |
|---|---|---|---|
| 3時32分 | 1 | 17.1GB | 27.6GB |
| 3時40分 | 15 | 27.3GB | 17.5GB |
| 4時12分 | 70 | 34.1GB | 10.4GB |
| 4時52分 | 140 | 40.9GB | 3.7GB |
| 5時57分 | 250(保存の直後) | 21.4GB | 22.7GB |
250ステップ目の保存のあと、GTT使用量は21.4GBまで戻った。
段階的に増える原因は確かめていない。バケットが8種類あり、初めて出てくる画像サイズのたびにGPUメモリの確保が増えている、というのは推測。
次の保存までにもう1段上がると空きメモリが足りなくなる計算なので、空きメモリとスワップを監視しながら続ける。落ちた場合は250ステップごとの保存から再開する。
500ステップ時点のメモリ推移
8時20分に500ステップ目が保存された。最初のステップから4時間47分。
250〜500ステップの区間でも、GTT使用量は同じ形で動いた。
| 時刻 | ステップ | GTT使用量 | 空きメモリ |
|---|---|---|---|
| 5時57分 | 250(保存の直後) | 21.4GB | 22.7GB |
| 5時58分 | 253 | 28.2GB | 16.2GB |
| 6時2分 | 259 | 34.9GB | 9.9GB |
| 6時7分 | 268 | 41.7GB | 3.2GB |
| 8時20分 | 500(保存の直後) | 17.7GB | 26.0GB |
268ステップ目で41.7GBに達したあとは、500ステップ目の保存まで約2時間13分そのままだった。4段目には上がっていない。保存のたびに戻り、3段上がって約41〜42GBで止まる、という動きが2区間続いた。
スワップは1.19GBから1.48GBへ少し増えた。空きメモリの最小は3.2GBで、64GB機では余裕がほとんどない状態で回っている。
750ステップでの出力確認と保存間隔の変更
250ステップごとの保存だと刻みが粗い。キャラが固まる点が2つの保存の間にあると、ちょうどいい所を取り逃がす。
それに、学習中の見本生成を切っていたので、ここまで学習が効いているのかどうかを一度も見ていなかった。
実行中のai-toolkitは保存間隔を途中で変えられない。750ステップ目の保存(10時44分)の直後に学習を止め、GPUメモリが空いている間に見本を出してから、save_every: 100 で再開することにした。
止めるときに間違えたこと
学習プロセスをPID指定で kill したが、止めたのはDataLoaderのワーカープロセスだった。学習本体と同じコマンドライン文字列を持つ子プロセスで、pgrep -f の最後の1件を取るとこちらが返る。
ワーカーが落ちたことで本体も RuntimeError: DataLoader worker (pid 143483) is killed by signal: Terminated. で終了したので、結果として学習は止まった。752ステップ目まで進んでいたが、保存は750なので2ステップ分を捨てた。
60秒ごとの計測スクリプトも同じ方法でPIDを選んでいたので、手順5で「RSS 12.68GBで一定」と書いた値はワーカーのものだった。
学習本体を含む値は /usr/bin/time -v の記録にある。
| 項目 | 値(起動から750ステップ過ぎで止めるまで) |
|---|---|
| 経過時間 | 7時間22分26秒 |
| 最大メモリ(RSS) | 27.53GB |
| ユーザーCPU時間 | 52,332秒 |
計測スクリプトは、該当するプロセスのうちRSSが最大のものを選ぶように直した。
250・500・750ステップの見本
見本はstable-diffusion.cpp(master-b521db4、Vulkan版)で出した。学習はMOSS-Image Baseで行い、生成はMOSS-Image SFT(教師あり追加調整版)に4ステップ蒸留LoRA(moss_image_sft_4step_v2.0)と学習したLoRAを重ねる。どちらのLoRAも強さは1。Eulerの4ステップ(ここでのステップはノイズを除去する推論計算の回数)、CFG 1.0、seedは42で固定した。
ログでは、学習したLoRAが504/504テンソル、4ステップLoRAが756/756テンソル適用されていた。
1枚あたりの時間は、モデルの読み込み込みで53〜56秒だった。
プロンプトは3本。学習キャプションと同じ書き方にしてある。
| 名前 | プロンプト | サイズ |
|---|---|---|
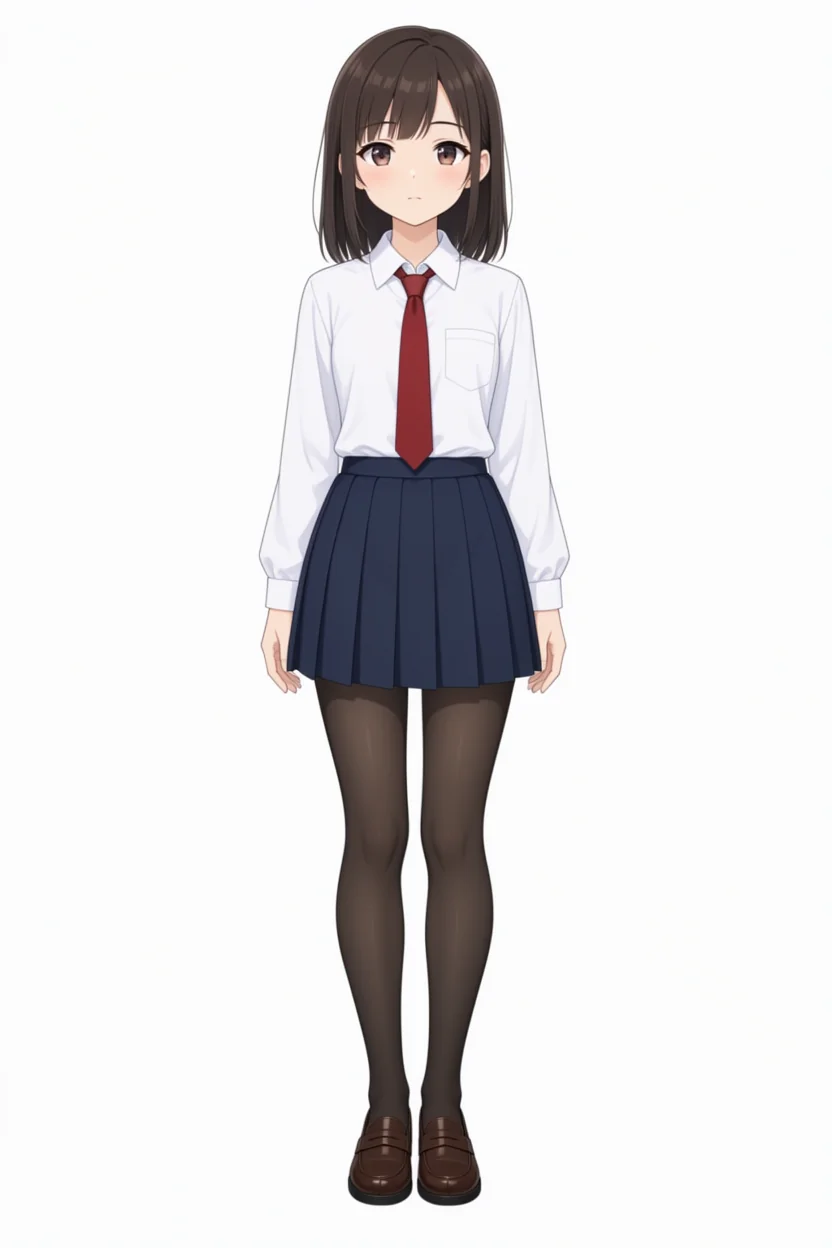
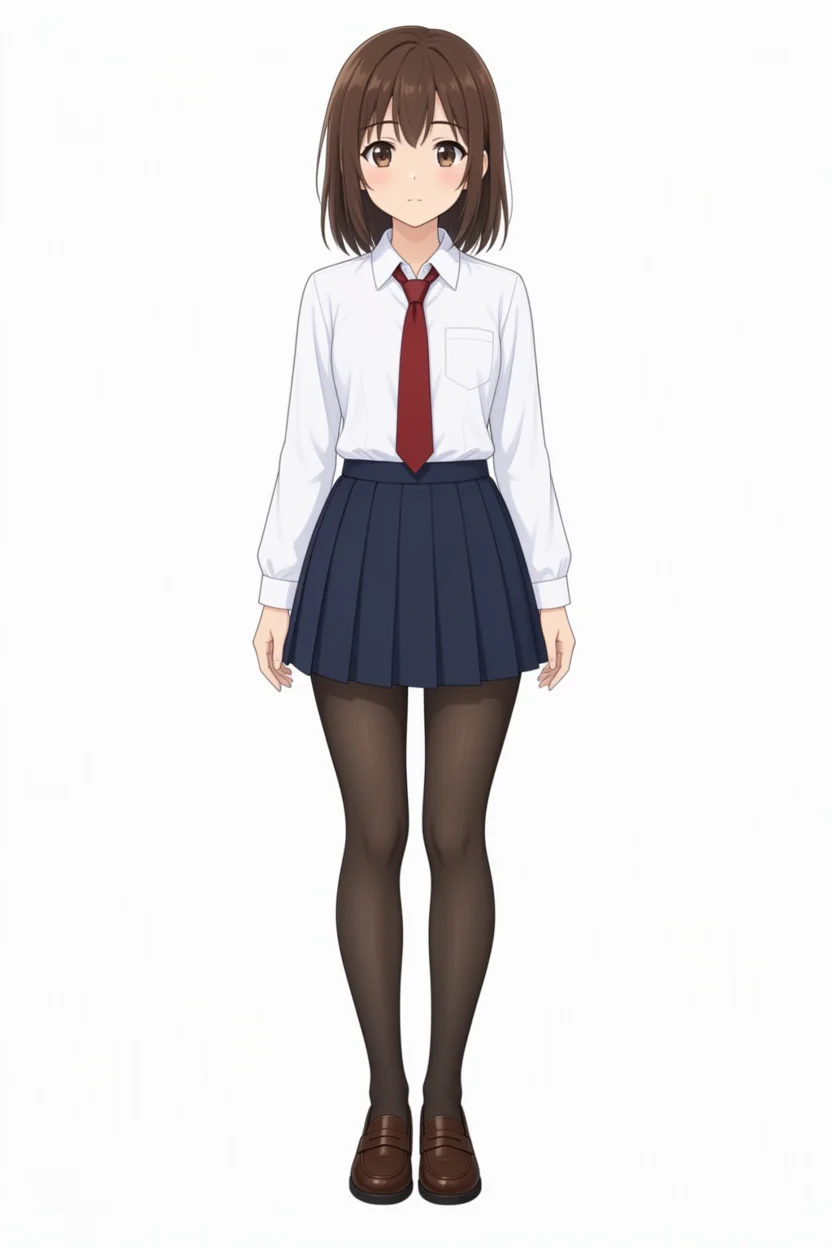
| p1 | A full-body front view of a girl named kanachan standing and facing the viewer directly, wearing a white collared shirt with red necktie, navy blue pleated skirt, black pantyhose, and brown loafers. Anime-style illustration with a plain white background. | 832x1248 |
| p2 | A close-up portrait of a girl named kanachan with a gentle closed-mouth smile looking warmly at the viewer. Anime-style illustration with a plain white background. | 1024x1024 |
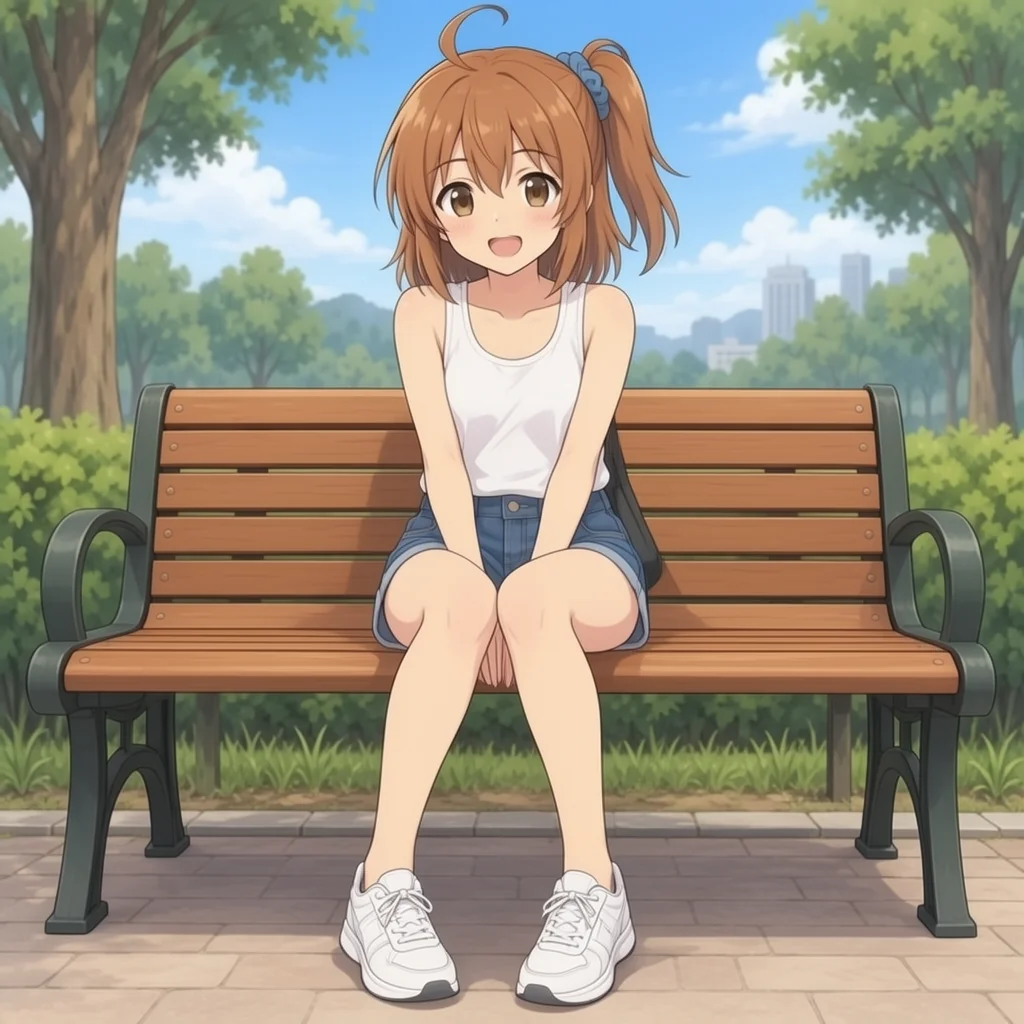
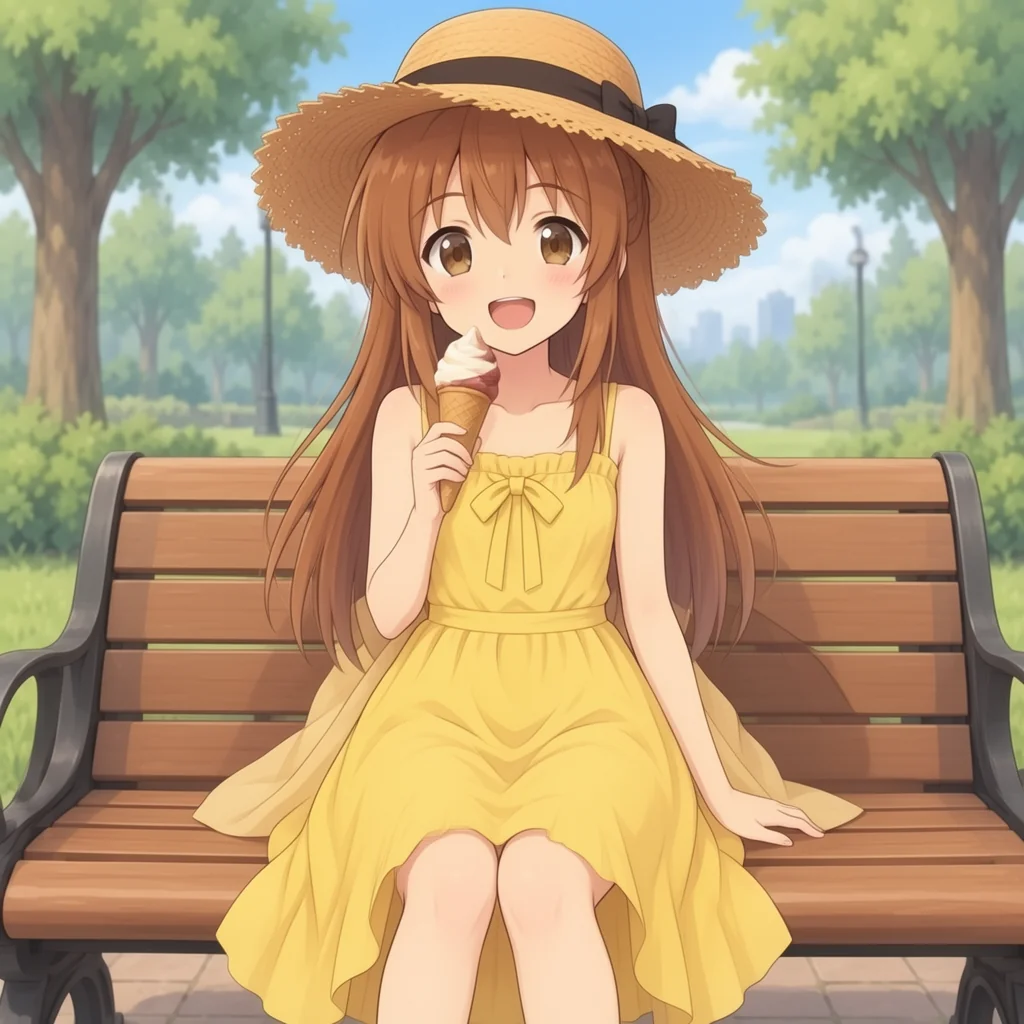
| p3 | A girl named kanachan sitting on a park bench eating an ice cream cone, wearing a yellow sundress and a straw hat, smiling. A sunny park with green trees in the background. Anime-style illustration. | 1024x1024 |
p1とp2は学習画像にある構図、p3は学習画像にない服と場面。髪型や髪色はどのプロンプトにも書いていない。
かなの固定特徴は、茶色の髪、向かって右のサイドポニー、青いシュシュ、頭頂のアホ毛。各出力でどこまで出たかを見た。
| LoRA | p1(制服の全身) | p2(顔アップ) | p3(公園) |
|---|---|---|---|
| なし | 黒に近い髪のボブ。サイドポニーもアホ毛もない | 黒髪のセミロングで花の髪飾り | こげ茶のロングヘア |
| 250ステップ | 髪が茶色寄りになった。髪型はボブのまま | 茶色寄りのボブ | LoRAなしとほぼ同じ |
| 500ステップ | 髪がさらに明るい茶色に。髪型は肩までのストレート | 向かって右に三つ編みと花飾りが出た。サイドポニーではない | 髪色が明るくなった。ロングのまま |
| 750ステップ | サイドポニーとアホ毛が出た | サイドポニーと青いシュシュが出た。アホ毛は画面の上端で切れていて判別できない | 髪色は近い。ロングのままで、サイドポニーは出ていない |
LoRAなしのp1。
250ステップのp1。
500ステップのp1。
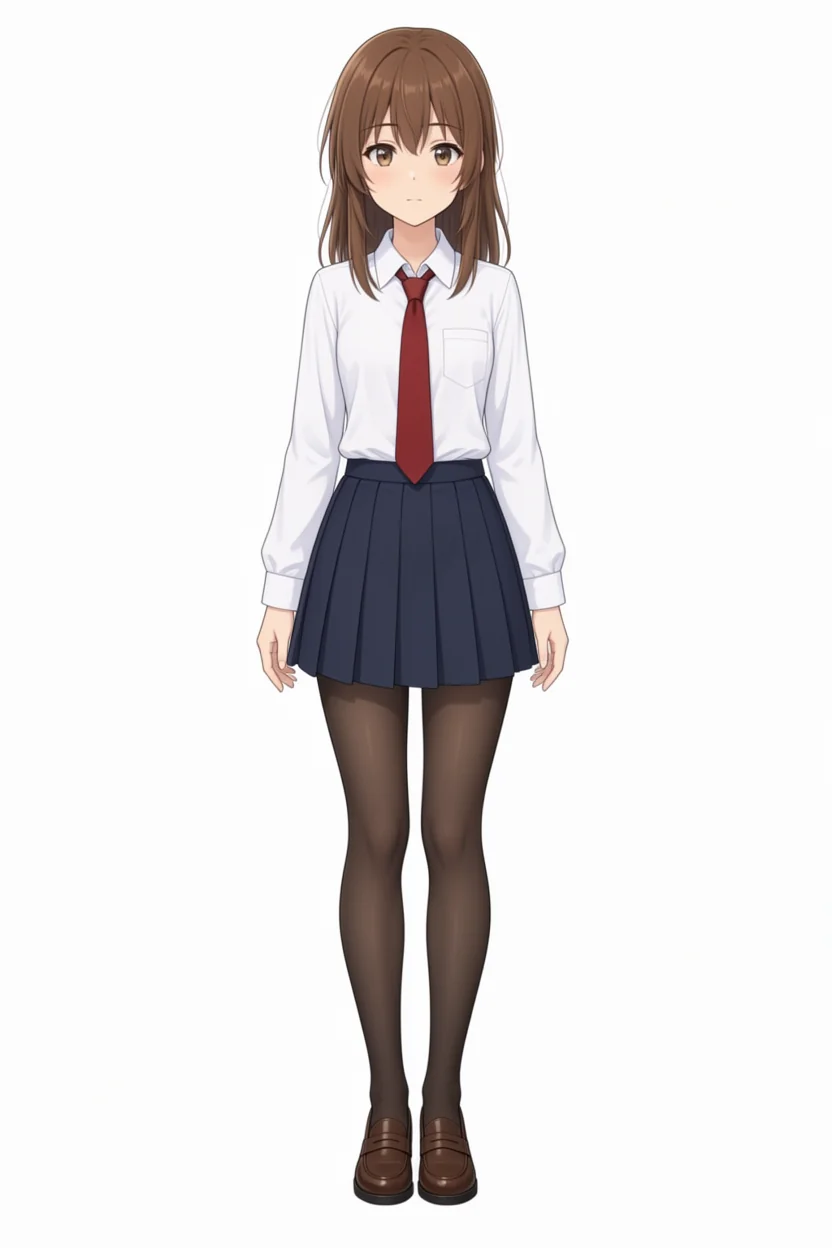
750ステップのp1。
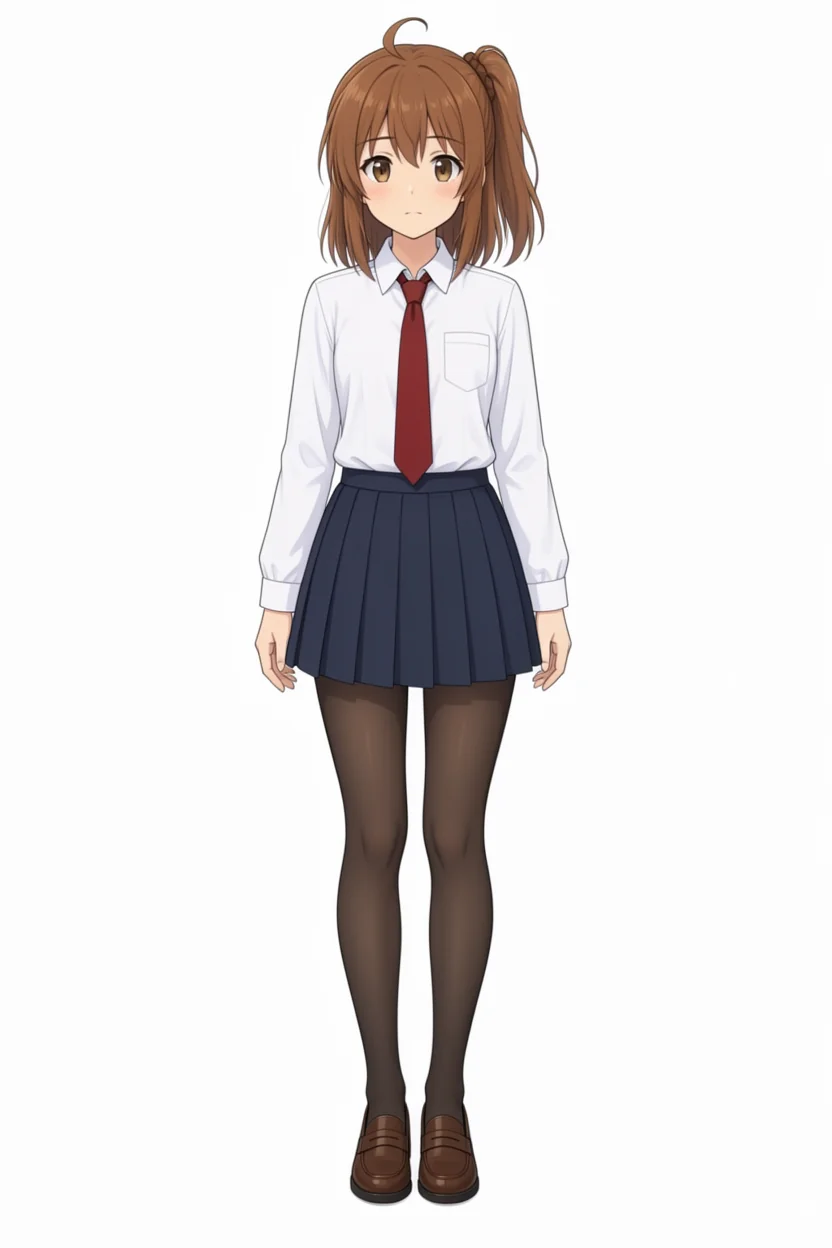
LoRAなしのp2。
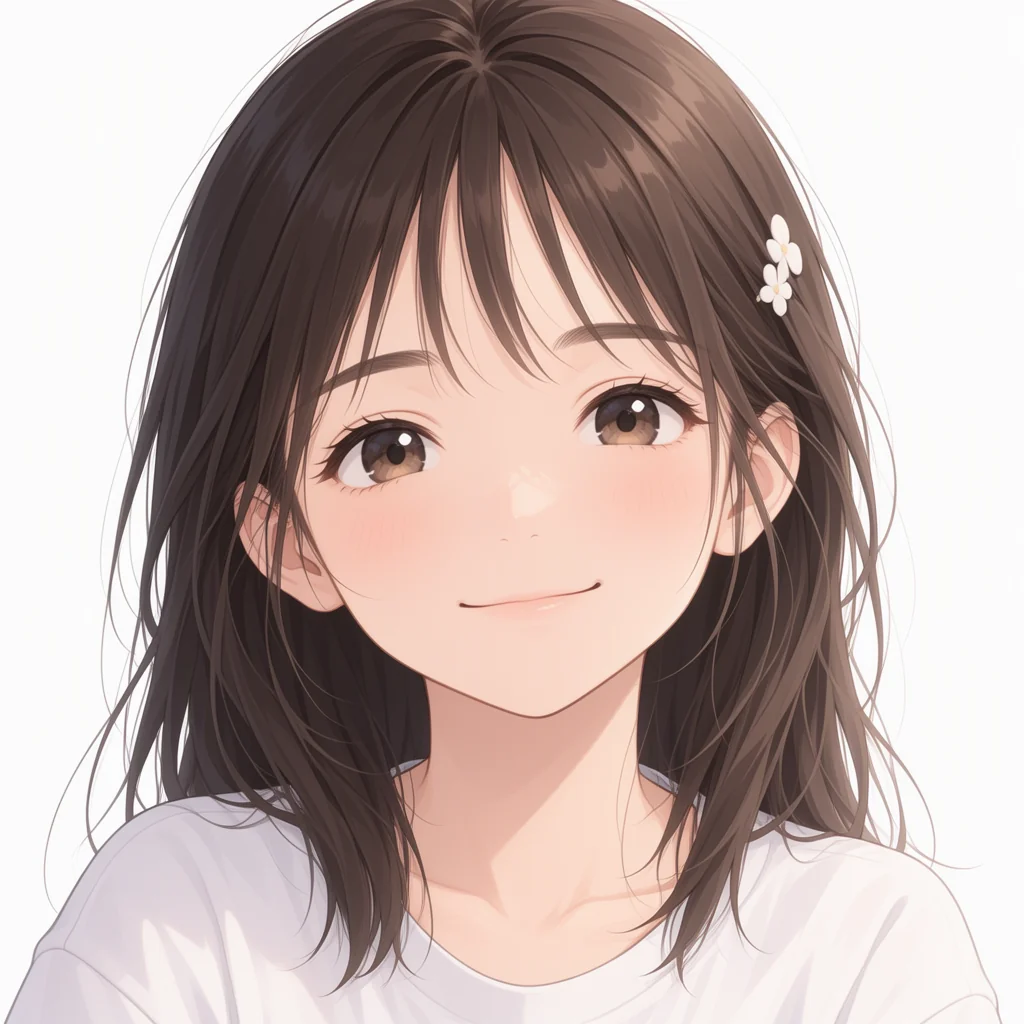
250ステップのp2。
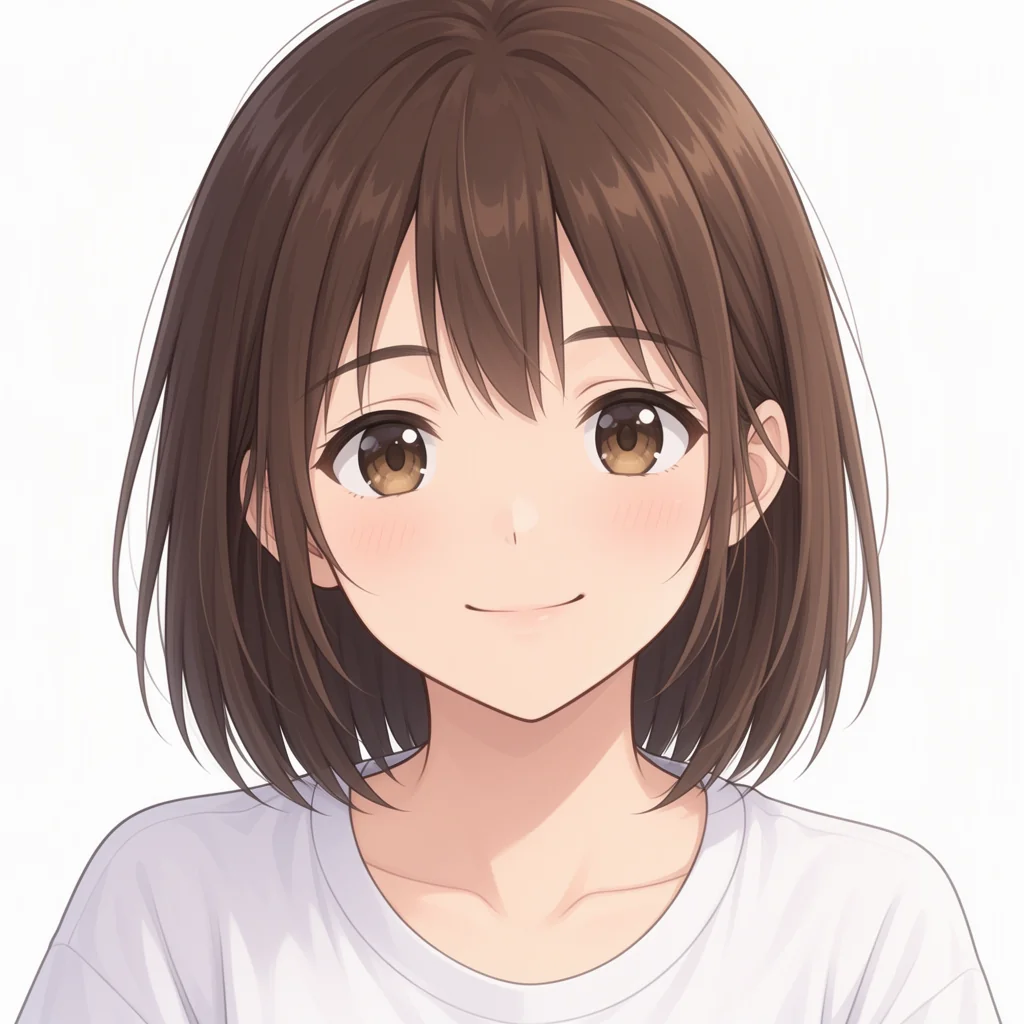
500ステップのp2。
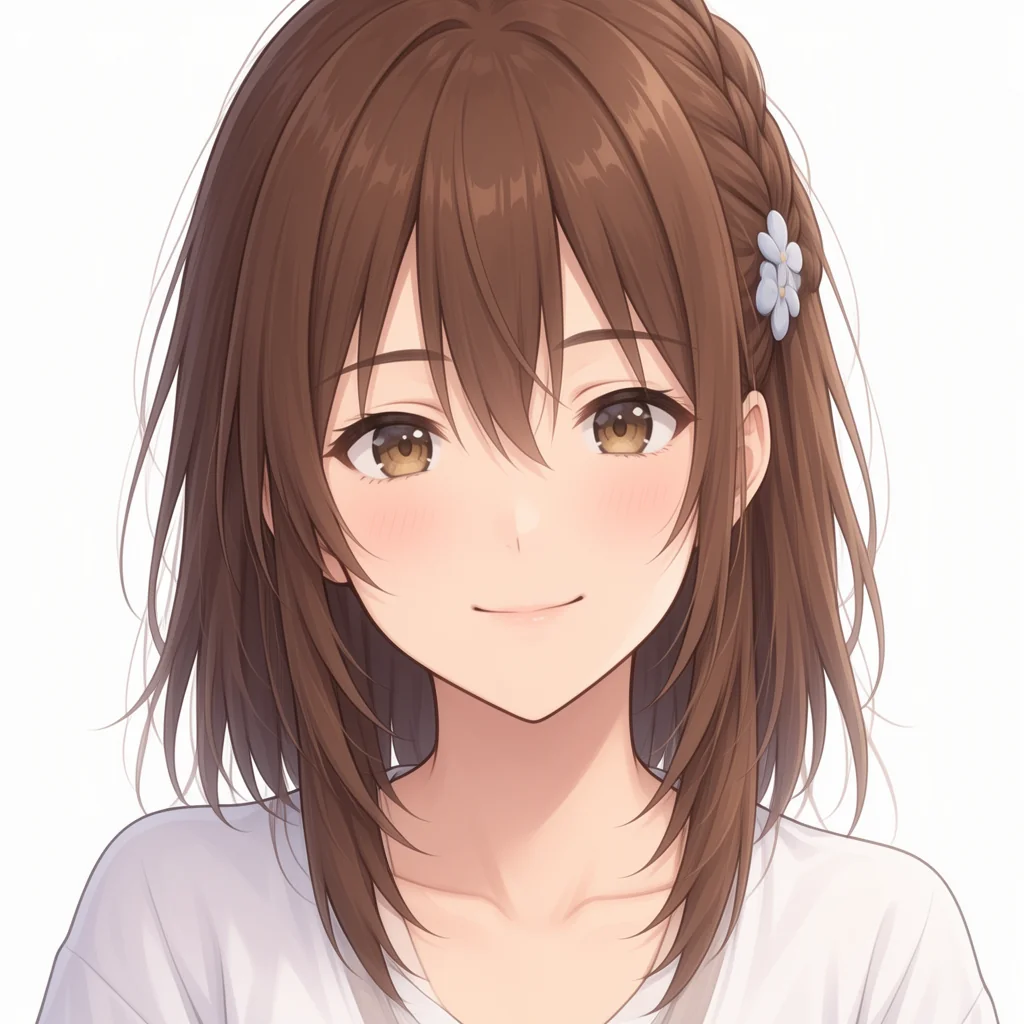
750ステップのp2。
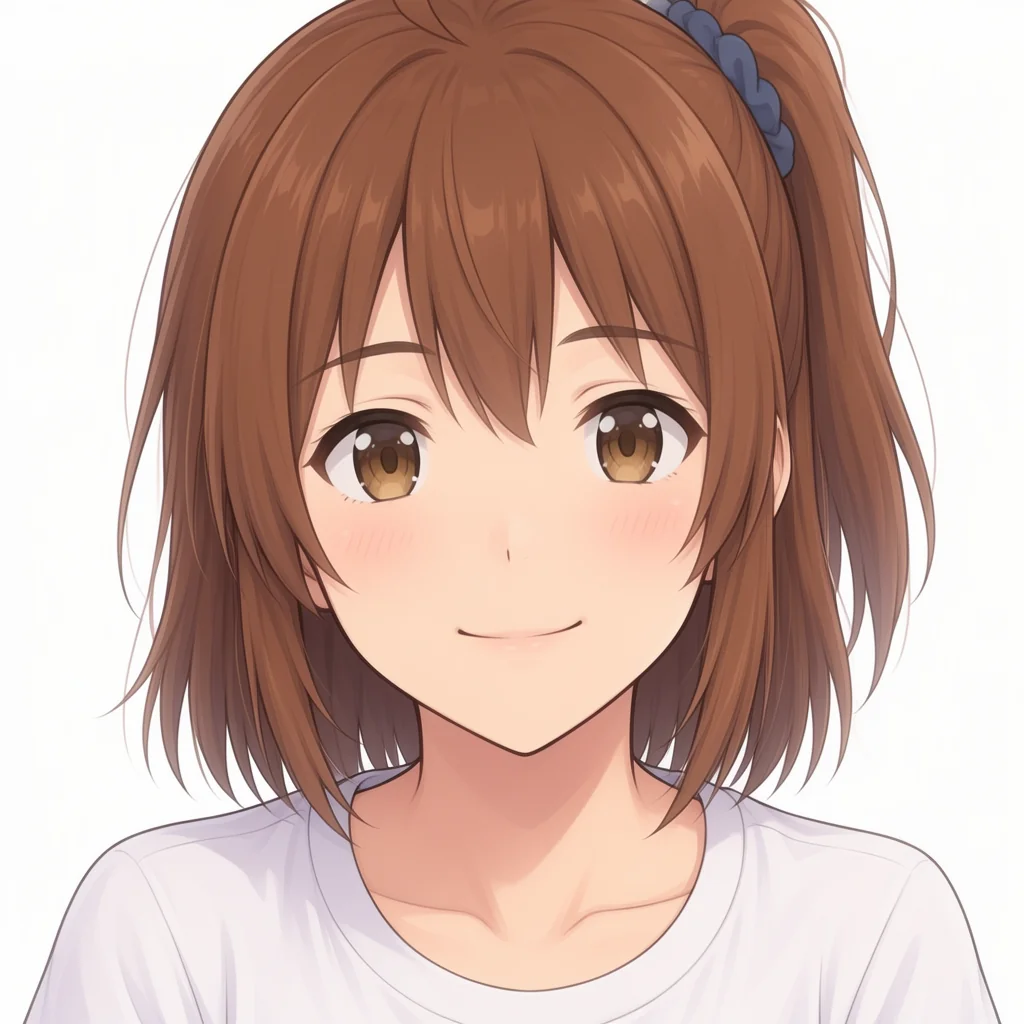
LoRAなしのp3。
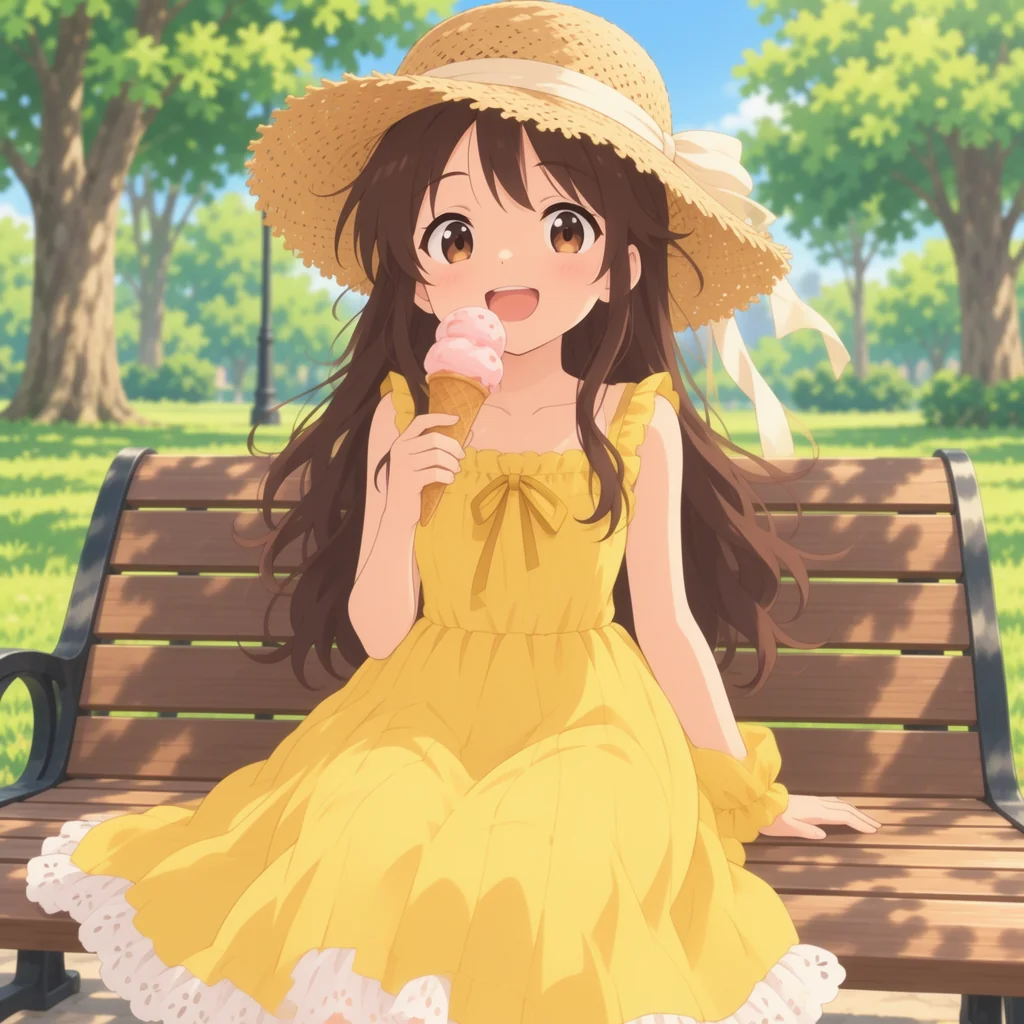
250ステップのp3。
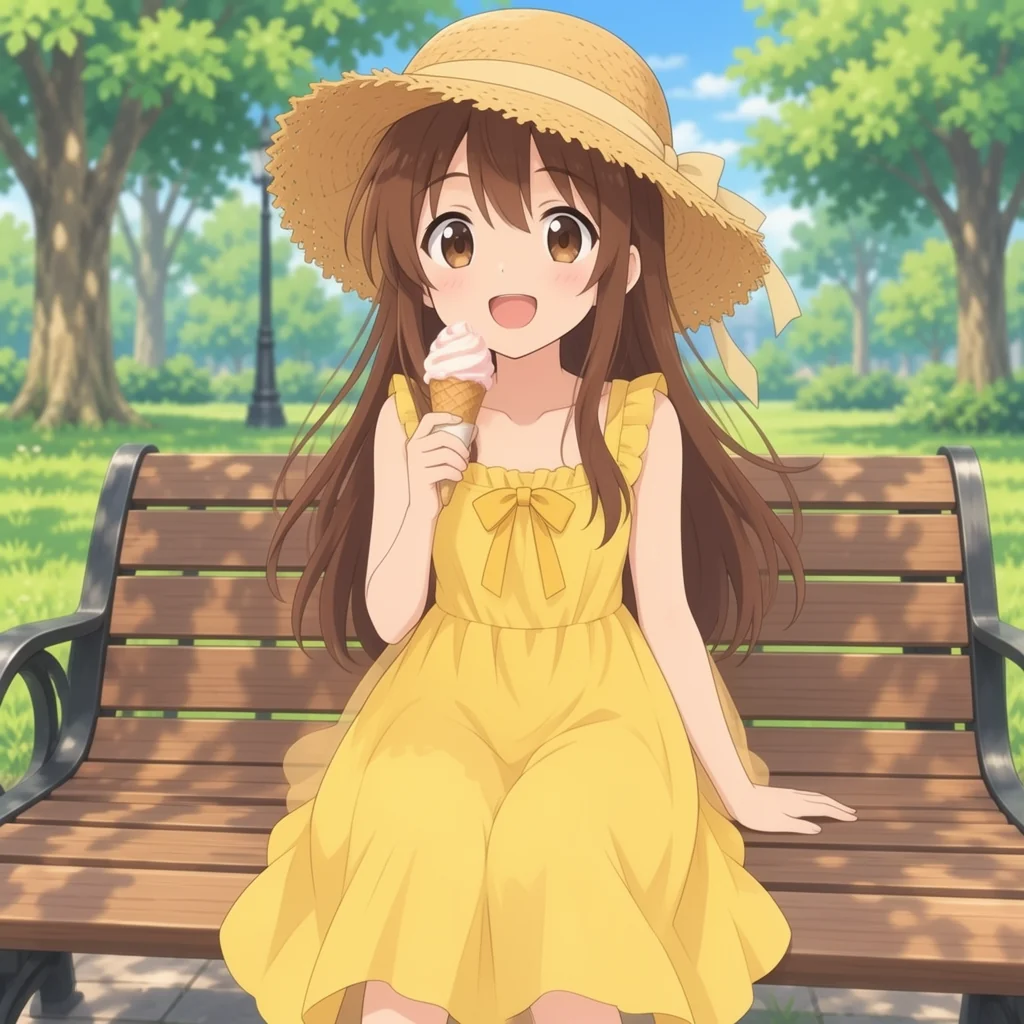
500ステップのp3。
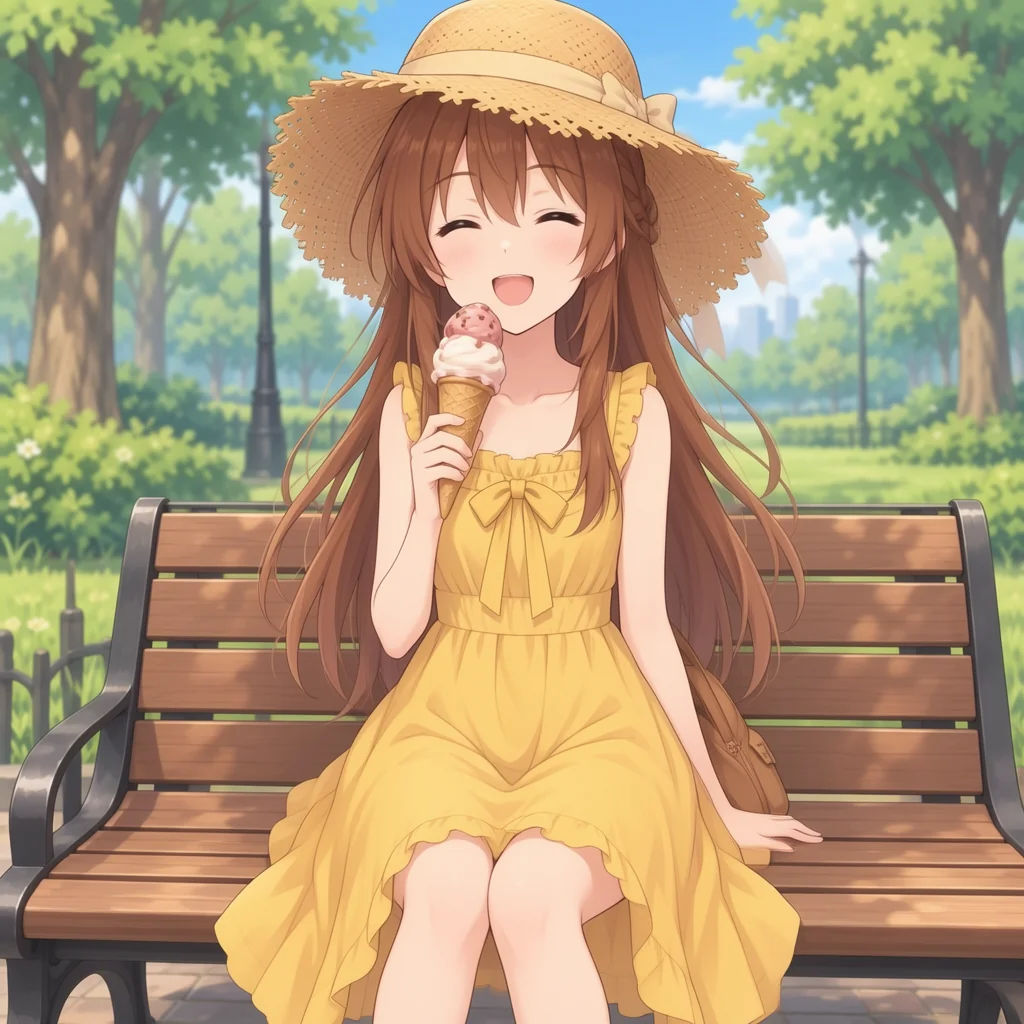
750ステップのp3。
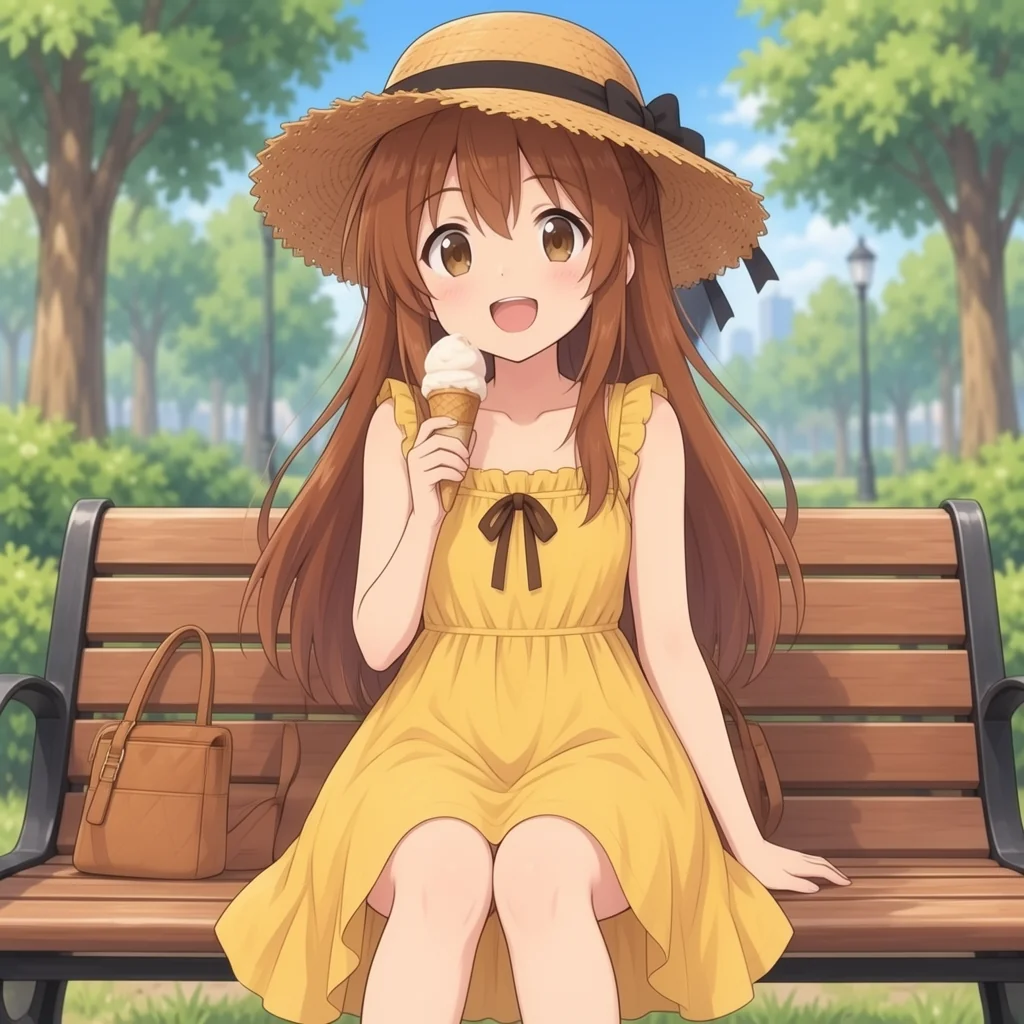
750ステップ(約10.7エポック)で、学習画像にある構図では髪型の特徴が出はじめた。学習画像にない場面のp3では再現できていない。
各条件1枚、seedも1つだけなので、揺れと区別できていない。Baseで学習したLoRAをSFTと4ステップLoRAへ適用できることは、この12枚で確認できた。
保存間隔を100にして再開した
設定ファイルの save_every を250から100へ、max_step_saves_to_keep を12から40へ変え、同じコマンドで起動し直した。steps: 2000 はそのまま。
ai-toolkitは出力フォルダーにある最新の保存(750ステップのLoRAと optimizer.pt)を読み、進捗表示は750/2000から始まった。保存ファイルのメタデータには {"step": 500, "epoch": 7} のようにステップ数が入っている。
| 項目 | 結果 |
|---|---|
| 学習を止めていた時間 | 10時45分13秒から10時56分56秒まで、約12分 |
| 再開の準備 | 起動から最初のステップまで約2分。初回の約9分より短い。テキスト埋め込みとlatentのキャッシュが残っているため |
| 再開後の1ステップ | 34.3〜36.4秒(最初の3ステップ) |
以降の保存は800、900と100刻みで、2000まで続く。
2000ステップで足りなかった場合も、steps を増やして起動し直せば同じ仕組みで続きから回せる見込みだが、2000を超える再開はまだ試していない。
メモリ不足とDataLoaderワーカーの停止
750ステップから再開した直後、GTT使用量がこれまでの上限(約41GB)で止まらず、5段目まで上がった。
| 時刻 | ステップ | GTT使用量 | 空きメモリ | スワップ使用量 |
|---|---|---|---|---|
| 10時58分 | 750 | 20.6GB | 26.9GB | 1.35GB |
| 10時59分 | 752 | 27.5GB | 20.2GB | 1.36GB |
| 11時0分 | 754 | 34.2GB | 13.7GB | 1.37GB |
| 11時5分 | 763 | 41.0GB | 6.9GB | 1.37GB |
| 11時8分 | 767 | 47.7GB | 1.0GB | 1.95GB |
| 11時9分 | 769 | 54.4GB | 0.8GB | 8.30GB |
| 11時10分 | 770 | 20.8GB | 33.9GB | 8.38GB |
11時9分の時点でGTTが54.4GB、空きメモリが0.8GB、スワップは8GBのほぼ全部が埋まった。その1分後にGTTが20.8GBへ下がり、学習は落ちずに続いた。保存のタイミングではないのに下がった理由は確かめていない。
空きメモリが1GBを切ったところでプロセスを調べると、DataLoaderのワーカープロセス2つが、それぞれRSS 10.6GBを持ったまま止まっていた。CPU時間は0秒で、仕事はしていない。学習本体のRSSは2.0GBだった。
GTT 47.7GB、本体2.0GB、ワーカー10.6GBを足すと約60.3GBで、その時点の使用中メモリ59.9GBとほぼ合う。2つのワーカーは同じ内容を共有していて、合わせて約10.6GBを占めていたことになる。
中身は確かめていないが、テキストエンコーダーを読み込んでいる間に分岐した子プロセスに、その分のメモリが残ったと推測している。本体は埋め込みをキャッシュしたあとテキストエンコーダーを解放するが、子プロセス側のコピーは残る。
latentもテキスト埋め込みもディスクにキャッシュ済みで、バッチサイズは1なので、ワーカーを使う意味はほとんどない。
800ステップ目の保存(11時27分)を待ってから学習を止め、データセット設定に num_workers: 0 を足して再開した。ai-toolkitの既定値は2。
| 項目 | ワーカー2(既定) | ワーカー0 |
|---|---|---|
| 学習に関わるプロセス | 本体と、RSS 10.6GBのワーカー2つ | 本体だけ(RSS 2.6GB) |
| GTTが約27.5GBのときの空きメモリ | 17.5〜20.2GB | 30.0GB |
| 1ステップ | 約35秒 | 34.6〜34.9秒(最初の3ステップ) |
空きメモリは約10GB増え、1ステップの時間は変わらなかった。止めていたのは11時29分10秒からの約2分で、進捗表示は800/2000から始まった。
先行作業の計測と手順5で見ていた「最大RSS 27GB前後」は、テキストエンコーダーを読み込んでいる間の値で、学習中の本体のRSSは2〜2.6GBしかない。学習中にメモリを使っているのはGPU側(GTT)と、このワーカーだった。
ワーカー0でもGTTは上限まで増えるが、学習は落ちなかった
再開後のGTT使用量と空きメモリの動き。
| 時刻 | ステップ | GTT使用量 | 空きメモリ | できごと |
|---|---|---|---|---|
| 11時31分 | 803 | 27.8GB | 30.7GB | 再開直後 |
| 12時1分 | 約855 | 48.2GB | 10.8GB | |
| 12時28分 | 約900 | 20.9GB | 37.5GB | 900ステップ目の保存の直後 |
| 12時46分 | 約932 | 54.5GB | 4.3GB | |
| 12時56分32秒 | 951 | 57.9GB | 1.0GB | 保存はしていない |
| 12時56分45秒 | 951 | 20.6GB | 37.7GB | 保存はしていない |
12時56分には空きメモリが1.0GBまで減ったが、13秒後に見るとGTTは20.6GBへ戻っていて、学習は951ステップ目から続いていた。スワップは1.9GBから2.7GBに増えただけだった。11時9分に見た「保存なしでGTTが下がる」動きと同じで、これで2回目。
GTTは保存のときのほかに、メモリが尽きかけたときにも解放されている。解放しているのがPyTorchのメモリ確保の再試行なのか、ドライバー側なのかは確かめていない。
このとき、Claude Code側で動かしていた終了待ちの監視コマンドは、メモリ不足を理由にClaude Codeに止められた。学習と60秒ごとの計測は止まっていない。
また、手順7の再開のときに起動した計測スクリプトが1つ残っていて、11時29分以降の計測ファイルに古いログのステップ番号(802)の行を重複して書いていた。12時57分に止めた。集計ではこの行を除く。
増えているのはPyTorchが抱えている空きブロックらしい
ai-toolkitのコードを見ると、保存処理(jobs/process/BaseSDTrainProcess.py の save())は最初に flush() を呼び、flush()(toolkit/basic.py)は torch.cuda.empty_cache() を呼んでいる。保存のたびにGTTが下がるのはこれで説明がつく。
empty_cache() が返すのは、PyTorchが使い終わったあとも再利用のために確保したままにしているGPUメモリで、計算に使っている最中のテンソルではない。学習中に増えていた分の大半は、この再利用待ちのメモリだったことになる。
保存していないのに下がった2回(11時9分、12時56分)は、PyTorchがメモリ確保に失敗したときに再利用待ちのメモリを解放してやり直す動きと合う。ただし torch.cuda.memory_reserved() と memory_allocated() を学習中に読んで確かめたわけではないので、ここは推測。
段階的に増える理由も確かめていない。画像の解像度が8種類あり、必要なブロックの大きさがステップごとに変わるので、前のブロックを使い回せずに新しく確保している可能性がある。
Turbo LoRAとの併用確認
学習の途中で、1300ステップ目の保存を別のPCへ持っていき、Turbo LoRAと併用して生成した。画像は出た。1300の時点ではキャラの固定がまだ怪しい。別PCの生成環境と設定はここには未記録。
EVO-X2側の見本(手順7)も、MOSS-Image SFTに4ステップLoRA(moss_image_sft_4step_v2.0)を重ねて出している。Baseで学習したLoRAが、蒸留LoRAと重ねた少ステップ生成でも反映されることは両方で確認できた。蒸留LoRAなしの通常生成は、まだ試していない。
2000ステップまでの学習結果
2026年11月15日23時2分に2000ステップ目まで終わった。終了コードは0。
| 項目 | 値 |
|---|---|
| 開始〜終了 | 3時23分〜23時2分(約19時間40分。停止と再開2回、見本出しの時間を含む) |
| 1〜752ステップの実行時間 | 7時間22分26秒 |
| 800〜2000ステップの実行時間 | 11時間33分22秒(準備を含む。進捗表示では11時間32分44秒) |
| 1ステップ | 50ステップごとの平均で33.9〜35.2秒。951ステップ目を含む区間だけ38.5秒 |
| 保存 | 250、500、750、800〜1900を100刻み、最終の2000。1個74MB |
| 学習中の本体RSS(800以降) | 最大2.6GB |
| プロセスの最大RSS(800以降、準備を含む) | 16.1GB |
| GTT使用量(800以降) | 17.5〜57.9GB、平均37.3GB |
| 空きメモリの最小 | 1.0GB(951ステップ目) |
| スワップ使用量の最大(800以降) | 2.8GB |
| GPU(800以降) | 使用率99.9%、平均66.4℃、最大71℃、平均85.1W |
1ステップの時間は最初から最後まで変わらなかった。進捗バーの表示は直近の値なので、小さい解像度の画像が続くと速く見える。
100ステップごとの区間で見た、GTT使用量の最大と空きメモリの最小。
| 区間 | GTTの最大 | 空きメモリの最小 |
|---|---|---|
| 800〜900 | 48.2GB | 10.7GB |
| 900〜1000 | 57.9GB | 1.0GB |
| 1000〜1100 | 34.5GB | 24.4GB |
| 1100〜1200 | 41.5GB | 17.4GB |
| 1200〜1300 | 42.0GB | 16.8GB |
| 1300〜1400 | 28.1GB | 30.4GB |
| 1400〜1500 | 54.7GB | 4.3GB |
| 1500〜1600 | 48.0GB | 10.9GB |
| 1600〜1700 | 54.9GB | 4.2GB |
| 1700〜1800 | 41.5GB | 17.3GB |
| 1800〜1900 | 34.8GB | 23.9GB |
| 1900〜2000 | 41.5GB | 17.5GB |
どこまで増えるかは区間ごとにばらばらで、空きが5GBを切った区間が3つあった。
損失を250ステップごとにまとめた値。
| 区間 | 平均 | 中央値 |
|---|---|---|
| 1〜249 | 0.304 | 0.256 |
| 250〜499 | 0.281 | 0.239 |
| 500〜749 | 0.290 | 0.238 |
| 750〜999 | 0.298 | 0.235 |
| 1000〜1249 | 0.280 | 0.219 |
| 1250〜1499 | 0.280 | 0.221 |
| 1500〜1749 | 0.264 | 0.213 |
| 1750〜1999 | 0.281 | 0.213 |
750〜999の区間は、再開で捨てた分があるので203ステップ分。中央値はゆるく下がり、1500以降はほぼ同じだった。
800〜2000の見本
手順7と同じ3つのプロンプト、seed 42、MOSS-Image SFTと4ステップLoRAで、800から2000まで100刻みの13個を出した。39枚とも1枚48〜52秒で、学習したLoRAは毎回適用された。
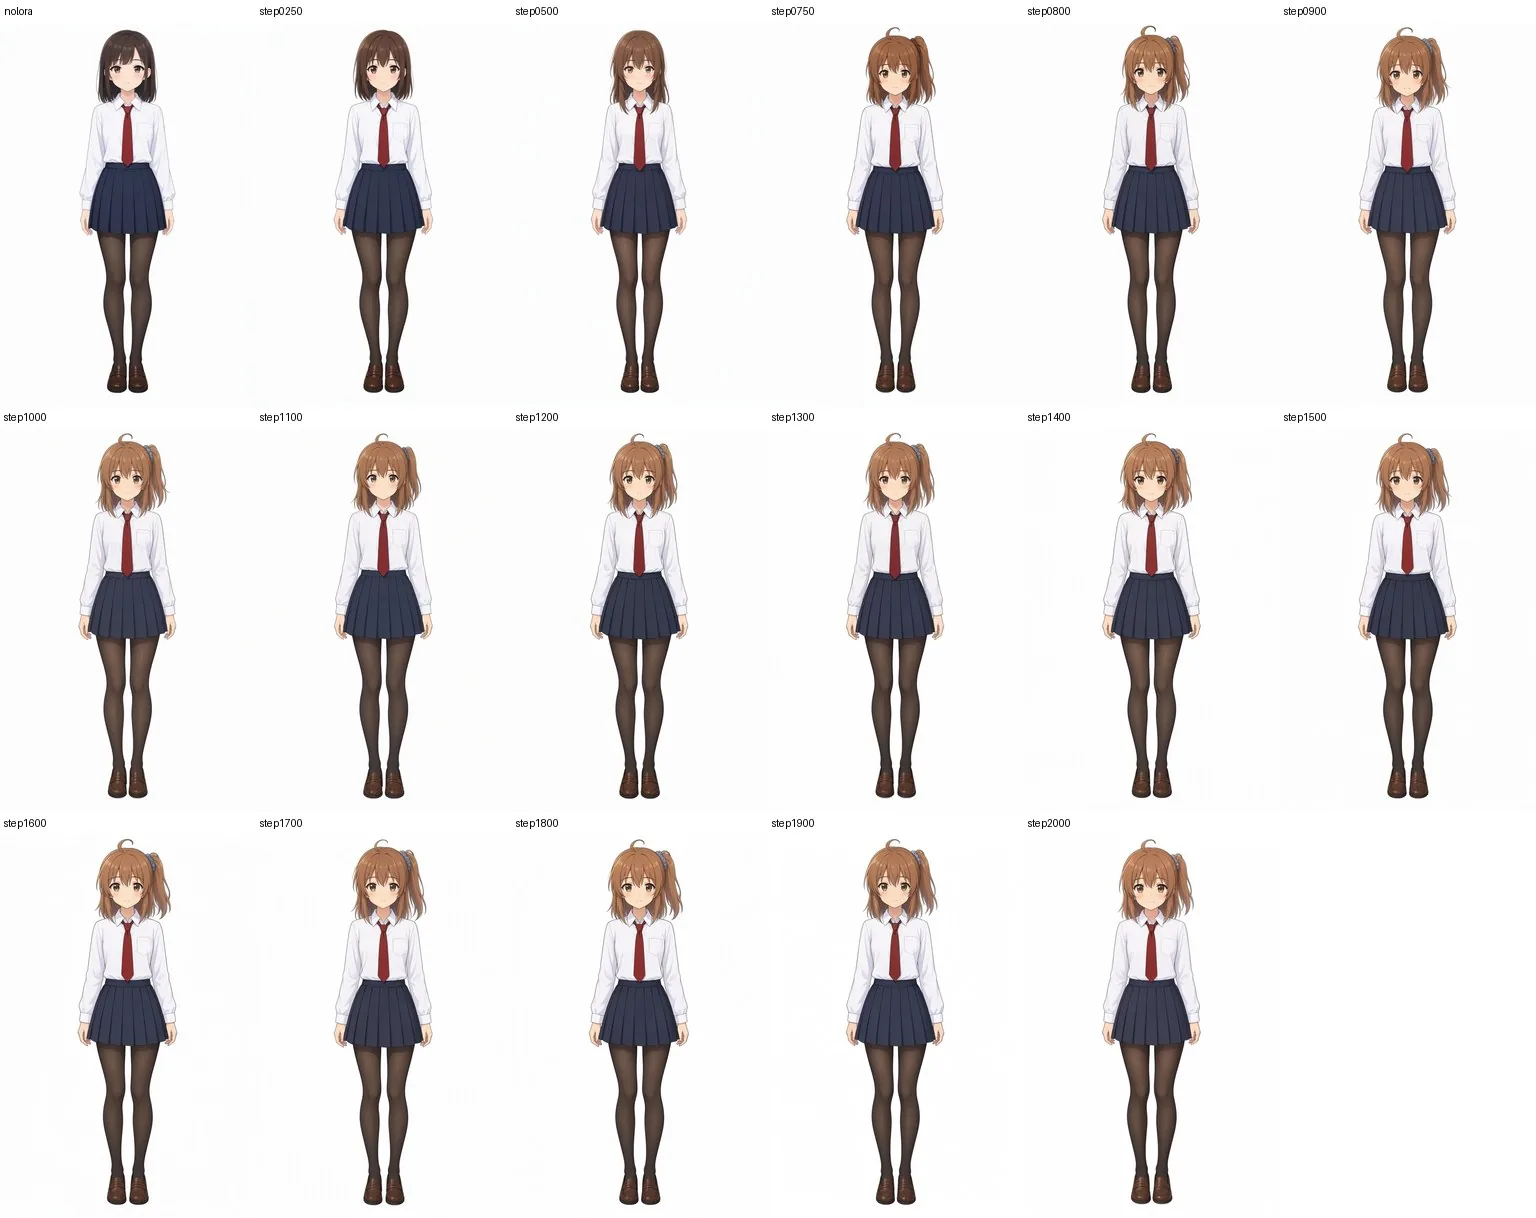
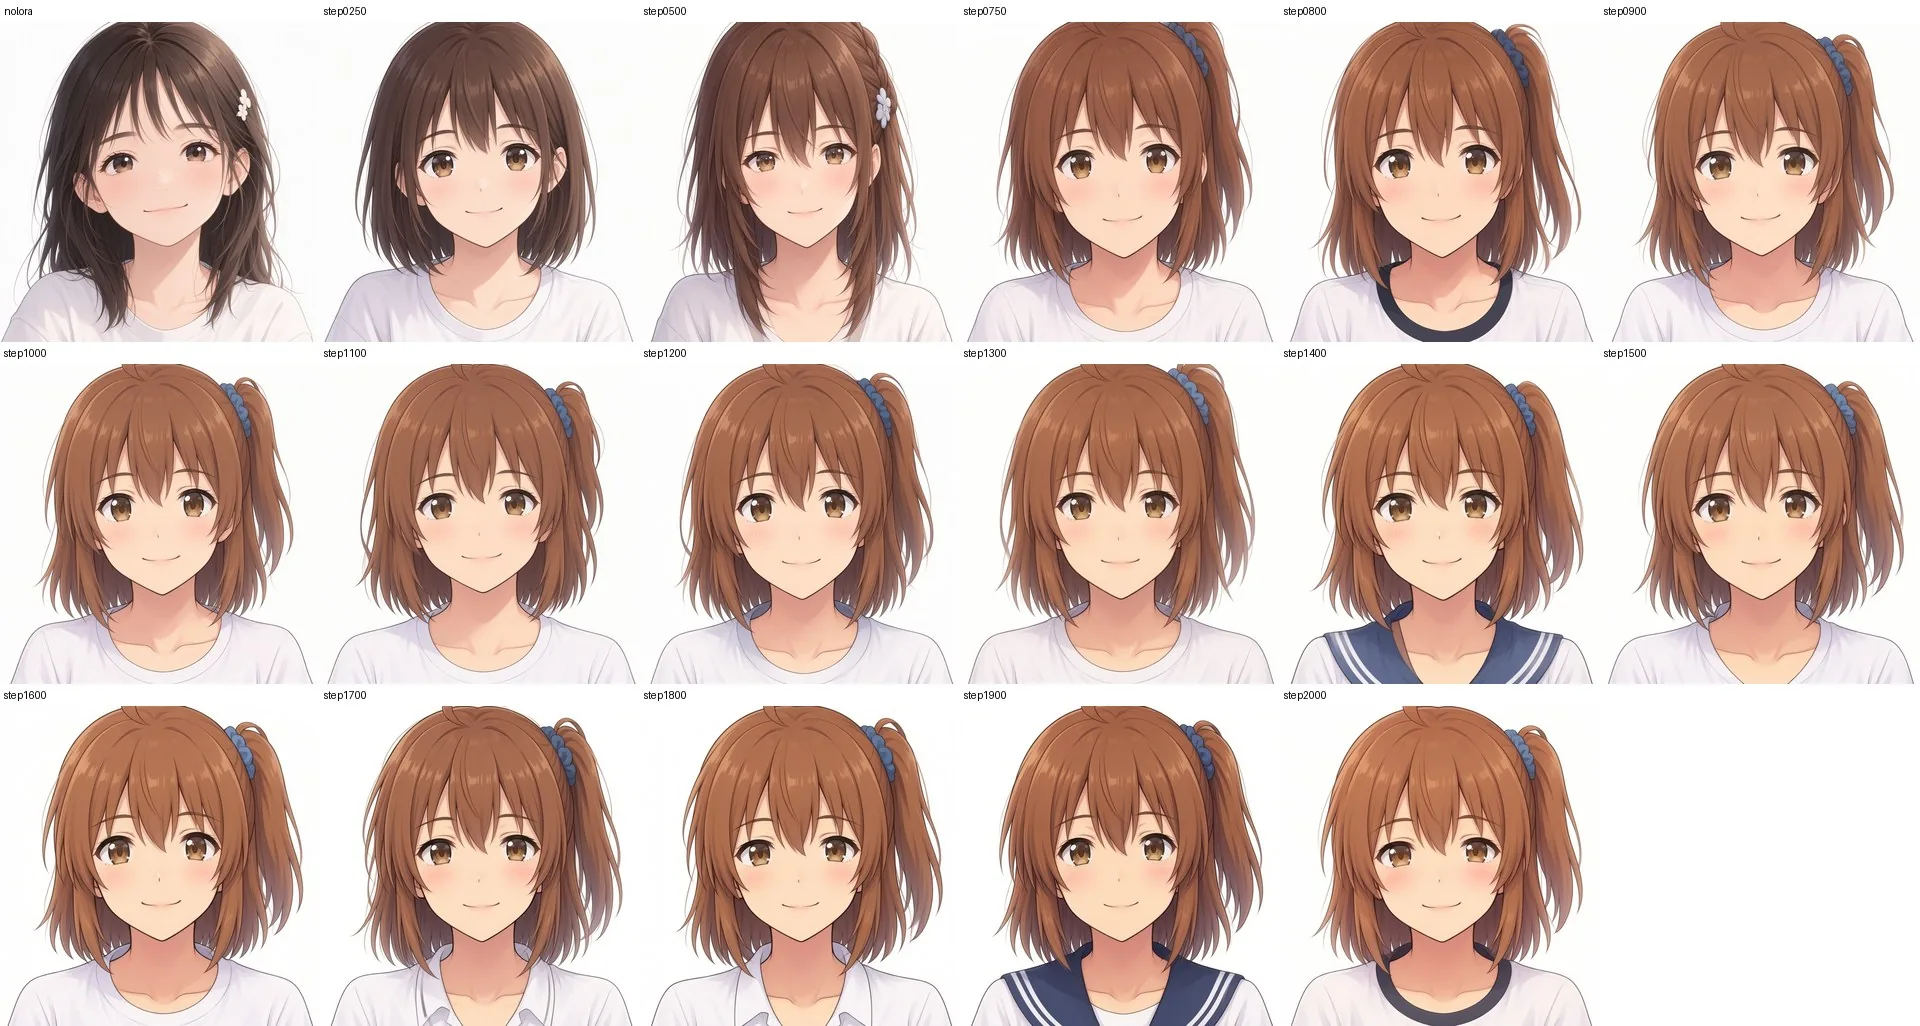
LoRAなしから2000までを1枚に並べた比較。上段の左から、LoRAなし、250、500、750、800、900。中段が1000〜1500、下段が1600〜2000。
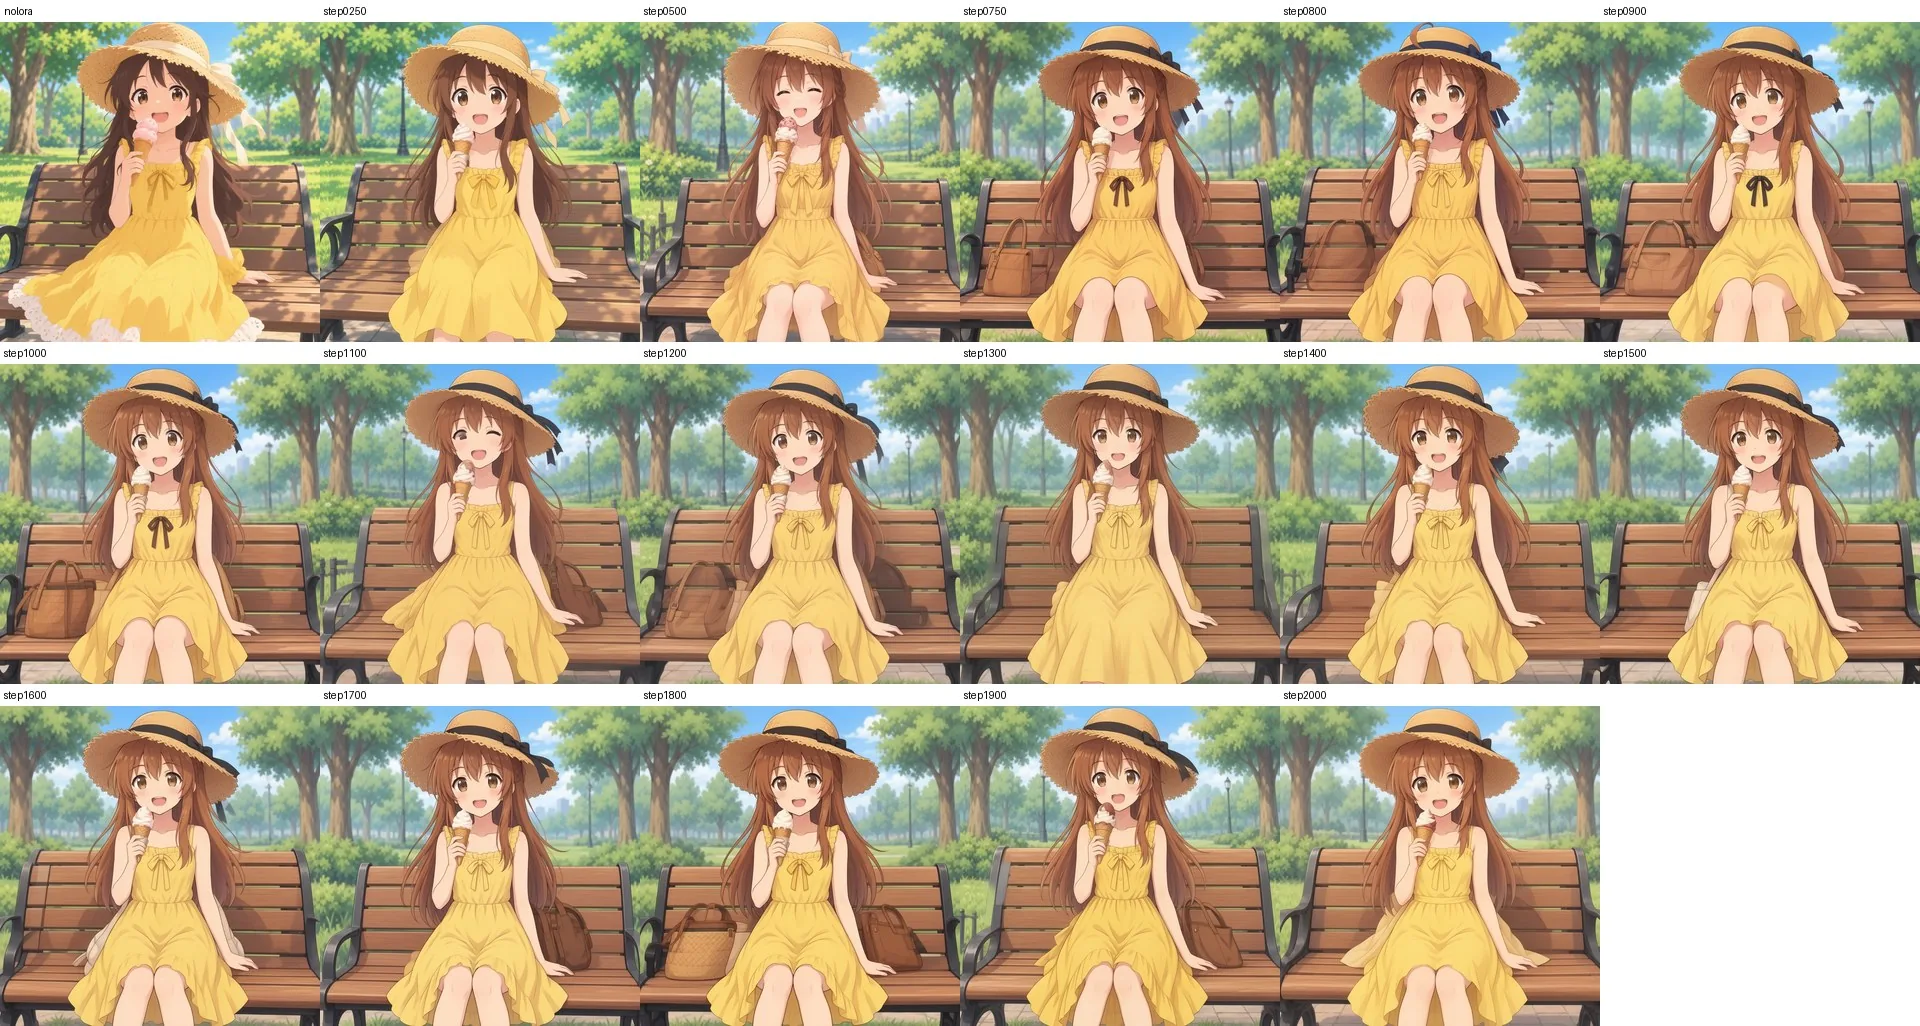
| プロンプト | 見えたこと |
|---|---|
| p1 制服の全身 | 750からサイドポニー、アホ毛、茶髪が出て、2000まで崩れない。800以降はほぼ同じ絵 |
| p2 顔のアップ | 750から青いシュシュのサイドポニーが出て、2000まで続く。服は指定していないので、白いTシャツ、セーラー服、襟付きシャツとステップごとに変わる |
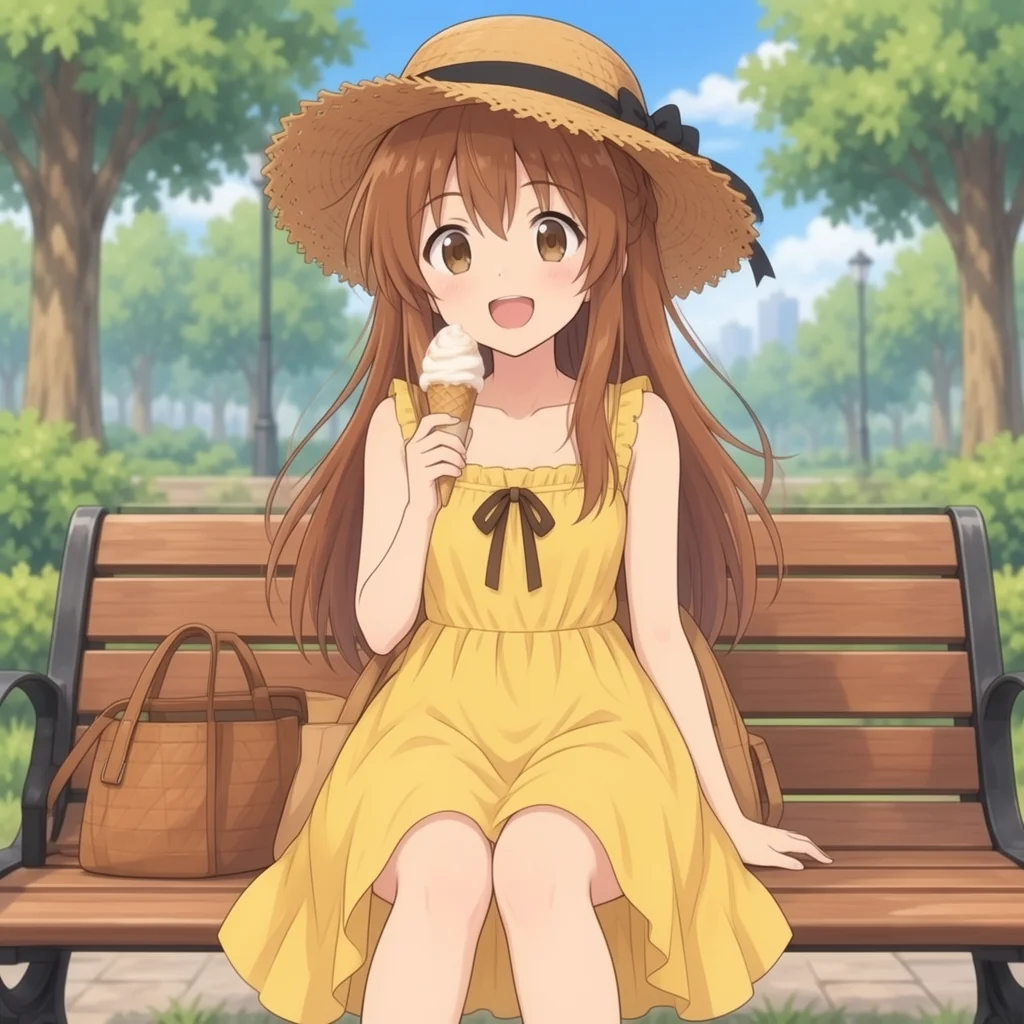
| p3 公園の場面 | 髪色は茶色になったが、髪は長く下ろしたままで、2000でもサイドポニーにならない。800だけアホ毛が出た |
p1とp2は750〜900で固まり、それ以降のステップで目に見えて良くなった点はなかった。
p3は2000まで回しても髪型が出なかった。プロンプトに麦わら帽子を入れているので、帽子が髪型を消しているのか、学習にない場面へ持ち出せていないのかは、この3つのプロンプトでは分けられない。
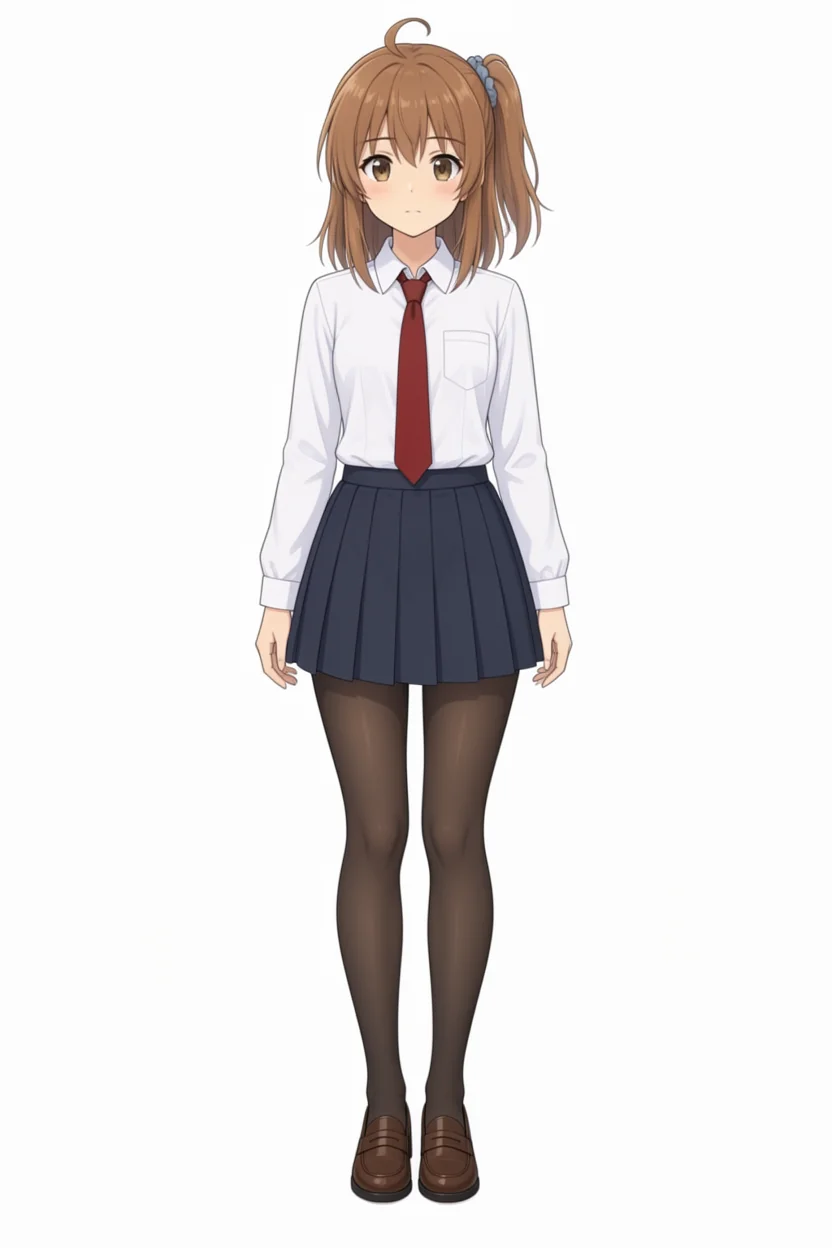
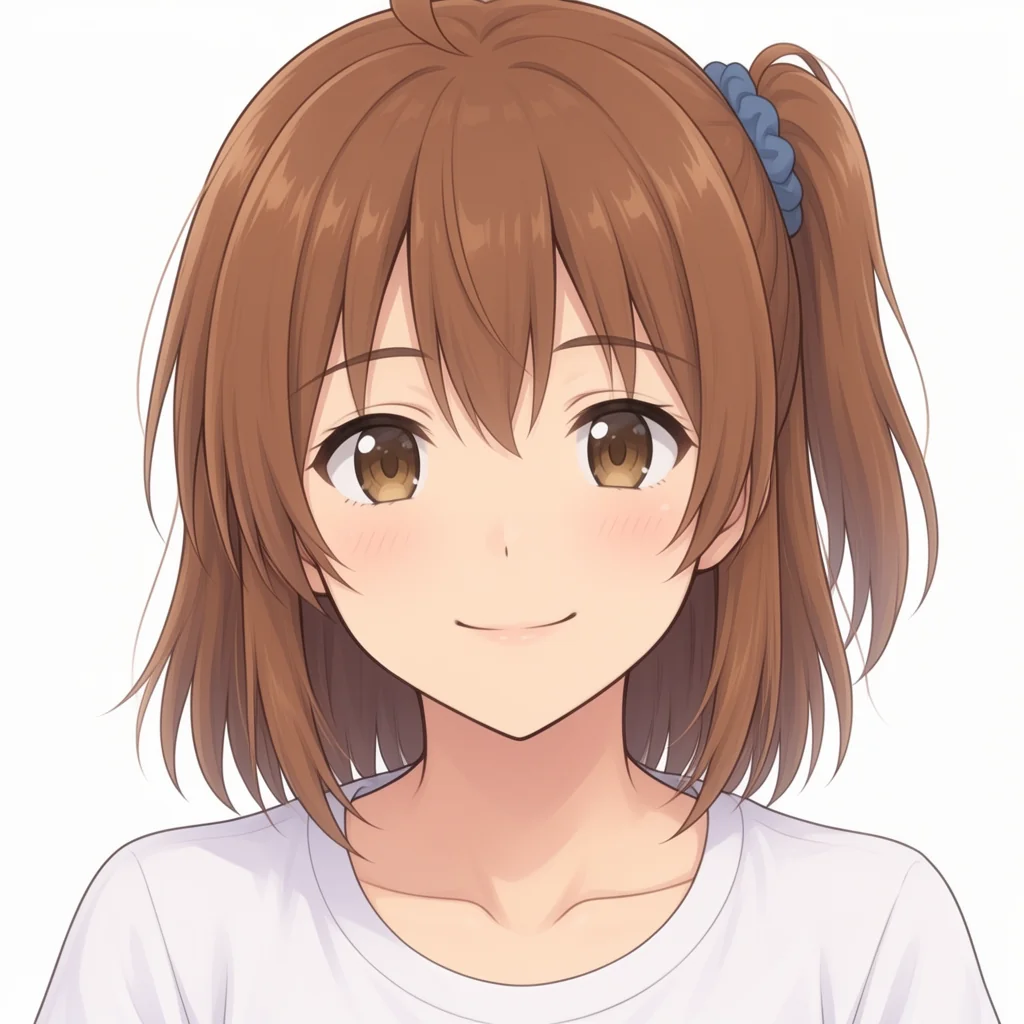
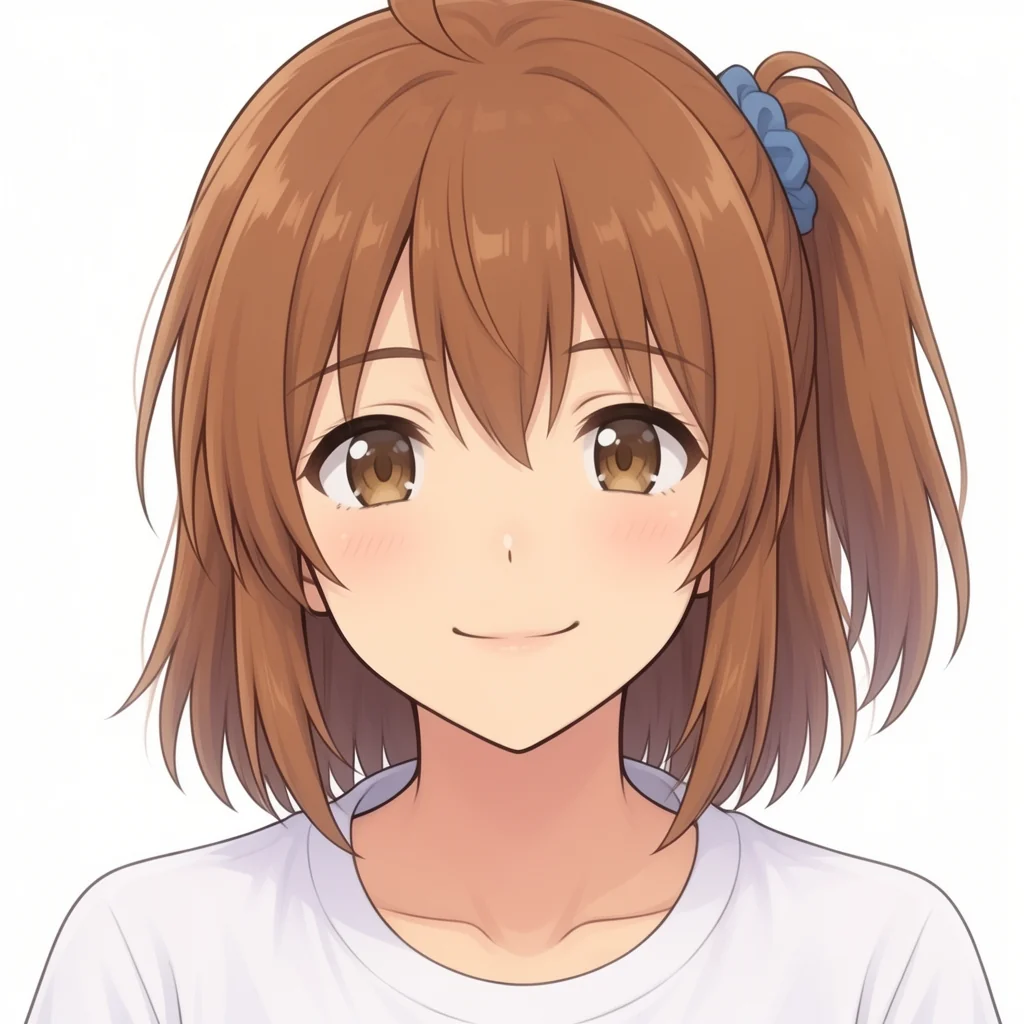
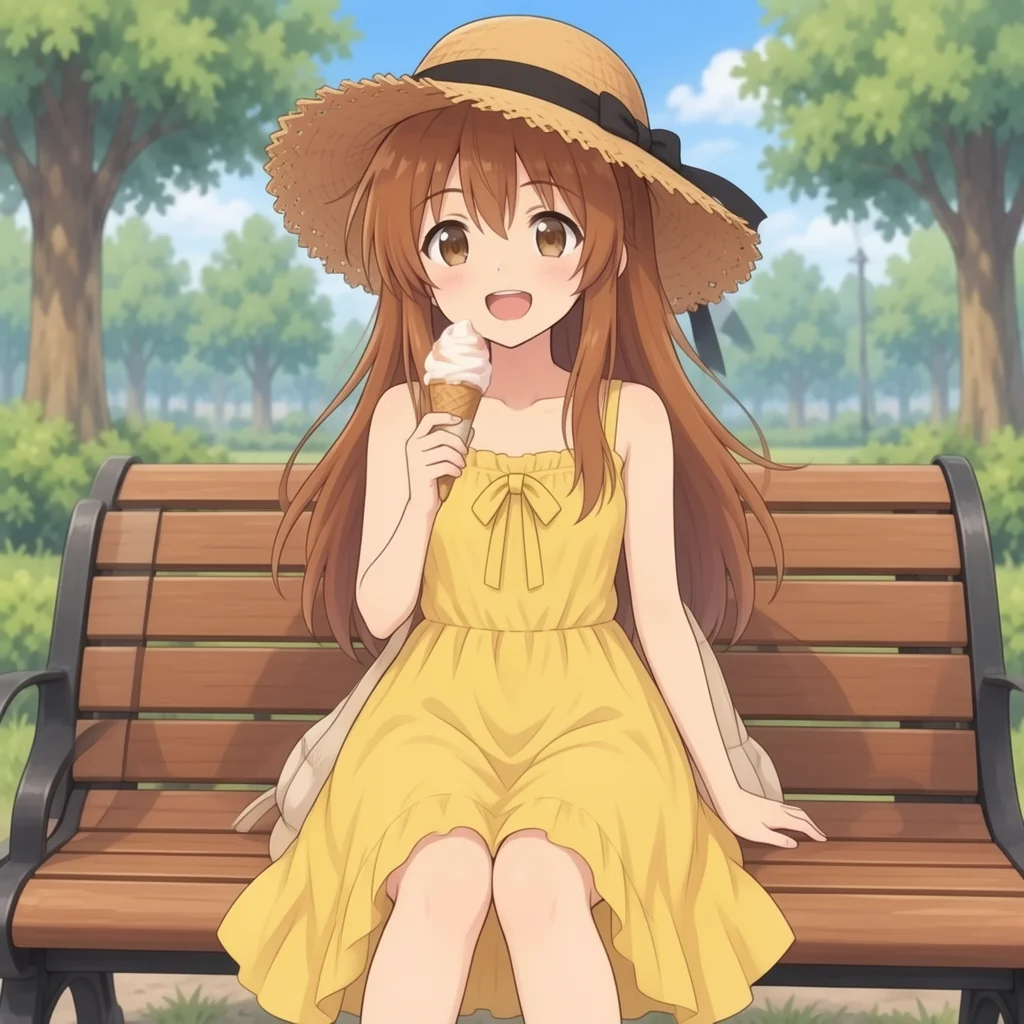
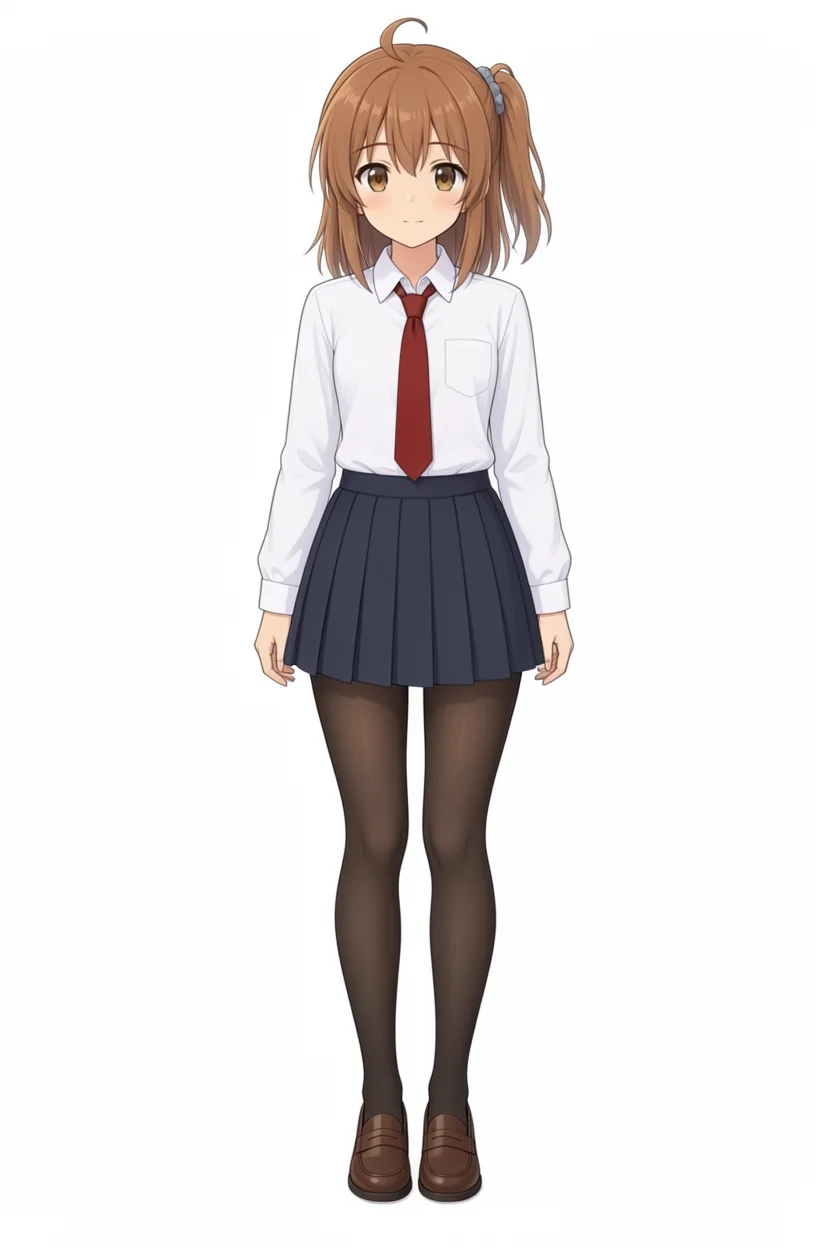
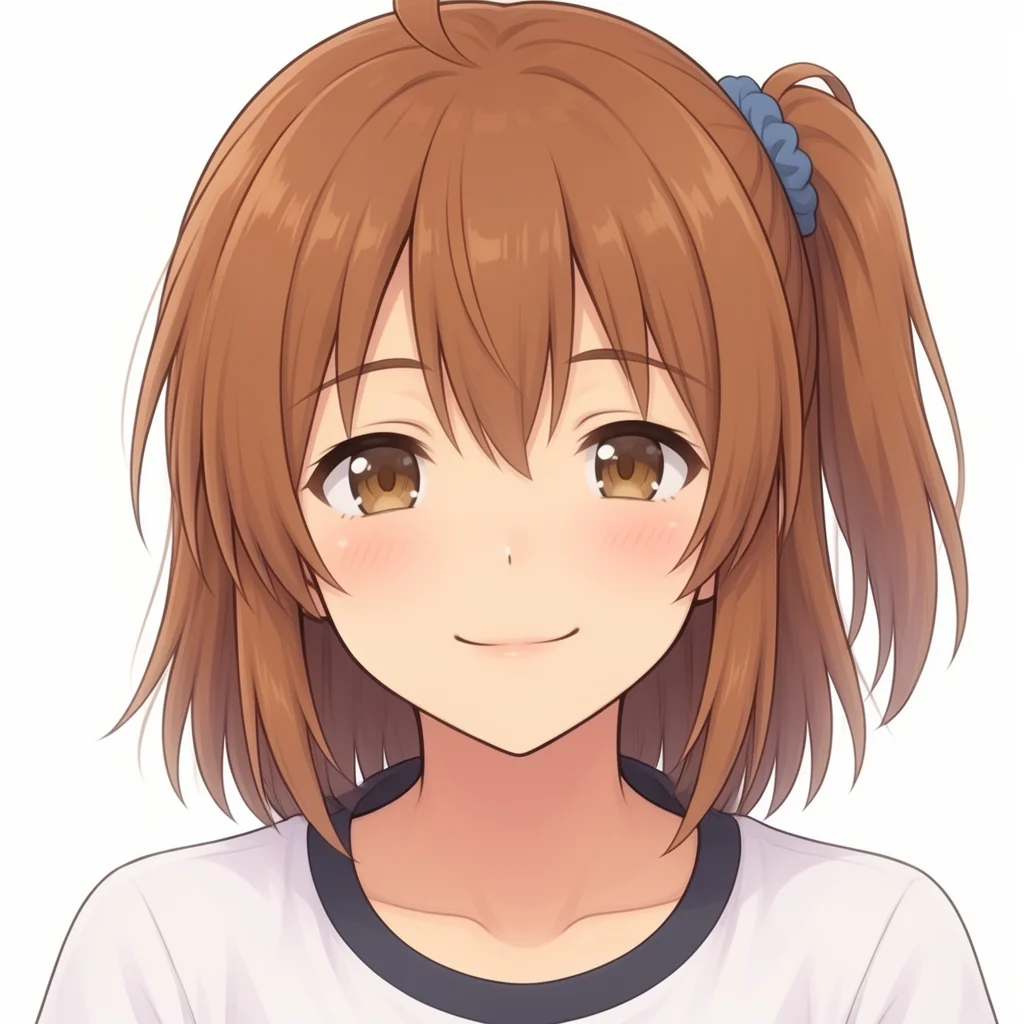
1000、1300、1600、2000の個別の画像。
| ステップ | p1 制服の全身 | p2 顔のアップ | p3 公園の場面 |
|---|---|---|---|
| 1000 | 1枚目 | 2枚目 | 3枚目 |
| 1300 | 4枚目 | 5枚目 | 6枚目 |
| 1600 | 7枚目 | 8枚目 | 9枚目 |
| 2000 | 10枚目 | 11枚目 | 12枚目 |
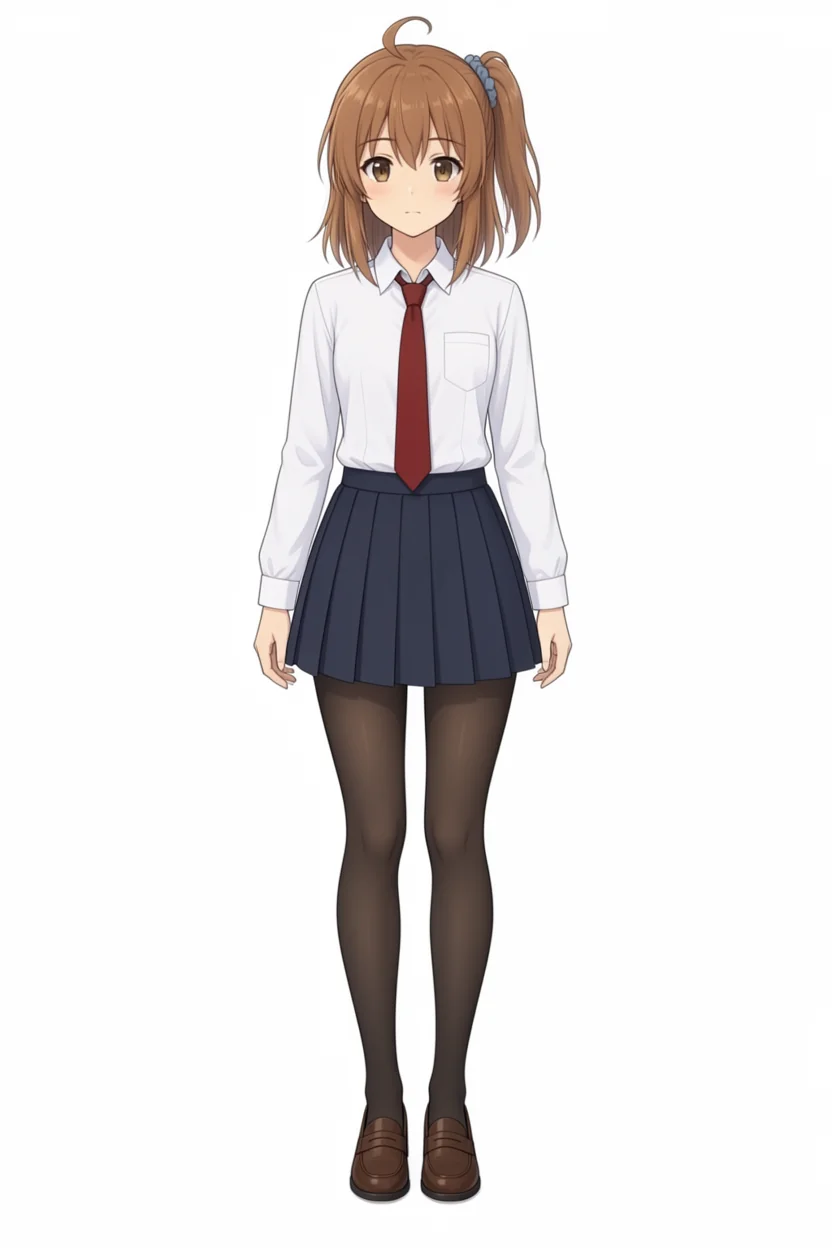
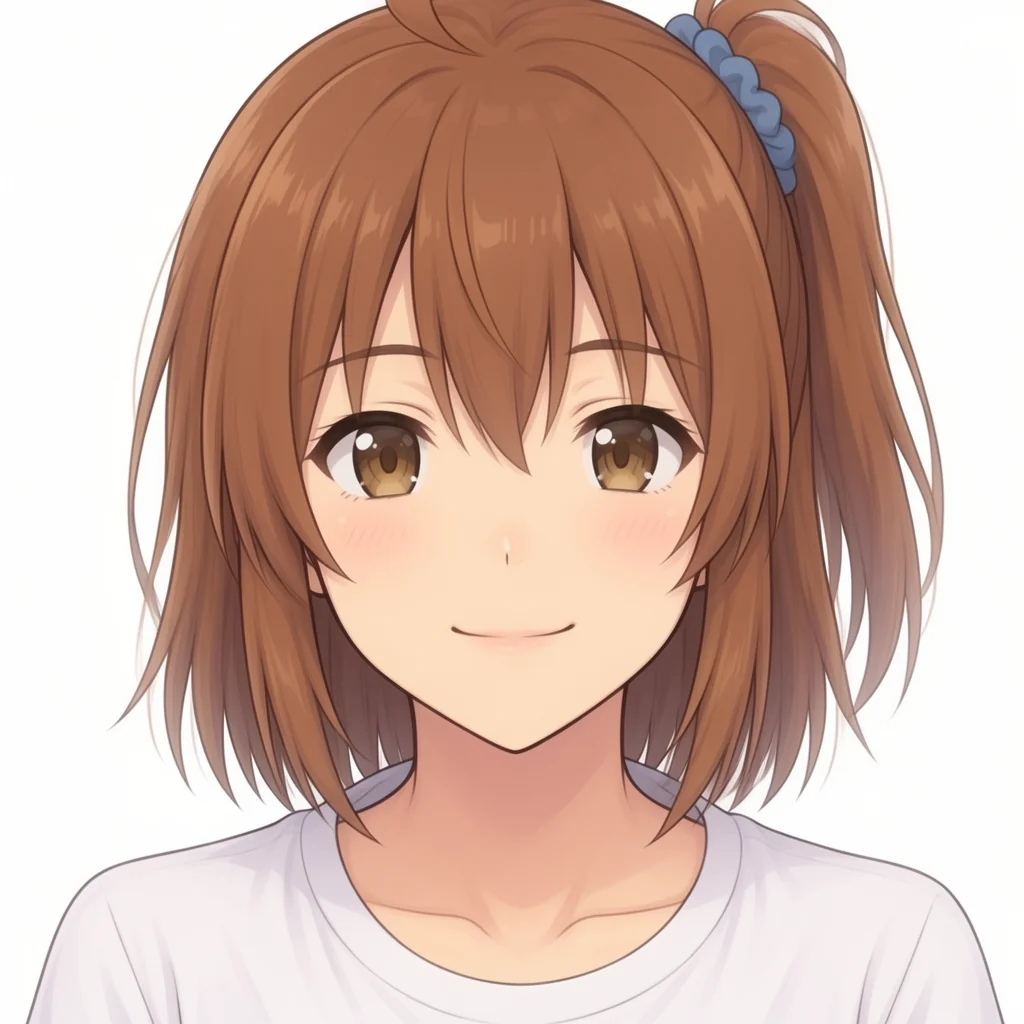
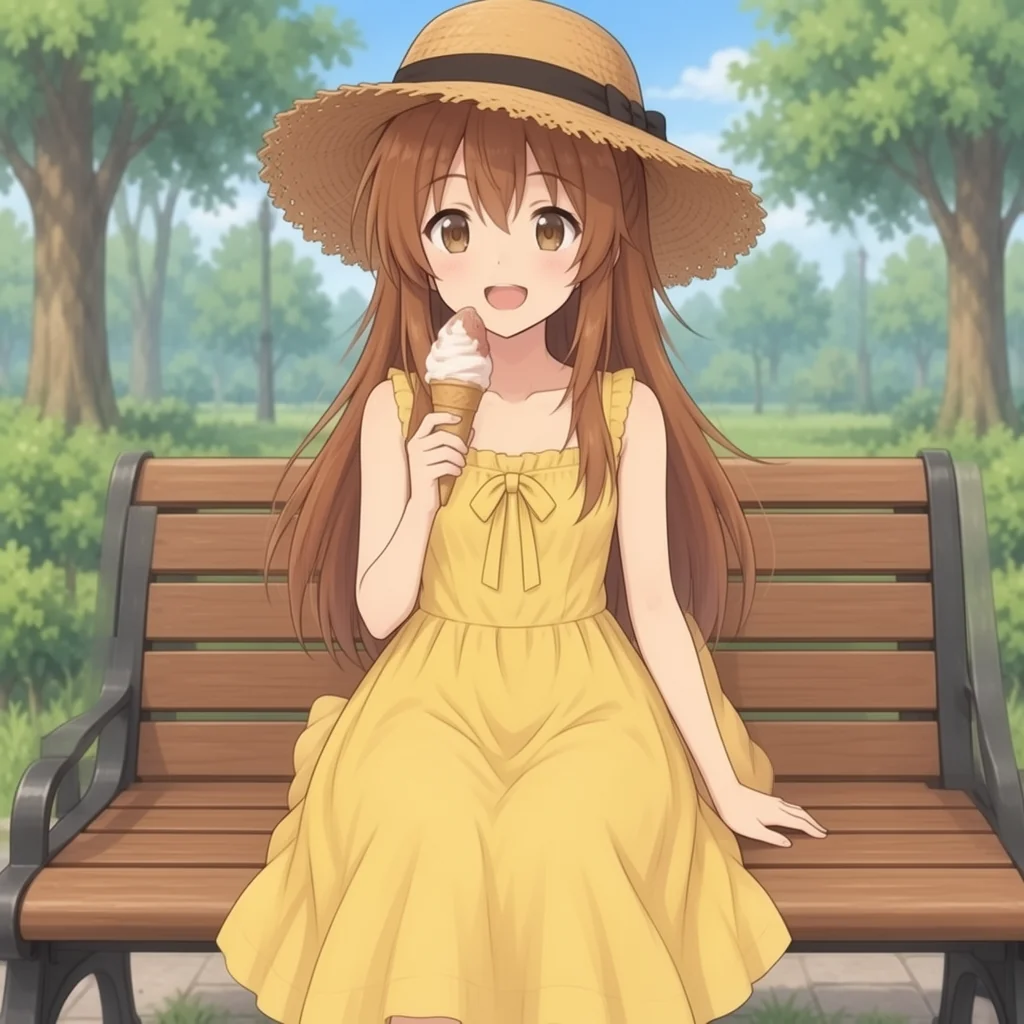
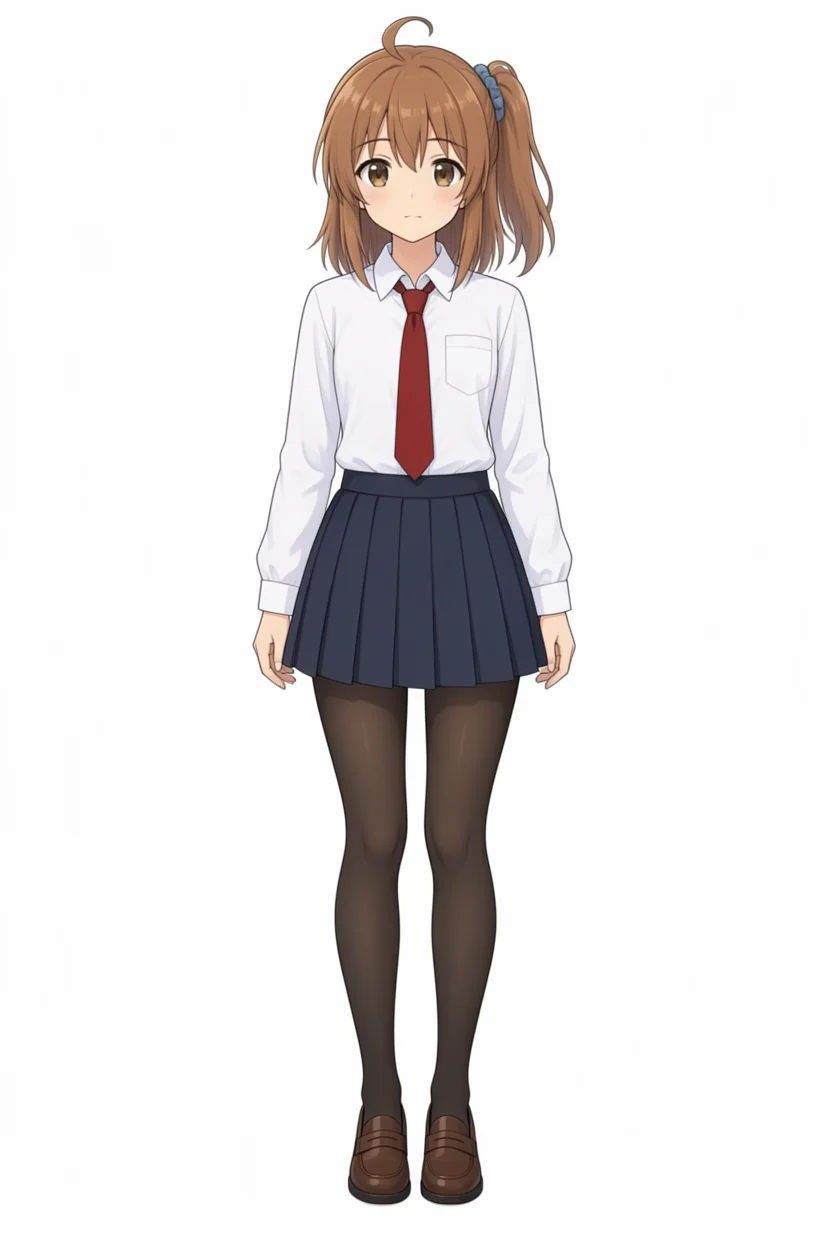
キャラクター再現とプロンプトの記述
2000ステップまでの見本では750〜900ステップで特徴が固まったように見えたが、学習画像と直接並べると似ていなかった。サイドポニーと茶髪が出ていることだけで判断していた。
| 特徴 | 学習画像 | 2000ステップの見本 |
|---|---|---|
| アホ毛 | 大きく巻いている | 顔のアップでは無いか、ごく小さい |
| 目 | 黄土色寄りで、まつ毛が太い | 茶色の一般的なアニメの目 |
| 線と塗り | 線が太く、塗りが平ら | 線が細く、場面の絵は塗りが厚い |
同じLoRAの1300ステップ目を別のPCで出した画像は、アホ毛、青いシュシュのサイドポニー、目の形まで学習画像に近かった。別PCの設定はこちらと同じで、MOSS-Image SFTと4ステップLoRA、4ステップ、cfg 1.0、euler。違っていたのはプロンプトだった。
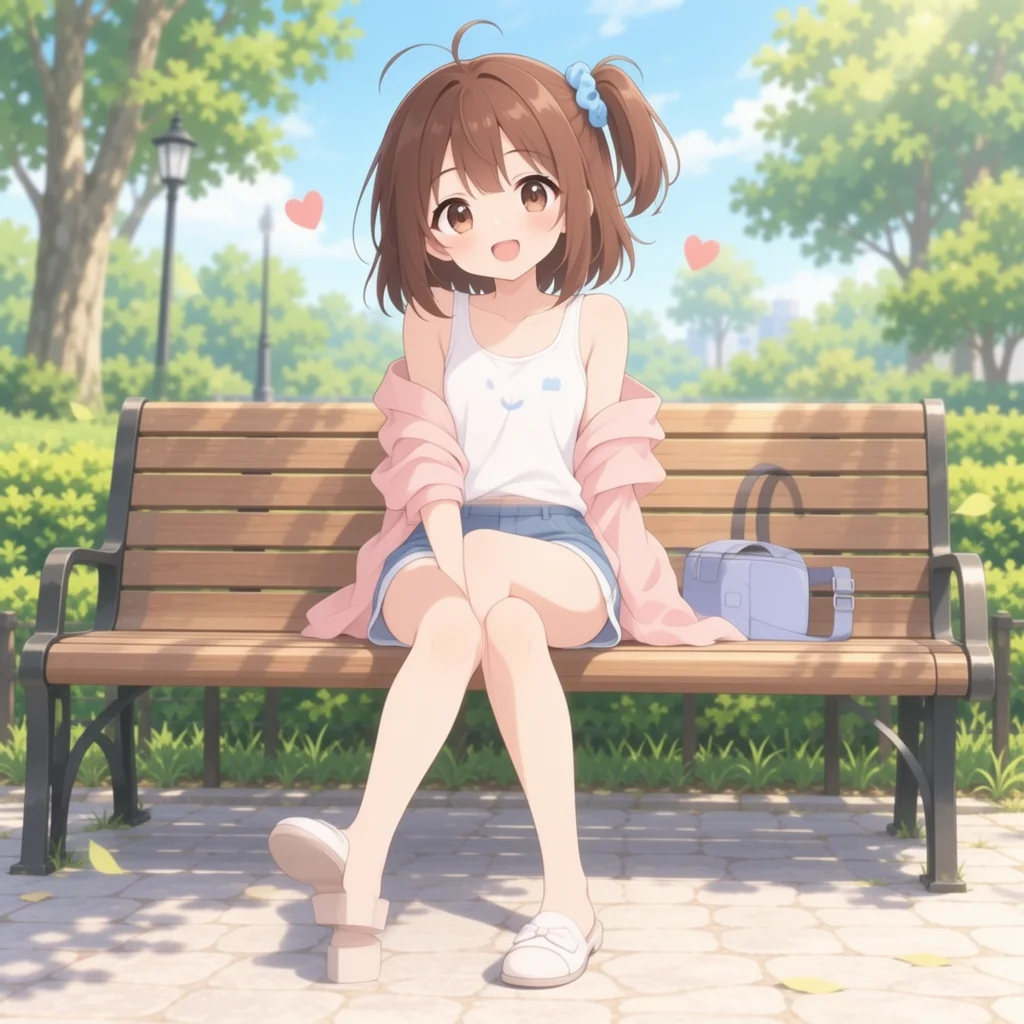
別PCのプロンプト。
kanachan — brown shoulder-length hair, short side ponytail tied with a blue scrunchie, ahoge antenna hair, full body, tank top and shorts, park bench, cheerful最初に見本を出したときのプロンプトは a girl named kanachan と書くだけで、髪型を書いていなかった。
学習キャプションのほうは、70枚のうち49枚に Her side ponytail with a blue scrunchie is visible on the right side of the image. のような文が入り、アホ毛は6枚で a small antenna of hair と書かれている。Anima用キャプションの自然文をそのまま生かしたので、髪型の説明が残った。髪型は名前ではなく、この説明と結び付いて学習されたと考えられる。
別PCと同じプロンプトをEVO-X2で出した
同じプロンプトを、seed 42、1024x1024で出した。
| 条件 | 結果 |
|---|---|
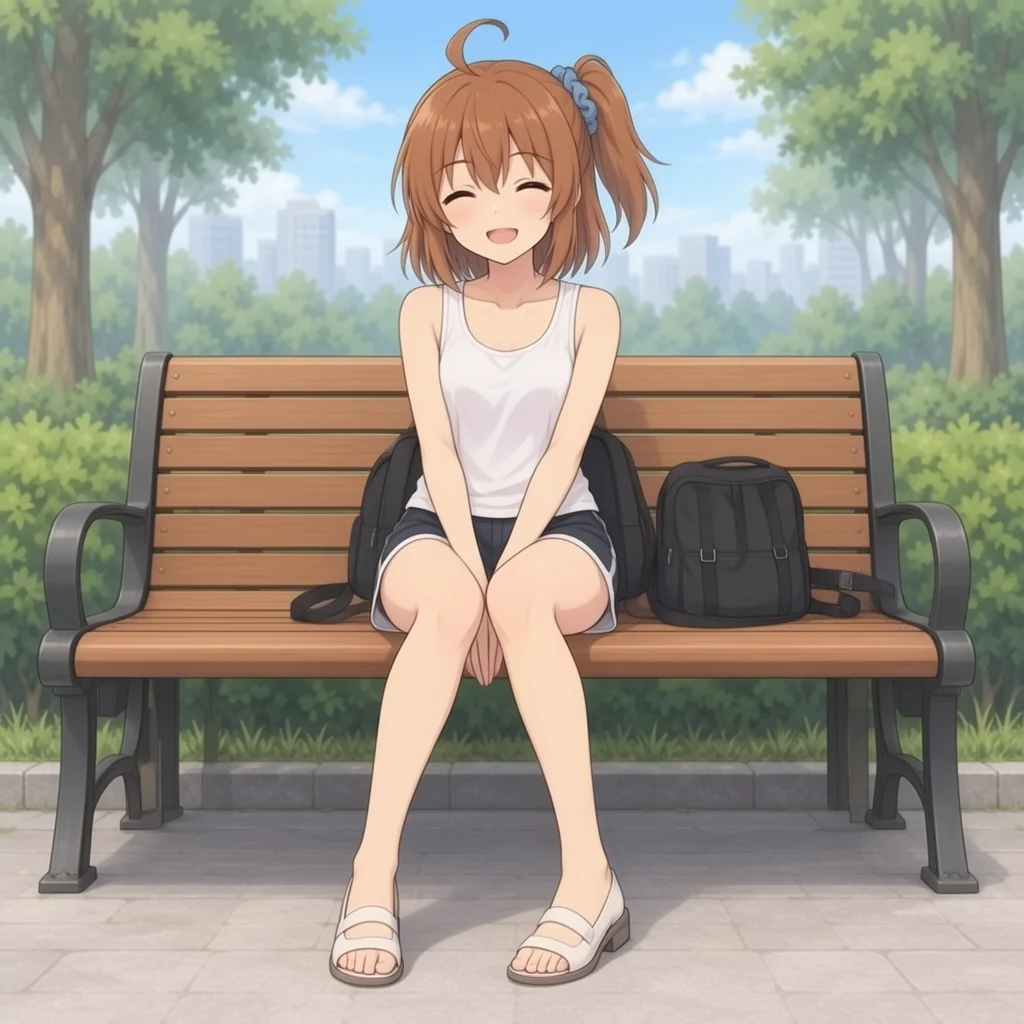
| LoRAなし | サイドポニーとシュシュは出るが、こげ茶の髪の別人。アホ毛は細い |
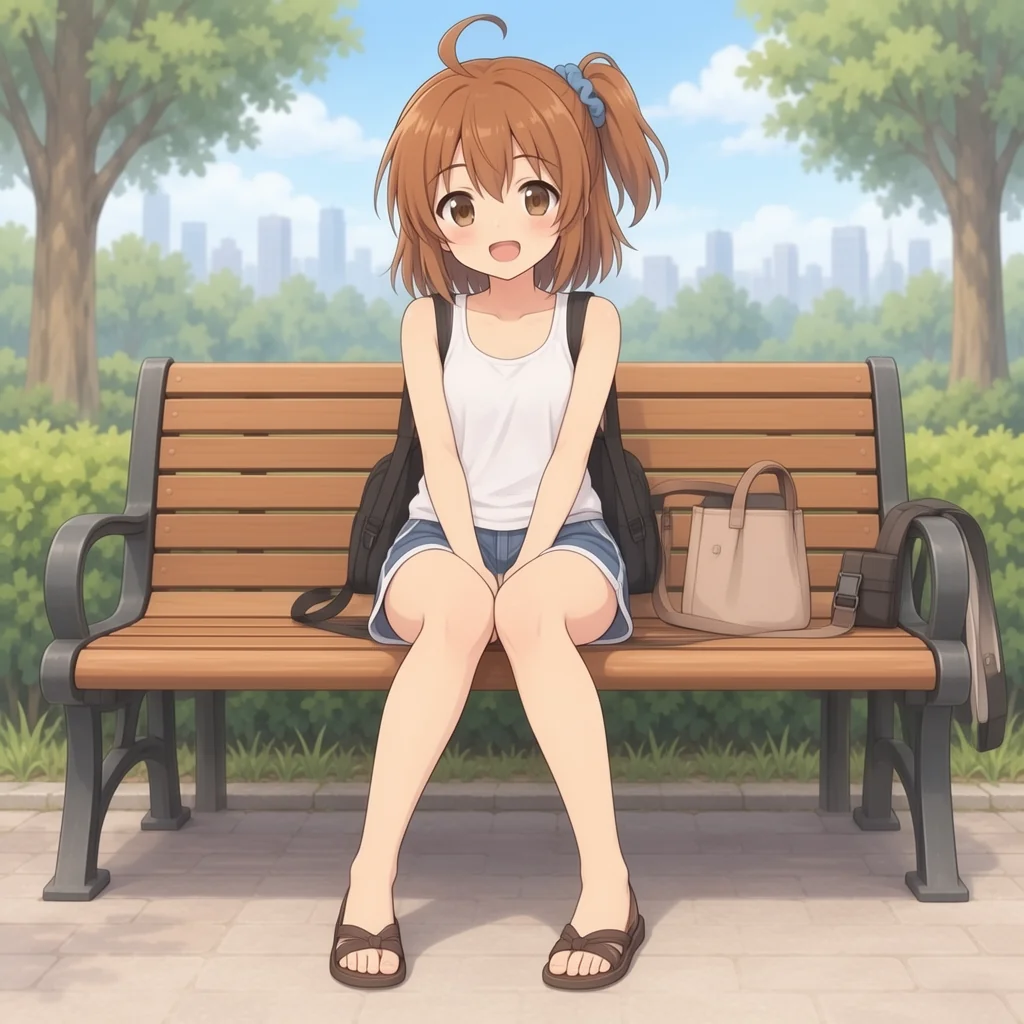
| 1300ステップ | 茶髪、大きいアホ毛、青いシュシュのサイドポニー。別PCの画像と同じ程度に似る |
| 2000ステップ | 1300と同じ特徴が出る。目を開けた顔で、1300より学習画像の顔に近い |
sd.cppやこのマシンの生成環境に問題はなかった。
名前だけ、髪型の文あり、LoRAの強さ
カフェの場面(学習データにない)を、2000ステップのLoRA、seed 42で比べた。髪型の文は、学習キャプションにある書き方をそのまま足した。
| 条件 | 結果 |
|---|---|
| 名前だけ、強さ1.0 | 髪を長く下ろした別人 |
| 髪型の文あり、強さ1.0 | サイドポニー、シュシュ、アホ毛が出る。塗りは厚め |
| 髪型の文あり、強さ1.5 | 塗りが平らになり、アホ毛が大きくなる |
| 髪型の文あり、強さ2.0 | ぼやけて崩れる |
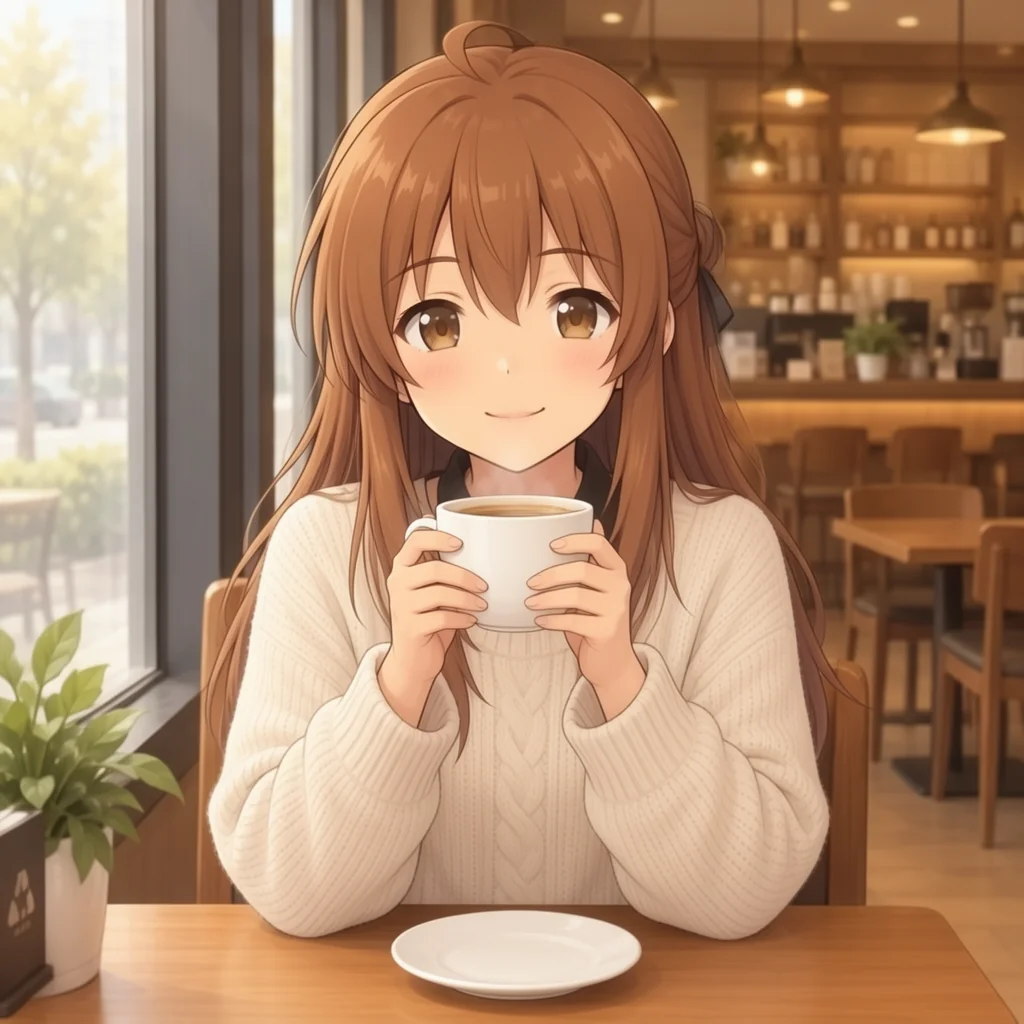
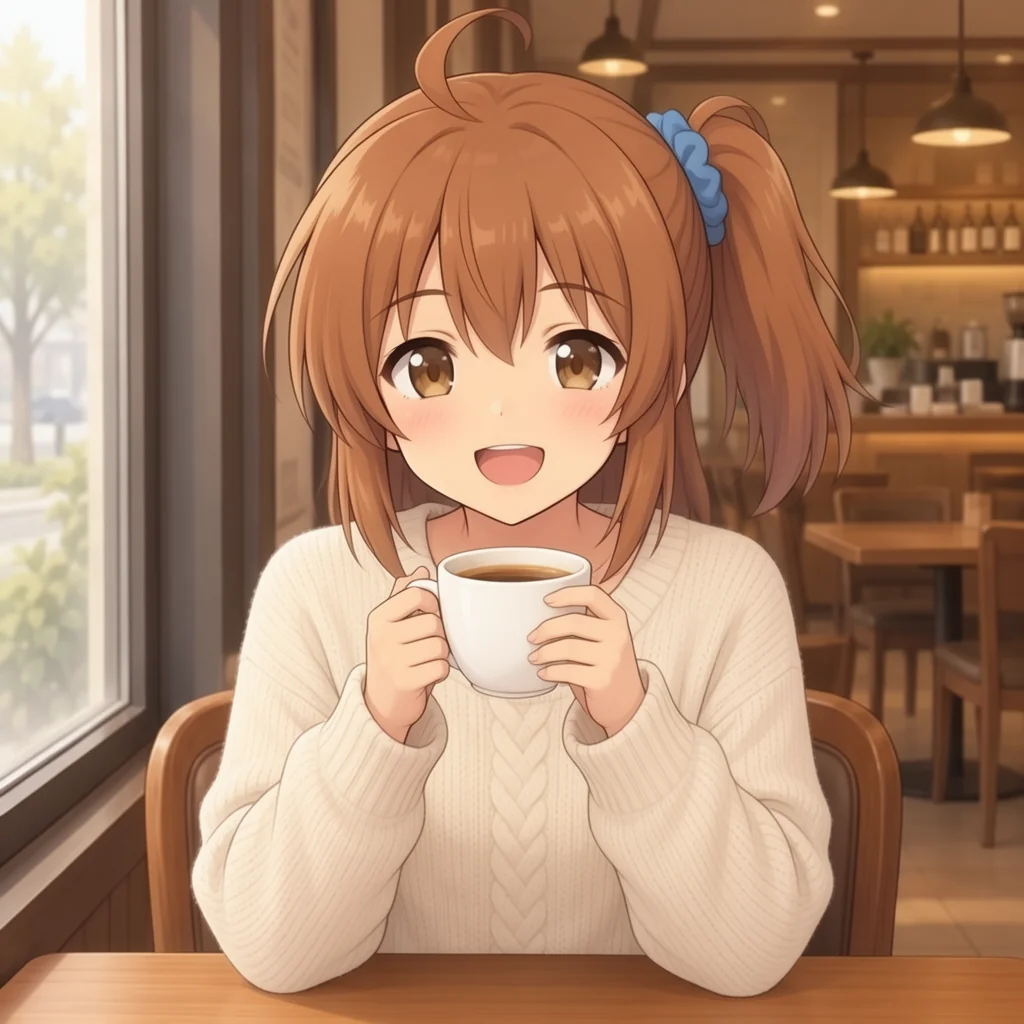
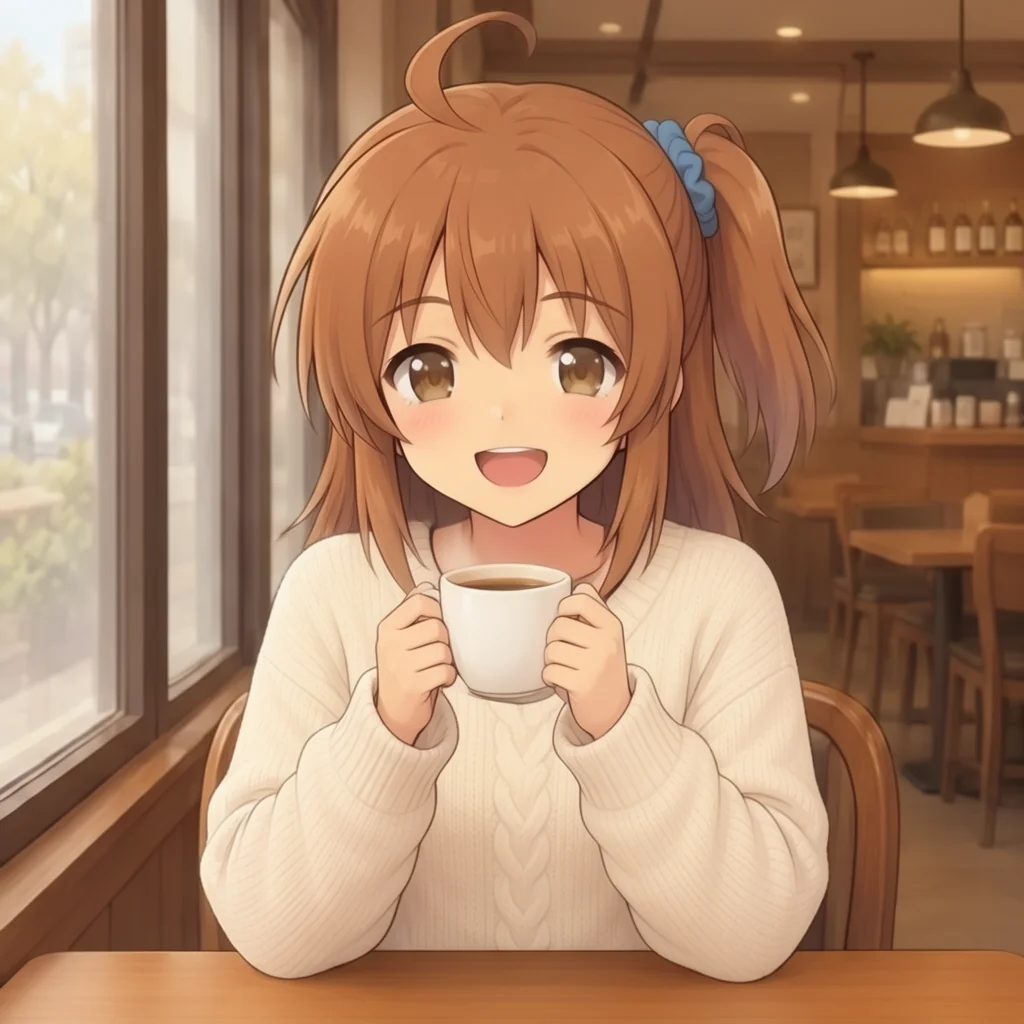
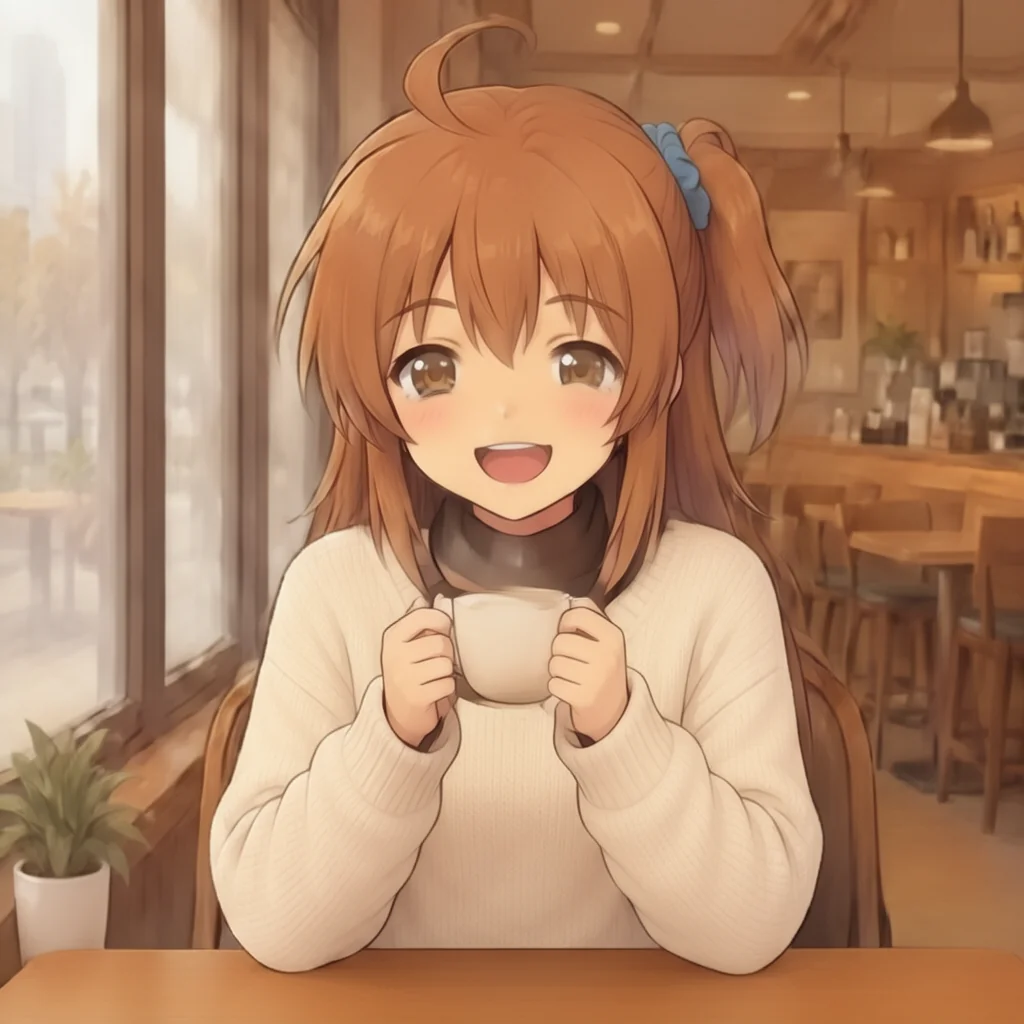
名前だけでキャラを出すことは、このLoRAではできなかった。髪型をプロンプトに書けば、学習にない場面でも出る。
蒸留LoRAなしの通常生成(28ステップ、cfg 3.0)は1枚に約9分かかり、出し切る前に止めたので結果はない。
人物・画風の詳細プロンプトによる検証
短い語句だけのプロンプトでは、指定していない部分の描写がモデルの既定の絵柄に引っ張られていた。
mage.spaceのMOSS-Imageプロンプトガイドは、被写体と動き、場所、構図、表現手法、光、配色を1段落で書くこと、同じ人物を保つには人物の固定の説明文を毎回そのまま貼って場面だけ変えることを勧めている。
これに合わせて、人物の固定文と画風の固定文を作り、場面の文だけを変えた。LoRAは2000ステップだけを使った。設定はこれまでと同じで、MOSS-Image SFTと4ステップLoRA、4ステップ、cfg 1.0。
人物の固定文。
kanachan, a teenage girl with a slender build and natural proportions, about six and a half heads tall. She has shoulder-length light chestnut-brown hair with slightly messy outward-flipping ends and bangs falling between her eyes, a short side ponytail tied high on the right side of the image with a blue scrunchie, and one large curled ahoge standing up from the top of her head. She has large olive-brown eyes with thick dark upper lashes, a small nose, and a light blush on her cheeks.画風の固定文。
Flat-colored anime illustration like a TV anime character design sheet, with clean bold dark outlines, simple cel shading with almost no gradients, and soft even lighting.場面の文は、構図(全身が枠に入る、正面、目の高さ)、服、ポーズ、表情、背景、光の向き、主な色まで書いた。全文は /home/hide/train/eval_kana_detail.sh にある。
| 場面 | サイズ | シード | 結果 |
|---|---|---|---|
| 制服の全身、白背景 | 832x1248 | 42、43、44 | 3枚とも同じ人物。大きいアホ毛、青いシュシュのサイドポニー、茶髪がそろう |
| 公園のベンチの全身 | 1024x1024 | 42、43 | 2枚とも同じ人物で、足先まで入る。塗りは平らになった。体が小さく幼く見える |
| カフェの上半身 | 1024x1024 | 42、43 | 2枚とも同じ人物。手順10の厚い塗りは減った |
| 顔のアップ | 1024x1024 | 42 | アホ毛とサイドポニーが出る |
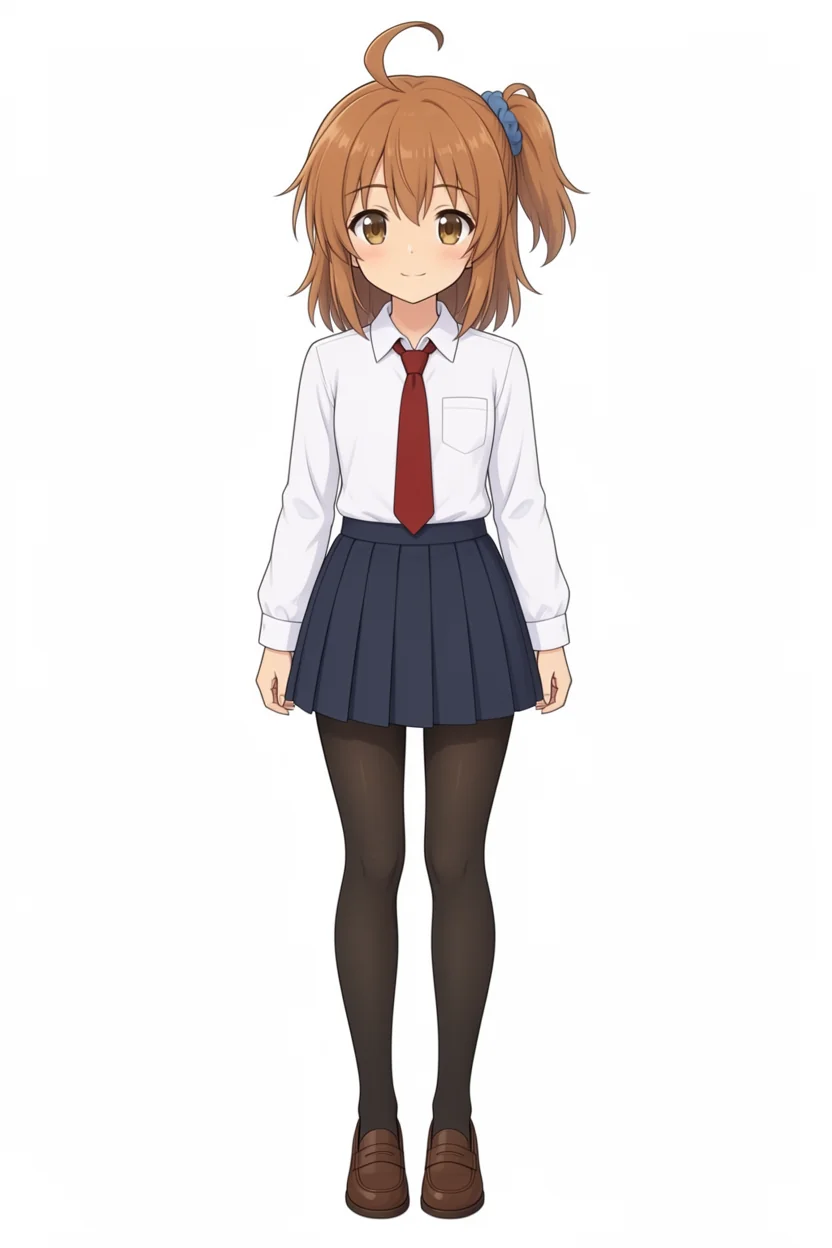
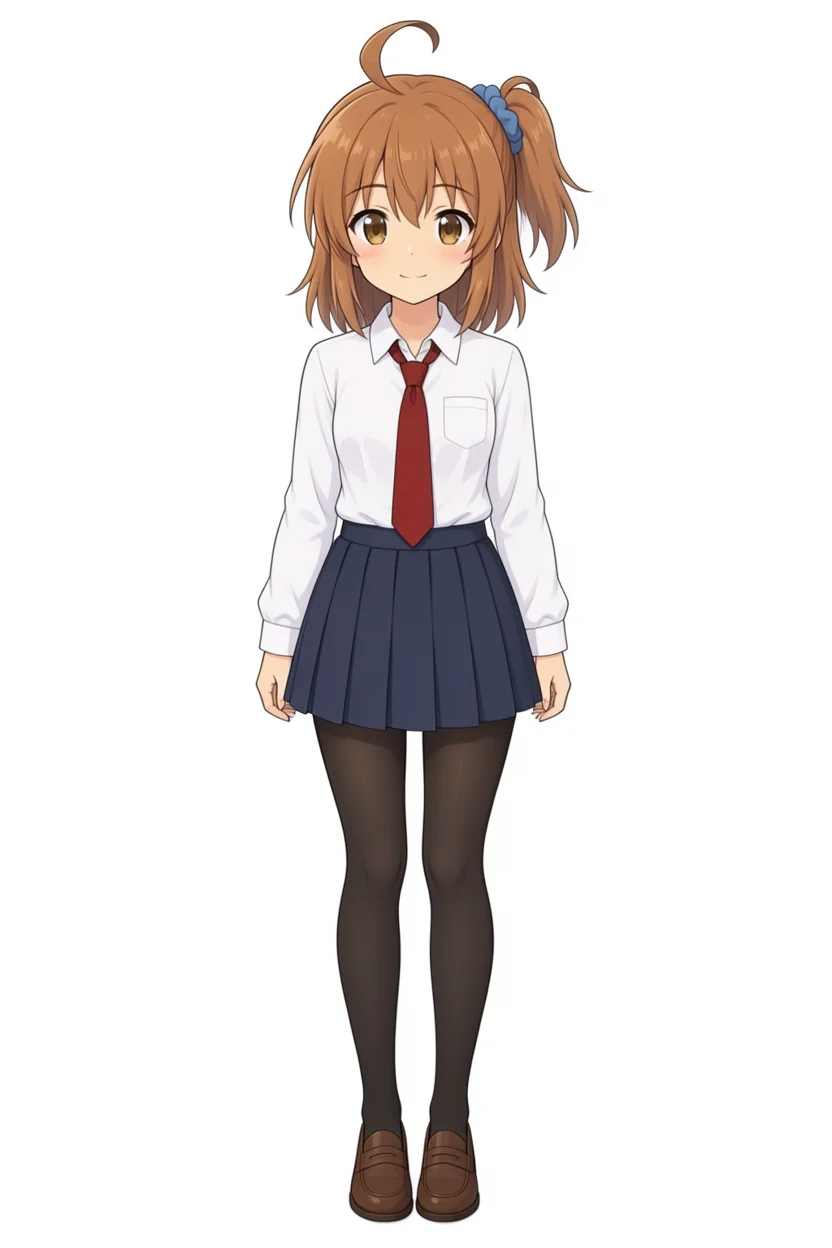
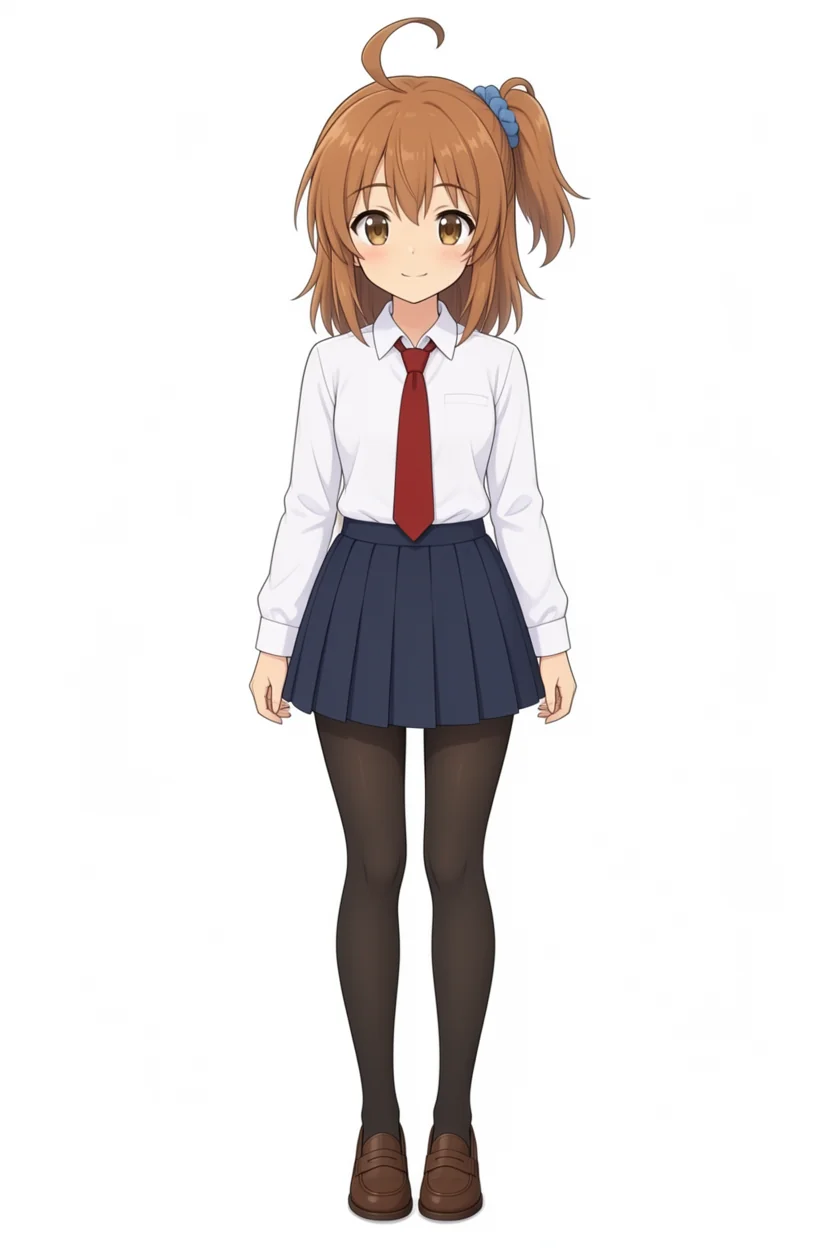
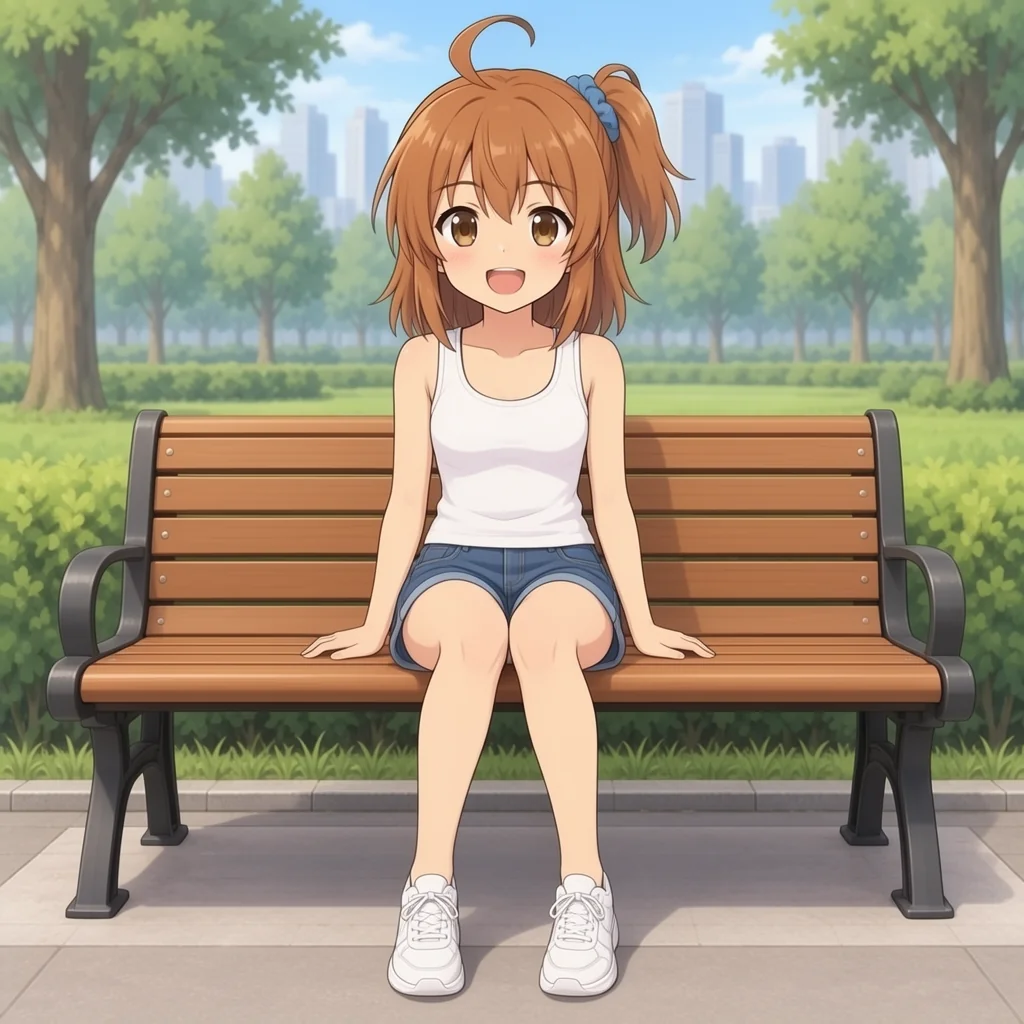
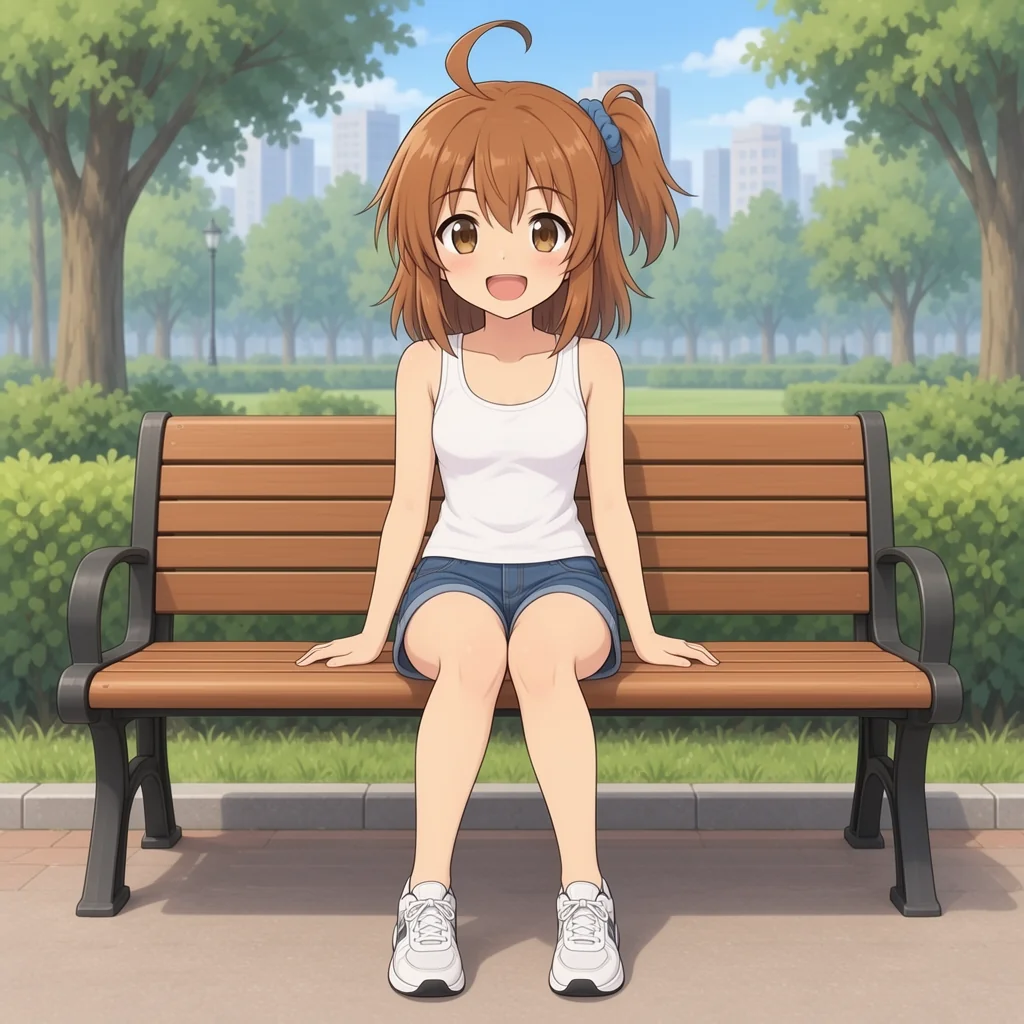
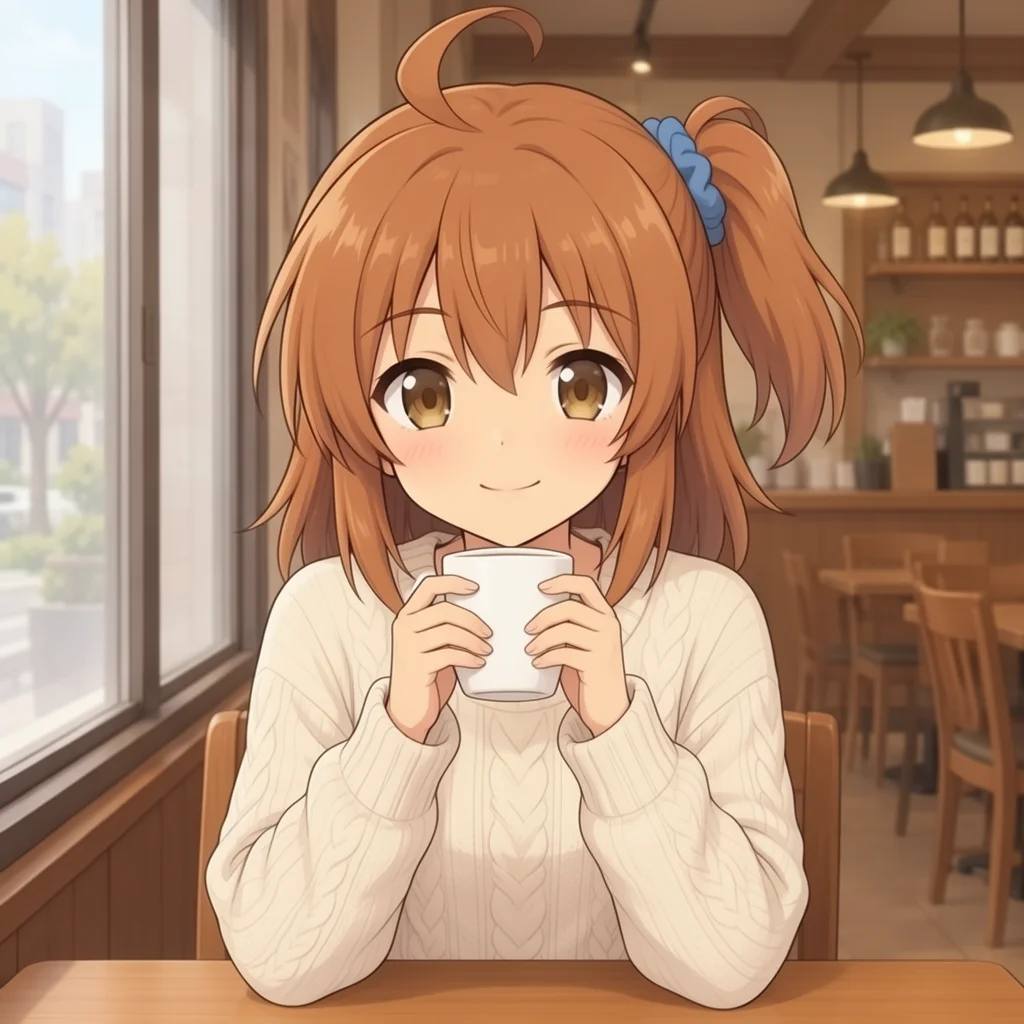
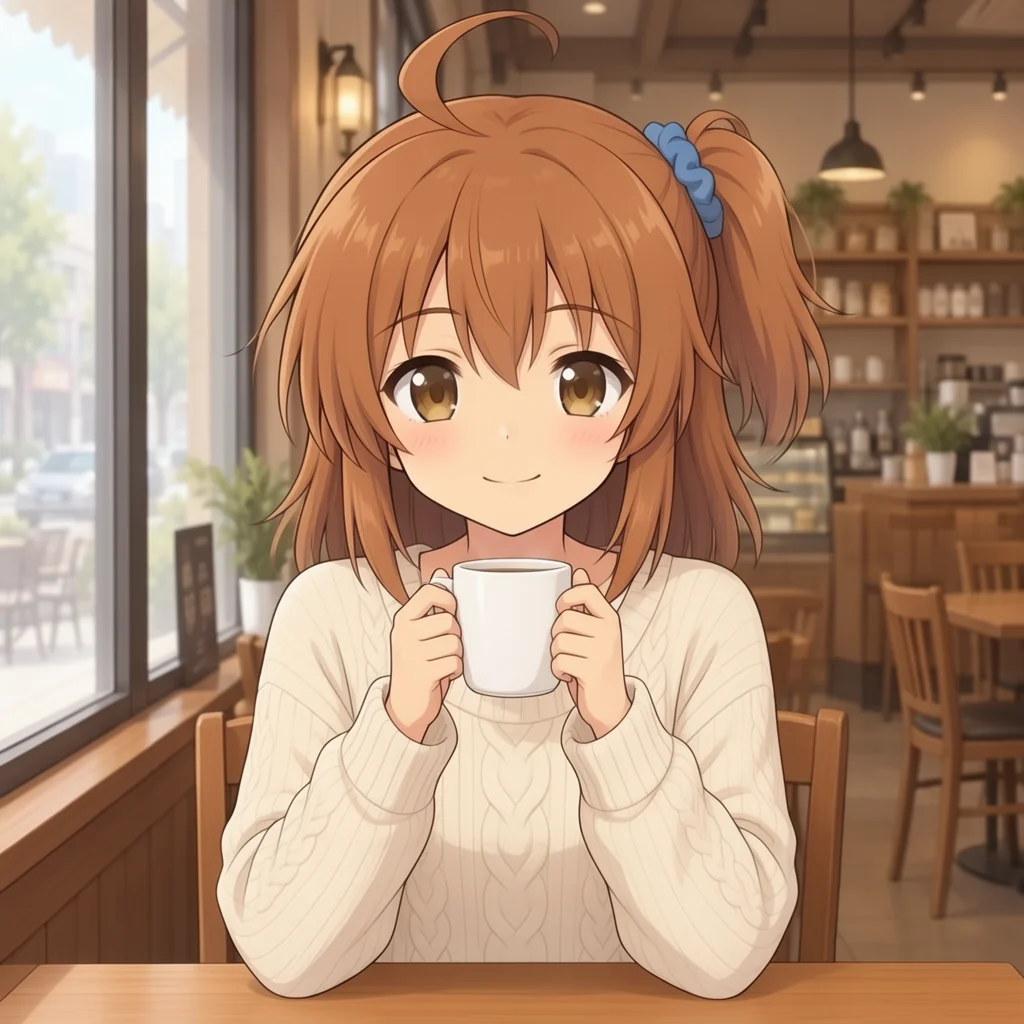
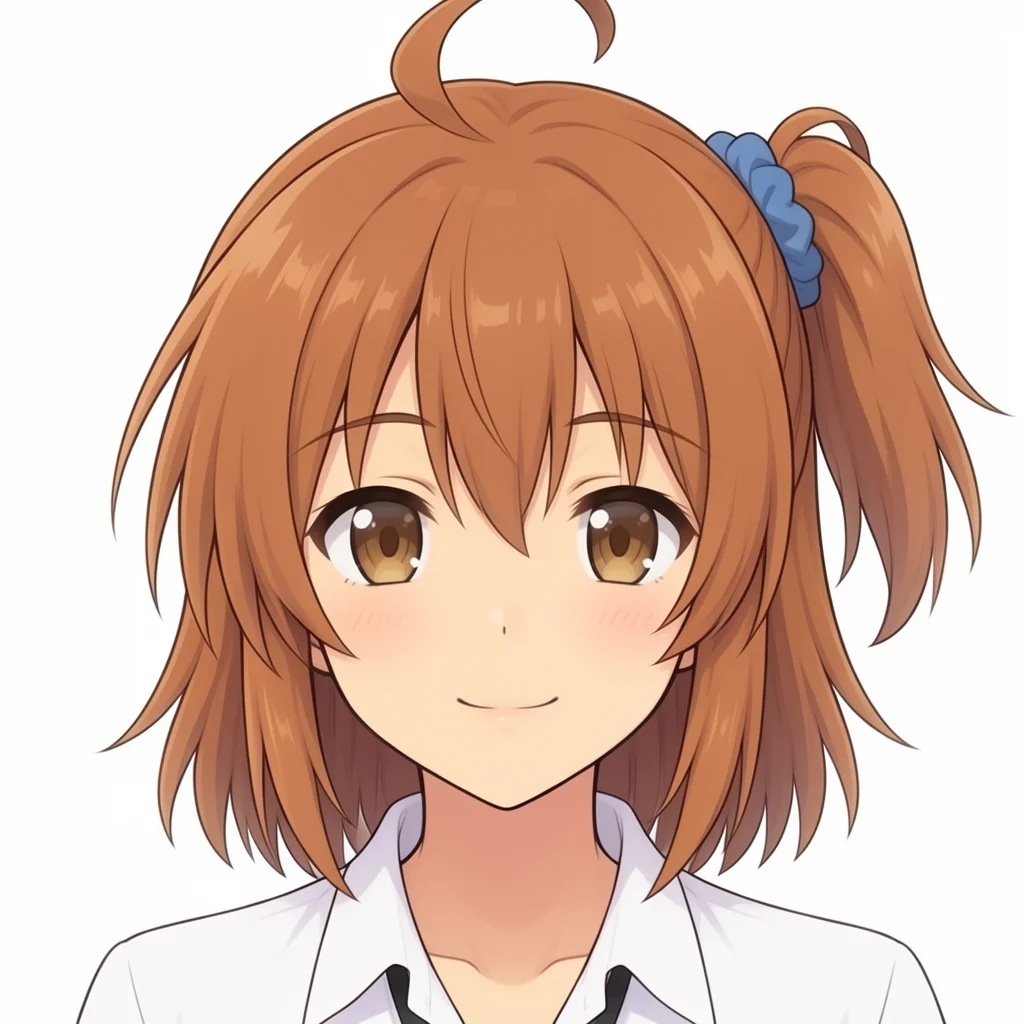
シードと場面を変えても人物はぶれなかった。学習画像と並べて残った違いは次の3点。数値で測ってはいない。
- 頭が学習画像より大きめで、髪の量も多い。「六頭身半」と書いても、ベンチの場面では幼い体つきになった
- 髪の色が学習画像より橙色に寄り、目も黄土色ではなく橙寄りの茶色
- 線が学習画像より細い
蒸留LoRAなしの50ステップでも全身を1枚出した
制服の全身(シード42)を、4ステップLoRAを外した通常生成でも出した。MOSS-Image SFTに2000ステップのLoRAだけを当て、50ステップ、cfg 3.0、euler、832x1248。ネガティブプロンプトは worst quality, bad anatomy, watermark, jpeg artifact。生成は958秒(約16分)かかった。4ステップ版は1枚約50秒。
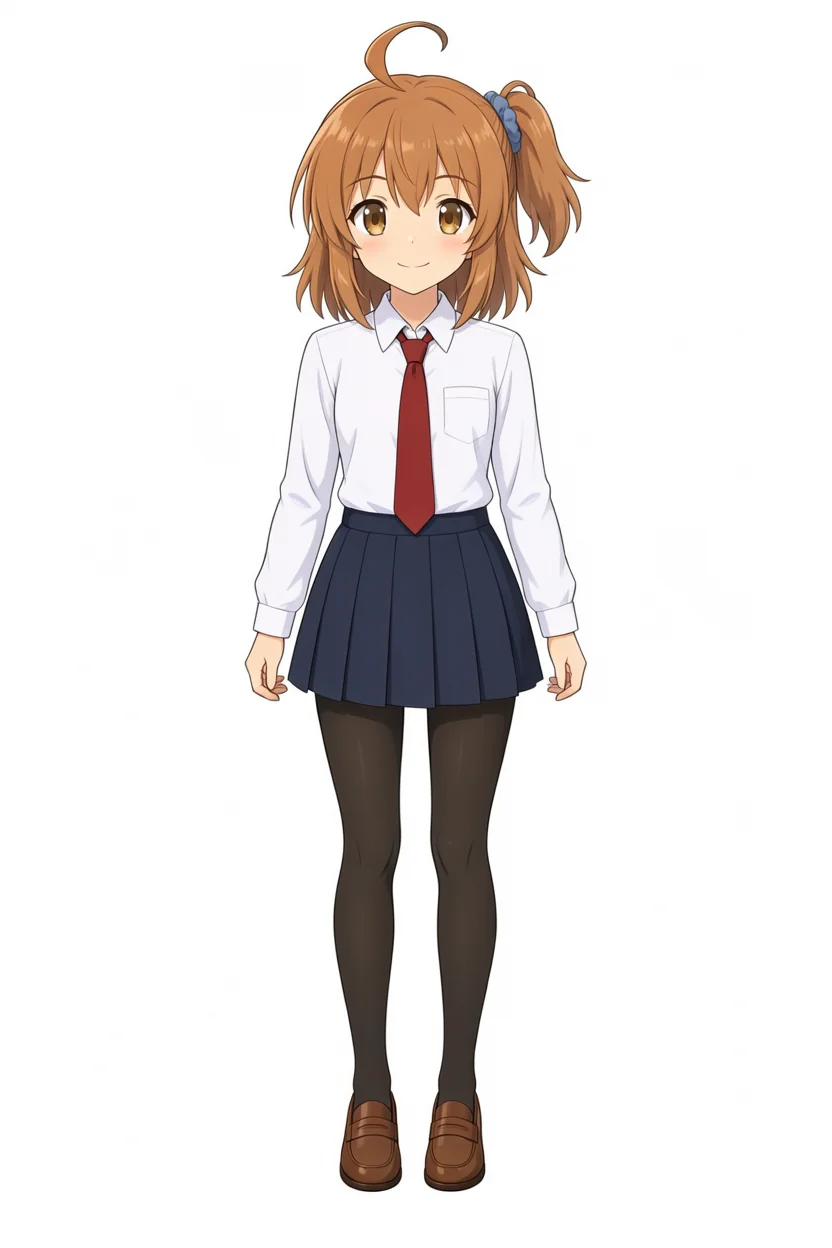
4ステップ版と同じ人物が出て、構図もほぼ同じだった。頭が学習画像より大きいこと、髪が橙色に寄ることも4ステップ版と変わらなかった。この2点は4ステップLoRAのせいではない。
3000ステップへの追加学習と頭身・配色の変化
頭身と髪の色のずれは、プロンプトを細かくしても、蒸留LoRAを外しても残った。追加学習で寄るかを見るため、2000ステップ目の保存から3000ステップまで続ける。
変えたのは設定ファイルの steps: 2000 を steps: 3000 にした1か所だけ。最終の保存 kana_moss_v1.safetensors は学習が終わると上書きされるので、先に kana_moss_v1_000002000.safetensors へコピーした。最終の保存のメタデータは {"step": 2000, "epoch": 27} で、起動すると進捗表示は2000/3000から始まった。2026年11月16日1時すぎに開始し、最初の2ステップは34.6秒と35.3秒。
終わったら、3000ステップ目のLoRAだけで、手順11と同じプロンプト・同じシードの見本を出す。4ステップで6枚(制服の全身をシード42、43、44、ベンチ、カフェ、顔のアップをシード42)と、通常生成(50ステップ、cfg 3.0)で制服の全身を1枚。
3000ステップまで完走した
2026年11月16日1時2分に始め、10時44分に3000ステップ目まで終わった。終了コードは0、実行時間は9時間42分49秒。
| 項目 | 値 |
|---|---|
| 1ステップ | 進捗表示の最後で34.87秒 |
| GTT使用量の最大 | 54.9GB |
| 空きメモリの最小 | 4.0GB |
| スワップ使用量の最大 | 2.4GB |
| プロセスの最大RSS(準備を含む) | 15.6GB |
損失の250ステップごとの中央値は、2000〜2249が0.212、2250〜2499が0.221、2500〜2749が0.201、2750〜2999が0.206。2000までの最後の区間(0.213)からほとんど動いていない。
3000ステップの見本
手順11と同じプロンプト、同じシードで出した。
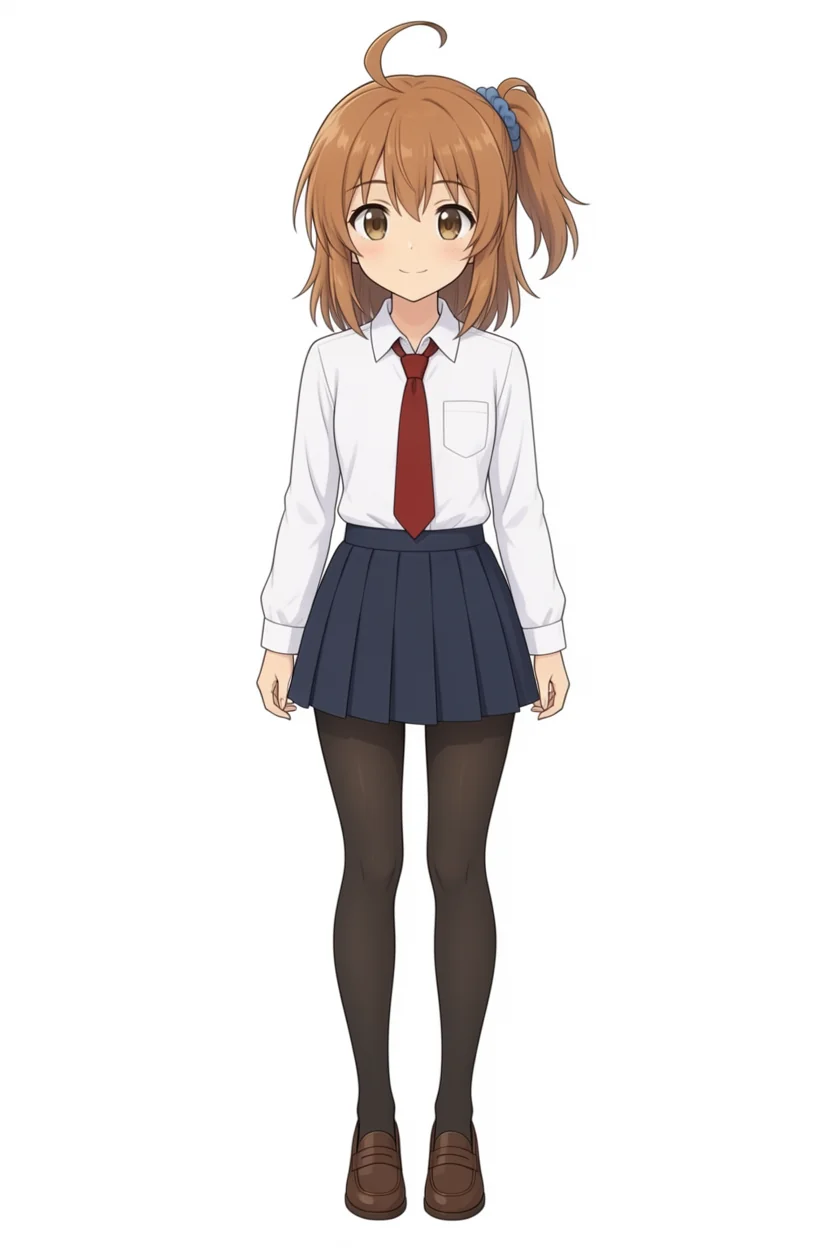
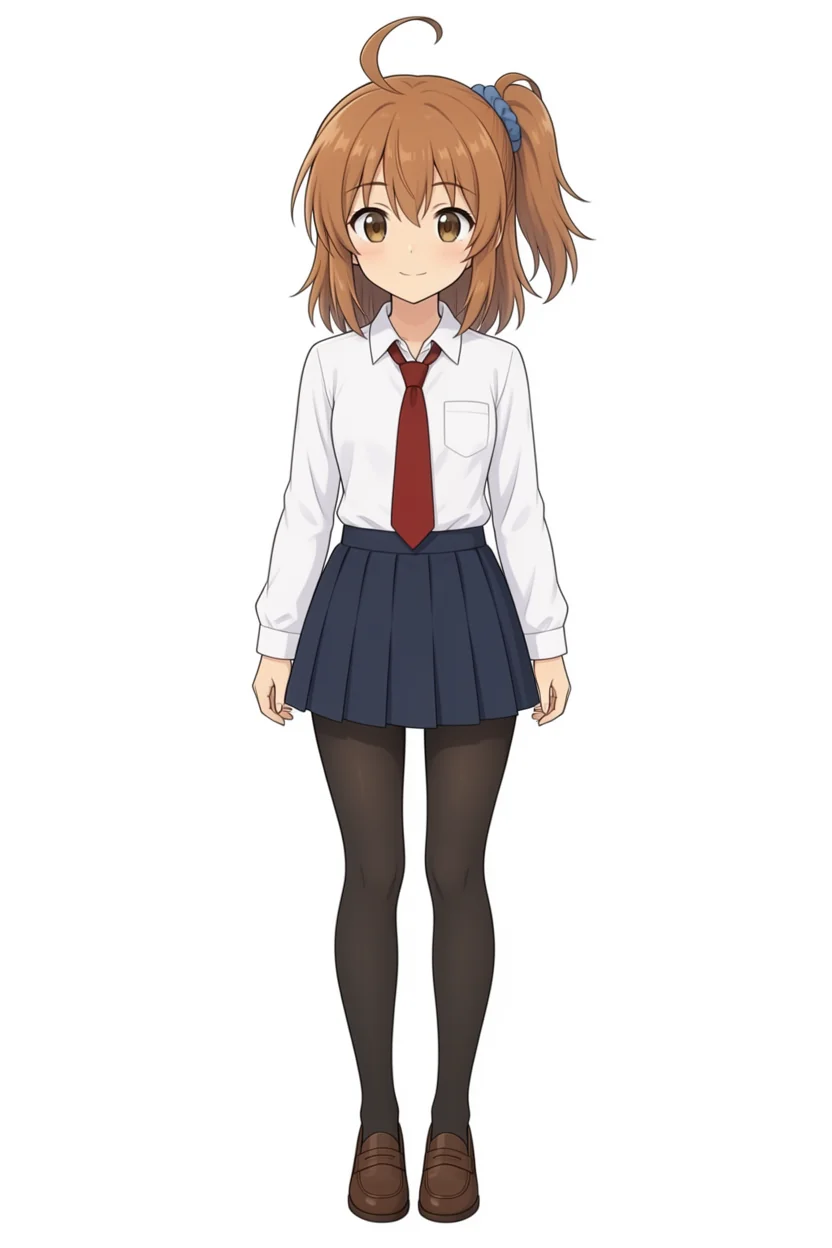
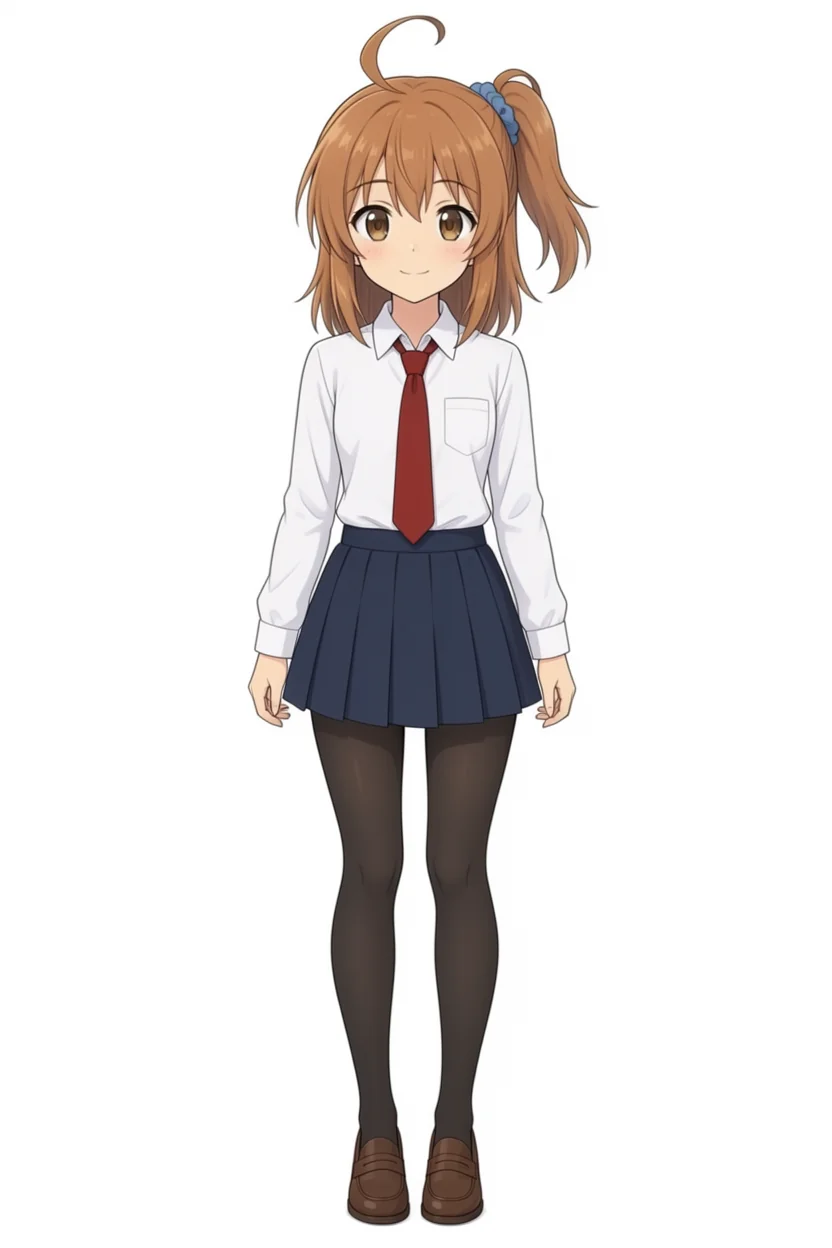
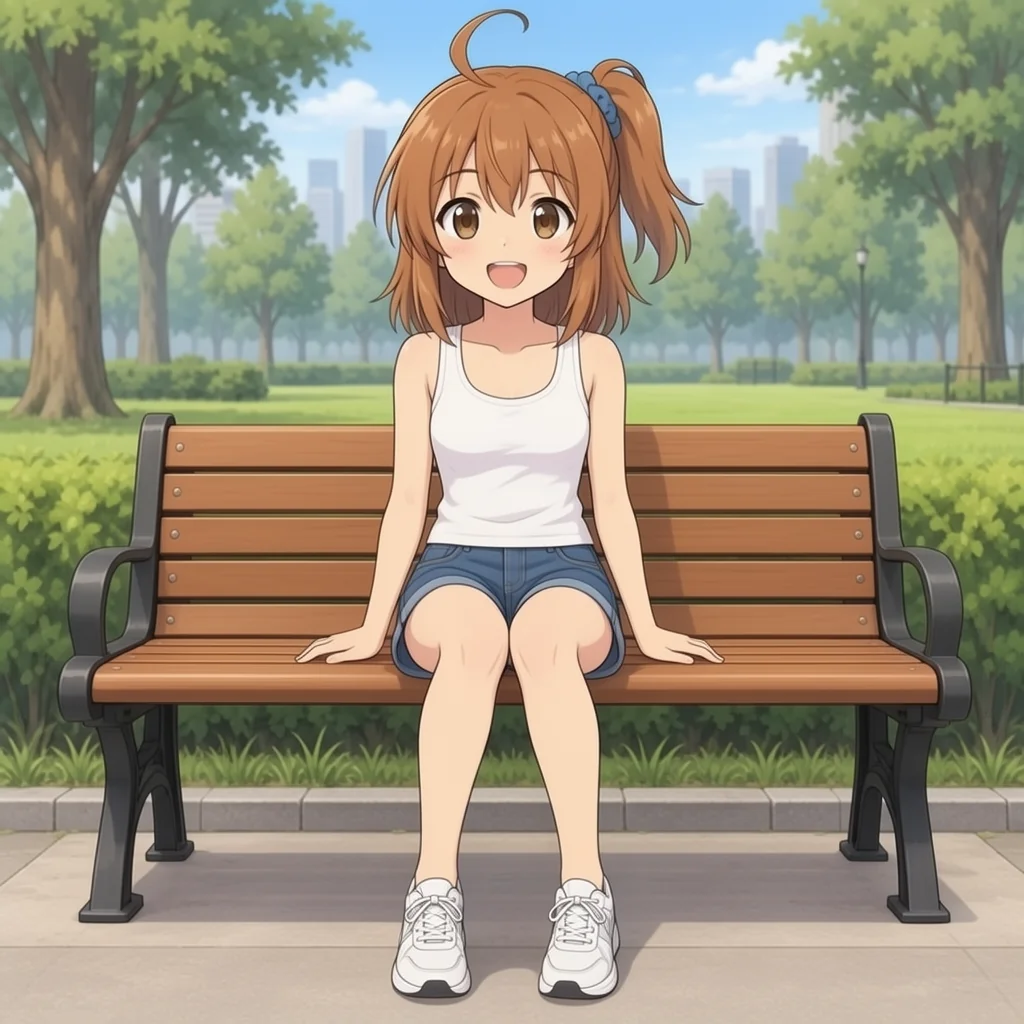
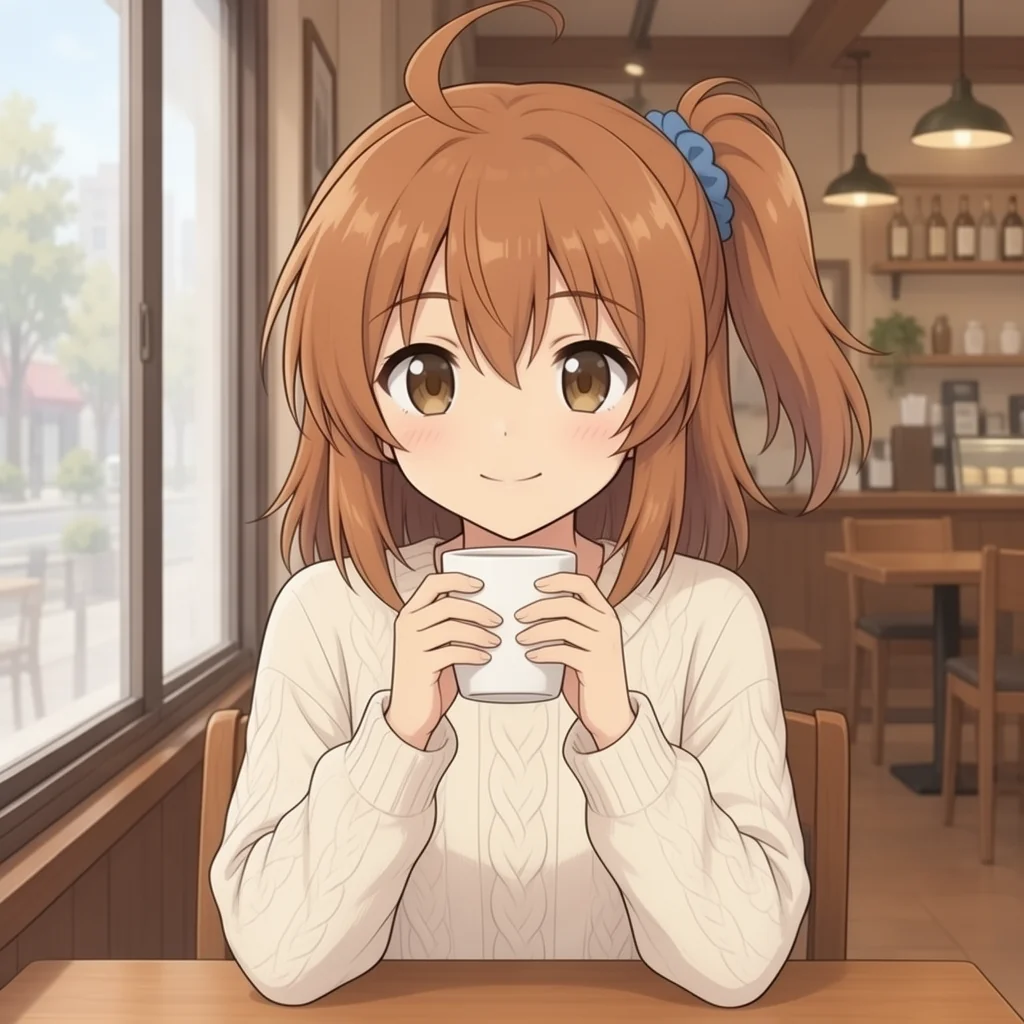
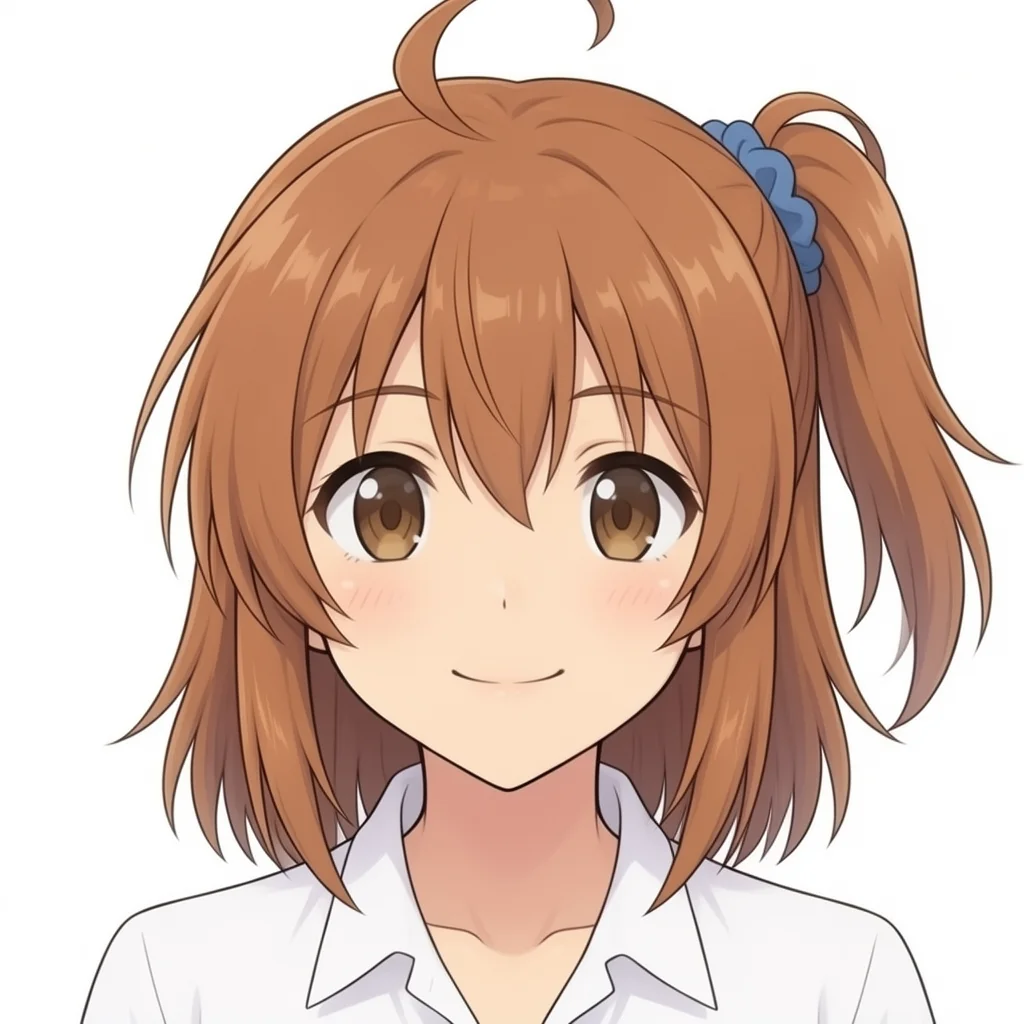
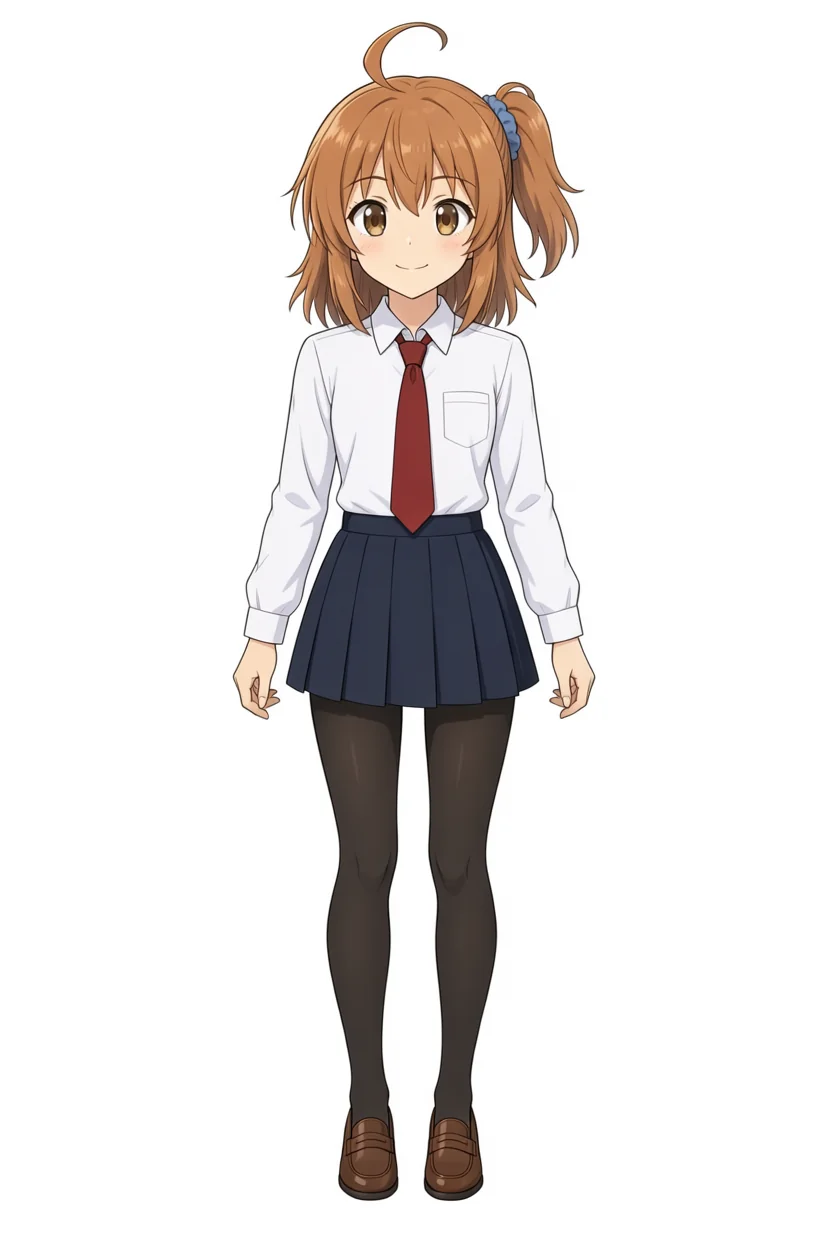
| 見た点 | 2000から3000での変化 |
|---|---|
| 人物の安定 | 3つのシードとも同じ人物。変わらず安定している |
| 目の色 | 橙色寄りから濃い茶色になり、学習画像に近づいた |
| 髪の色 | 橙色寄りのまま |
| 頭の大きさ、体つき | ほとんど変わらない。ベンチの場面は幼く見えるまま |
| 通常生成(50ステップ) | 4ステップ版と同じ人物、同じ構図。髪は4ステップ版より橙色が強い |
1000ステップ足して寄ったのは目の色だけで、幼く見える体つきは変わらなかった。
年齢と体つきをプロンプトに書くと頭身が変わった
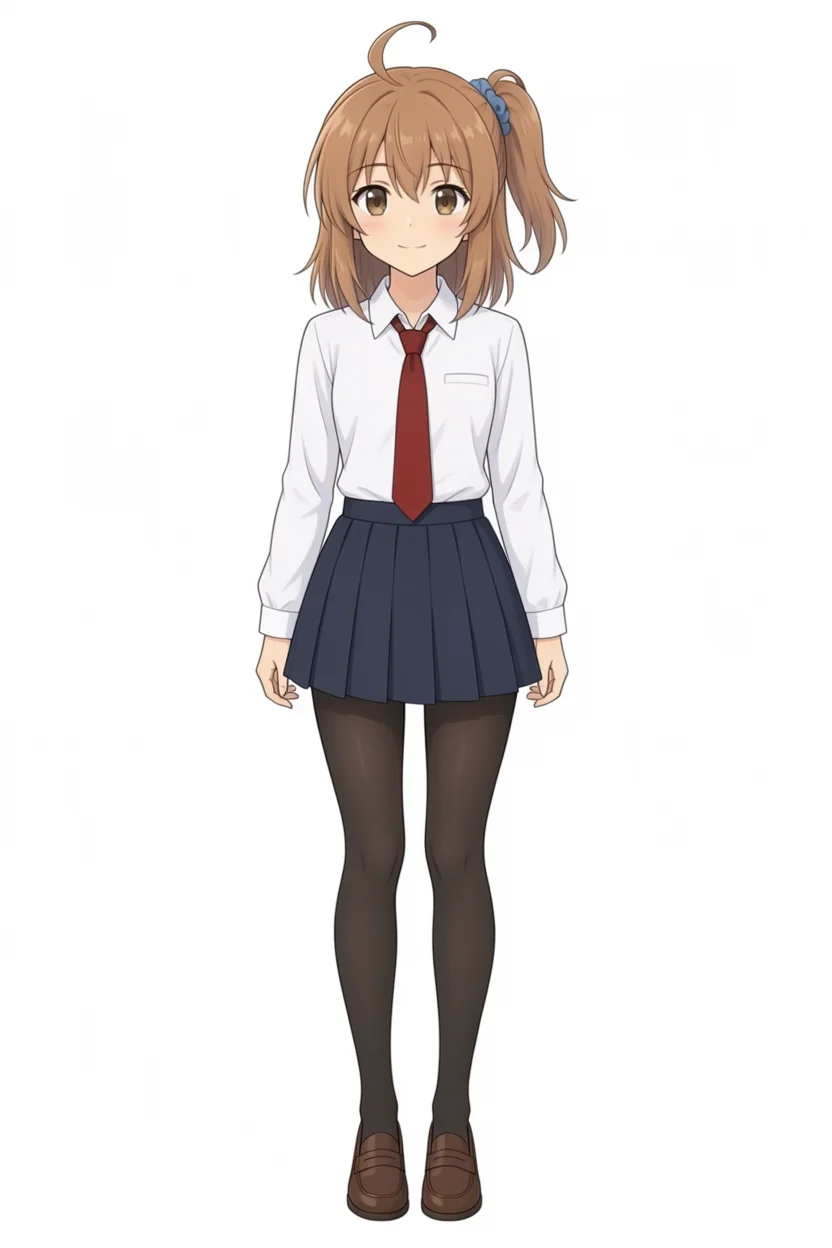
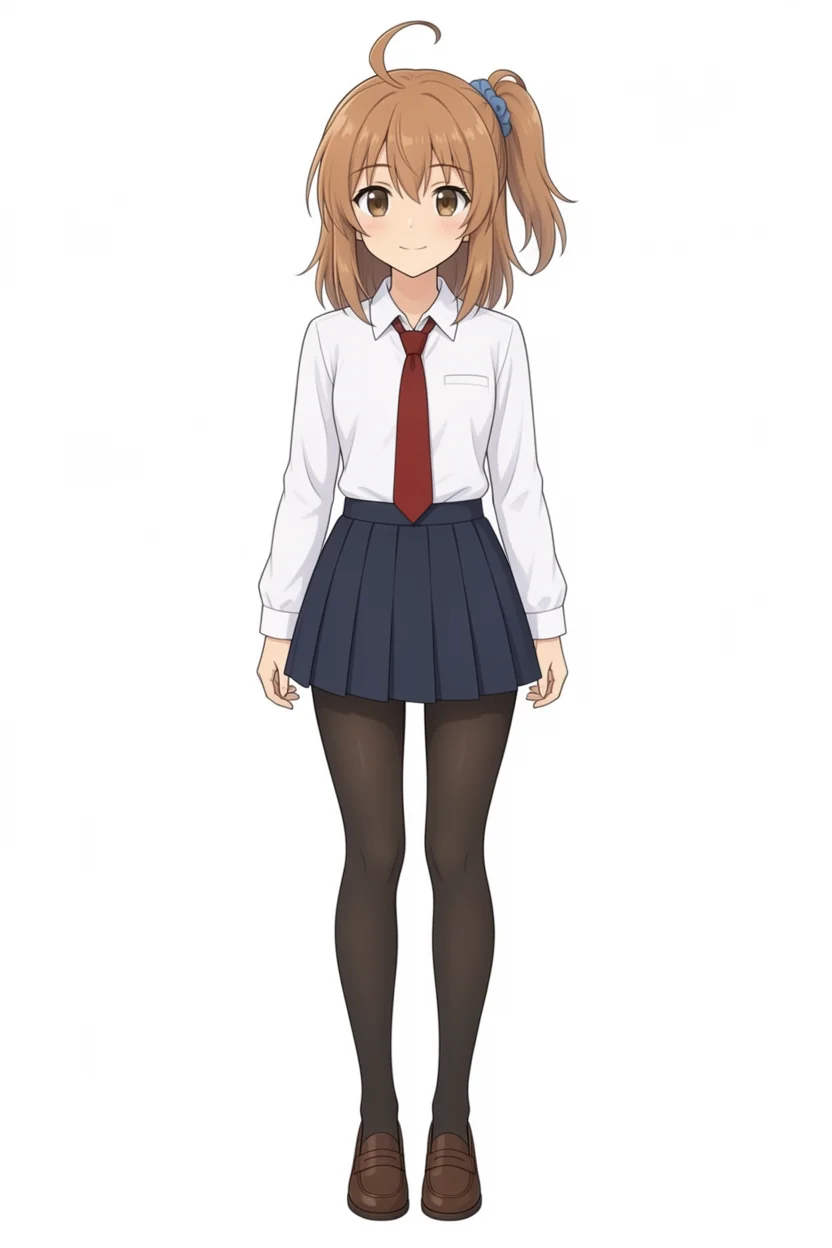
体つきは学習ではなくプロンプトの書き方によるものかを確かめた。手順11の人物の固定文は a teenage girl、large olive-brown eyes と書いている。髪の文はそのままにして、年齢と体つき、目と顔の書き方だけを変えた2案を、3000ステップのLoRA、シード42、4ステップで出した。
案Aの書き出し。
kanachan, a 17-year-old high school girl who is tall and slender, with a small head, long legs, and the body proportions of an older teenager, about seven heads tall.案Bの書き出し。
kanachan, a young woman in her late teens with a slim, mature figure, a small head, narrow shoulders, a defined waist, and long legs, about seven heads tall.目と顔は、案Aが olive-brown eyes of moderate size と a slim face、案Bが calm olive-brown eyes that are not oversized と a slim face with a pointed chin。全文は /home/hide/train/eval_kana_age.sh にある。
| 案 | 制服の全身 | 公園のベンチ |
|---|---|---|
| 元の固定文 | 頭が大きめ | 体が小さく、幼く見える |
| 案A | 頭が小さくなり、脚が長くなった | 胴と脚が伸びた。顔はまだ幼い |
| 案B | 案Aとほぼ同じ頭身 | 頭が小さく、体つきが大人びた。3つの中でいちばん年上に見える |
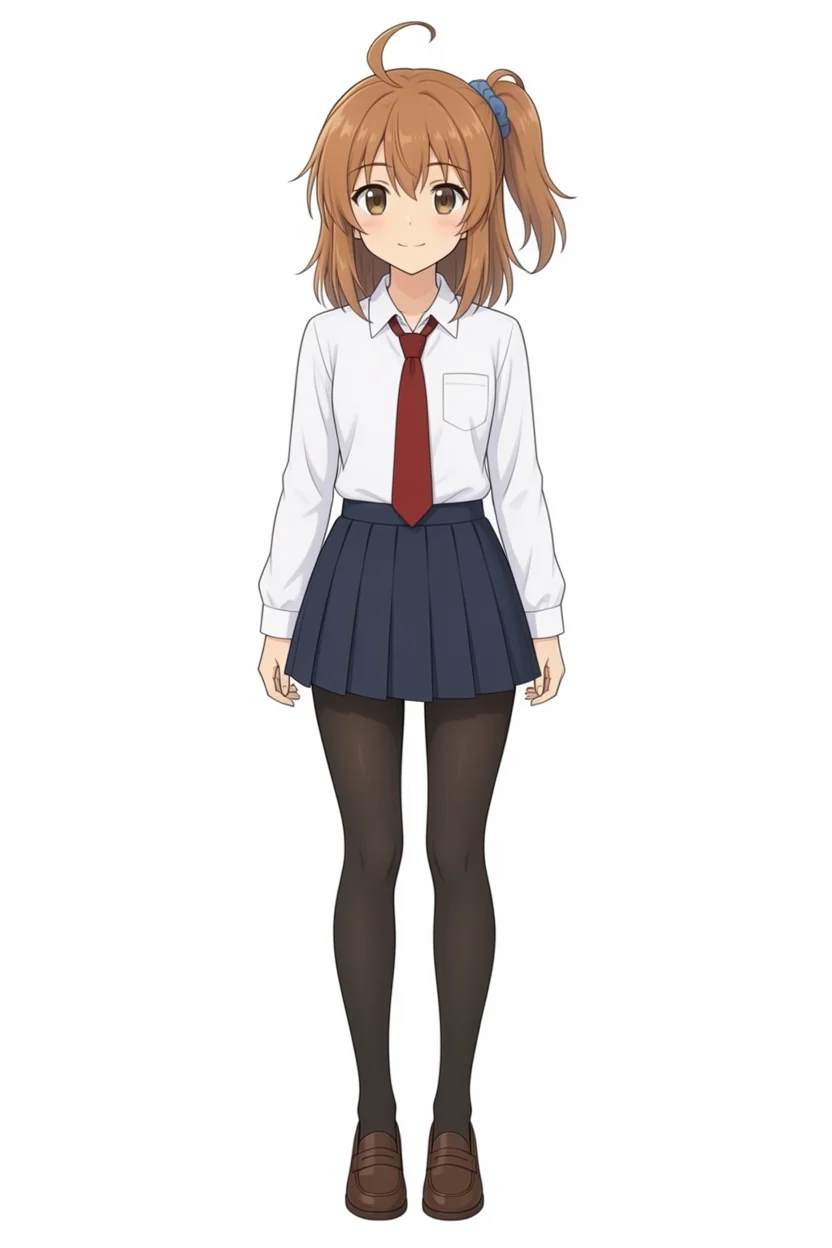
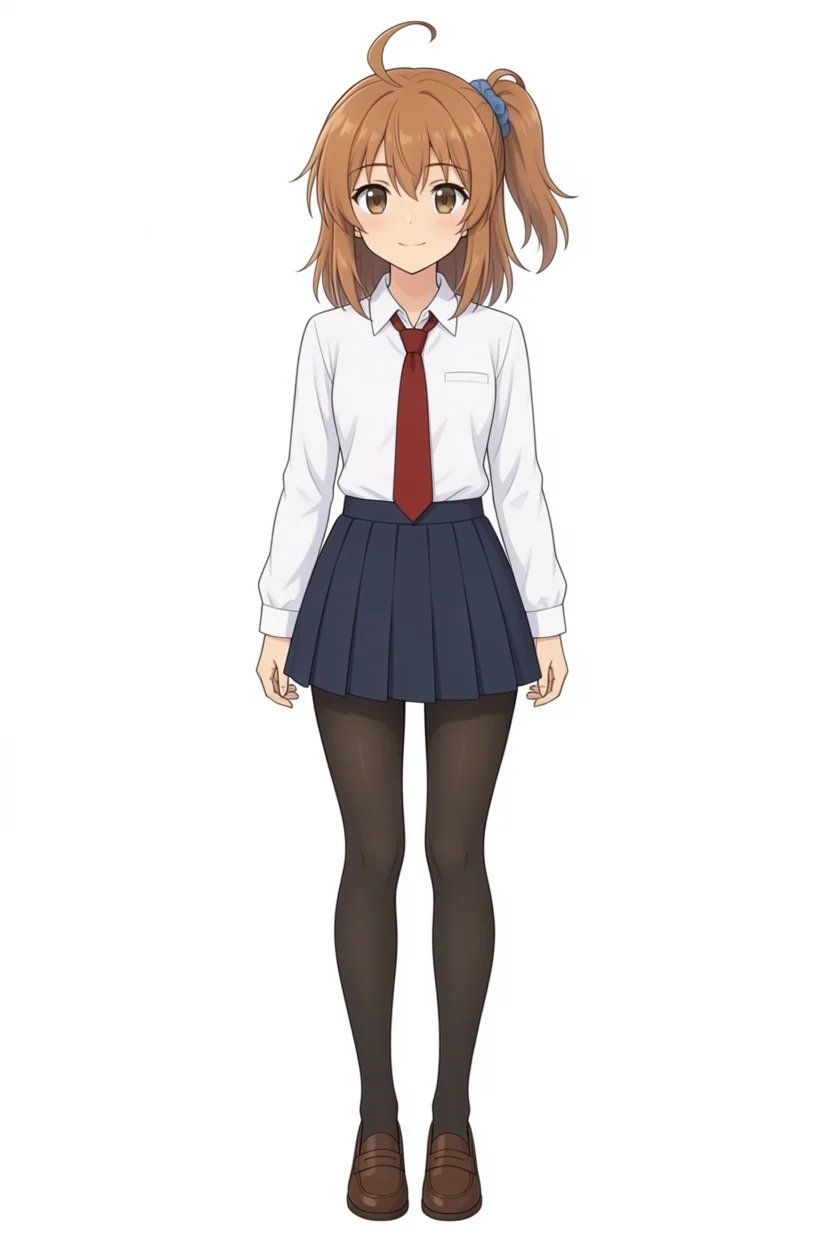
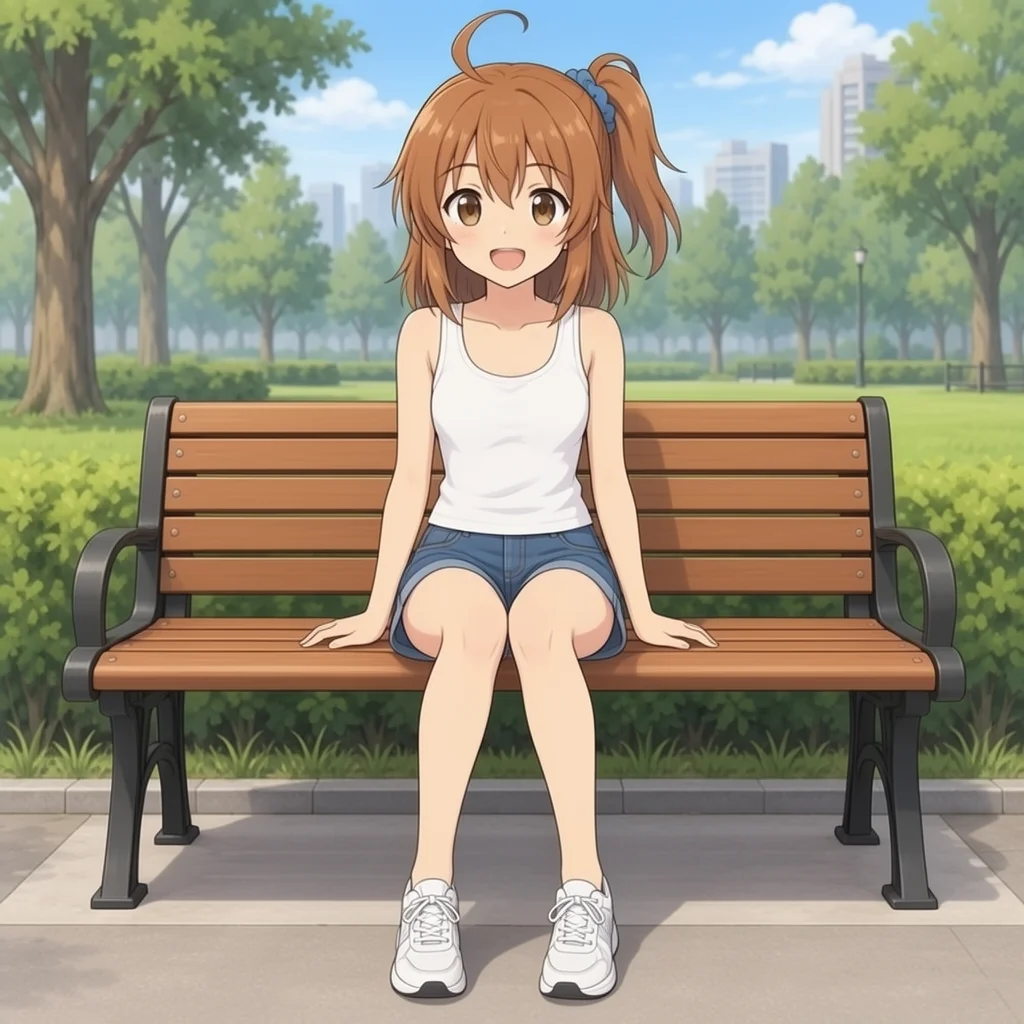
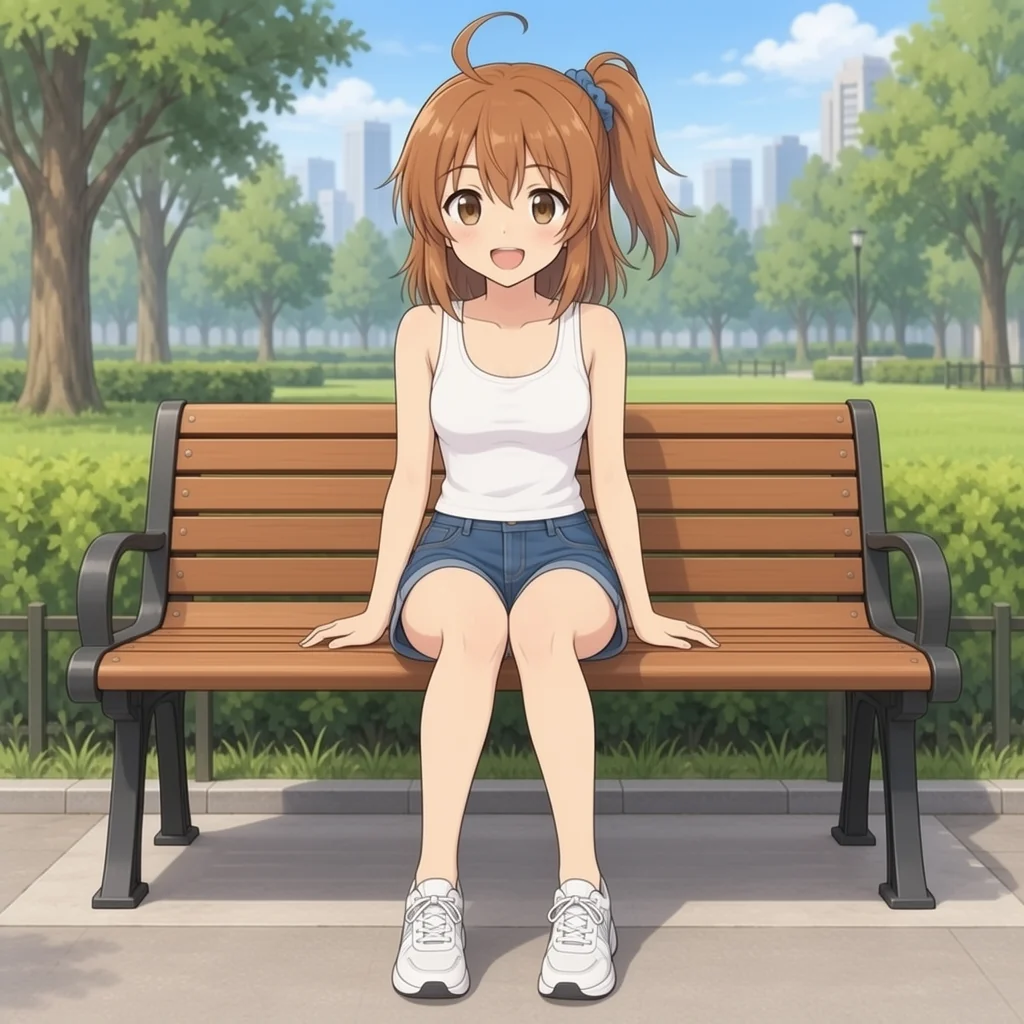
髪型、アホ毛、シュシュはどの案でも変わらずに出た。頭身と体つきは、LoRAではなくプロンプトの記述で動いた。
この4枚は、最初に通常生成と同時に走らせたら、4枚とも色が化けた壊れた画像になった。生成を1つずつに直して出し直したものを載せている。sd.cppの生成はこのマシンで2つ同時に走らせない。
髪の色を学習画像に寄せる書き方
髪の色を数値で比べた。顔のアップを200x200に縮めて8色に減色し、明るい茶色のうち面積がいちばん大きい色を取った。
| 画像 | RGB | 色相 | 彩度 | 明度 |
|---|---|---|---|---|
| 学習画像(kana_0001) | 190, 140, 111 | 22° | 0.42 | 0.75 |
| 3000ステップ、元の書き方(light chestnut-brown) | 191, 128, 93 | 21° | 0.51 | 0.75 |
色相と明るさは合っていて、ずれていたのは彩度だった。橙色に見えるのは、色が濃く出ているため。
髪の色の書き方だけを変えた2案を、3000ステップのLoRA、シード42、4ステップで出した。体つきは案B。
案H1。
soft, muted light brown hair with a dusty beige tint, low in saturation and not orange or reddish,案H2。
pale milk-tea brown hair, colored #BE8C6F in the lit areas and #AB7B5F in the shaded areas,配色の文も chestnut brown から muted light brown に変えた。全文は /home/hide/train/eval_kana_hair.sh にある。
| 書き方 | RGB | 色相 | 彩度 | 明度 |
|---|---|---|---|---|
| 学習画像 | 190, 140, 111 | 22° | 0.42 | 0.75 |
| 元 | 191, 128, 93 | 21° | 0.51 | 0.75 |
| 案H1(くすんだ明るい茶色) | 192, 135, 104 | 21° | 0.46 | 0.75 |
| 案H2(色コード指定) | 200, 143, 109 | 22° | 0.46 | 0.78 |
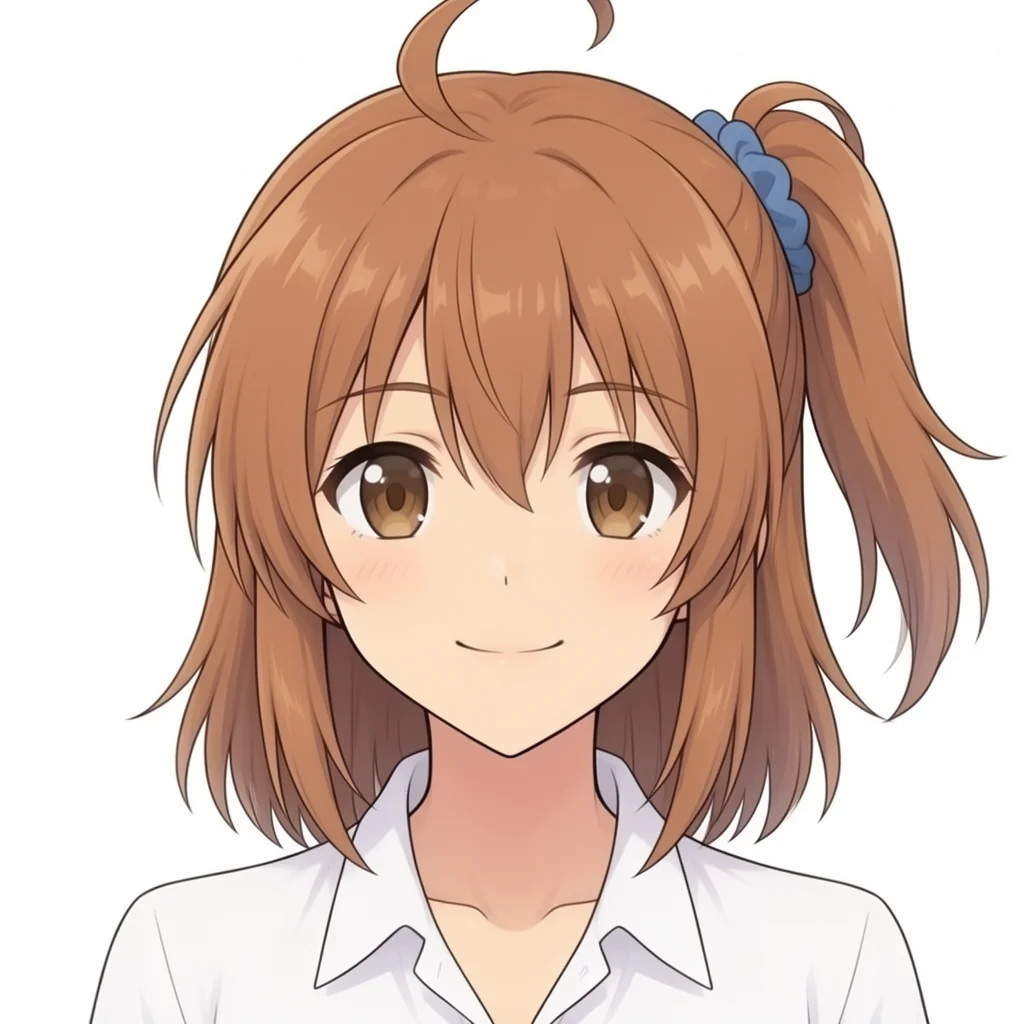
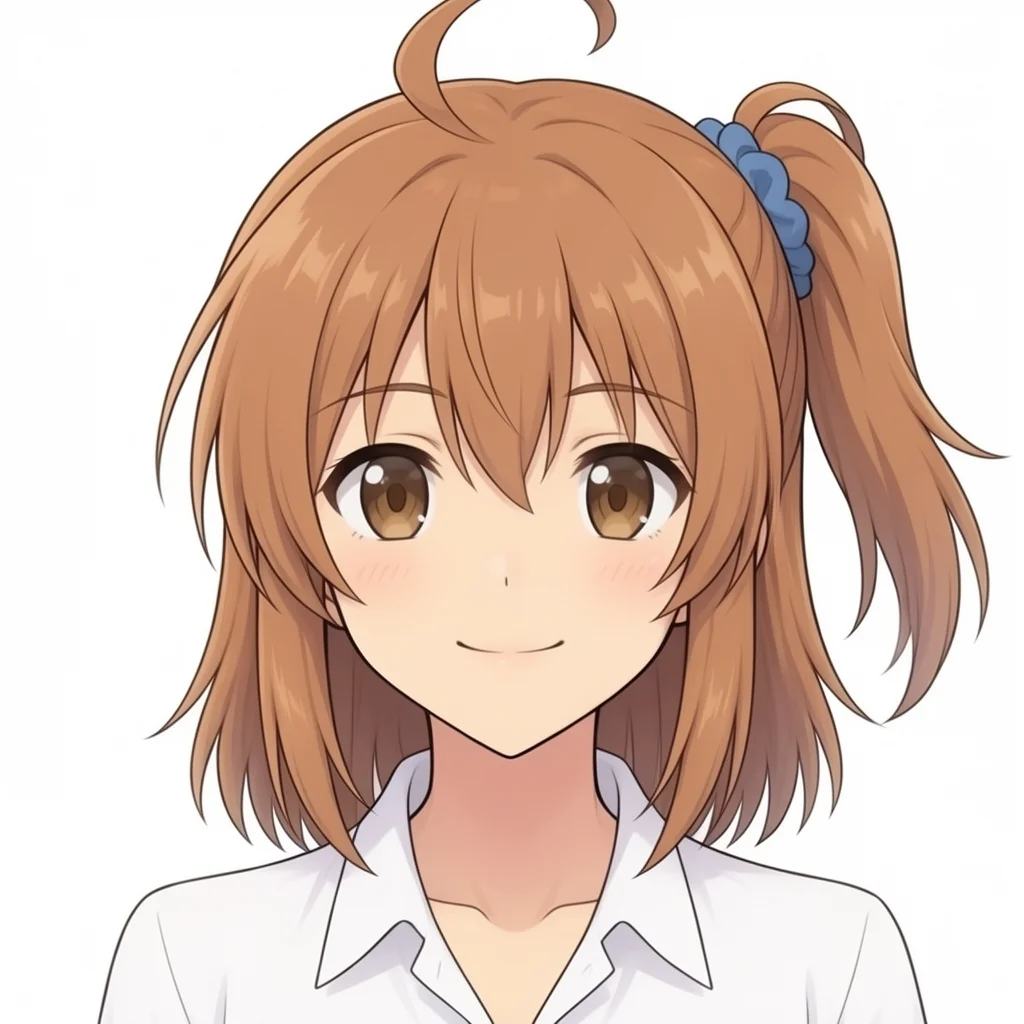
どちらも彩度が0.51から0.46に下がり、学習画像の0.42との差は半分ほどになった。案H1は明るさが学習画像と同じで、3つの中でいちばん近い。案H2は色コードを書いた分だけ寄るわけではなく、少し明るくなった。
比べたのは顔のアップ1枚、シード1つだけ。
学習画像を見て造形を細かく書いた固定文
学習画像の顔のアップと全身を見直して、人物の固定文を書き直した。髪の質感(まっすぐで頭に沿う、毛先が細く不ぞろい)、前髪(目の間に1房)、サイドポニーの太さと長さ、アホ毛の形(前へ巻くかぎ形)、目(カーキ寄りの茶色、白いハイライト1つ)、眉、顔の輪郭、肌の色まで書いた。画風の固定文も、細い焦げ茶の線、影1段の平塗り、髪のハイライトの帯、と具体的にした。全文は /home/hide/train/eval_kana_v2.sh と eval_kana_v3.sh にある。
| 版 | 変えた点 | 結果 |
|---|---|---|
| v2 | 造形と画風を細かく書いた。年齢は16〜17歳の高校生、六頭身半 | 髪がまっすぐになり、量が減って学習画像に近づいた。髪は胸まで伸びて長すぎる。ベンチの場面は幼いまま |
| v3 | 髪は鎖骨までと書き、体つきを案B(10代後半、七頭身)に、目を「大きすぎない」に変えた | 全身は髪の長さが学習画像に近づいた。顔のアップはアホ毛が大きく出た。ベンチの場面はやはり幼い |
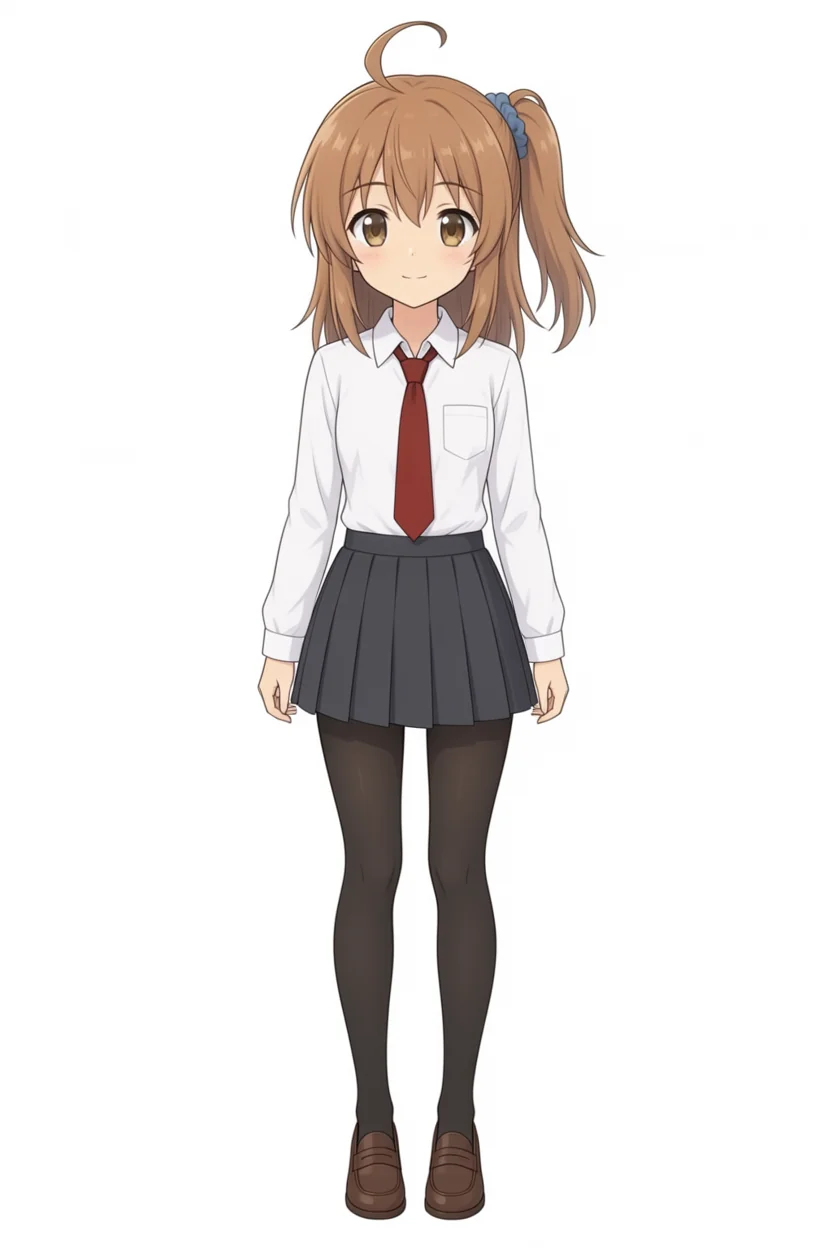
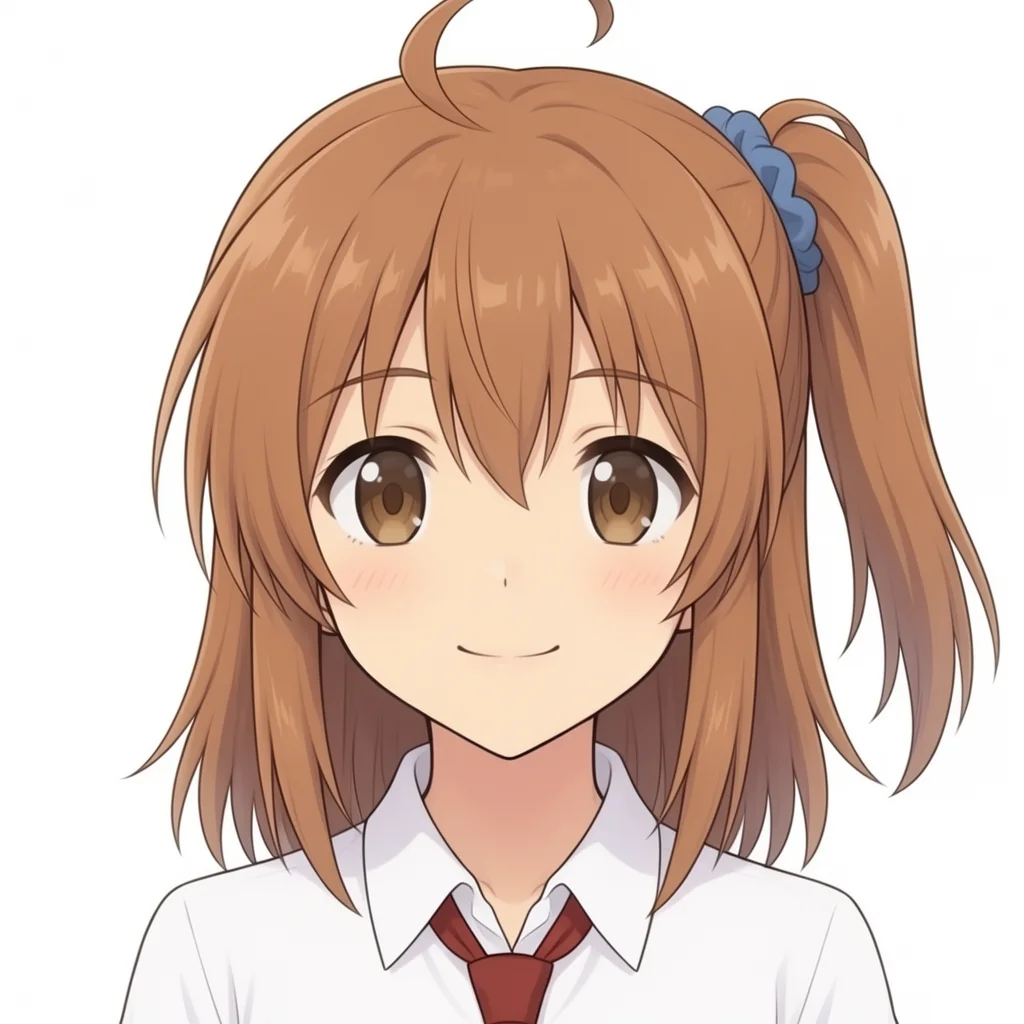
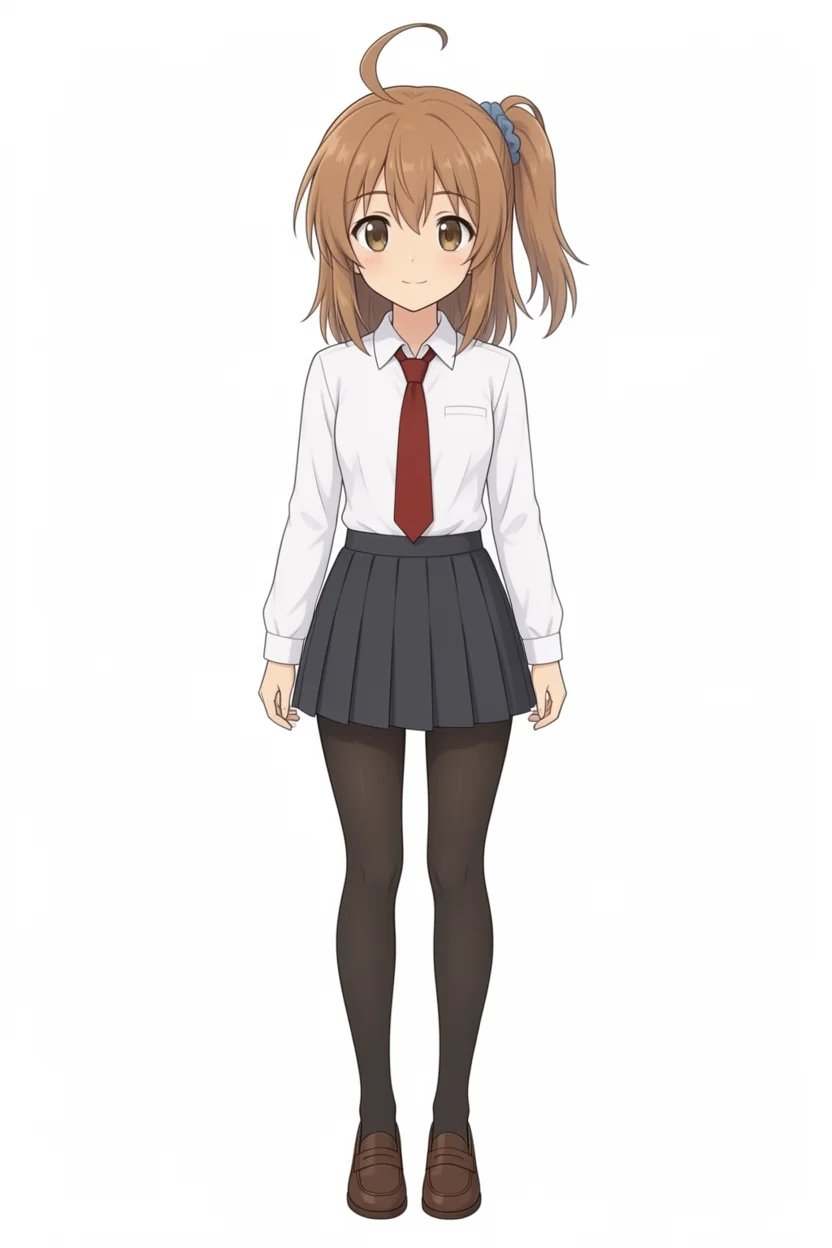
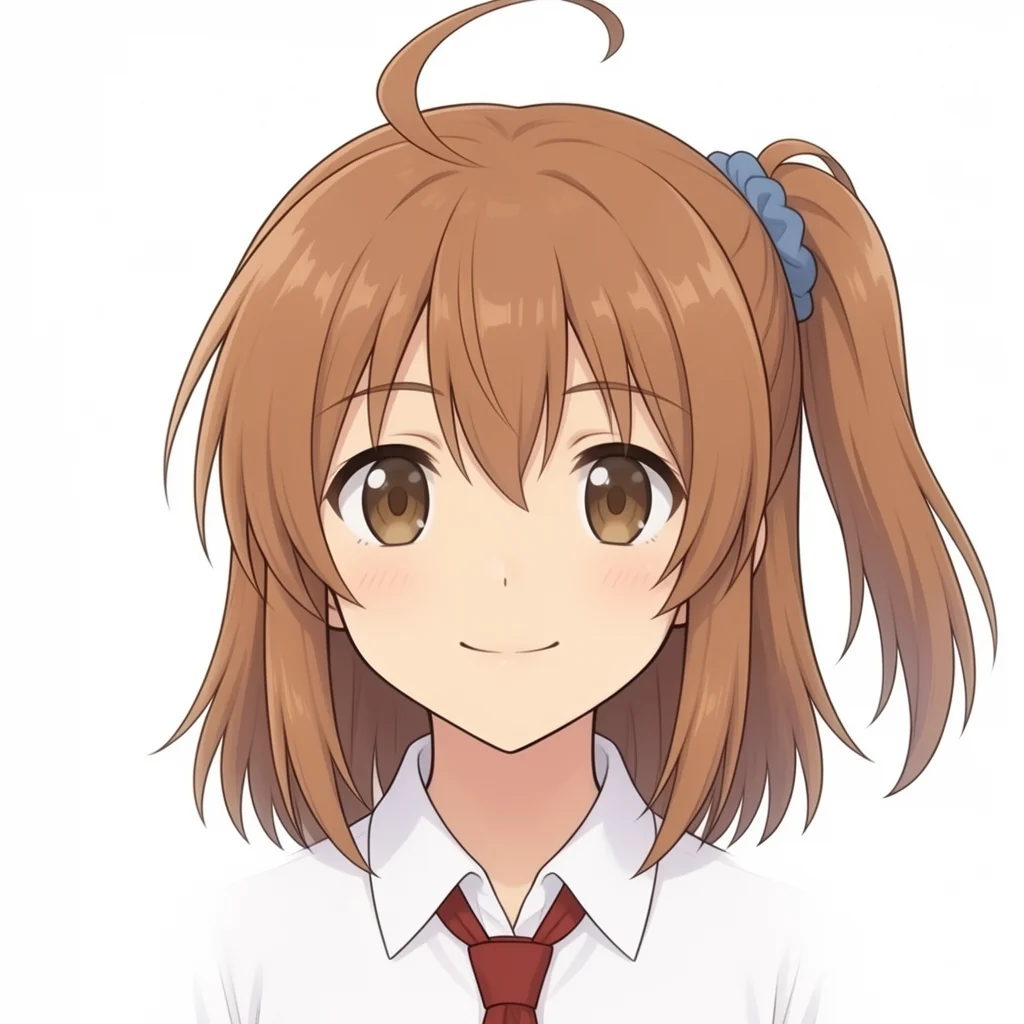
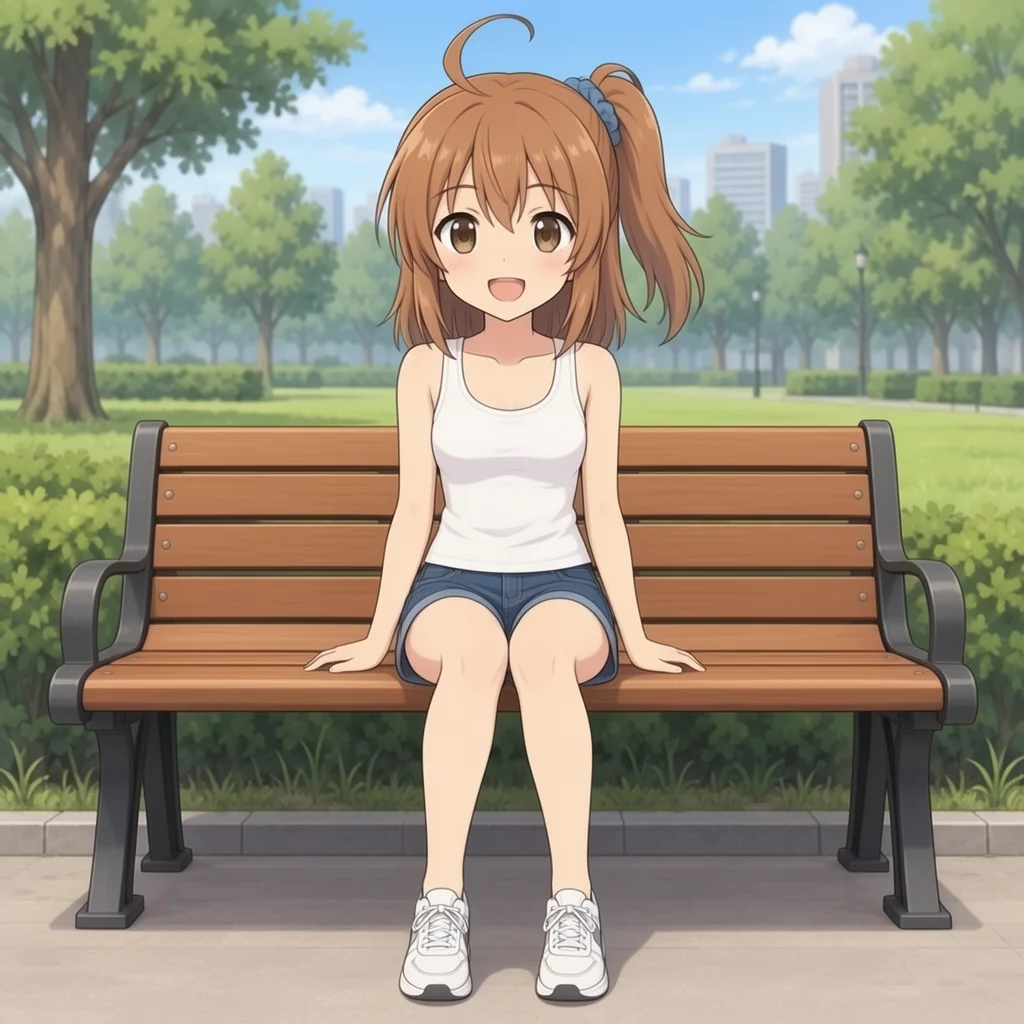
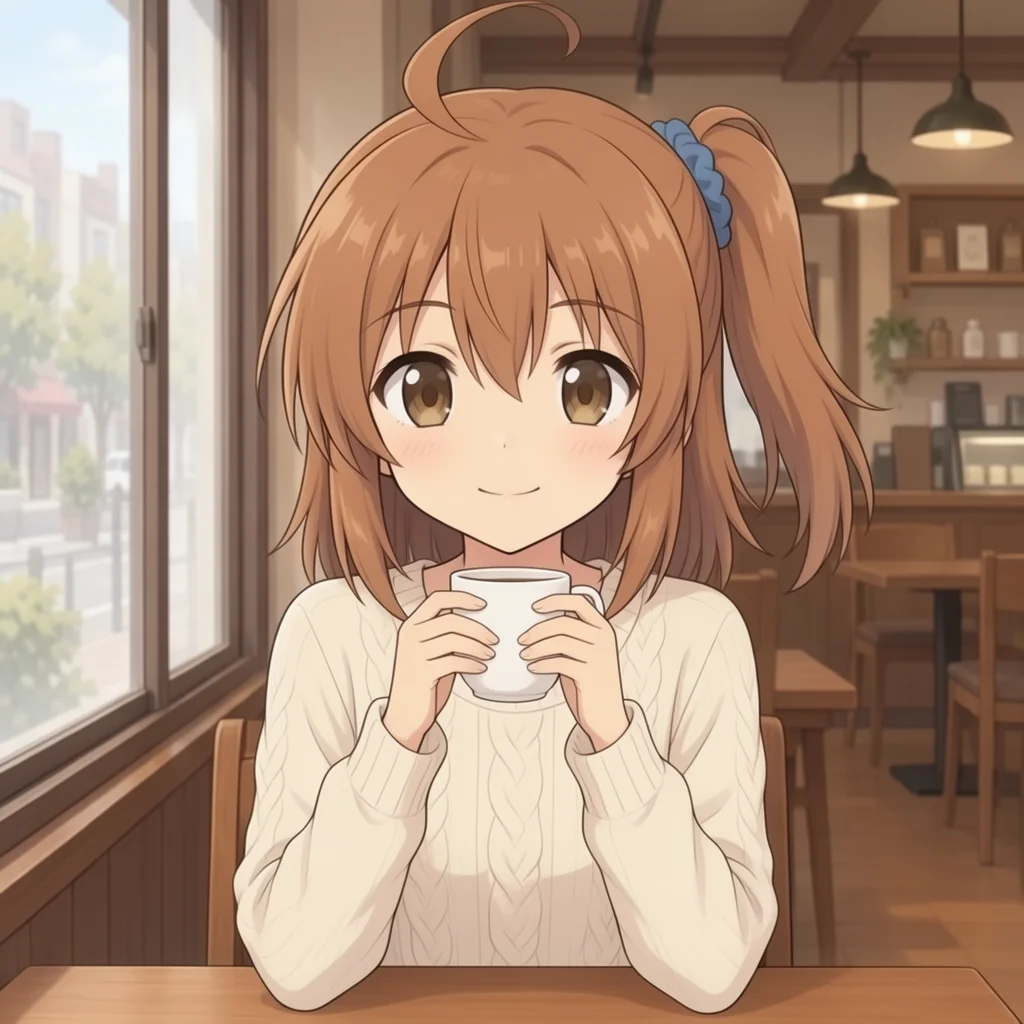
髪の造形はプロンプトで指定すると近づいた。体つきは、案Bだけを変えたときは大人びたのに、顔を細かく書いたv3ではベンチの場面が幼く戻った。「丸い顔」「小さい点の鼻」「頬の赤み」といった顔の記述が、体つきを幼いほうへ引いている可能性がある。確かめてはいない。
タグ形式のプロンプト
mage.spaceのガイドには、アニメ系はタグ形式が合うとあり、順序は品質、スコア、メタ、年、キャラクター、シリーズ、アーティスト、一般タグとされている。文章ではなくタグで、3000ステップのLoRAありとLoRAなしを出した。シード42、4ステップ。
制服の全身のプロンプト。
masterpiece, best quality, score_7, safe, anime coloring, 1girl, solo, kanachan, light brown hair, medium hair, side ponytail, blue scrunchie, ahoge, hair between eyes, brown eyes, blush, small breasts, school uniform, white shirt, collared shirt, long sleeves, red necktie, grey skirt, pleated skirt, black pantyhose, brown footwear, loafers, full body, standing, arms at sides, looking at viewer, closed mouth, smile, straight-on, simple background, white background| 条件 | 制服の全身 | 公園のベンチ |
|---|---|---|
| タグ形式、LoRAなし | 頭が小さく脚が長い。髪は薄い茶色で、別人 | アニメ調で出る。別人 |
| タグ形式、3000ステップ | 頭が小さく、文章形式より学習画像の頭身に近い。髪型とアホ毛も出る | 文章形式のv3より年上に見える体つき |
| 文章形式v3、3000ステップ | 頭が大きめ | 幼く見える |
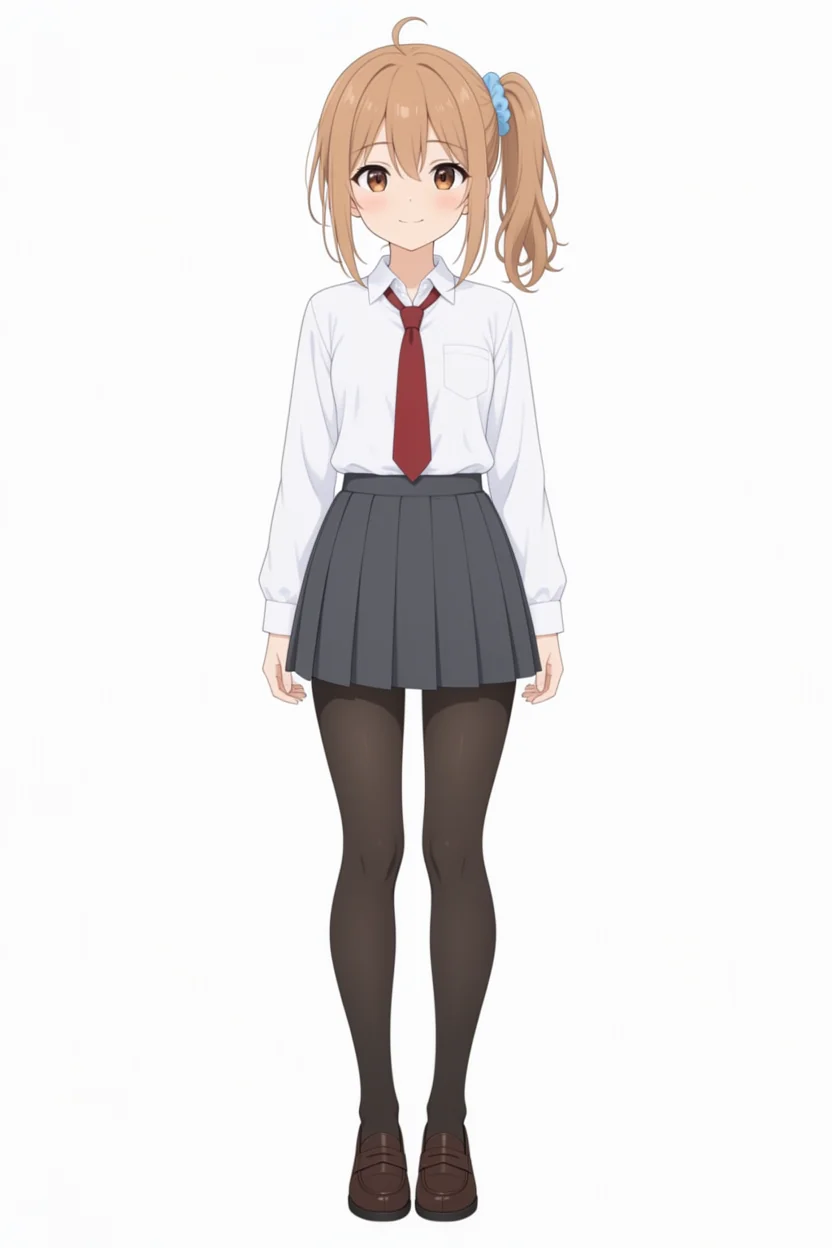
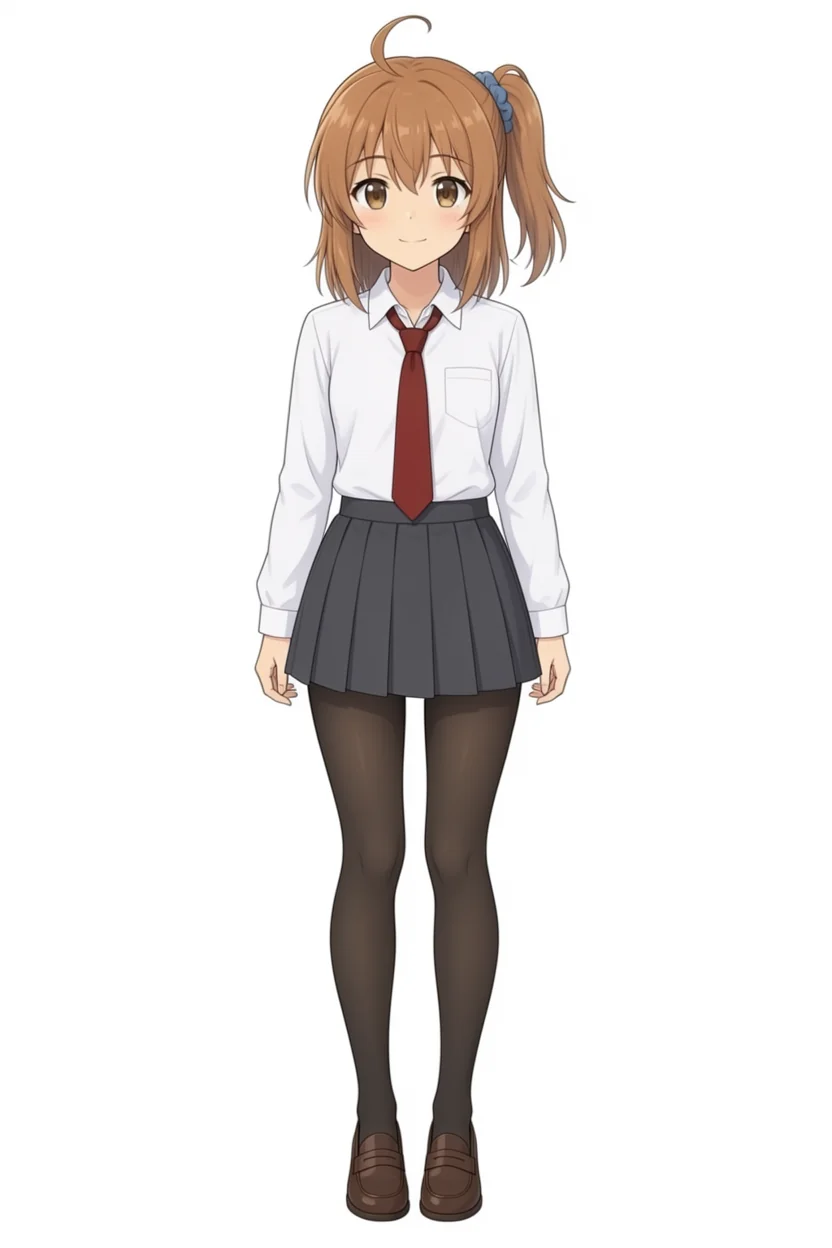
LoRAなしでも、タグ形式なら平らな塗りのアニメ調で、頭身も高く出た。文章形式で苦労した頭身は、タグ形式にしただけで学習画像に近づいた。
今回の学習キャプションは、Anima用のタグ列を消して文章だけにしている。MOSS-Imageがアニメ調をタグと結び付けて覚えているなら、学習キャプションもタグ形式のほうが合う可能性がある。これは学習し直さないと確かめられない。比べたのはシード1つ、2場面だけ。
タグと自然文を組み合わせたキャプション構成案
手順2では、Anima用キャプションの接頭タグと末尾のタグ列を消して、自然文だけにした。タグ形式のプロンプトのほうがアニメ調と頭身が学習画像に近く出たので、次の学習用に、元のAnima用キャプションに近い形のデータセットを別に作った。学習はまだ回していない。
元のAnima用キャプションは、接頭タグ、自然文、danbooruタグ列の順に並んでいる。変えたのは4点。
| 変更 | 内容 |
|---|---|
| 画像の除外 | レーティングがsafe以外の5枚を除く。v1と同じ70枚 |
| 自然文の語 | a young girl と a young slender girl を a girl にした。63枚が該当 |
| 体型と色のタグ | flat chest、slim、brown hair、brown eyes を消した。全身の立ち絵10枚(kana_0054、0056〜0062、0064、0065)だけに入っていた |
| 接頭タグ | score_7 が無かった12枚(kana_addNN)にも入れて、全キャプションの接頭を masterpiece, best quality, score_7, safe, 1girl, solo, kanachan, にそろえた |
できたキャプションの例。
masterpiece, best quality, score_7, safe, 1girl, solo, kanachan, A girl wearing a reddish brown school blazer over a white collared shirt with red necktie. She has an angry expression with a fang and open mouth, captured mid-action with one fist clenched. Her side ponytail with a blue scrunchie is visible on the right side of the image. side ponytail, ahoge, double parted bangs, medium hair, blue scrunchie, reddish brown blazer, white collared shirt, red necktie, angry, fang, open mouth, looking to the side, upper body, action pose, white background, simple background語数は最小36、平均70.8、最大111。v1のキャプションより長い。
体型と髪・目の色は、キャプションに書かずにトリガーワードの kanachan へ吸収させる。書いてあると、その特徴は名前ではなく説明の語と結び付いて学習され、生成のたびに書かないと出なくなる。v1で髪型がそうなった。
髪型のタグ(side ponytail, ahoge, double parted bangs, medium hair, blue scrunchie)と、サイドポニーの位置を書いた自然文は、元のキャプションのまま残している。
| 置いた場所 | 中身 |
|---|---|
/home/hide/train/datasets/kana_moss_v2/ | PNG 70枚とTXT 70個 |
/home/hide/train/build_kana_moss_dataset_v2.py | 変換スクリプト |
/home/hide/train/kana_moss_v2_captions.jsonl | 元のキャプションとの対応表 |
/home/hide/train/configs/kana_moss_v2.yaml | v1の設定から、名前とデータセットの場所を変え、ステップ数を2000に戻したもの |
他のLoRA公開例との比較
手順1の調査は、キャプションの書き方に絞っていた。キャラが似ない原因を切り分けるため、MOSS-ImageのLoRAを公開している人と学習ツールの文書を、2026年11月16日に読み直した。どのページも要約ツール経由で読んでいて、原文の全文は確認していない。
| 出どころ | 内容 |
|---|---|
| tachiyumi/MOSS-Image-LoRAs | アニメキャラのLoRA 4本。MOSS-Image Baseで学習、rank 32。キャプションは自然文の書き直しで、タグ列ではない。髪や目などトリガーが受け持つ外見はキャプションで繰り返さない。使うときは alya(anime), <説明> のようにトリガーを先頭に置いた自然文。推論はEuler、50ステップ、CFG 3.0 |
同じリポジトリの loras.json | 学習は100件で10,000ステップ、90件で1,800ステップ、120件で12,000ステップ、60件で6,000ステップ。件数の単位は原文では frames(アニメのコマ画像とみられる)。強さは0.85〜1.0 |
| imagelora.devのガイド | LoRAに焼き込みたいものはキャプションに書かず、変えたいものだけを書く。似せるには100〜200枚がよい。ステップ数は少ないデータセットで約2,000、キャラは約3,000。ふつうのLoRAなら、いつもより高いrankを試す。LoRAを判定するときはCFGを3〜4に上げる |
| kohya-ss/sd-scriptsの文書 | MOSS-ImageはLLMが書いた長い自然文キャプションで学習されている。事前学習のタイムステップ分布は truncated_logit_normal で再現できる。sd-scriptsの既定は sigmoid で、文書は両者の差には触れていない |
| sorryhyun/anima_loraのMOSS用文書 | Anima風のタグキャプションでも学習はできるが、既定ではMOSSのJSON形式へ変換する。品質タグは学習キャプションから外す。既定はrank 32、学習率5e-5 |
| axiomofmind/Moss-image-anime-lora | 画風LoRA。79枚、2,000ステップ、rank 16、学習率1e-4、自然文キャプション。Baseで学習してSFTで推論 |
| Raehoshi Moss Image | アニメ系を約1万枚学習した派生チェックポイント。フルタグ、長い自然文、中くらい、短い、の4形式のキャプションで学習している |
今回の学習と比べた違い。
| 項目 | 今回 | 調べた例 |
|---|---|---|
| キャプション | 自然文。髪型の説明が70枚中49枚に残っていた | 自然文。トリガーが受け持つ外見は書かない |
| rank | 16 | アニメキャラの4本は32 |
| ステップ数 | 70枚で2,000〜3,000(1枚あたり約29〜43回) | アニメキャラの4本のうち3本は1件あたり100回、1本は20回 |
| タイムステップの取り方 | ai-toolkitの既定(sigmoid)のまま | sd-scriptsの文書は、事前学習に合わせた設定を別に用意している |
固定の特徴をキャプションに書かない点は、それに触れていたairmore.ai、imagelora.dev、tachiyumiの3つで同じ方向だった。タグ形式で学習したキャラLoRAの実例は、この調査では見つからなかった。Raehoshiはタグでも学習しているが、1万枚規模のチェックポイントで、70枚のLoRAにそのまま当てはまるかは分からない。
ステップ数は例によって1件あたり20回から100回まで開きがあり、どれが正しいとは言えない。rankやタイムステップの取り方が今回の結果にどう影響したかも、切り分けられていない。
アニメ系派生モデルへのLoRA適用
Raehoshi Moss Image v1.0は、MOSS-Image Baseにアニメ系の画像を約1万枚学習させた派生チェックポイント。配布ページによると、最後にMOSS-Image SFTから抜き出したLoRA(rank 128)をマージしている。bf16版(10,164,655,824バイト)を落として、3000ステップのLoRAがそのまま使えるかを見た。
配布ページの推奨設定はER SDE、SGM Uniform、30〜50ステップ、CFG 4.0〜5.0で、SLG(層22、24、26、開始0、終了0.5)は必須とされている。sd.cppでは次の指定で通り、ログに Skipping layers at uncond step と出た。
--sampling-method er_sde --scheduler sgm_uniform --steps 30 --cfg-scale 4.5 \
--skip-layers "[22,24,26]" --skip-layer-start 0 --skip-layer-end 0.5 \
--extra-sample-args slg_uncond=1
プロンプトは手順12のタグ形式と同じ。シード42。ネガティブプロンプトは worst quality, bad anatomy, watermark, jpeg artifact。
| 条件 | 生成時間 | 制服の全身 | 公園のベンチ |
|---|---|---|---|
| 推奨設定、LoRAなし | 722秒、747秒 | 薄い金茶の髪の別人。ゲームのキャラ絵に近い描き込み | 別人 |
| 推奨設定、3000ステップ | 691秒、723秒 | 茶髪、アホ毛、青いシュシュのサイドポニーが出る。頭が小さく、学習画像の頭身に近い | サイドポニーと茶髪は出る。体つきは大人びている。全身は枠に入らず、ひざから下が切れた |
| 4ステップLoRA併用、3000ステップ | 59秒、62秒 | 推奨設定とほぼ同じ人物が出る | 人物は出るが、構図が崩れて手や小物が乱れた |
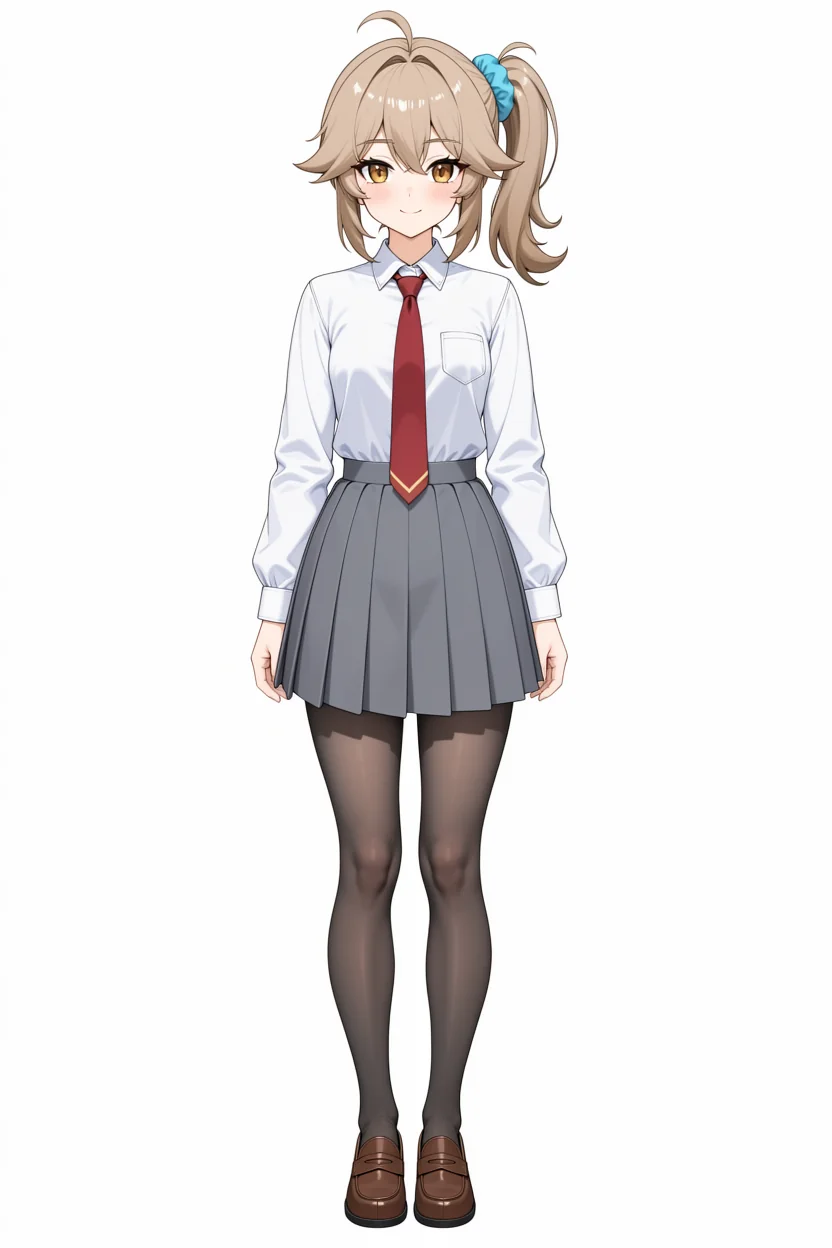
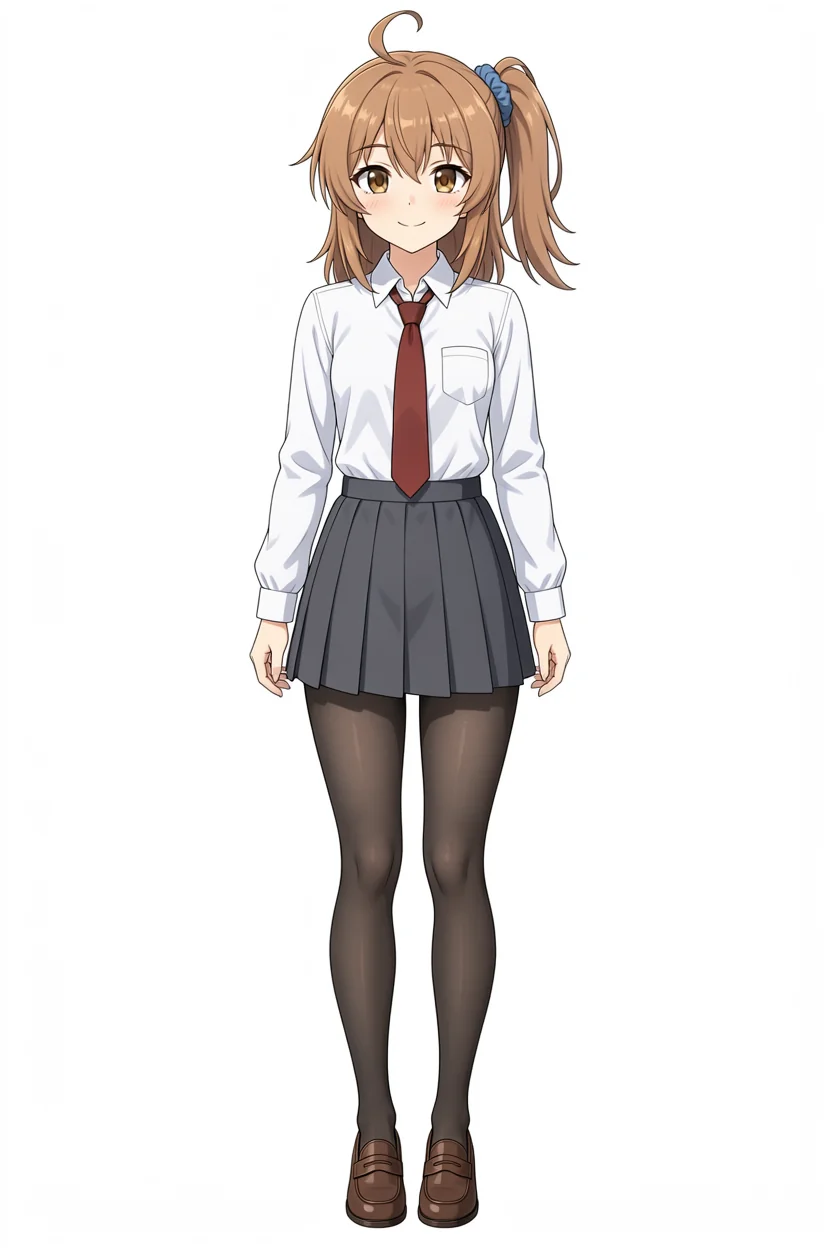
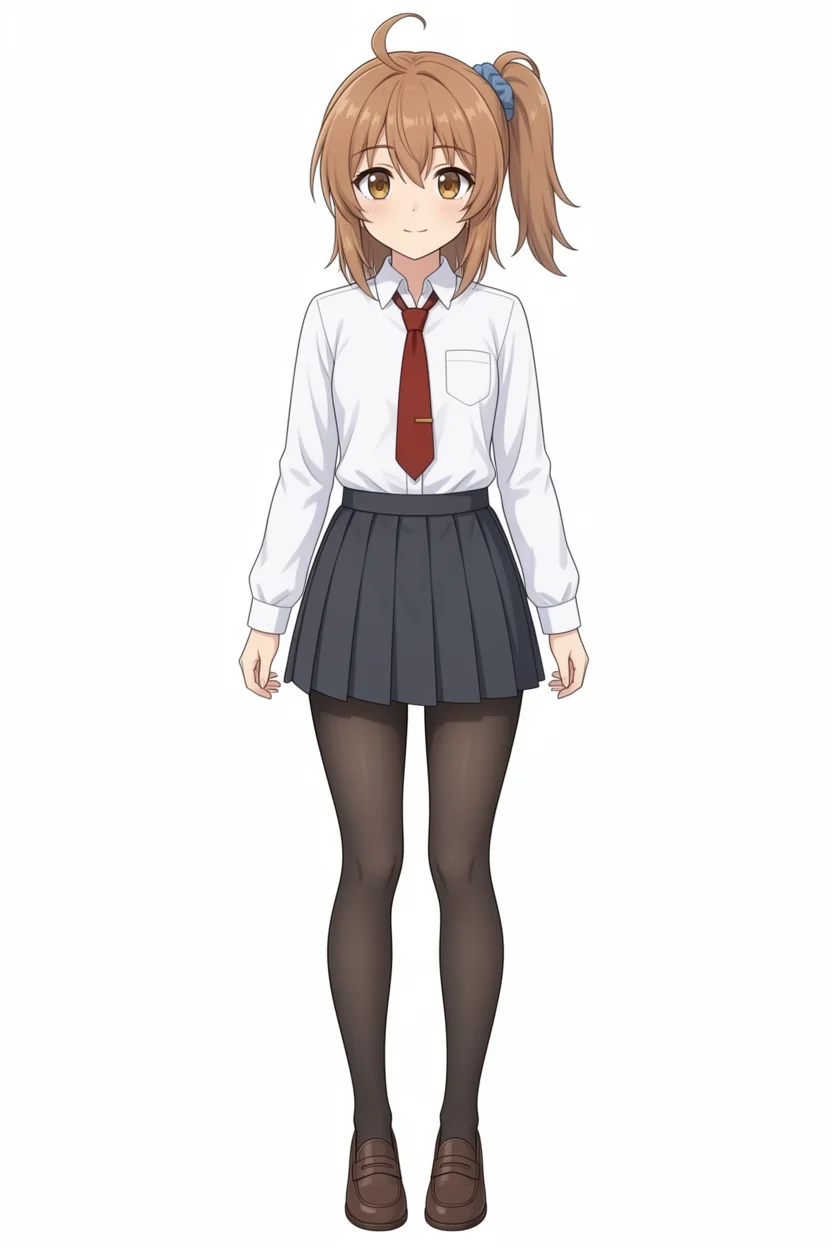
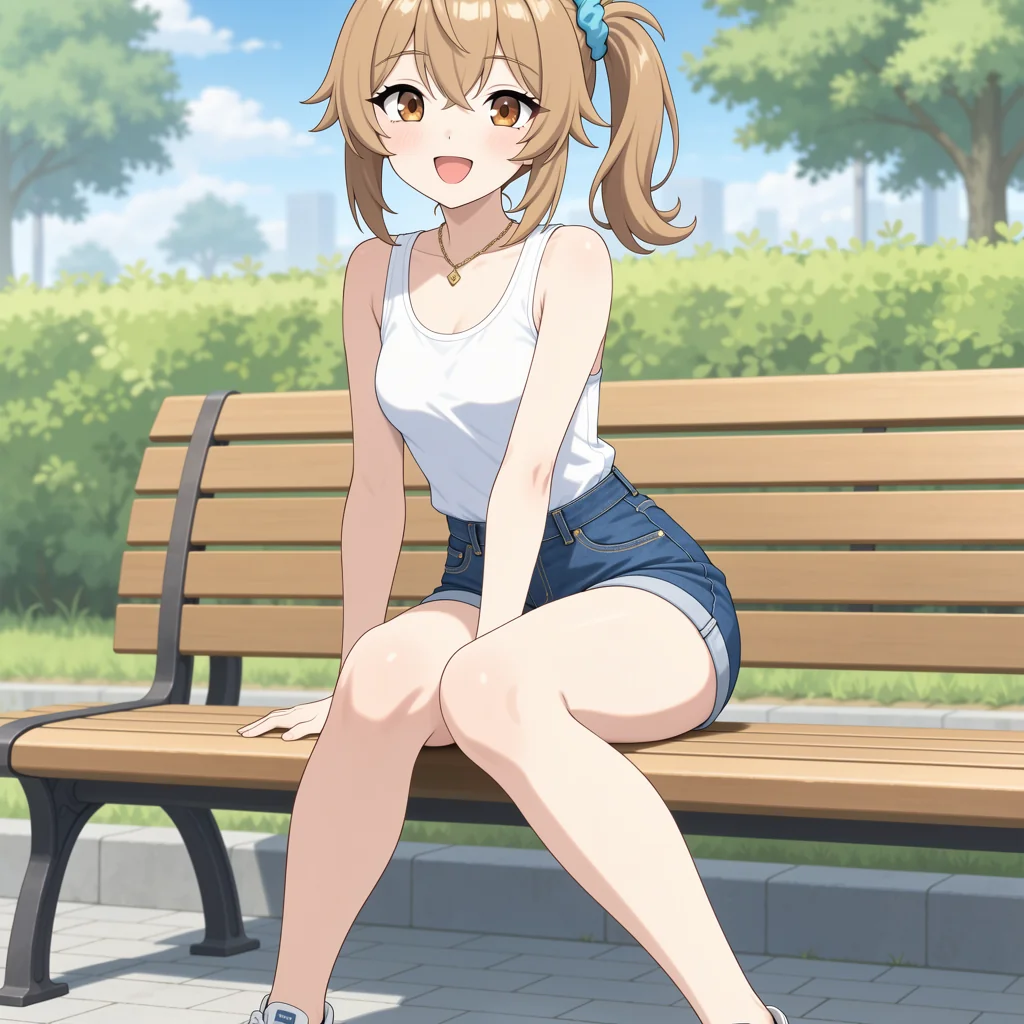
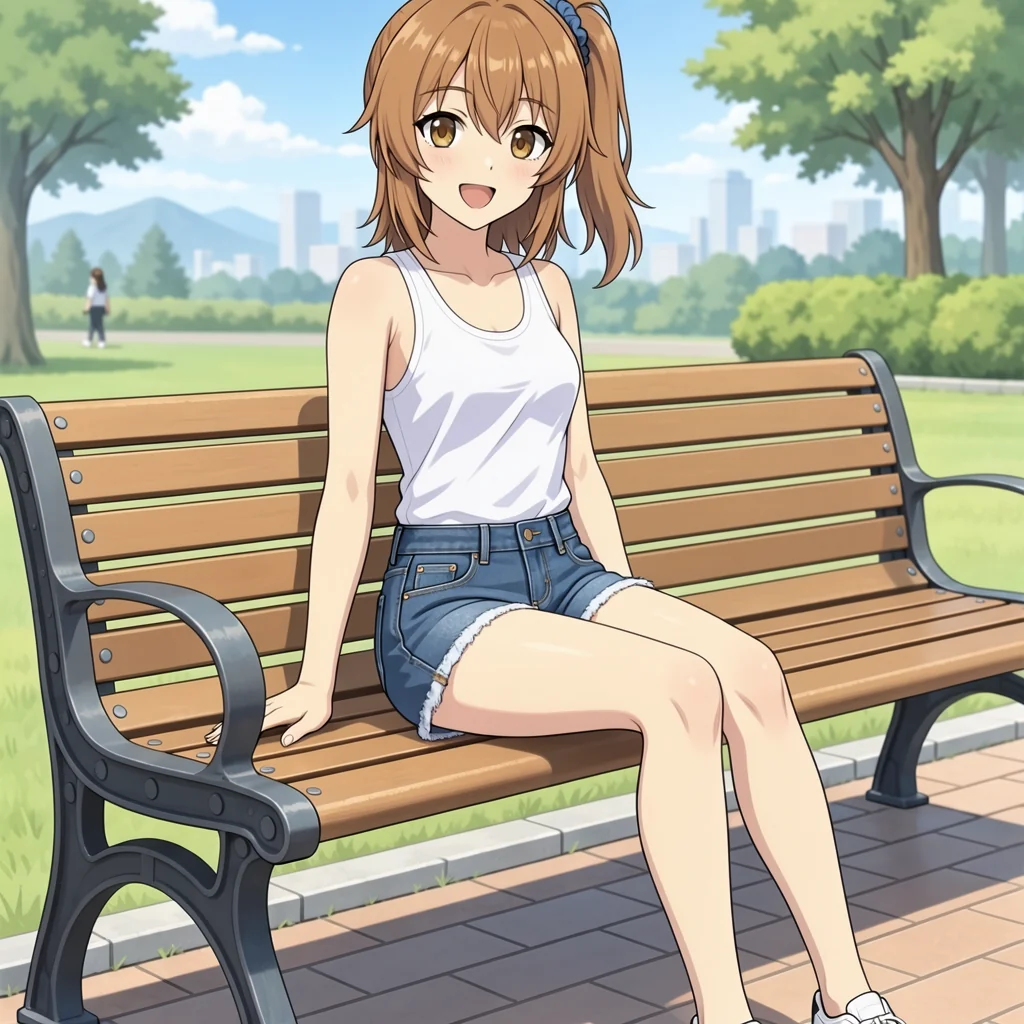
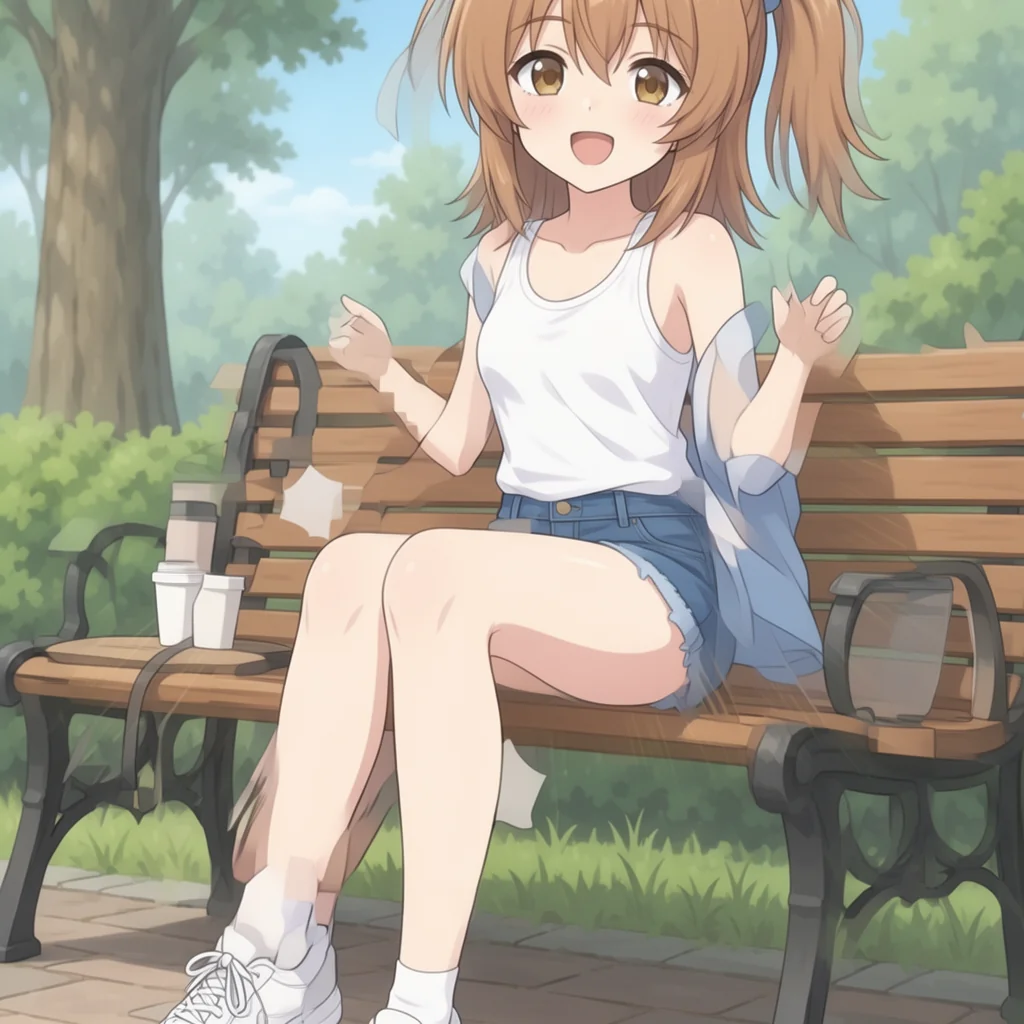
MOSS-Image Baseで学習したLoRAは、派生モデルにもそのまま当たった。LoRAなしでは別人、LoRAありでは髪型と髪色がそろう。絵柄は派生モデル側の描き込みの多い塗りになり、学習画像の平らな塗りとは違う。
SFT用の4ステップLoRAも派生モデルで動いたが、ベンチの場面は崩れた。派生モデルと4ステップLoRAの組み合わせは、単純な構図に限られそうだ。比べたのはシード1つ、2場面だけ。
実機検証のまとめと今後の課題
このマシンでの学習はここで止める。分かったことと、次に確かめること。
| 分かったこと | 根拠 |
|---|---|
| EVO-X2のROCmで、MOSS-ImageのLoRAを1024pxで学習できる | 3000ステップまで完走。1ステップ約35秒、2000ステップで約19時間 |
| 学習したLoRAは、SFT、SFTと4ステップLoRA、アニメ系の派生モデルのどれでも当たる | 手順7、11、15 |
| 名前だけではキャラが出ない | 髪型の説明がキャプションの70枚中49枚に残っていた。手順10 |
| 2000から3000へ回数を足しても、変わったのは目の色だけ | 手順12 |
| 頭身と体つきは、プロンプトの書き方で大きく動く | 年齢の記述とタグ形式。手順12 |
| 次に確かめること | 内容 |
|---|---|
| キャプション | 固定の特徴(髪型、髪と目の色、体型)を書かずにトリガーへ吸収させるか。Animaでは吸収しきれず髪型を書いていた経緯があり、MOSS-Imageで同じになるかは分からない |
| キャプションの形式 | 自然文だけにするか、Anima形式に近いタグと自然文にするか。タグ形式で学習したキャラLoRAの実例は見つかっていない |
| rank | 16のままか、実例に多い32にするか |
| ステップ数 | 実例は1件あたり20回から100回まで開きがある |
| タイムステップの取り方 | ai-toolkitの既定(sigmoid)のままでよいか |
1ステップ35秒では、この組み合わせを1つずつ試すのに1回19時間以上かかる。条件を変えて比べる段階は、RunPodなどのNVIDIAのGPUで回す。手順13で作ったデータセットv2は、その出発点として残してある。