Animaで描いたキャラの絵をMOSS-Imageの4ステップI2Iで描き直してみた
 目次
これまでの検証では、オリジナルキャラクター「かな」の画像をAnima系のwaiANIMAと、専用のキャラクターLoRAを組み合わせて出力してきた。
一方で、MOSS-Imageは英数字の文字描画とリアルな写真質感に優れたモデルだが、MOSS-Image用にはかなのLoRAが存在しない。ベースモデルの構造が異なるため、Anima用のLoRAをそのままMOSS-Imageに読み込ませることもできない。
MOSS-Image上でこのキャラクターを扱うには、Animaで生成した絵を画像から画像への変換(Image-to-Image / I2I)の入力として渡し、MOSS-Image側で描き直させる方法が考えられる。
M1 Max上のMOSS-Imageは、標準の25ステップだと1枚の生成に約10分かかる。
しかし、4ステップLoRAを適用した構成であれば1枚50秒前後まで短縮できるため、パラメータを変えながら複数枚を試す作業も現実的になる。
そこで、4ステップ化したMOSS-ImageにAnimaの絵を入力し、看板への英字入れ、1.5倍の高解像度化、写真風への変換を試してみた。
検証環境
| 項目 | 内容 |
|---|---|
| マシン | MacBook Pro M1 Max、メモリ64GB、macOS 27.0 |
| GPU | MPS(Apple GPU) |
| ComfyUI | v0.43.0、Python 3.12.12、PyTorch 2.15.0 |
| ノード集 | HaDeS MOSS Suite 88839e0(MOSS KSamplerを使用) |
| 画像生成モデル | moss_image_sft_bf16(Comfy-Org/MOSS-Image) |
| 4ステップLoRA | akhaliq/MOSS-Image-SFT-4-stepsの moss_image_sft_4step_v2.0.safetensors、強さ1.0 |
| テキストエンコーダー | qwen3.5_9b_bf16 |
| VAE | flux2-vae |
| サンプラー | MOSS KSampler、euler、simple、4ステップ、CFG 1 |
| 入力の絵 | waiANIMA+かなLoRA(rework-v4 ep150)+Turbo LoRA(832×1024)。看板持ち、バストアップ、全身の3構図(各2枚) |
| シード値 | 1000、1001。入力2枚×2シードで各条件4枚を生成 |
ワークフローは、Animaで出力した画像を LoadImage から VAE Encode ノードへ通し、潜在画像として MOSS KSampler に入力する構成とした。
生成時間は、832×1024で1枚約38秒、1.5倍に拡大した1248×1536で約102秒だった。
実行中の物理メモリ消費量は最大47GBに達した。
4ステップ時のdenoiseと開始ノイズの粗さ
最初に denoise(ノイズ除去強度)を0.3、0.5、0.6、0.7、0.8、0.9と変化させてみたところ、0.7と0.8の出力結果が16組すべてピクセル単位で同一になった。
ComfyUIの KSampler は、denoise が1未満の場合に int(ステップ数 / denoise) ステップ分のスケジュールを内部で生成し、その末尾の指定ステップ数分だけサンプリングを実行する仕様になっている(comfy/samplers.py の set_steps)。
4ステップ生成において各 denoise で計算されるスケジュールは次の通りだ。
| denoise | 作成されるスケジュール | 実際の開始ノイズ強度 |
|---|---|---|
| 0.3 | 13ステップ | 0.69 |
| 0.5 | 8ステップ | 0.83 |
| 0.6 | 6ステップ | 0.91 |
| 0.7、0.8 | 5ステップ | 0.95 |
| 0.9 | 4ステップ | 1.00 |
ノイズ強度は、simple スケジューラーと shift 5.0 から算出される値で、1.0は入力画像の情報が完全に失われてゼロから生成する状態を意味する。
denoise 0.9 では4ステップ分のスケジュール全体をそのまま回すことになるため、実質的に入力画像を参照しないテキストからの新規生成と同じ挙動になる。実際、看板の入力画像でシード1000を指定した際、空の潜在画像から生成した出力と denoise 0.9 の出力はピクセル単位で完全に一致した。
スケジュールのステップ数は整数で計算されるため、4ステップ運用では5ステップ分(ノイズ0.95)の次が4ステップ分(ノイズ1.00)に飛んでしまい、その中間のノイズ強度は通常の denoise パラメータでは指定できない。ステップ数が少ない構成ほど、1.0手前の刻みが極端に粗くなる。
看板への文字入れ
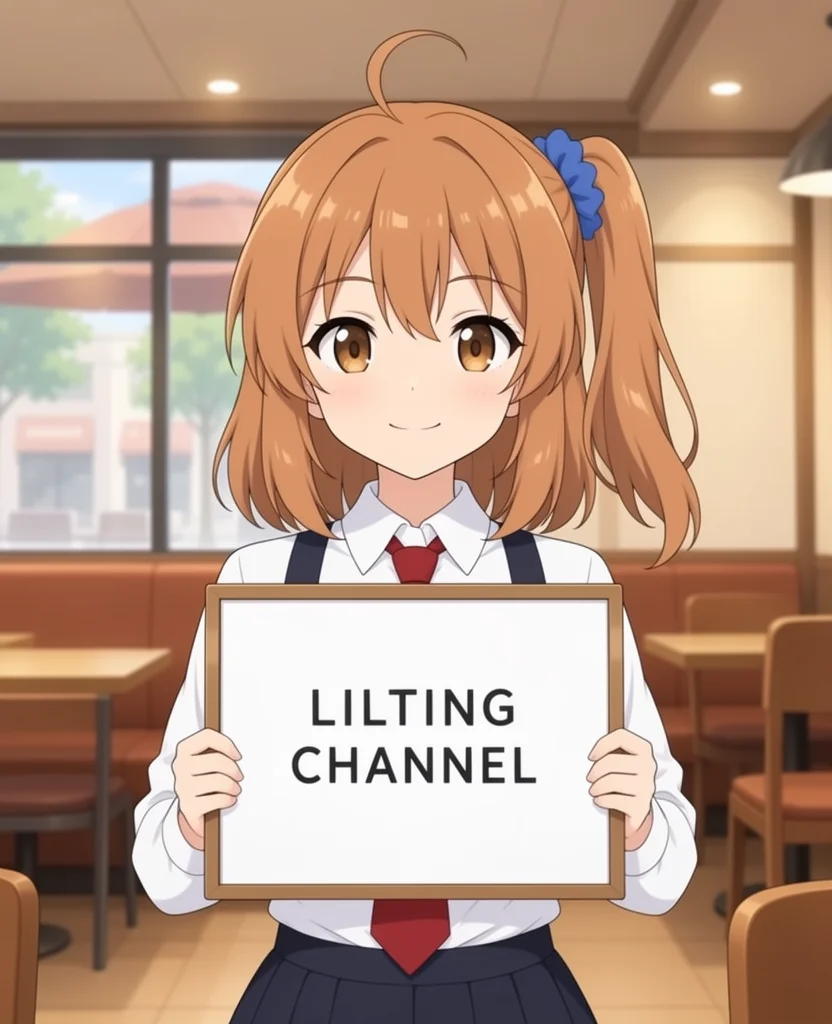
白い無地の看板を両手で持っているイラストを入力とし、プロンプトで「LILTING CHANNEL」という文字を入れるよう指示した。
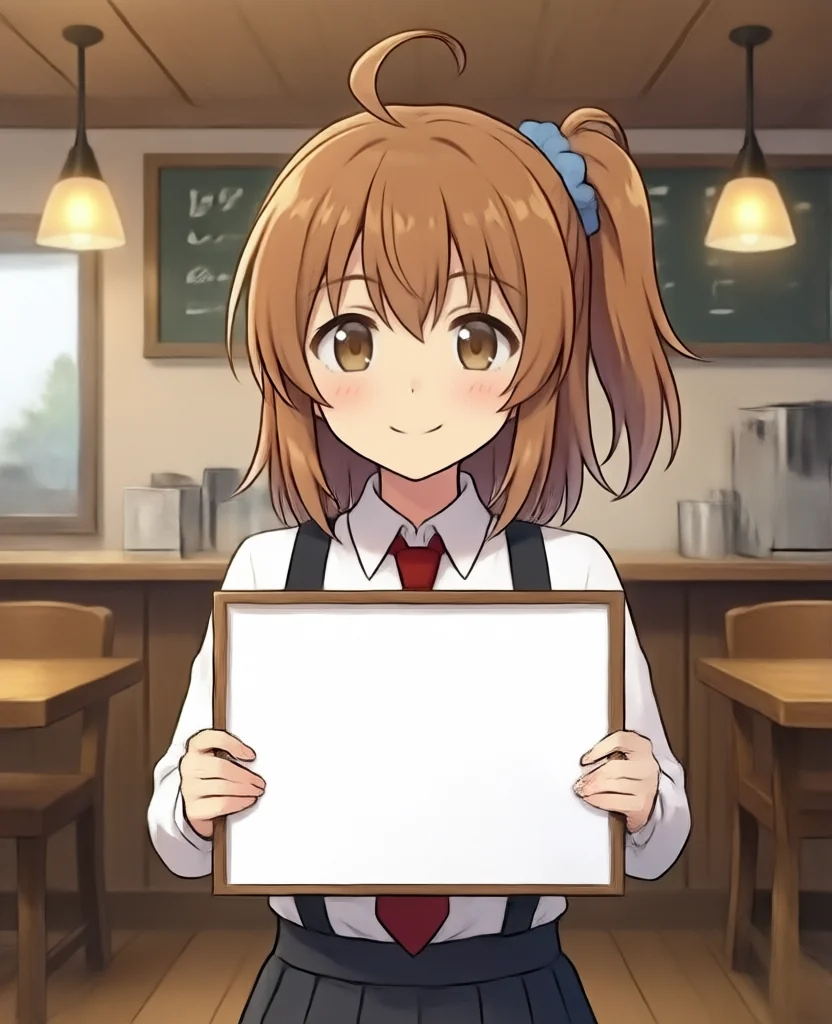
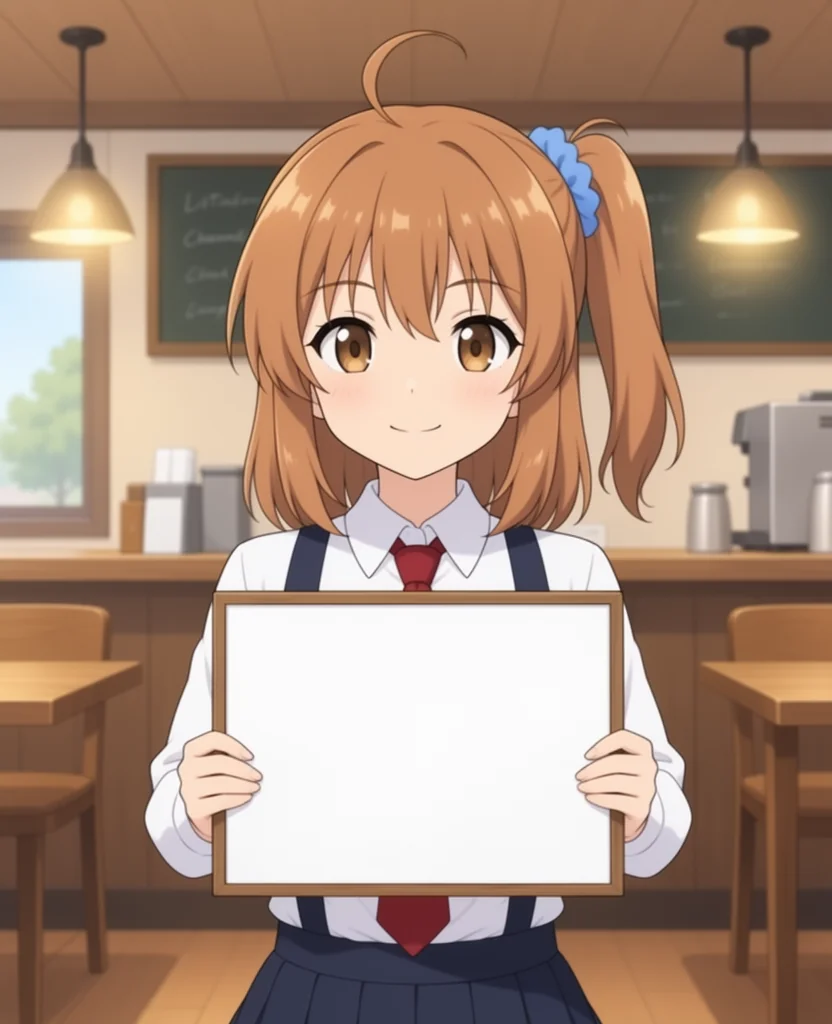
denoise 0.6 以下では、4枚とも看板は白い無地のまま文字は描画されなかった。
一方、denoise 0.7(開始ノイズ0.95)に上げると、4枚すべてで「LILTING CHANNEL」の英文字列が正確な綴りで看板に描かれた。
サイドポニー、青いスクランチー(シュシュ)、頭頂部のアホ毛、シャツとネクタイといったキャラクターの特徴も維持され、背景の店内のみがMOSS-Imageらしい質感に描き直された。
1.5倍の高解像度化
街を背景にした全身イラストを、ImageScaleBy ノードのランチョス補間(Lanczos)で1.5倍(1248×1536)へアップスケールした上でエンコードし、denoise 0.3、0.5、0.7、0.9で描き直した。
顔周辺を切り出し、単にランチョス補間で拡大しただけの画像と並べて比較した。
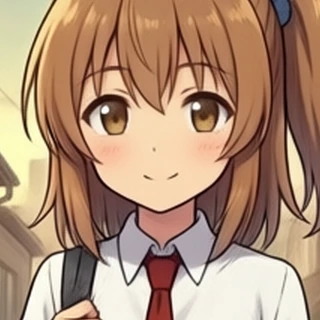
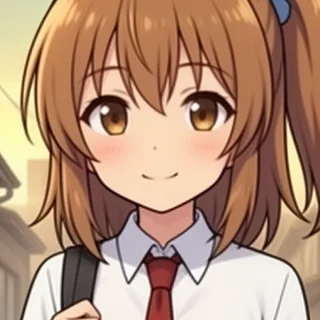
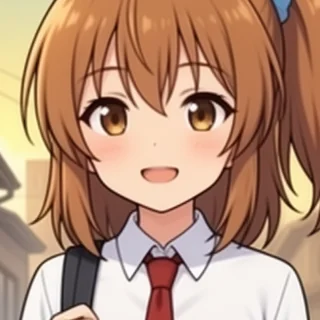
denoise 0.3(開始ノイズ0.69)では、元の表情と構図を維持したまま、拡大処理によってぼやけた主線がくっきりと鮮明に補正された。
denoise 0.5 に引き上げると、閉じていた口が開くなど表情に変化が生じた。さらに0.7以上になると、背景の時間帯や街並みの構造自体が別のものへと置き換わった。
写真風への変換
バストアップのイラストを入力とし、実写の写真として描き直すようプロンプトで指示した。
通常の KSampler で denoise を0.3〜0.8に設定した場合、いずれもアニメ調のタッチのまま維持された。denoise 0.9 では前述の通り元画像の情報が失われるため、標準の denoise 指定ではキャラクター性を残した写真にはならなかった。
写真タッチへの切り替わりがノイズ強度0.95と1.00の間にあるとすれば、標準の denoise ではその中間値を指定できない。
そこで、ComfyUI標準の ManualSigmas ノードと SamplerCustom ノードを使い、サンプリング開始時のノイズ値(sigma)を直接指定した。4ステップのまま開始ノイズを0.96、0.97、0.98、0.99に設定して生成した。開始ノイズ0.952の出力が denoise 0.7 の出力とほぼ同一(10階調以上の差がある画素が全体の0.6%)であることを確認した上で実行している。
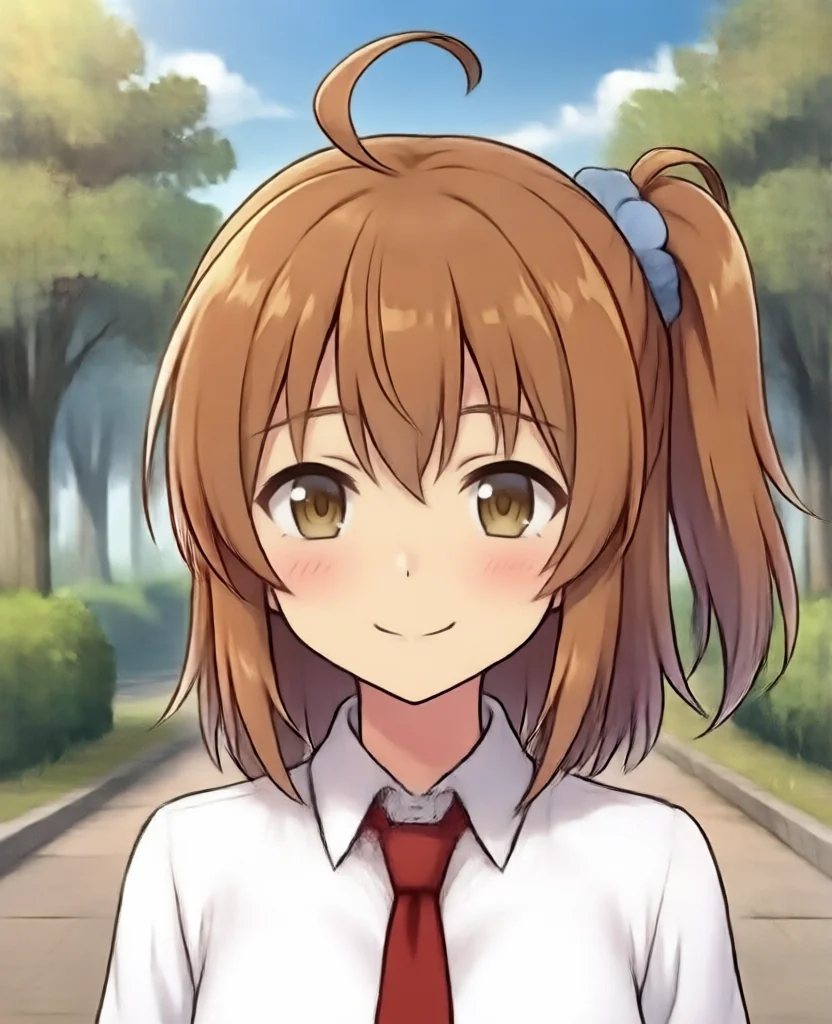
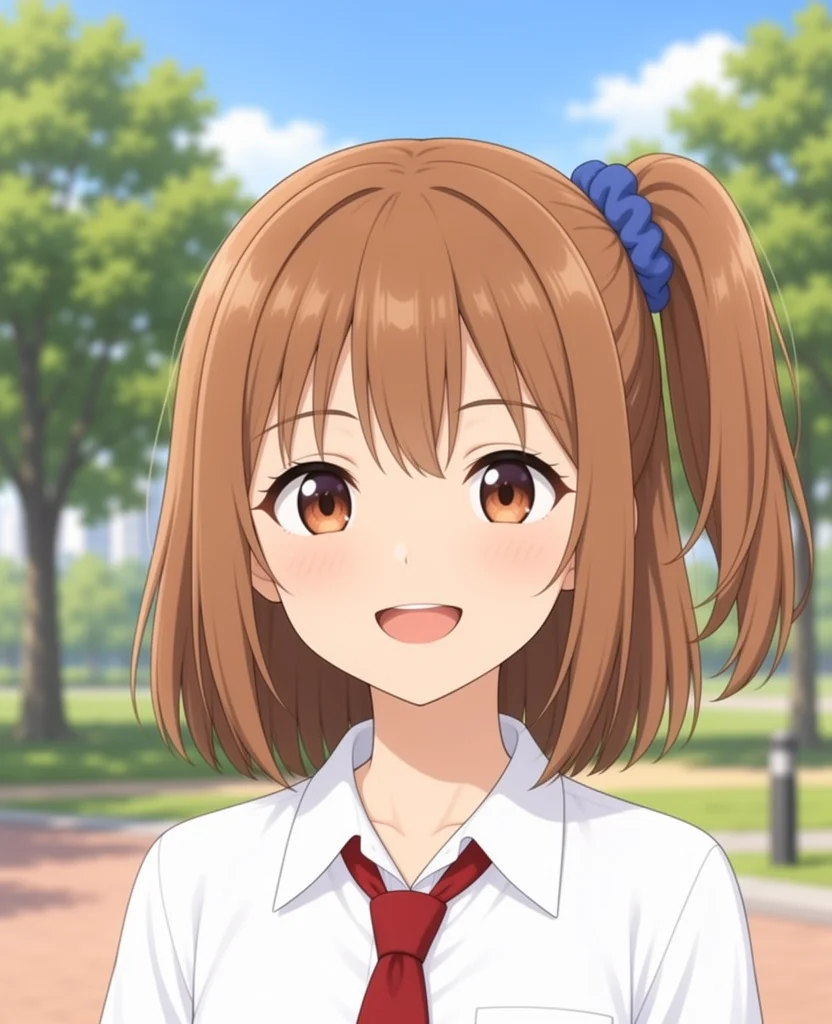
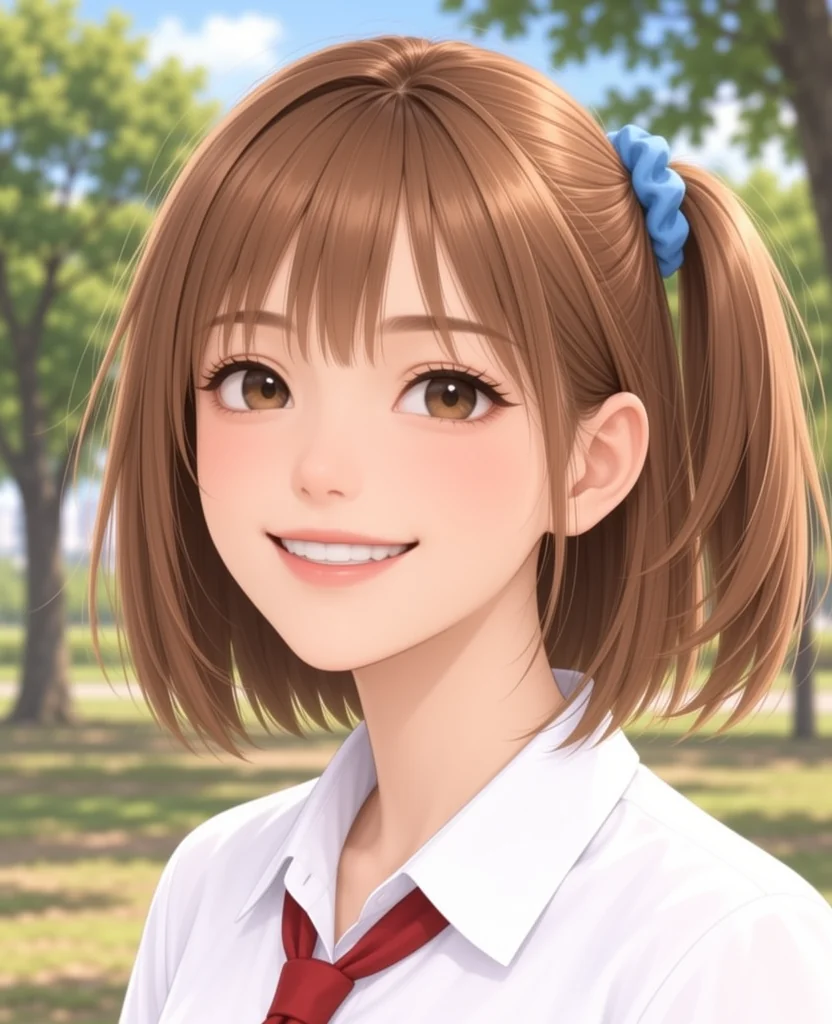
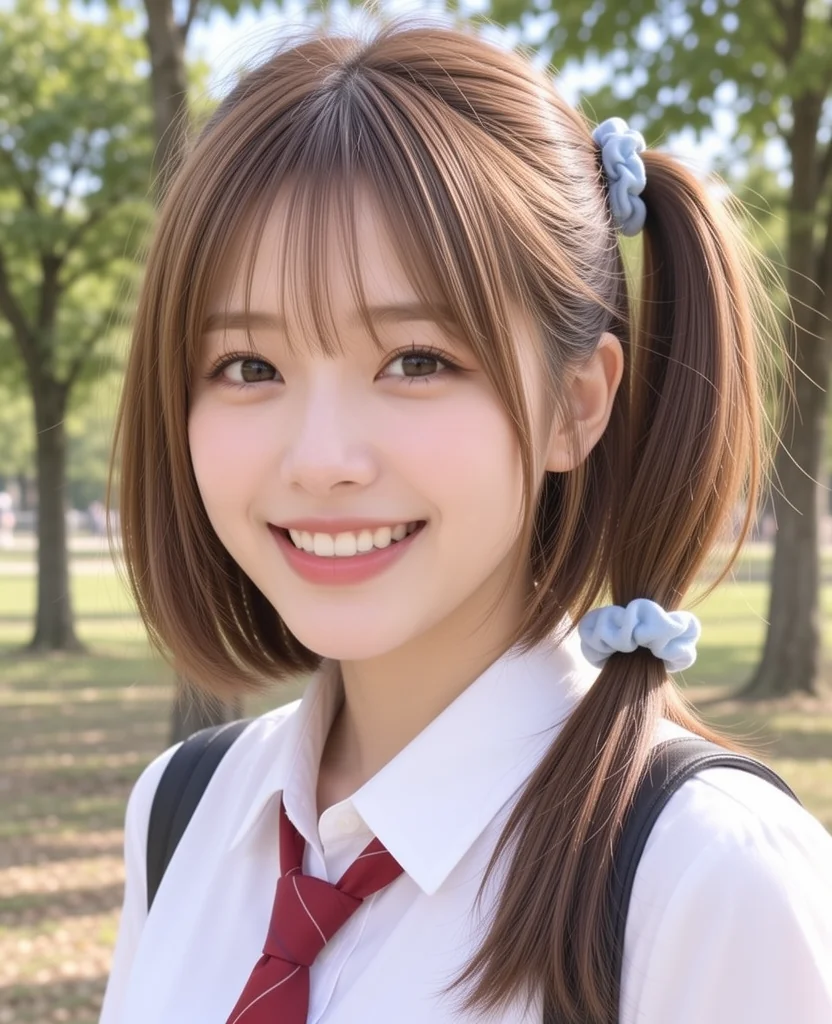
イラストから写真への変化は、開始ノイズ0.97から0.98の境界で急激に起きた。
4枚中2枚は0.97で、残り2枚は0.98で写真調に切り替わった。
切り替わった直後の写真でも、サイドポニー、青いスクランチー、白シャツ、赤ネクタイといった衣装と髪型の配置は維持されていた。しかし頭頂部のアホ毛は4枚すべてで消失し、元画像にはない自然な前髪が生成された。さらに一段上の0.99までノイズを上げると、髪型も崩れて別人の写真になった。
目的別の設定と結果のまとめ
| 目的 | 有効だった設定 | 入力から維持された要素 | 変化した要素 |
|---|---|---|---|
| 看板への文字入れ | denoise 0.7(開始ノイズ0.95) | 構図、髪型、スクランチー、アホ毛、服 | 背景の店内がMOSS調に描き直される |
| 1.5倍の高解像度化 | denoise 0.3(開始ノイズ0.69) | 表情、構図、輪郭の明瞭さ | 0.5で表情、0.7以上で背景構造が変化 |
| 写真風への変換 | 開始ノイズ0.97〜0.98(ManualSigmas) | サイドポニー、スクランチー、シャツ、ネクタイ | アホ毛が消え、自然な前髪が形成される |
4ステップ化したMOSS-Imageを用いることで、Animaで生成したオリジナルキャラクターの絵に対しても、キャラクター性を残したまま正確な英語文字入れや高解像度化が行えることが確認できた。
一方、写真風への変換は4ステップ特有の denoise の粗さ(0.95の次が1.00になる挙動)に挟まれた0.97〜0.98の間で切り替わるため、ManualSigmas による直接的なノイズ指定が必要となった。