Xperiaフォトフレームに受付を挟んでウェイクワードで呼んでみた
 目次
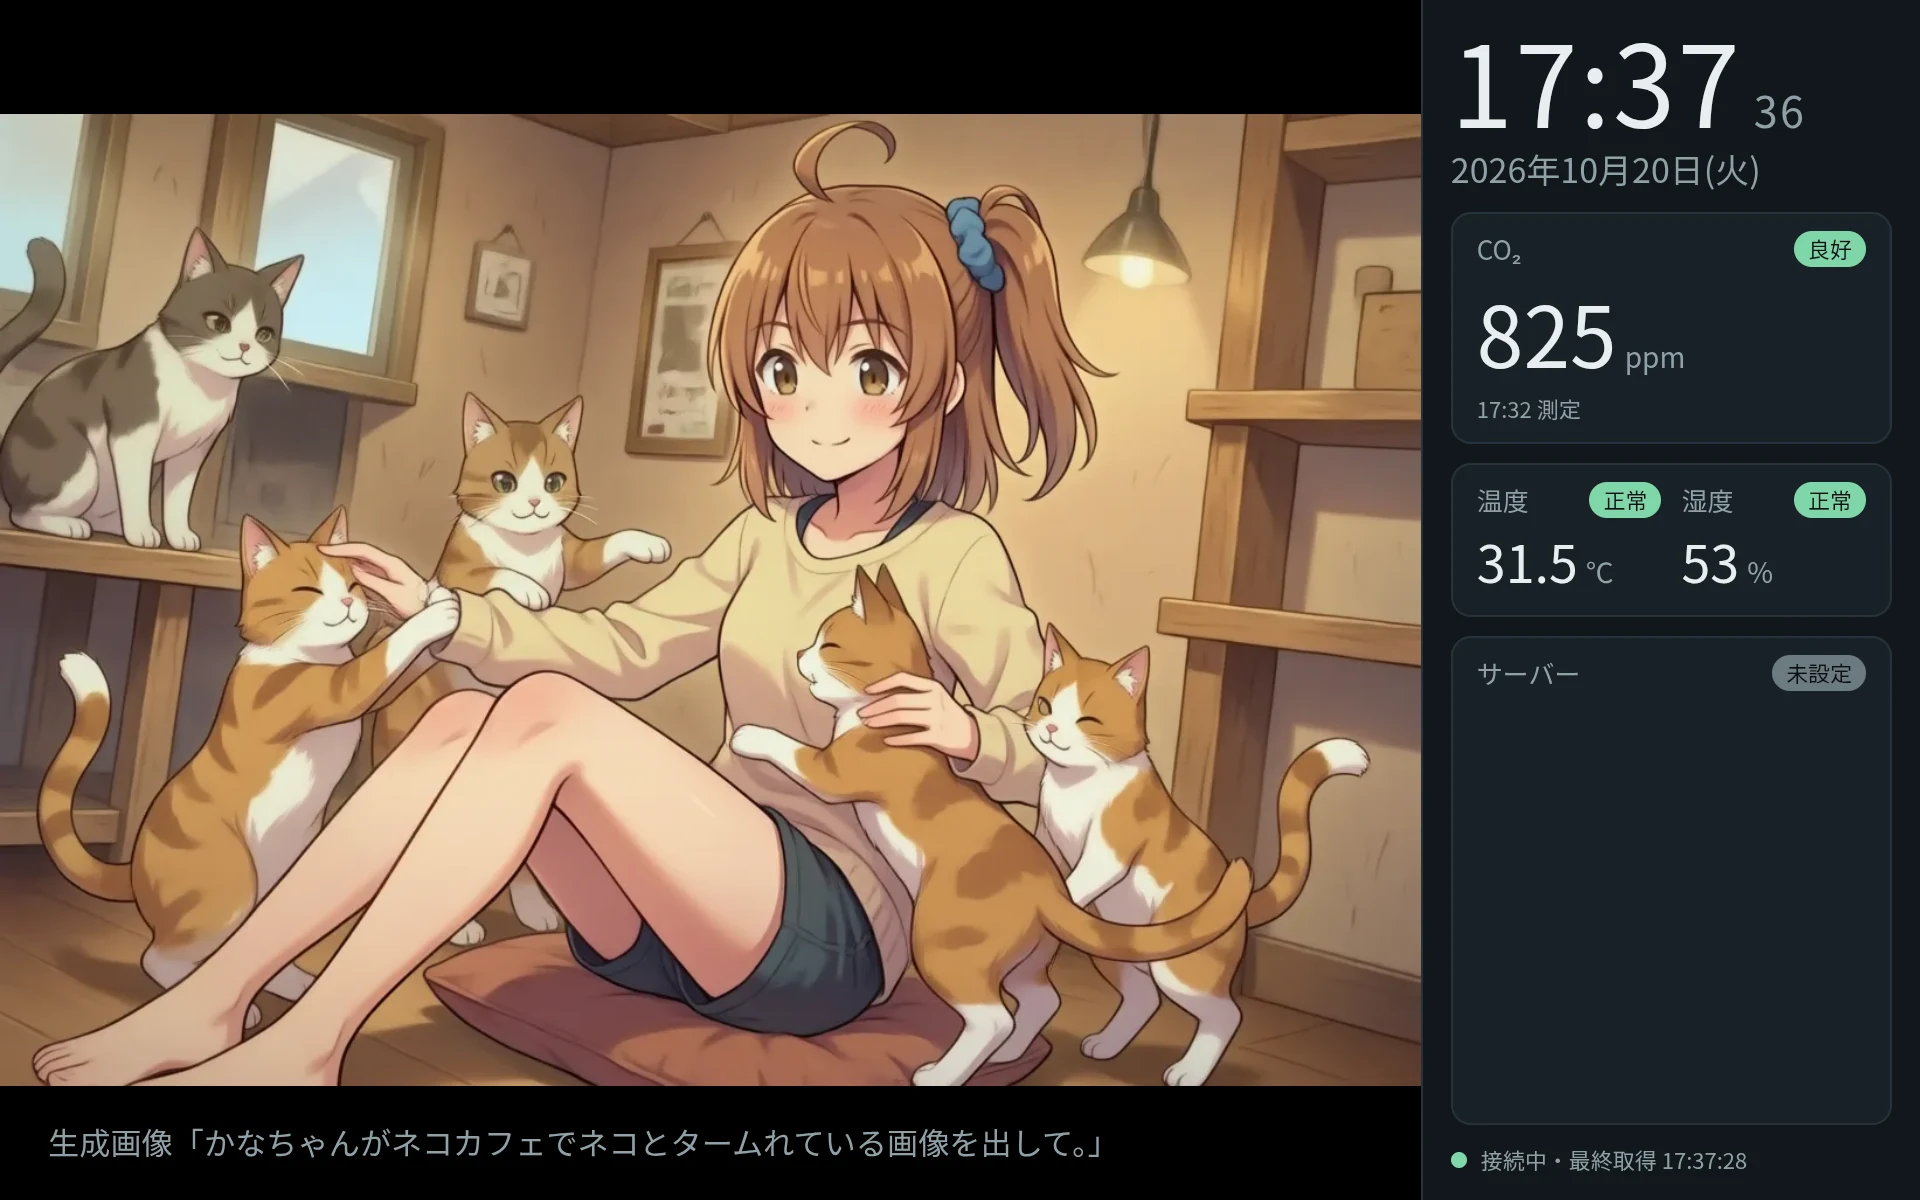
前回の記事で、古いXperia Z3 Tablet Compact(SGP611)を常時表示のフォトフレームに仕立て、音声チャットサーバーにつないで会話や画像生成ができるところまで動かしてみた。
ただ、実際に部屋に置いて使ってみると気になる点が2つ出てきた。
1つは返事の遅さだった。「今何時?」や「部屋の温度は?」といった決まった質問でも、文字起こし、LLM(Qwen3.8-Max)の呼び出し、音声合成が順に動くため、1文目が鳴り始めるまでに約10秒かかっていた。
もう1つはPCへの依存で、画面を配信する表示サーバーをPCで動かしていたため、PCがスリープに入ると画面が止まり、会話もできなくなっていた。
そこで表示サーバーを常時稼働のLinux機へ移してPC依存をなくし、通信の中継に「受付」を置いて、決まった質問やニュースのネタをその場で即答できるようにしてみた。
あわせて、画面をタップせずに「かなちゃん」と呼びかけられるよう、オフラインのウェイクワード(特定の呼び出し語)も実機に組み込んだ。
作業した環境と全体の構成
| 項目 | 内容 |
|---|---|
| 端末 | Xperia Z3 Tablet Compact SGP611(Wi-Fiモデル) |
| OS | LineageOS for microG 18.1(Android 11) |
| 常設アプリ | 自作WebViewアプリ v0.9.6(Vosk組込) |
| 表示サーバー | Latitude 5310(Ubuntu、systemdで常駐) |
| 音声チャットサーバー | Qwen3-ASR(音声認識)、Qwen3.8-Max、Irodori-TTS(音声合成) |
| 画像生成サーバー | genserver(Anima) |
| 通信 | Tailscale(常時接続VPN) |
前回はPCで表示サーバーを動かし、タブレットは同じLAN内から直接つないでいた。
今回は常時稼働しているLinux機(Latitude 5310)へ表示サーバーを移し、タブレットにもTailscaleを導入して、PCを介さずに全サーバーとつながる構成へ改めた。
flowchart TD
  subgraph Tablet [Xperia Z3 Tablet Compact]
    A["常設アプリ v0.9.6<br/>Voskウェイクワード"]
  end

  subgraph LinuxServer [表示サーバー :8787]
    B["中継・画面配信"]
    C["受付 FrontDesk"]
    D["ネタ帳 TopicDesk"]
  end

  subgraph VoiceServer [音声チャットサーバー :8357]
    E["文字起こし /stt"]
    F["会話作成 /chat_async"]
    G["会話記録 /turn"]
  end

  subgraph OtherServers [周辺サーバー]
    H["音声合成 :8355"]
    I["画像生成 genserver"]
    J["StackChan CO₂実測値"]
  end

  A <-->|Tailscale HTTP| B
  B --- C
  B --- D
  C -->|文字起こし依頼| E
  C -->|一般の質問を転送| F
  C -->|即答した会話を同期| G
  C -->|室温などを1回合成| H
  B -->|絵の生成を依頼| I
  J -->|定期送信| VoiceServer
  C -->|測定値を取得| VoiceServer
ここでの「受付」は、タブレットと音声チャットサーバーの間に挟む即答役だ。
時刻や室温のように答えが決まっている質問は受付がその場で返し、難しい会話だけを音声チャットサーバーのLLMへ回すことで、返答待ちの時間を減らすようにした。
表示サーバーを常時稼働のLinux機へ移す
表示サーバーのコードをLinux機へ配置し、systemdのユーザーサービスとして常駐させた。
プロセスが停止しても10秒後に自動再起動するように設定した。
タブレット側にはF-DroidからTailscale(v1.102.4)を入れ、Androidの常時接続VPN(always_on_vpn_app)に設定した。
これで端末を再起動しても、起動後10秒ほどでVPNが接続され、Linux機の表示サーバーへ自動でつながる。
この移行によって、PCを立ち上げていなくてもフォトフレームが単独で動き続けるようになった。
受付を入れて応答時間を縮める
返答の遅さを解消するため、各処理にかかる時間をLatitudeから計測してみた。
| 処理 | かかった時間 | 内容 |
|---|---|---|
文字起こし(/stt) | 1.6〜2.8秒 | Qwen3-ASR-0.6B |
音声合成(/tts、40ステップ) | 2.5〜2.9秒 | Irodori-TTS(約2.7秒の文) |
| 音声合成(12ステップ) | 1.14秒 | 同上 |
| 会話全体(LLM経由) | 約10秒 | 文字起こし+LLM+最初の文の音声合成 |
文字起こしに約2秒、音声合成に約3秒かかっており、ここにLLMの思考時間が加わるため、どうしても1文目まで約10秒かかっていた。
一方で、時刻や部屋の温度を聞く質問は答えが決まっている。LLMに考えさせずに中継の受付が定型文を返せば時間を削れるはずだ。
音声合成の調整と語尾の無音
受付で使う音声合成のパラメータも見直した。
生成ステップ数を40、20、12で聞き比べたところ、12ステップでも品質の差がほとんど分からなかったため、1.14秒で仕上がる12ステップにした。
また、合成音声の語尾が「だよ」で不自然に途切れる問題があった。
波形を調べると、語尾の後0.1秒しか無音が入っていなかったため、文自体の文字列は変えずに、音声の末尾に0.5秒の無音を自動追加して自然に聞こえるようにした。
時刻の音声を事前生成する
時刻の返答を「今は12時」と「34分だよ。」の2つの音声ファイルをつなぎ合わせて再生する案も試した。
しかし、間をつなぐとアクセントと抑揚がおかしくなり、継ぎ接ぎだと分かって不自然だった。
そこで、24時間分の時・分の組み合わせ(24×60=1440通り)を、1文まるごと(「今は0時0分だよ。」〜「今は23時59分だよ。」)事前に音声合成して保存することにした。
スクリプトを回して連続生成させると、1件あたり約1.1秒、合計約30分で全1440件のWAVファイルができた。
受付による即答の仕組み
中継に組み込んだ受付(FrontDesk)では、届いた録音データをまず音声チャットサーバーの /stt に送ってテキスト化する。
テキストが時刻を聞く質問なら事前生成しておいた該当時刻のWAVファイルを即座に返し、室温や湿度、CO₂などの質問なら、StackChanが送ってきている最新値(/context)を使って文を組み立て、その場で1回だけ音声合成して返す。
それ以外の質問や、センサー値が古くなっている場合は、通常の会話処理へ送る。
中継経由での応答時間は次のようになった。
| 質問 | 処理方式 | 返事 | 応答時間 |
|---|---|---|---|
| 今何時? | 受付(作り置きWAV) | 今は13時6分だよ。 | 2.07〜2.17秒 |
| 今何度? | 受付(その場で1回合成) | 今の部屋は30.9度だよ。 | 4.03秒 |
| 湿度どのくらい? | 受付(その場で1回合成) | 部屋の湿度は54パーセントだよ。 | 4.32秒 |
| C O 二のノードはどう? | 受付(その場で1回合成) | 部屋のシーオーツーは1558ピーピーエムだよ。 | 5.39秒 |
文字起こし(約1.8秒)の直後に事前生成した音声を取り出すため、時刻の返答は約2秒で鳴り始めるようになった。
音声チャットサーバーに新APIを追加してもらう
受付を中継に入れたことで応答は速くなったが、2つの問題が見つかった。
1つは二重の文字起こしだ。受付が答えられない一般の質問を音声チャットサーバーへ回す際、既存の入口が音声ファイルしか受け付けなかったため、同じ録音を送り直して文字起こしが2回走り、約2秒余計に待たされる。
もう1つは会話履歴の途切れで、受付が自分で答えた内容は音声チャットサーバーを通らないため、「さっき何時って言った?」や、ニュースを聞いた後の「それ詳しく教えて」がLLMに通じなくなっていた。
そこで音声チャットサーバー側に要件を伝えて、3つの新機能を実装してもらった。
テキストで会話を開始する POST /chat_async
音声ファイルを送る代わりに、受付で文字起こし済みのテキストを直接送って非同期ジョブを開始するエンドポイント。
POST /chat_async?sr=16000&client=frame&frame_prompt=...
Content-Type: application/json

{"text": "明日の天気は?"}
VAD(音声区間検出: 声が出ている区間を判定する処理)と文字起こしをスキップし、受け取ったテキストから直接LLMの処理に入る。
記憶の呼び出しやツール(天気・検索・画像生成 draw_image)の実行は従来の音声入力と同じように動作する。これで二重の文字起こしを回避できた。
受付の応答を会話ログに書き戻す POST /turn
受付が自分で答えた1往復を、LLMや音声合成を通さずに会話ログへ追加するエンドポイント。
POST /turn
Content-Type: application/json

{
  "user": "今何時?",
  "kana": "今は14時34分だよ。",
  "emotion": "smile",
  "client": "frame",
  "long_term": false
}
ここで言う履歴は直近数往復の文脈を追うための短期記憶で、長期記憶はユーザーの好みや重要な事実をずっと残すための情報だ。
long_term: false を指定すると、直近の会話履歴(history)とログには残るが、長期記憶には保存されない。時刻や室温を尋ねるたびに、不要な事実が長期記憶に蓄積されるのを防ぐ設定だ。
また、ニュースのように後から詳しく聞かれる可能性がある話題のために、詳細資料を渡す note フィールド(最大2000文字)も用意された。
note の内容は発言本文には混ぜずに、LLMのシステムプロンプトにある「さっき話したことの資料」として直近3往復分だけ渡される。
/stt で無音を判定する
マイクの録音に声が入っていなかった場合、従来の /stt は認識のヒント語(二十四節気など)を誤ってテキストとして返していた。
新版の /stt ではVADによる無音判定が入り、声がないときは {"text": "", "no_speech": true, "reason": "vad: 0.00s of speech"} を返すようになった。
これで無音のときは無駄な処理を走らせずにそのまま終了できる。
実機での連携確認
これらの新APIを受付に組み込み、タブレットから実機で話しかけてテストしてみた。
| 発話(聞き取り) | 処理方式 | 返事 | 1文目までの時間 |
|---|---|---|---|
| 今何時。 | 受付(作り置きWAV) | 今は14時34分だよ。 | 2.7秒 |
| 今何度。 | 受付(その場で1回合成) | 今の部屋は30.8度だよ。 | 4.2秒 |
| さっき何時って言った? | かなちゃん(/chat_async) | さっきは14時34分って答えたよ。 | 8.6秒 |
| 猫の絵を描いて。 | かなちゃん(/chat_async)→ draw | 猫の絵を描くね、できたら画面に出すよ。 | 9.4秒 |
受付が答えた時刻を、間に室温の質問を挟んだ後でも、かなちゃん本体が覚えていて「さっきは14時34分って答えたよ」と答えた。
/turn による会話履歴の同期が機能している。
また、/chat_async 経由でも画像生成ツールが呼ばれ、「猫の絵を描いて」と頼んでから38秒後に画像が生成され、フォトフレームの画面が自動で切り替わった。
「なんかネタある?」に答えるネタ帳
時刻や室温だけでなく、「なんかネタある?」と聞いたときに最新の話題をサッと教えてくれるネタ帳機能も受付に追加した。
Web、AI、セキュリティ関連の18フィード(RSS)を60分ごとに取得してSQLiteに保存し、直近48時間の新着記事から、ModelScopeの Qwen3.8-Max を使って推し記事を判定させる。選ばれた記事には80文字以内の話し言葉の紹介文と、詳しく聞かれたとき用の資料(要点・URL)を作らせ、最大5件までその場ですぐ音声合成してWAVファイルとして保存しておく。
「なんかネタある?」と聞くと、未紹介のネタの中で最も推しスコアの高いものを事前生成音声で鳴らし(鳴り始め3.1秒)、「他には?」と続けて聞けば次のネタを順に話す。話したネタだけを POST /turn(long_term: true、note 付き)で音声チャットサーバーへ送り、話さなかったネタは48時間で自動破棄する。
APIキーの設定時に、Windows形式の改行コード(\r)が末尾に残ってエラーが出たため、改行を除去し、サーバー側でも前後の空白を自動除去するようにした。
英文や長文で声質が変わる問題
ネタ帳を実機で試した際、別の問題が出た。
あるネタ(Rank Mathの話題)を話すときは普段のかなちゃんの声だったが、別のネタ(Cloudflareの話題)になると、明らかに別のキャラクターのような声に変わってしまった。
音声合成(Irodori-TTS)は1本の参照音声を元に合成するワンショット方式で動いている。
長文や英語の単語、技術用語が混ざると、参照音声の特徴から外れて声質がぶれる傾向がある。
声の安定化には話者埋め込み(声の特徴の数値化)やLoRA(追加学習手法)による本格的な追加学習が必要で、これには蓄積された音声データの整理がいる。
声の調整は別の作業として切り離すことにした。
ウェイクワード「かなちゃん」を端末へ組み込む
ここまでの操作は、PCからADB経由で録音コマンド(voicetest chat)を送って動かしていた。
フォトフレームとして居間に置くには、画面に触れずに声だけで起動できなければ普段使いしにくい。
そこで、軽量なオフライン音声認識ライブラリの「Vosk」を使い、ウェイクワード「かなちゃん」をSGP611の実機に組み込んでみた。
Voskによる軽量な常時待ち受け
日本語の小型モデル vosk-model-small-ja-0.22(展開後94MB)を使い、単語を限定する grammar 指定を次のように設定した。
["かな ちゃん", "[unk]"]「かな」と「ちゃん」が連続して検出されたときだけ起動フラグを立てる。
事前の単体テストでは、音声合成の呼びかけ5件をすべて検出し、呼びかけを含まない12問の誤検出は0件だった。
Androidの常設アプリに vosk-android のライブラリと armeabi-v7a のネイティブコード(.so)を組み込み、モデルファイルは端末の外部ストレージへ配置した。
実機で動作させたところ、モデルの読み込みに約5秒、メモリ使用量は約250MB、常時認識中のCPU使用率は約24%(1コア相当)、電池温度は32.0℃〜33.5℃の間にとどまり、常時動かしても問題ない負荷だった。
実機で使い勝手を調整する
実際に声で呼びかけてみると、いくつか使いにくい点が見つかり、順に対応を入れた(v0.9.0〜v0.9.6)。
| 見つかった課題 | 対処 |
|---|---|
| 録音時間が8秒固定で長すぎる | 話し始めを待ち、発話後に0.8秒無音が続いたら自動で録音を止めるVADを導入 |
| 呼びかけ直後の合図がサイン波(「ぷー」)で不自然 | かなちゃんの声で「ん?」と返事をする事前生成音声を鳴らす |
| LLMの返事を待つ間が無音で不安 | かなちゃん本体へ回すときだけ、待機中にフィラー音声(「えーっと」など)を再生 |
| 絵の生成を頼んだ後、いつ完成したか分からない | 生成完了を監視し、完成時に「できたよ!画面を見てね。」と自動で音声報告 |
「かなちゃん」と呼ぶと即座に「ん?」と返り、「今何時」と話しかけて口を閉じると、0.8秒後に自動で録音が終わって受付へ送られる。
時刻なら呼びかけから約3.5秒で「今は16時24分だよ。」と返ってくるようになり、手で操作しなくて良くなった。
音声ごとの音量のばらつき
実機で音声を鳴らす中で、合図の「ん?」、フィラー、返事、完成報告の音量がそれぞれバラバラに聞こえる問題が生じた。
ファイルの平均音量を測定したところ、-12.6dBFS(最大音量を0とするデジタル音声の単位)から-16.5dBFSまで約4dBの開きがあった。
そこでアプリ側で再生直前にすべて-18dBFSへ正規化する処理(Loudness)を入れ、サンプリング周波数も16kHzへ揃えた。
しかし、端末の内蔵スピーカーで鳴らしてマイクで測定すると、耳で聞いたときの音量差がまだ残っていた。
音声ごとの周波数特性や語頭の立ち上がりの違いが影響しているようだ。
この音量の統一についても、声のブレ対策として音声を作り直すタイミングでまとめて調整することにした。