JevのLLM文体判定はMarkdownや改行を消してもほぼ変わらなかった
 目次
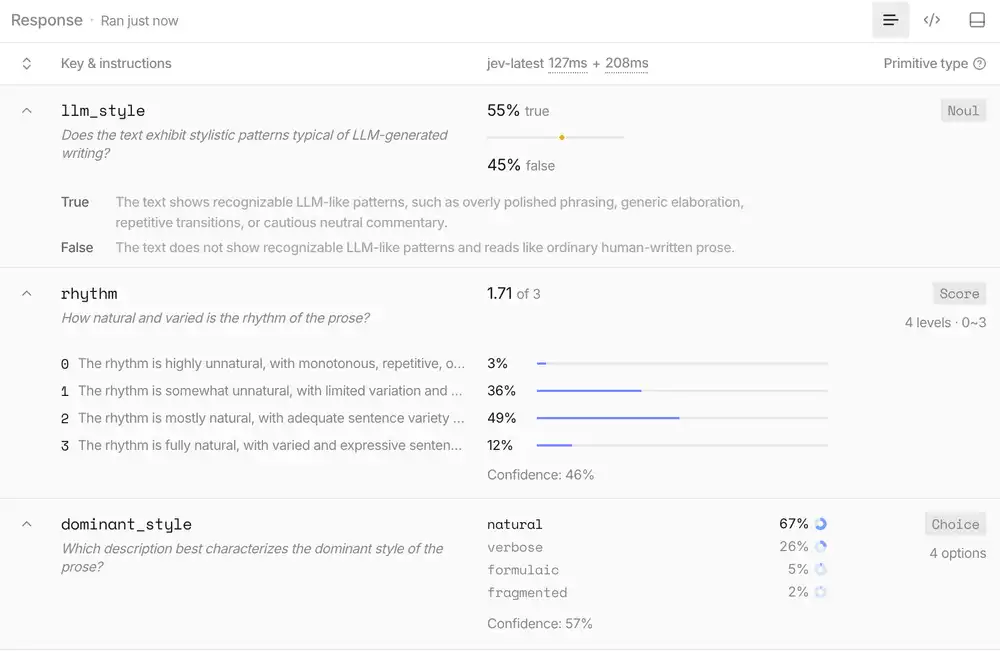
前回のTypeSafe AIのJevについての記事では、文章を生成せず判定だけを返すモデルの発表内容をまとめた。Jevはテキストを入力すると、あらかじめ指定したスキーマ(質問項目)に沿ってYes/Noや採点の確率値を高速に返す判定用モデルだ。
今回は実際にJevへ記事の本文を送り、改行やMarkdown記号の有無でLLMっぽさの判定が変わるかを試してみた。
質問のスキーマ
Jevには、質問ごとに型・質問文・判定基準を指定したスキーマを渡す。
JevのPlaygroundにある型ごとの雛形と、入力欄(State)のプレースホルダーのJSONをCodexに渡したところ、Codexが質問文と基準まで組み立てた。
それをそのまま使い、基本型のNoul・Score・Choiceを1問ずつ試した。
llm_styleはNoul(Yes/Noを返す、一般的なBooleanに相当するJev独自の型)で、LLMが書いた文章によくある型にはまったパターンが目立つかを判定させる。
値はtrueの確率で返る。
rhythmはScore(段階評価)で、文のリズムがどれだけ自然で変化があるかを0〜3の4段階で採点させる。
| 段階 | 基準 |
|---|---|
| 0 | 繰り返しが多く機械的な構成 |
| 1 | やや繰り返しが多い |
| 2 | おおむね自然で変化がある |
| 3 | とても自然で変化がある |
dominant_styleはChoice(選択肢から1つ)で、文章をいちばんよく表す説明を4つから選ばせる。
| 選択肢 | 基準 |
|---|---|
| formulaic | 型通りで構成が読める |
| fragmented | 唐突な切れ目が多い |
| verbose | 冗長で説明しすぎ |
| natural | 目立つ構造の問題がない |
質問文と基準はCodexが書いた英語のまま渡した。
指定したスキーマはこんな感じで、本文は {"text": "本文"} の形で渡す。
{
  "llm_style": {
    "type": "noul",
    "instructions": "Does this text exhibit stylistic patterns commonly associated with LLM-generated writing?",
    "criteria": {
      "true": "The writing prominently exhibits formulaic patterns commonly associated with LLM-generated prose",
      "false": "The writing does not prominently exhibit such patterns"
    }
  },
  "rhythm": {
    "type": "score",
    "instructions": "How natural and varied is the rhythm of the prose?",
    "criteria": [
      "Highly repetitive or mechanically structured",
      "Somewhat repetitive",
      "Mostly natural and varied",
      "Highly natural and varied"
    ]
  },
  "dominant_style": {
    "type": "choice",
    "instructions": "Which description best characterizes the prose?",
    "criteria": {
      "formulaic": "Formulaic and predictably structured",
      "fragmented": "Fragmented, with frequent abrupt breaks",
      "verbose": "Verbose or unnecessarily explanatory",
      "natural": "Natural prose without a dominant structural issue"
    }
  }
}
入力に使った文章
入力には、まず人間が書いた文章の基準としてESPRIMO G5010/EにUbuntuを入れた記事の本文を使った。記事先頭の属性情報(フロントマター)は除いてある。
この記事はClaudeが書いた初稿の大半を自分で書き直したもので、ほぼ人間が書いた技術記事だ。
3つの入力形式
同じ本文から、改行とMarkdown記号の残し方を変えた3つの形式を用意した。
Aは原文そのまま、Bは改行を消したもの、Cは改行とMarkdown記号を消したプレーンテキストだ。
| 形式 | A(原文) | B(改行なし) | C(記号なし) |
|---|---|---|---|
| 文字数 | 3,075 | 2,943 | 2,485 |
Bでは行末の2スペース(Markdownの改行指定)も一緒に消し、行の境目で英数字同士がくっつく箇所だけ半角スペースを入れた。
Cでは見出しの ##、リンクのURL、バッククォート、表の縦棒と区切り行、画像を消した。
リンクは表示テキストだけ残し、コードブロックは前後のバッククォートを外してコード本体を残した。
番号付きリストは、ESPRIMO記事の本文が「1〜4すべてダメ」と箇条書きの数字に言及しているため残してある。
ESPRIMO記事の判定結果
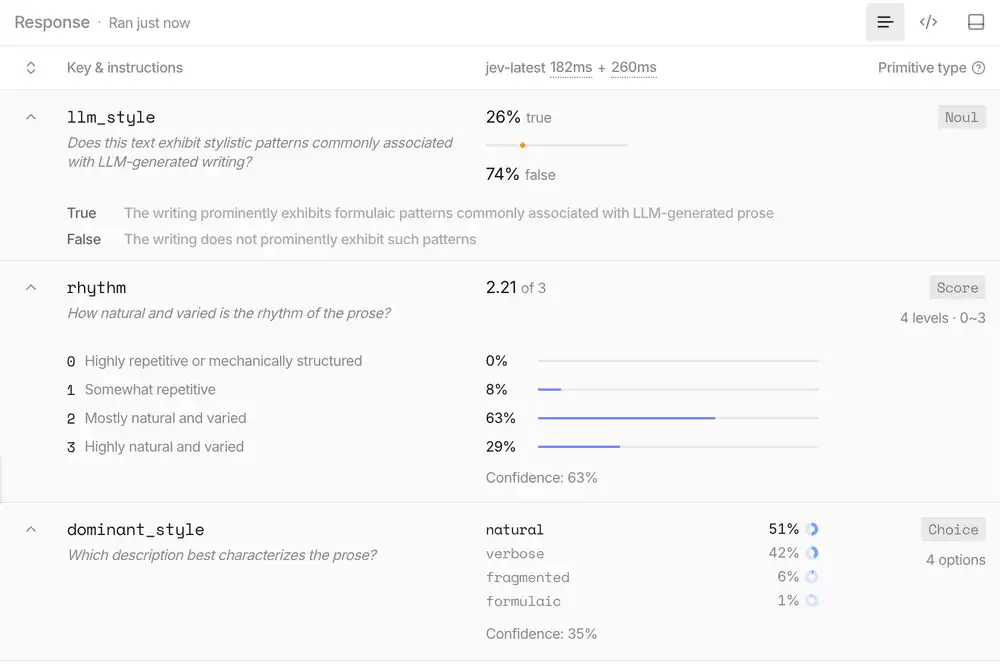
llm_styleの値はtrueの確率。
rhythmは、その下の0〜3の各確率で重み付けした平均と一致する。
dominantの行から下は、dominant_styleの各選択肢の確率。
確信度は画面のConfidenceで、rhythmとdominant_styleにのみ表示される。
| 項目 | A | B | C |
|---|---|---|---|
| llm_style | 29% | 25% | 26% |
| rhythm | 2.42 | 2.33 | 2.21 |
| 0の確率 | 0% | 0% | 0% |
| 1の確率 | 1% | 2% | 8% |
| 2の確率 | 56% | 63% | 63% |
| 3の確率 | 43% | 35% | 29% |
| 確信度 | 56% | 62% | 63% |
| dominant | |||
| natural | 81% | 72% | 51% |
| verbose | 17% | 26% | 42% |
| fragmented | 0% | 1% | 6% |
| formulaic | 1% | 1% | 1% |
| 確信度 | 75% | 64% | 35% |
画面のレイテンシ表示は、Aが118 + 215ms、Bが161 + 287ms、Cが182 + 260msだった。
結果を見ると、改行やMarkdown記号を消してプレーンテキスト(C)にしても、llm_style(LLMっぽさ)の確率は25〜29%であまり変わらなかった。
一方で文のリズム(rhythm)は2.42から2.21へと採点が下がり、dominant_styleでもnaturalが81%から51%に落ちてverbose(冗長)が42%まで増えている。
A(原文そのまま)の実行結果。
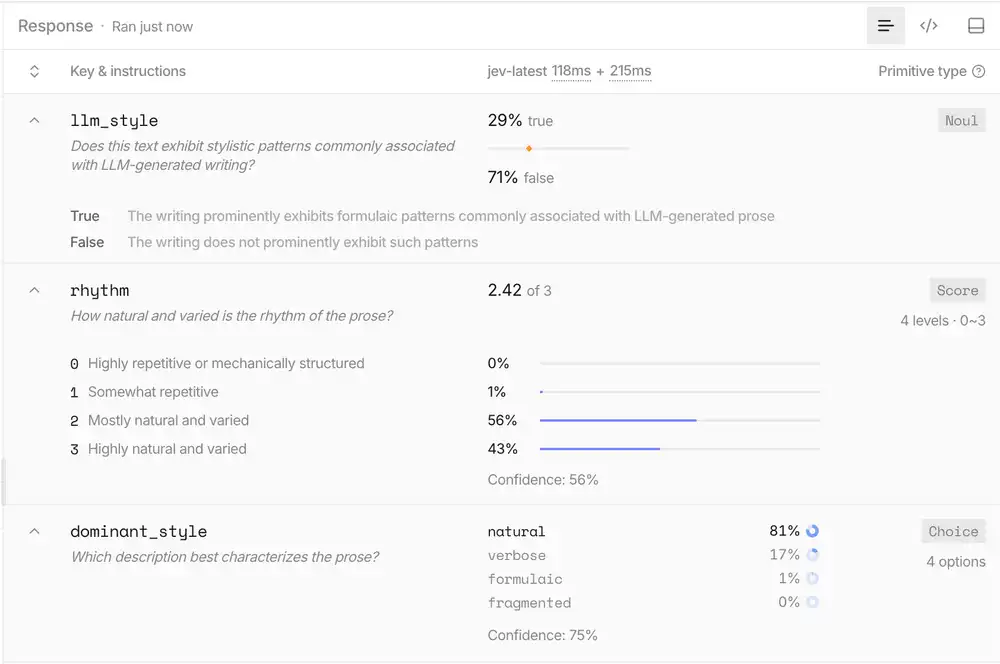
B(改行除去)の実行結果。
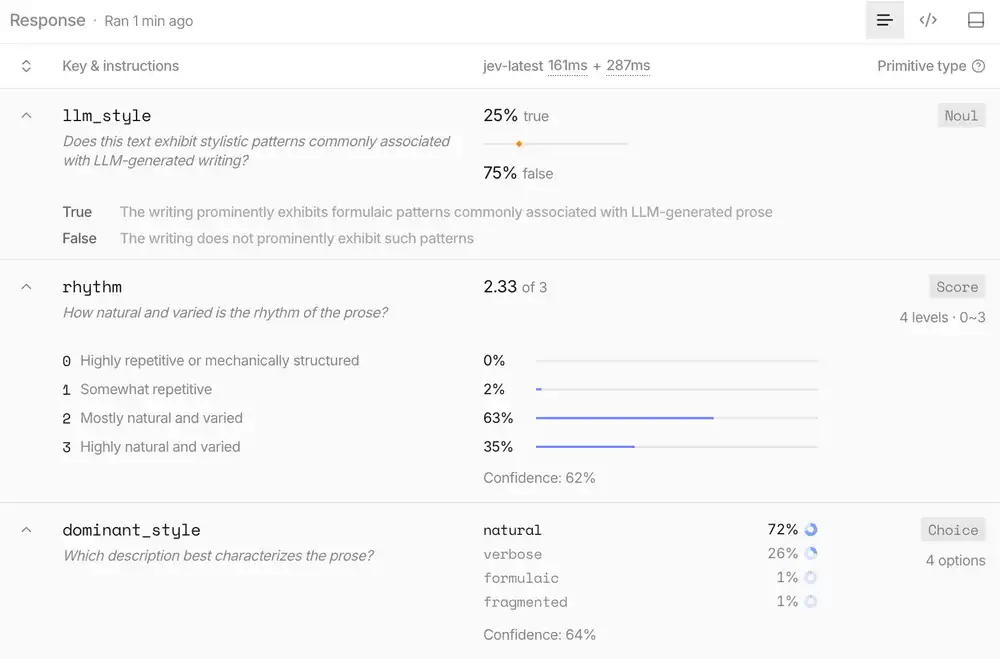
C(プレーンテキスト)の実行結果。
同一入力での結果のブレ
Aは最初に1回送り、B・Cを試したあとにもう1回実行した。
上の表と画面キャプチャは2回目の値だ。
| 項目 | 1回目 | 2回目 |
|---|---|---|
| llm_style | 29% | 29% |
| rhythm | 2.46 | 2.42 |
| 0の確率 | — | 0% |
| 1の確率 | — | 1% |
| 2の確率 | — | 56% |
| 3の確率 | — | 43% |
| 確信度 | 52% | 56% |
| dominant | ||
| natural | 81% | 81% |
| verbose | 17% | 17% |
| fragmented | 1% | 0% |
| formulaic | — | 1% |
| 確信度 | 75% | 75% |
1回目は詳細内訳を折りたたんだ状態で保存したため、rhythmの各確率とformulaicは画面上には表示されていない。
画面のレイテンシ表記は1回目が148 + 264ms、2回目が118 + 215msだった。
Qwenが書いた記事
比較対象として、pi.devとQwenで架空の音楽レーベルサイトを作った記事の本文も同じ3つの形式で試してみた。
この記事は構成から文体の修正までQwen3.7 / 3.8で行い、手直しはほとんどしていない。
末尾の --- 以降にある制作手順と感想は外して本文のみを入力した。
| 形式 | A(原文) | B(改行なし) | C(記号なし) |
|---|---|---|---|
| 文字数 | 9,875 | 9,654 | 8,252 |
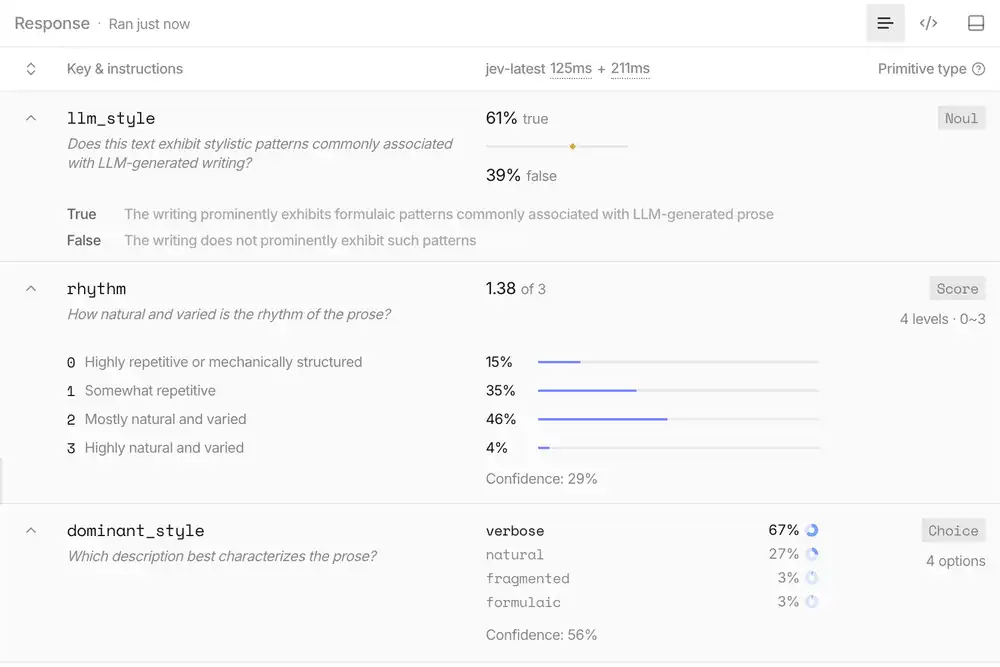
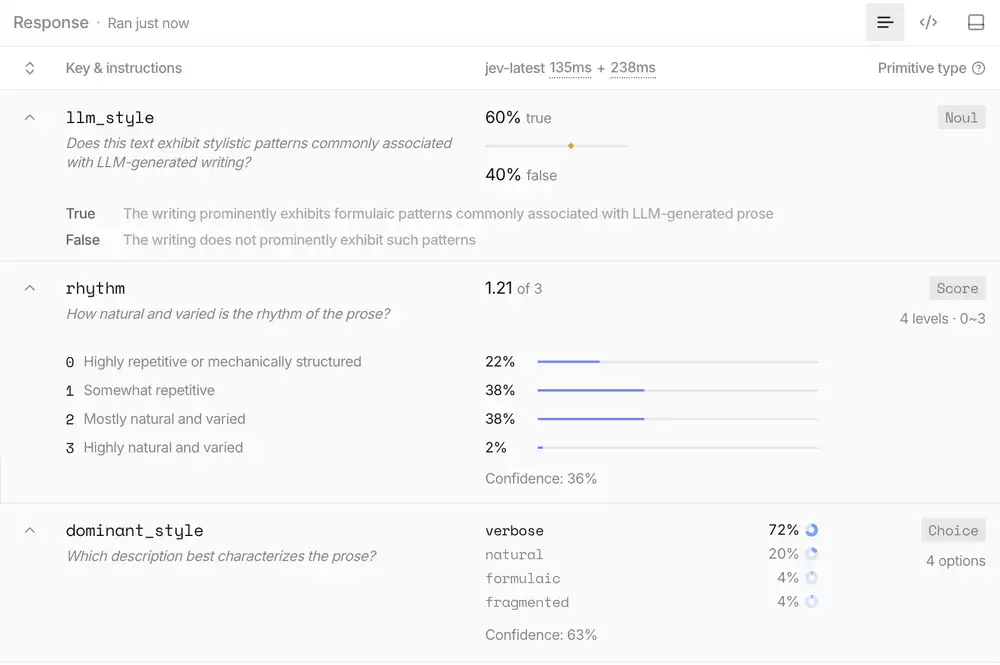
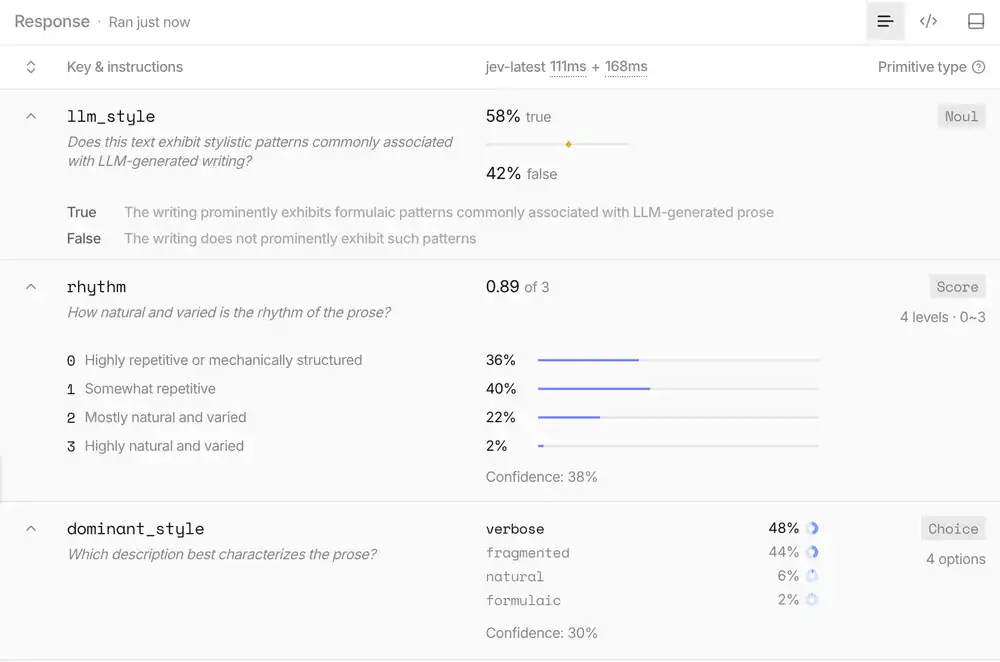
| 項目 | A | B | C |
|---|---|---|---|
| llm_style | 61% | 60% | 58% |
| rhythm | 1.38 | 1.21 | 0.89 |
| 0の確率 | 15% | 22% | 36% |
| 1の確率 | 35% | 38% | 40% |
| 2の確率 | 46% | 38% | 22% |
| 3の確率 | 4% | 2% | 2% |
| 確信度 | 29% | 36% | 38% |
| dominant | |||
| natural | 27% | 20% | 6% |
| verbose | 67% | 72% | 48% |
| fragmented | 3% | 4% | 44% |
| formulaic | 3% | 4% | 2% |
| 確信度 | 56% | 63% | 30% |
画面のレイテンシ表示はAが125 + 211ms、Bが135 + 238ms、Cが111 + 168msだった。
Qwen記事はもともとllm_styleが約6割と高めに出ている。こちらも形式を変えてもllm_style自体は58〜61%とほぼ動かないが、rhythmは1.38から0.89まで落ち、dominant_styleではfragmented(唐突な切れ目)が44%まで跳ね上がった。
Qwen記事には表が6つとコードブロックが6つあり、Cではそれらが区切りなしで地の文につながっている(例:「作業環境要素 内容ハーネス pi.dev…」)。
A(原文そのまま)の実行結果。
B(改行除去)の実行結果。
C(プレーンテキスト)の実行結果。
全部人間が書いた文章
ChatGPT登場以前の2011年に旧ブログへ書いた過去記事も試してみた。
地の文だけの記事は長くても1,000字前後だったため、日記1本(953字)と技術寄りの勉強会報告1本(825字)を選んだ。
どちらもMarkdownではないプレーンテキストで、形式は改行ありの1種類のみとした。
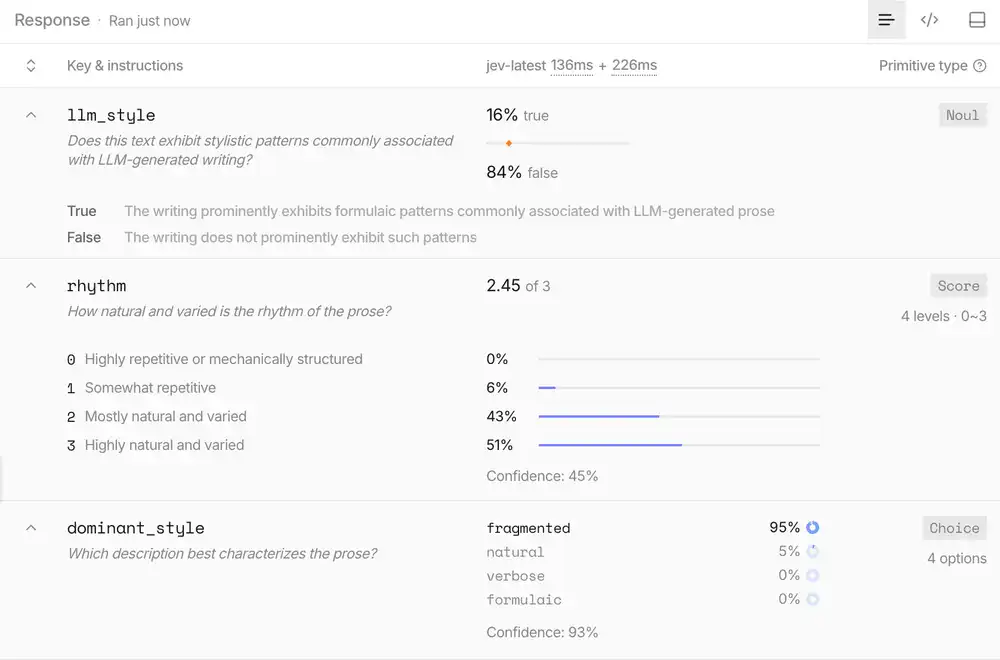
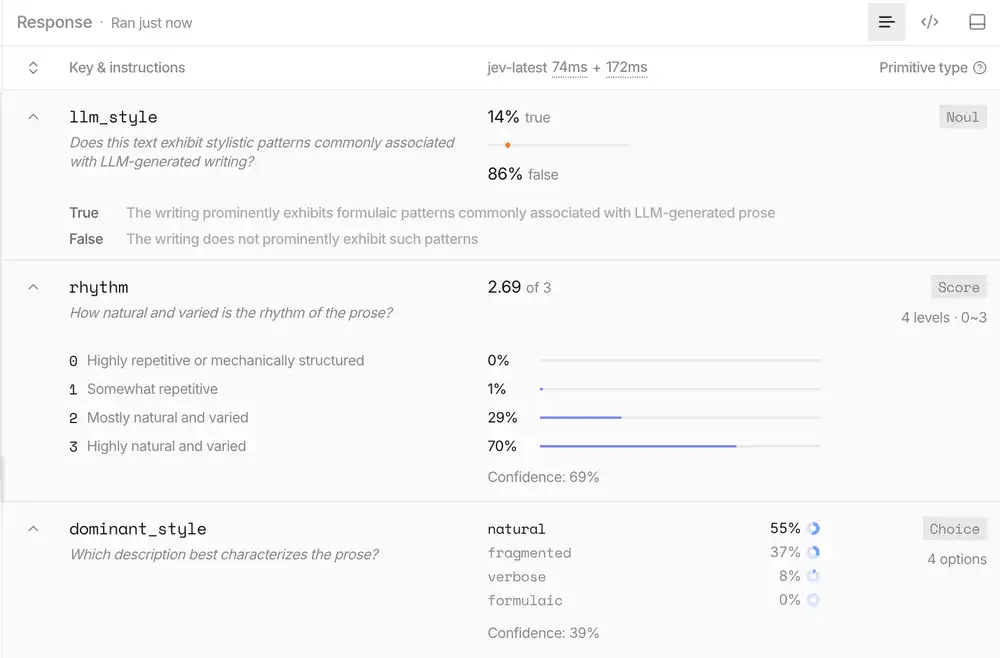
| 項目 | 日記 | 勉強会報告 |
|---|---|---|
| llm_style | 16% | 14% |
| rhythm | 2.45 | 2.69 |
| 0の確率 | 0% | 0% |
| 1の確率 | 6% | 1% |
| 2の確率 | 43% | 29% |
| 3の確率 | 51% | 70% |
| 確信度 | 45% | 69% |
| dominant | ||
| natural | 5% | 55% |
| verbose | 0% | 8% |
| fragmented | 95% | 37% |
| formulaic | 0% | 0% |
| 確信度 | 93% | 39% |
画面のレイテンシ表示は日記が136 + 226ms、勉強会報告が74 + 172msだった。
ChatGPT登場以前の文章ではllm_styleが14〜16%と低く、リズムも2.45〜2.69と高い値を保っている。ただ、日記はdominant_styleでfragmented(唐突な切れ目)が95%と極端に出た。
この日記はもともと写真日記で、テキストにしたときに画像のあった位置が空行として残り、全120行のうち71行が空行になっている。
Qwen(A)はfragmentedが3%しかないのにllm_styleは61%と判定された。一方、2011年の日記はfragmentedが95%に達しているのにllm_styleは16%に留まっている。
今回試した4本では、fragmentedの高さとllm_styleの高さは連動していなかった。
日記の実行結果。
勉強会報告の実行結果。
質問文を書いたモデルを変える
今回のスキーマは、Playgroundの雛形からCodexが組み立てたものだった。
入力の形式を変えてもllm_styleはほとんど動かなかったので、次は入力を固定して質問文のほうを変えてみる。
判定を行うモデルはJevのままで固定し、Jevに渡す質問文と判定基準(スキーマ)を作成するモデルだけを変えて比較した。
Claude Opus 5、Qwen3.8-Max、Gemini 3.8 Flash High(AGY経由)に、Codexに渡したのと同じ雛形を渡し、Codex版と同じ3問のスキーマを生成させた。
最初は構造も自由にさせたところ、モデルごとに質問の数や段階数、書く言語までそろわなかった。
そこでキー名、型、rhythmの4段階、dominant_styleの選択肢のキーはCodex版に固定し、英語の質問文と基準だけを各モデルに書かせた。
Codex(GPT)の分は、今回使ったスキーマをそのまま使う。
入力はESPRIMO記事とQwen記事のA(原文そのまま)に固定する。
Codex版ではllm_styleがESPRIMO記事で29%、Qwen記事で61%と開いていた。
この差が、ほかのモデルが書いた質問文でも残るかを比べてみた。
| スキーマ作成モデル | 対象記事 | llm_style | rhythm | dominant_style(上位) |
|---|---|---|---|---|
| Codex(GPT) | ESPRIMO(A) | 29% | 2.42 | natural 81%, verbose 17% |
| Codex(GPT) | Qwen(A) | 61% | 1.38 | verbose 67%, natural 27% |
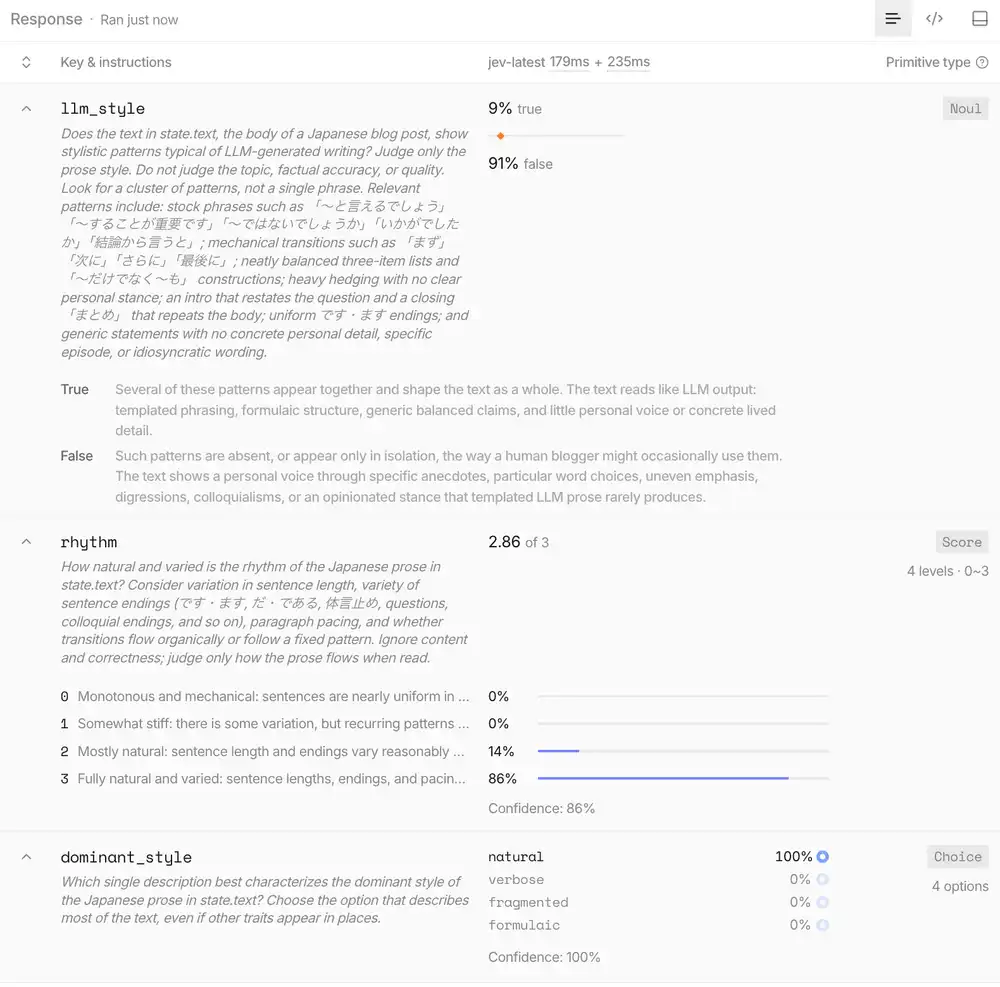
| Claude Opus 5 | ESPRIMO(A) | 9% | 2.86 | natural 100% |
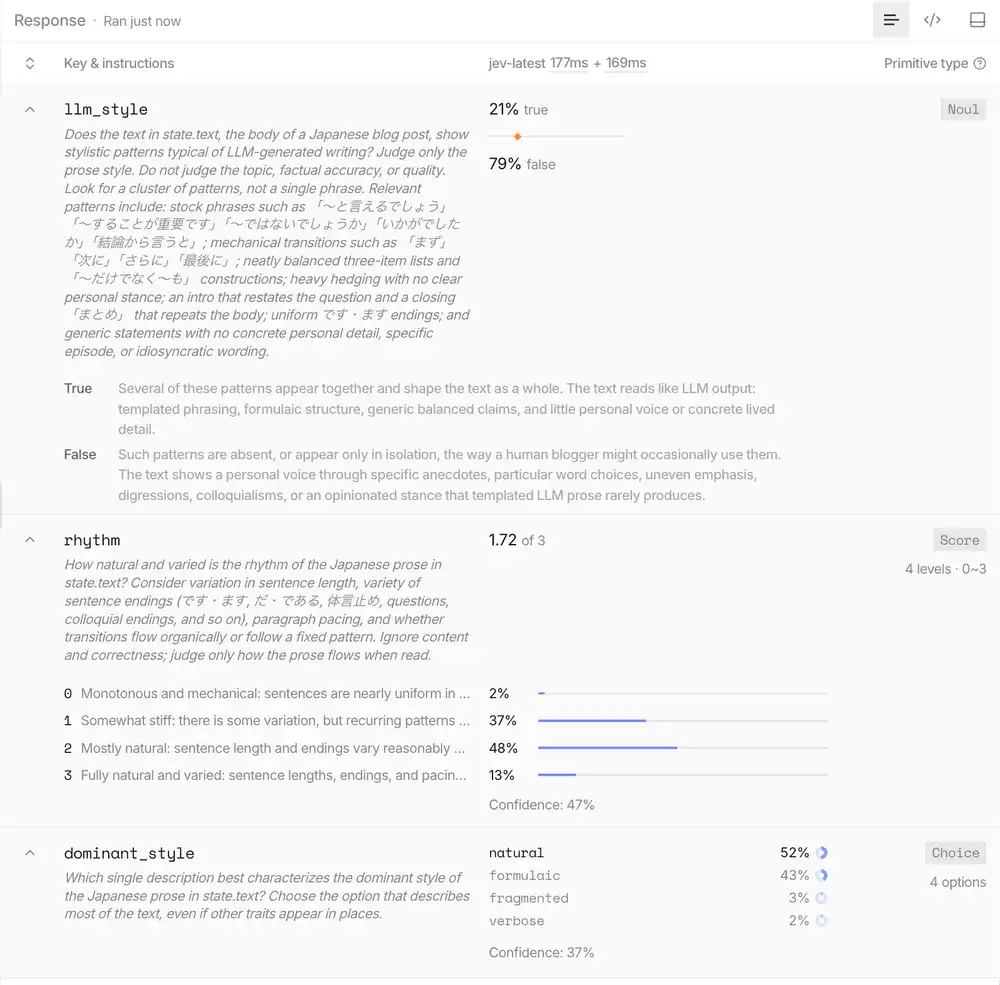
| Claude Opus 5 | Qwen(A) | 21% | 1.72 | natural 52%, formulaic 43% |
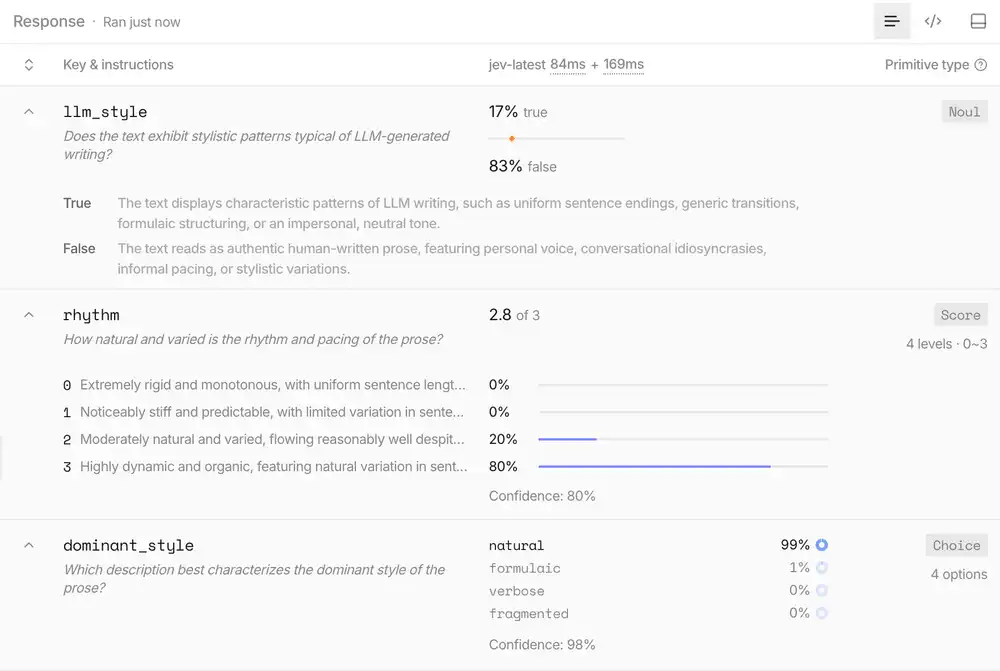
| Gemini 3.8 Flash High | ESPRIMO(A) | 17% | 2.80 | natural 99% |
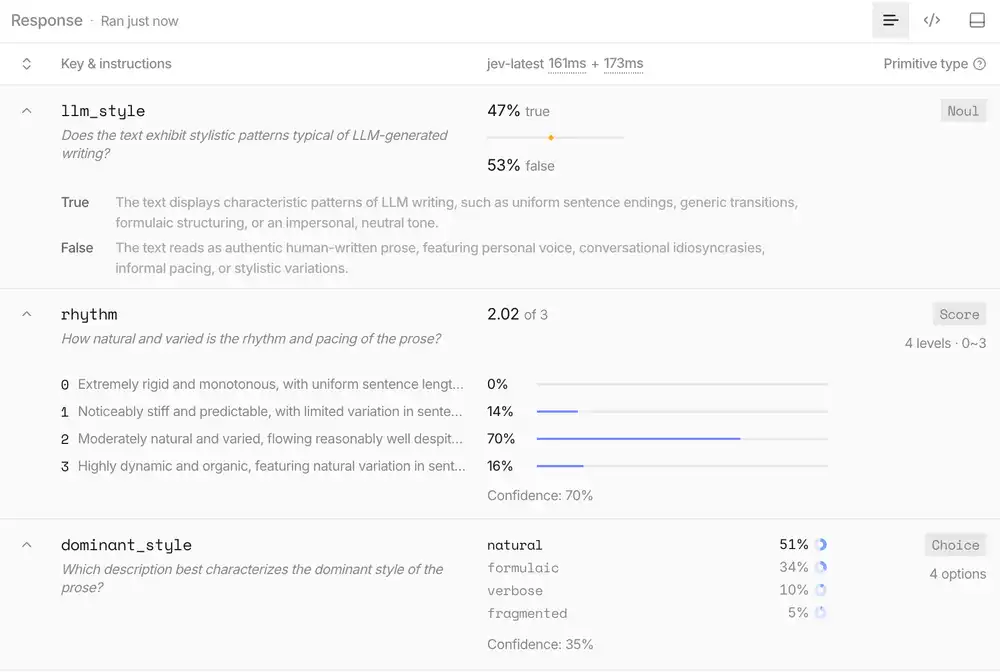
| Gemini 3.8 Flash High | Qwen(A) | 47% | 2.02 | natural 51%, formulaic 34% |
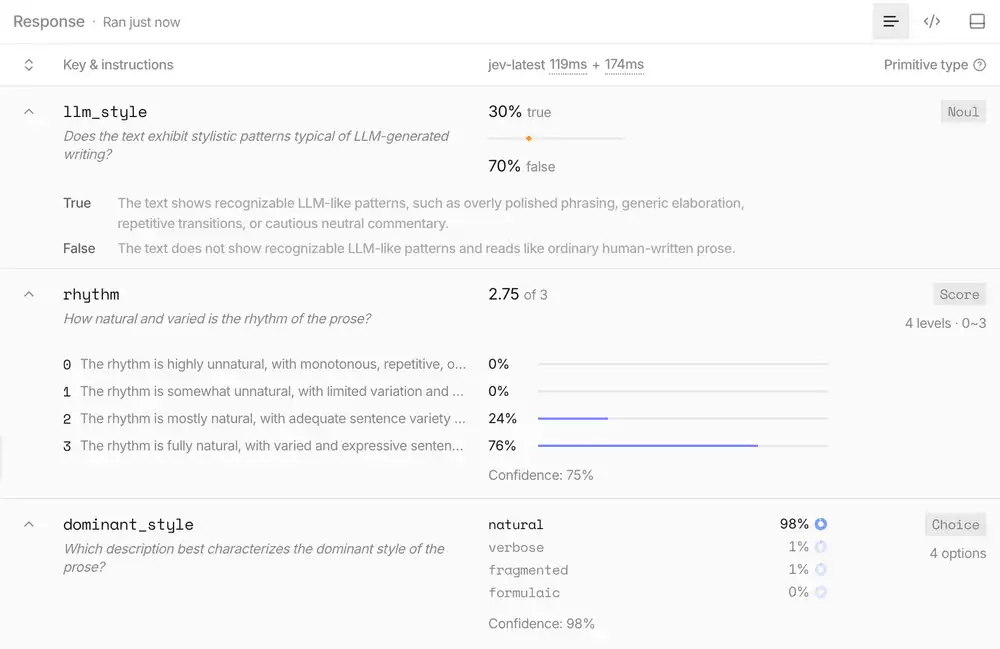
| Qwen3.8-Max | ESPRIMO(A) | 30% | 2.75 | natural 98% |
| Qwen3.8-Max | Qwen(A) | 55% | 1.71 | natural 67%, verbose 26% |
画面のレイテンシ表示は次の通りだった。
- Claude Opus 5: ESPRIMOが179 + 235ms、Qwenが177 + 169ms
- Gemini 3.8 Flash High: ESPRIMOが84 + 169ms、Qwenが161 + 173ms
- Qwen3.8-Max: ESPRIMOが119 + 174ms、Qwenが127 + 208ms
どのモデルが書いたスキーマでも、ESPRIMO記事よりQwen記事のほうがllm_style(LLMっぽさ)の確率は12〜32ポイント高く出た。
またrhythmも、すべてのスキーマでESPRIMO記事が2点台後半、Qwen記事が1点台から2点台前半となり、文のリズムの採点差も一貫していた。
スキーマごとの差を見ると、Claude Opus 5版は両方の記事でllm_styleが低めに出ている(9%と21%)。
Claudeのスキーマは判定基準の中に「〜と言えるでしょう」「〜することが重要です」「いかがでしたか」「まず/次に/さらに/最後に」など、日本語の典型的な言い回しを具体的に指定していた。基準に具体的な語句を多く含めたClaude版では、全体としてtrueの判定確率が低く出た形だ。
Gemini版(17%対47%)とQwen版(30%対55%)は、Codex版(29%対61%)に近い25〜30ポイントの開きが出た。
Qwen版のdominant_styleでは、Qwen記事でverbose(冗長)が26%選ばれており、Codex版の67%と同様に説明過多な傾向が拾われていた。
質問文を書いたモデルによって絶対値の高さは異なるが、人間が書いた文章とLLMが書いた文章の開きはどのスキーマでも再現した。
Claude Opus 5のスキーマによるESPRIMO記事(A)の実行結果。
Claude Opus 5のスキーマによるQwen記事(A)の実行結果。
Gemini 3.8 Flash HighのスキーマによるESPRIMO記事(A)の実行結果。
Gemini 3.8 Flash HighのスキーマによるQwen記事(A)の実行結果。
Qwen3.8-MaxのスキーマによるESPRIMO記事(A)の実行結果。
Qwen3.8-MaxのスキーマによるQwen記事(A)の実行結果。