MiniMax H3の枝刈りGGUFをEVO-X2で動かして、かなちゃんを喋らせた
 目次
普段はLLMを動かしているGMKtec EVO-X2で、動画と音声をいっしょに生成するMiniMax H3を試した。
本体の枝刈り版をGGUFに量子化した重みがUnslothから配布されているので、stable-diffusion.cppのROCm版で動かしてみる。
今回はQ4_Kという4ビット中心の量子化形式を選び、Qwen-Image 2.1で使ったかなちゃんの立ち絵を入力にして、テキスト生成、立ち絵からの動画化、2人の参照画像による生成を順に試した。
検証環境
| 項目 | 内容 |
|---|---|
| 本体 | GMKtec EVO-X2(Ryzen AI Max+ 395、Radeon 8060S / gfx1151) |
| メモリ | 64GB(BIOSで48GBをVRAMに割り当て。ROCm上では55,160MiBと表示) |
| OS | Windows 11 Pro 26200、GPUドライバー 32.0.31041.1004 |
| 実行系 | stable-diffusion.cpp master-929-3f8527a(公式配布の win-rocm-7.14.0-x64) |
| HIPランタイム | llama.cppのHIPビルド(C:\llama-hip-b1328)に入っていたDLLを流用 |
| 本体の重み | unsloth/MiniMax-H3-GGUF の fl2va_pruned-Q4_K(11.4GB)、ref2va_pruned-Q4_K(11.4GB) |
| テキストエンコーダー | 同じリポジトリの qwen3vl_32b_minimax_h3-Q4_K_M(18.2GB) |
| VAE | Comfy-Org/MiniMax-H3 の minimax_h3_video_vae_fp16(5.2GB)、minimax_h3_audio_vae_fp32(0.6GB) |
| 共通設定 | CFG 1.0、シード42、--rng cpu、--diffusion-fa。キツネは4ステップ、人物は8ステップ |
MiniMax H3と枝刈りGGUF
H3の配布モデルには、動画を生成する本体が2種類ある。
別々のチェックポイント(重みのファイル)なので、入力に合わせて読み込むファイルを選ぶ。
本体とは別に、文章や参照画像をモデルが扱える情報へ変換するテキストエンコーダーと、映像・音声を内部表現との間で変換するVAEも読み込む。
テキストエンコーダーはH3向けに調整されたQwen3-VL-32Bを使う。
| 本体 | 入れられるもの |
|---|---|
| fl2va | テキストと、最初のフレーム・最後のフレーム(0〜2枚) |
| ref2va | テキストと、参照用の画像・動画・音声 |
Unslothの配布一覧では、どちらの本体にもQ2_KからQ8_0までの枝刈り・量子化版がある。
表はfl2vaのファイル容量で、GBは10億バイトとして計算した。
Q2やQ4の数字が小さいほど、重みを保存するビット数を抑えた形式になる。
UD付きは、モデルの部分ごとに精度を変えた混合量子化版だ。
| 量子化 | fl2va_pruned | 組み合わせるテキストエンコーダー |
|---|---|---|
| Q2_K | 6.72GB | Q2_K_M(13.1GB) |
| UD-Q2_K_XL | 8.06GB | Q2_K_M |
| Q3_K | 8.76GB | Q4_K_M(18.2GB) |
| UD-Q3_K_XL | 9.56GB | Q4_K_M |
| Q4_K | 11.42GB | Q4_K_M |
| Q5_0 | 13.92GB | Q4_K_M |
| Q6_K | 16.59GB | Q4_K_M |
| Q8_0 | 21.44GB | Q4_K_M |
Comfy-Orgのfl2va配布ファイルは、16ビット形式のBF16だと枝刈り前が66.3GB、枝刈り後が40.2GBある。
11.42GBのQ4_Kは、枝刈り後のBF16の約28%になる。
これはファイル容量の比較で、推論中に必要なメモリ全体を表す値ではない。
今回は本体をQ4_K、テキストエンコーダーをQ4_K_Mにした。
UnslothのREADMEの例は、次のオプションを付けている。
| オプション | 理由 |
|---|---|
--mode vid_gen | ないと画像生成として扱われて止まる |
--cfg-scale 1.0 | H3は蒸留済みでCFG(プロンプトに従わせる強さ)を使わない。既定値の7.0のままだと止まる |
--backend te=cpu | 例のQ2_K_MテキストエンコーダーをCPU側に置き、GPUメモリを節約する |
このEVO-X2はメモリの48GBをVRAMに割り当てており、Windowsから見えるRAMは15.6GiBだった。
今回のQ4_K_Mテキストエンコーダーはファイルサイズだけで18.2GBあるため、15.6GiBのRAMには入り切らない。そのため --backend te=cpu は外し、GPU側にまとめて載せる構成にした。
READMEでは3つとも必須と書かれているが、今回の環境ではCPU配置を使わずに生成できた。
配布ライセンスはMiniMax H3 Community License Agreement。
stable-diffusion.cppのROCm版を動かす
検証に使ったリリースには、WindowsのROCm版とVulkan版がある。
ROCmはAMDのGPUで計算する実行基盤で、今回はその中のHIPランタイムを使う。
Vulkan版はそのまま起動して、Radeon 8060Sが認識された。
ROCm版は sd-cli.exe、sd-server.exe、1GBある stable-diffusion.dll の3ファイル構成で、起動すると stable-diffusion.dll を読み込めないエラーで止まった。
配布ファイルにHIPランタイム(amdhip64_7.dll など)が含まれておらず、依存DLLが足りない状態だったためだ。
手持ちのllama.cppのHIPビルドフォルダーを環境変数PATHに追加すると、GPUが正常に認識された。
set PATH=C:\llama-hip-b1328;%PATH%
sd-cli.exe --list-devices
ggml_cuda_init: found 1 ROCm devices (Total VRAM: 55160 MiB):
Device 0: AMD Radeon(TM) 8060S Graphics, gfx1151 (0x1151), VMM: no, Wave Size: 32, VRAM: 55160 MiB
ROCm0 AMD Radeon(TM) 8060S Graphicsログに ggml_cuda_init と出ているが、ggmlの内部実装ではROCm環境でもCUDA系の名称がそのまま使われているためだ。
以降はすべてROCm版で生成した。
VRAM確保のためLLM常駐を停止する
このEVO-X2では普段Qwen3.8-27B(Q6_K)のllama-serverを常駐させており、モデルファイルだけで約22GBある。
H3は重みだけで約34GB使用するため、事前にllama-serverを停止してVRAMを空けた。
テキストだけで動かす
最初は、READMEの例と同じプロンプトで、画像を入れずに生成した。
a red fox trotting through falling snow, cinematicsd-cli.exe --mode vid_gen ^
--diffusion-model minimax_h3_fl2va_pruned-Q4_K.gguf ^
--llm qwen3vl_32b_minimax_h3-Q4_K_M.gguf ^
--vae minimax_h3_video_vae_fp16.safetensors ^
--audio-vae minimax_h3_audio_vae_fp32.safetensors ^
--prompt "a red fox trotting through falling snow, cinematic" ^
--width 640 --height 384 --video-frames 25 --steps 4 --cfg-scale 1.0 ^
--diffusion-fa --vae-tiling --rng cpu -s 42 ^
--output out.webm起動ログでは、重みが全部VRAMに載っていた。
total params memory size = 33909.96MB (VRAM 33909.96MB, RAM 0.00MB): text_encoders 17375.93MB(VRAM), diffusion_model 10975.93MB(VRAM), vae 5558.10MB(VRAM)25フレームを指定したが、出てきた動画は39フレームだった。
検証した版のドキュメントでは、フレーム数を「17の倍数+5」に切り上げる。
25の次は39(17×2+5)になる。
フレームレートも24fpsに固定で、ほかの値を指定しても上書きされる。
| 項目 | 時間 |
|---|---|
| プロンプトの読み取り | 9.91秒 |
| 生成(4ステップ、1ステップ約10秒) | 45.88秒 |
| 音声のデコード | 1.02秒 |
| 動画のデコード | 30.27秒 |
| 合計 | 87.12秒 |
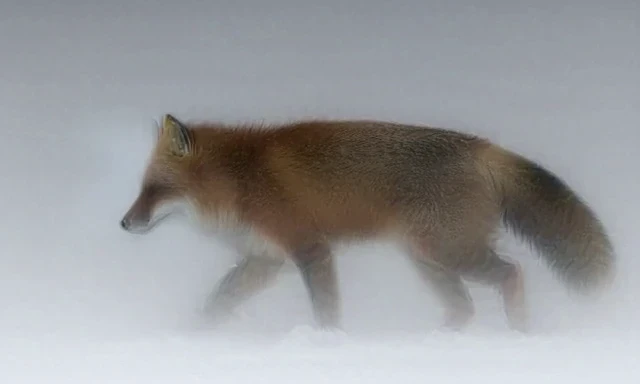
元のwebmには32kHzのステレオ音声トラックがあり、測定した平均音量は-56.5dB、最大音量は-43.3dBだった。
デジタル音声の上限を0dBとする値なので、負の値が大きいほど音は小さい。
音の指定をしていないプロンプトで小さい値が出たが、指定の有無による比較はしていない。
再生して聴いても、風や足音などの音は聞こえなかった。
かなちゃんの立ち絵を1フレーム目にする
かなちゃんは、昔同人誌で使ったキャラで、StackChanの顔にもしている。
Qwen-Image 2.1の記事で編集の入力にした、正面で両腕を下ろした立ち絵を最初のフレームにした。
この使い方をI2VA(画像から音声付き動画を生成する方式)と呼ぶ。
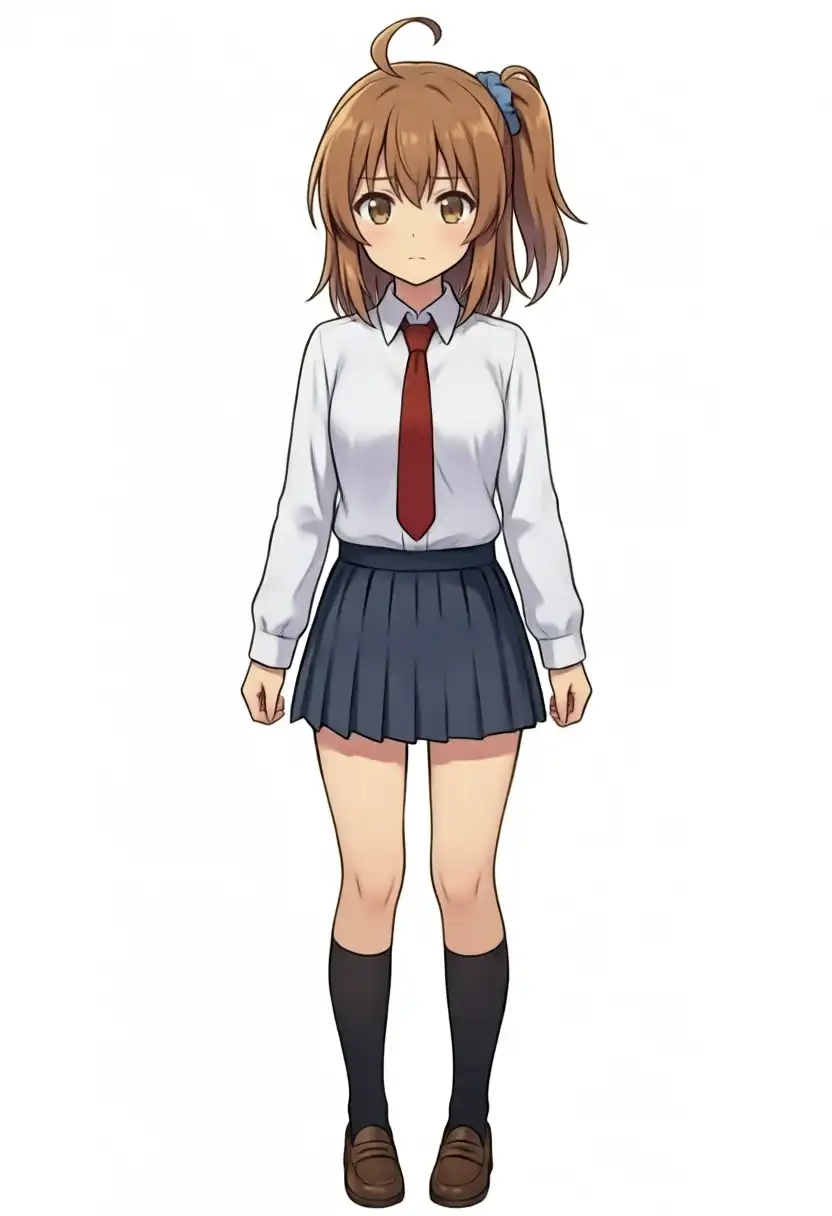
プロンプトでは、笑って右手を振り、首をかしげて、日本語で「やっほー、かなだよ!」と言うよう書いた。
Anime style animation. The girl with brown side ponytail and blue scrunchie smiles brightly, raises her right hand and waves at the viewer, then tilts her head cutely. Her hair and skirt sway gently. Static camera, clean white background, consistent character design. She says cheerfully in Japanese: "やっほー、かなだよ!"832x1216の立ち絵を、同じ縦横比の416x608で、56フレーム(約2.3秒)・8ステップにした。
VAEエンコード時の停止
最初はキツネと同じく --vae-tiling を付けていたら、立ち絵のVAE変換中、6つのタイルのうち2つ目でエラーを出さずに終了した。
--vae-tiling を外すと最後まで進んだ。
生成されたかなちゃんの動画
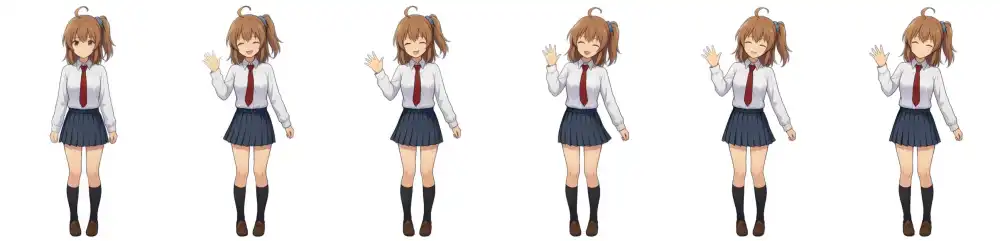
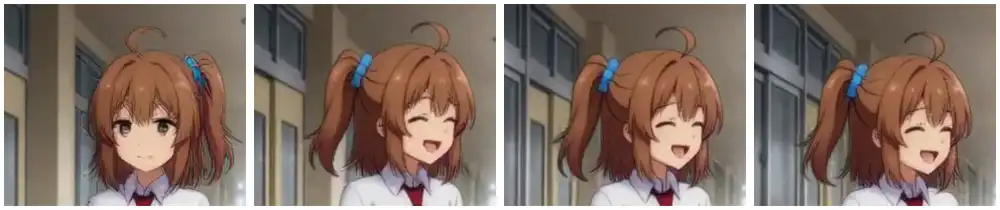
0フレーム目の真顔から、11フレーム目には口を開けた笑顔になり、画面左の手(本人の右手)を挙げて、最後まで振っていた。
並べた6枚では、アホ毛、画面右のサイドポニーと青いシュシュ、赤いネクタイ、紺のスカート、黒の靴下が保たれていた。
首をかしげる動きは、6枚を並べた範囲でははっきりしなかった。
後から顔まわりを3フレームおきに切り抜いて確認すると、1.25秒以降は頭が少し傾いていた。
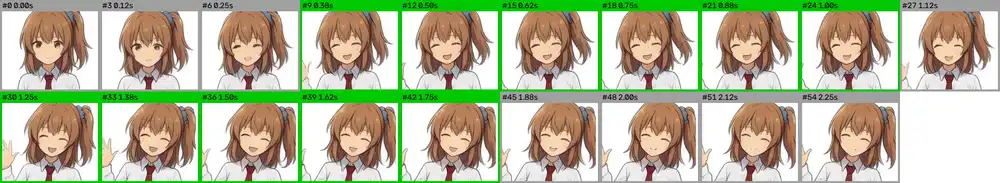
緑枠は、音声解析(pYINアルゴリズム)で声が出ていると判定された時刻を示している。
声ありの0.38〜1.00秒と1.25〜1.75秒では口が開き、1.88秒以降は閉じていって、2.12秒には口を閉じた笑顔になっていた。
抽出したフレームでは口の開閉と声が出ている区間がおおむね対応していた。
ただ、再生して確認すると口パクとセリフのタイミングは合っていなかった。
声が出ているのに口が動かない部分や、途中で口が閉じる部分がある。
音声を、Whisper(large-v3-turbo)で文字起こしした。
| 指定したセリフ | 文字起こし |
|---|---|
| やっほー、かなだよ! | ヤッホー!カナダよ! |
文字起こしには、指定したセリフに近い内容が出た。
「かなだよ」が「カナダよ」になっているが、聴くと「やっほー、かなだよー」と聞こえた。
語尾は指定の「!」で切らず、伸ばしていた。
2人を参照画像で指定する
2人の見た目を別々の参照画像で指定するため、Ref2VA(参照素材から音声付き動画を生成する方式)の本体を使った。
stable-diffusion.cppでは参照画像の引数 -r を繰り返せる。
この方式は最初・最後のフレームとは併用できない。
もう1人は、Qwen-Image 2.1の部分編集の記事で使った2人の立ち絵から、左の金髪の子を切り出した。
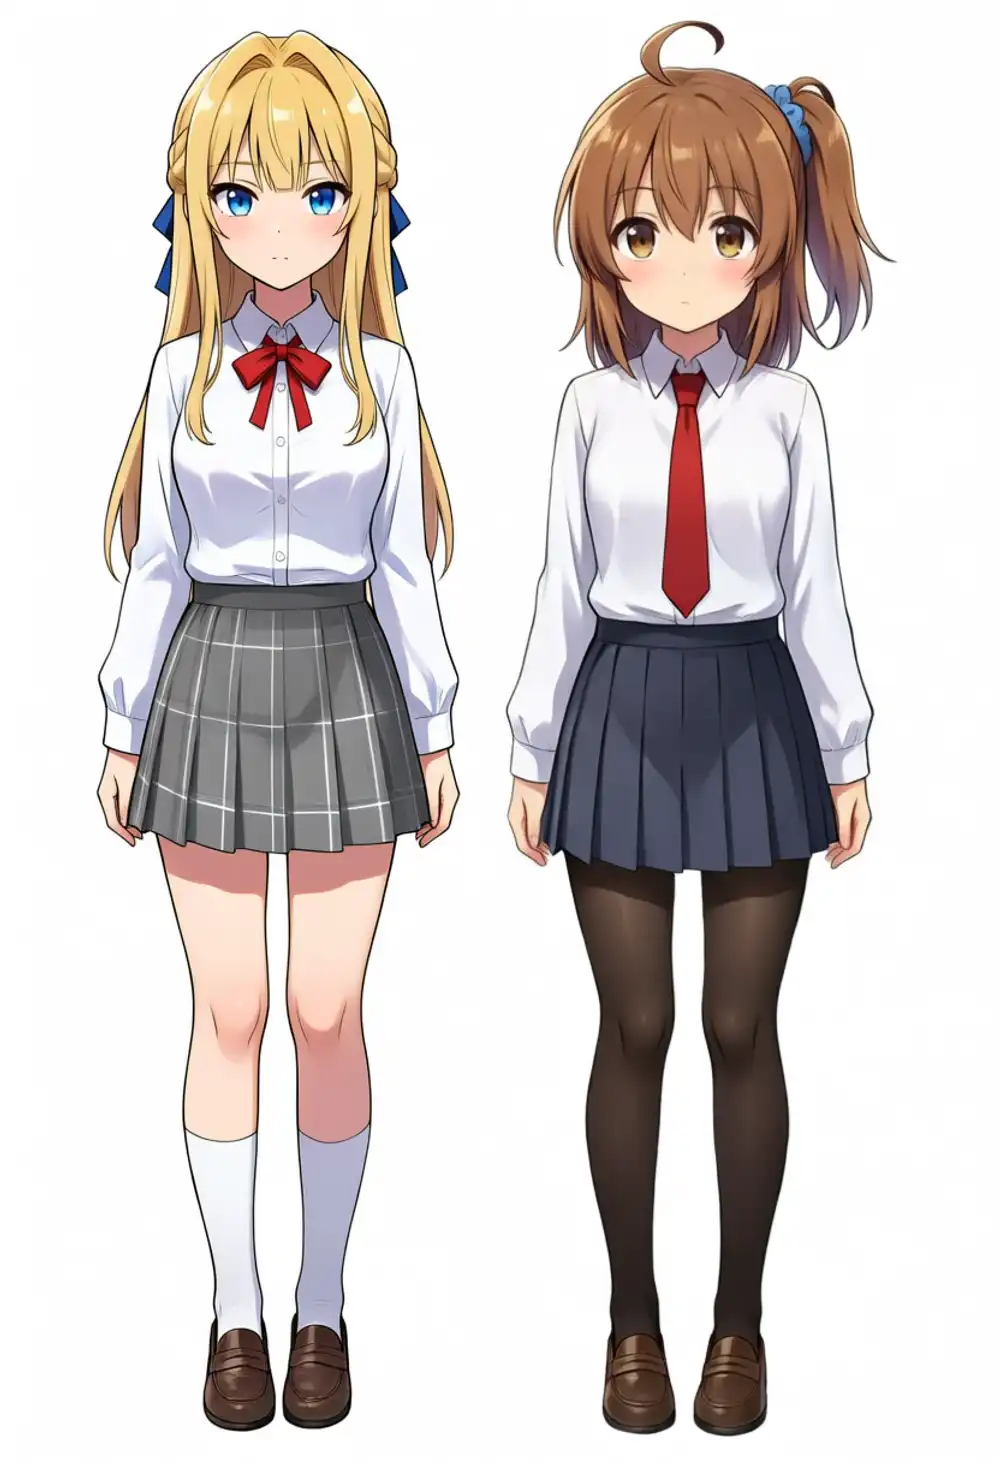
プロンプトでは、参照画像を <Picture 1> <Picture 2> で指し、それぞれの見た目も書いた。
Anime style animation. Use the girl from <Picture 1> (brown side ponytail with a blue scrunchie, red necktie, navy skirt, black socks) and the girl from <Picture 2> (long blonde hair with blue ribbons, blue eyes, red bow, grey plaid skirt, white socks). Keep both characters' appearance and identity consistent with the references. The two girls walk side by side along a sunny school hallway toward the camera, chatting happily. The brown-haired girl on the left turns to her friend and laughs, the blonde girl on the right smiles and nods. Medium shot, slow tracking camera, soft daylight. The brown-haired girl says in Japanese: "ねえ、今日の帰りクレープ食べに行こうよ!" and the blonde girl answers: "いいね、行こう!"参照画像を入れたときの停止
最初は立ち絵をそのままの大きさ(832x1216と500x1462)で指定した。
ドキュメントは、参照画像の面積が出力キャンバスを超える場合に縮小すると説明している。
一方、当時の実行メモでは、元の大きさのままVAEへ渡っているように見えた。
参照画像をVAEで変換する6タイル分の進み具合が出たあと、エラーを出さずに終了した。
キャンバス(640x384)より面積が小さくなるよう、320x464と224x640に縮めてから渡しても、同じところで落ちた。
詳しいログを出すと、VAEのタイルの2つ目で、HIPグラフ(GPUの処理をまとめて記録して流す仕組み)の準備が終わった直後に止まっていた。
  |=========================>                        | 2/4 - 4.76it/s
[VERBOSE] ggml - ggml_backend_cuda_graph_compute: CUDA graph warmup complete
環境変数でHIPグラフを切ると、最後まで生成できた。
set GGML_CUDA_DISABLE_GRAPHS=1最初の立ち絵で落ちたのも、同じVAEのタイルの処理の中だった。
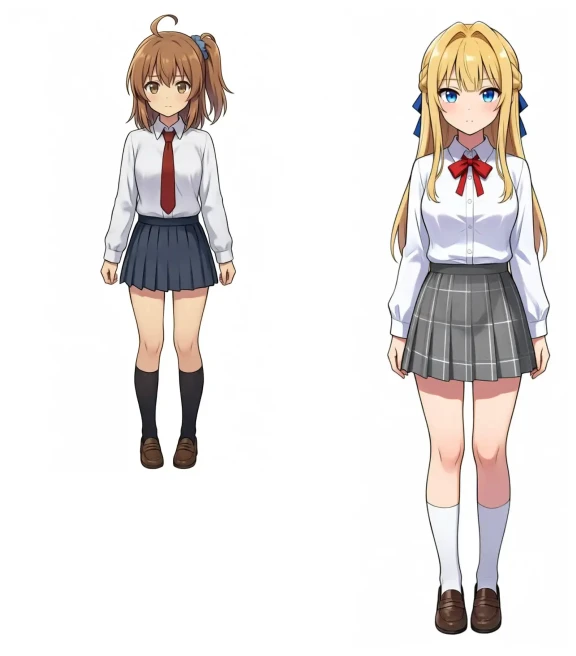
停止条件の切り分けと再現
当時の停止ログは再実行で上書きされて残っていなかった。
そこで同じ環境・シード42・8ステップ・56フレームで11回生成し、詳しいログ、終了コード、実行コマンドを残した。
| 入力 | HIPグラフあり | HIPグラフなし |
|---|---|---|
立ち絵1枚、--vae-tiling あり | 3回中、成功2・停止1 | 1回成功 |
| 参照画像2枚、元サイズ(832x1216、500x1462) | 3回とも停止 | 1回成功 |
| 参照画像2枚、縮小(320x464、224x640) | 3回中、成功2・停止1 | 初回の動画で成功 |
縮小した参照画像でHIPグラフを切った条件は、上に載せた2人の動画で成功している。
今回の11回の再現では、その条件は実行していない。
停止した5回は、すべて終了コードが 0xC00000FD(スタックオーバーフロー)だった。
VAEエンコードのタイル処理中に、ログの CUDA graph warmup complete が出た直後で終わっている。
HIPグラフありで成功した4回では、同じ準備完了のログが最初に出たのは、最後に映像へ戻すVAEデコードの途中だった。
同じ条件でも準備が終わる段階が変わっており、エンコード中に終わった回が停止していた。
HIPグラフなしでは、タイル分割を付けた立ち絵1枚も、元サイズの参照画像2枚も最後まで生成できた。
この環境では、停止を防ぐために参照画像を縮小する必要はなかった。
成功した立ち絵1枚と縮小した参照画像2枚では、HIPグラフあり・なしの出力をそれぞれ比べた。
WebMファイル自体のハッシュは違うが、デコード後の映像と音声は両方の組でSHA-256が一致した。
今回比較できた2組では、HIPグラフの有無による出力内容の差はなかった。
追加のハッシュ記録では、立ち絵1枚の成功3本と最初の動画も、デコード後の映像・音声がすべて一致していた。
この条件では、--vae-tiling の有無による出力内容の差もなかった。
生成された2人の動画
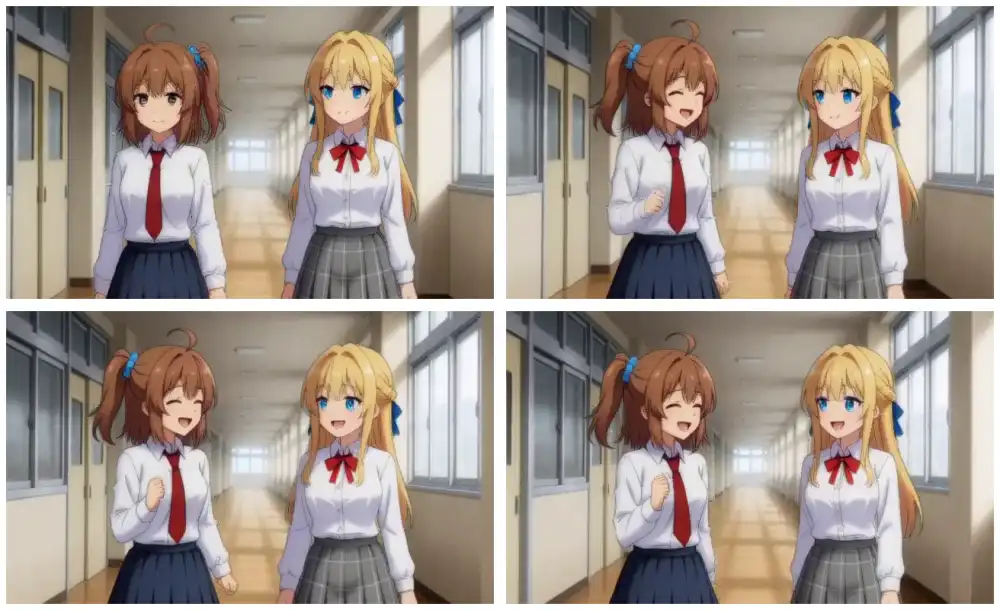
抽出した4枚では、2人の位置は入れ替わっていない。
髪の色、リボンとネクタイ、グレーのチェックと紺のスカートも描き分けられていた。
かなちゃんが笑いながら金髪の子の方を向き、金髪の子が笑って応えている。
2人の立ち位置は大きくは変わらず、歩行の動きはあまり見られなかった。
サイドポニーの位置
参照画像のかなちゃんは、サイドポニーが画面右(本人の左)にある。
0フレーム目は画面右にあったが、画面右の金髪の子の方へ顔を向けた18フレーム目からは、画面左に出ていた。
顔を画面右へ向けると、本人の左側で結んだ髪は奥へ回って見えにくくなるはずで、手前に見えているのは本人の右側で結んだ形になっている。
動画を再生すると、横を向いたところでサイドポニーが崩れ、後ろで結ぶポニーテールのような形になっていた。
セリフが時間に入り切らなかった
| 指定したセリフ | 文字起こし |
|---|---|
| ねえ、今日の帰りクレープ食べに行こうよ! / いいね、行こう! | ねえ今日の帰りクレープの |
56フレームは約2.3秒しかなく、文字起こしは1人目の途中で終わっている。
文字起こしには、金髪の子の返事に当たる内容は出なかった。
聴いても「ねえ今日の帰りクレープ」までは聞き取れ、その先は聞き取れなかった。
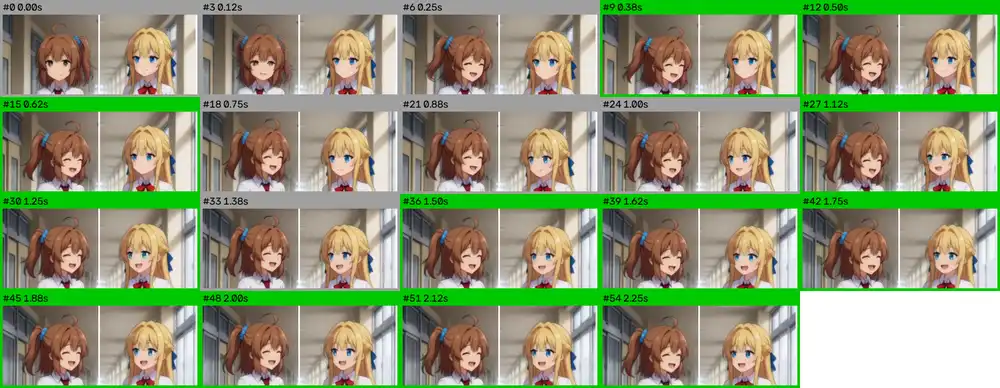
顔を3フレームおきに見ると、かなちゃんは0.38秒から最後まで口が開いていた。
金髪の子も1.25秒あたりから口が開き、後半は2人とも口が開いている。
生成時間とメモリ
| 内容 | 本体 | 大きさ | フレーム | ステップ | 生成 | 動画のデコード | 合計 |
|---|---|---|---|---|---|---|---|
| キツネ(テキストのみ) | fl2va | 640x384 | 39 | 4 | 45.88秒 | 30.27秒 | 87.12秒 |
| かなちゃん(1フレーム目) | fl2va | 416x608 | 56 | 8 | 152.68秒 | 33.66秒 | 199.87秒 |
| 2人(参照画像2枚) | ref2va | 640x384 | 56 | 8 | 155.99秒 | 34.56秒 | 205.38秒 |
56フレームでは、1ステップ約19秒だった。
fl2vaのログでは、重みは本体10,976MB、テキストエンコーダー17,376MB、VAE 5,558MBの合計33,910MBで、すべてVRAMに配置されていた。
ref2vaの本体は10,938MBで、合計は33,872MBだった。
これらは重みが占めるメモリ量で、推論中のGPU専用メモリの最大値は成功13回で35.3〜36.9GiBだった。
合計時間はログの generate_video completed in で、コマンド起動からの全体の待ち時間とは区別している。
今回の2.3秒の人物動画は、どちらも約3分半だった。
この表の生成時間はシード42で各条件1回の値となっている。