MiniMax H3で振り向き・4人バンド・参照音声を試した
 目次
前回のMiniMax H3検証では、EVO-X2で枝刈りGGUFを動かし、かなちゃんの立ち絵1枚と2人の参照画像から音声付き動画を生成した。
今回はその続きとして、最初と最後のフレーム指定、4.5秒の掛け合い、4人バンド、参照音声による声の指定を試した。
検証環境
前回の記事と同じくGMKtec EVO-X2のROCm環境で生成した。
| 項目 | 内容 |
|---|---|
| 本体 | GMKtec EVO-X2(Ryzen AI Max+ 395、Radeon 8060S / gfx1151、VRAM割り当て48GB) |
| 実行系 | stable-diffusion.cpp master-929-3f8527a(win-rocm-7.14.0-x64)+ llama.cppのHIPビルドのDLL |
| 本体の重み | unsloth/MiniMax-H3-GGUF の fl2va_pruned-Q4_K、ref2va_pruned-Q4_K |
| テキストエンコーダー | qwen3vl_32b_minimax_h3-Q4_K_M |
| 共通の設定 | 8ステップ、CFG 1.0、シード42、--rng cpu、--diffusion-fa、GGML_CUDA_DISABLE_GRAPHS=1 |
fl2vaは最初・最後の絵で動画を指定するモデル、ref2vaは見た目や声の参照素材を指定するモデルだ。
CFGは生成時のプロンプト追従度を調整する値で、今回は1.0に固定した。
前回の検証で参照画像の変換中に止まったため、GPU処理をまとめて実行するHIPグラフを無効化した設定を引き継いでいる。
| 実験 | 本体 | 入力 | 大きさ | フレーム |
|---|---|---|---|---|
| 振り向き | fl2va | 最初と最後のフレーム | 416x608 | 56(約2.3秒) |
| ジャンプ | fl2va | 最初と最後のフレーム | 416x608 | 56(約2.3秒) |
| 2人の掛け合い | ref2va | 参照画像2枚 | 640x384 | 107(約4.5秒) |
| 4人バンド | fl2va | 最初のフレーム | 672x384 | 107(約4.5秒) |
| 声の指定なし | ref2va | 参照画像1枚 | 416x608 | 73(約3秒) |
| 声の指定あり | ref2va | 参照画像1枚+参照音声 | 416x608 | 73(約3秒) |
| WAVだけを追加(切り分け) | ref2va | 参照画像1枚+参照音声。声を合わせる指示文なし | 416x608 | 73(約3秒) |
最初と最後のフレームを指定する
fl2vaモデルでは、最初と最後のフレームを指定してその間を動画化できる(FL2VA方式)。
最初の絵を -i、最後の絵を --end-img で指定する。
両端には、Qwen-Image 2.1のローカル版の記事で、正面の立ち絵から編集した後ろ姿とジャンプ姿を使った。
振り向き
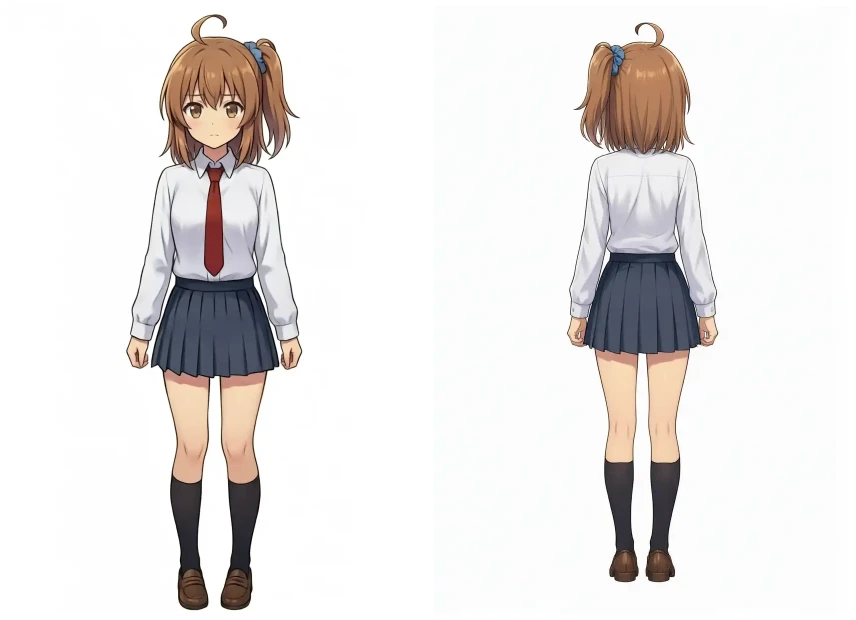
後ろ姿の絵は、サイドポニーと青いシュシュが画面左(本人の左)にある。
正面の立ち絵では画面右(本人の左)なので、両端で結ぶ側はそろっている。
プロンプトでは、その場でゆっくり左回りに振り向くことと、サイドポニーは同じ側に結んだままにすることを書いた。
Anime style animation. The girl with brown side ponytail and blue scrunchie stands facing the viewer, then slowly turns around in place to her left until her back faces the camera. Her side ponytail stays tied on the same side of her head while she turns. Smooth natural rotation, hair and skirt sway gently. Static camera, clean white background, consistent character design. Quiet room tone, soft footsteps.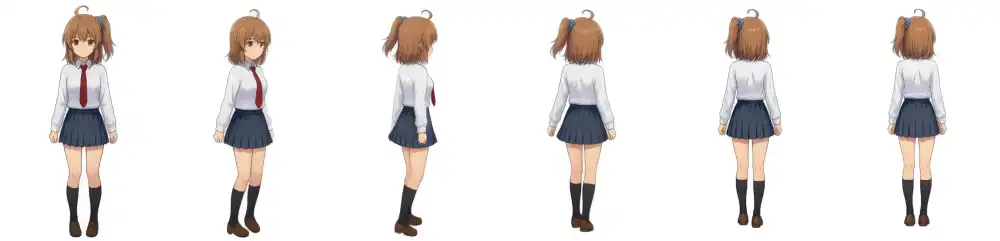
11フレーム目で画面右へ顔を向け、22フレーム目で真横、33フレーム目には背中を向けていた。
後から3フレームおきに見ると、0.38秒から画面右、つまり本人の左へ回り始め、1.38秒以降は後ろ姿になっていた。
途中で足を踏み替え、1.50秒以降はほぼ静止している。
抽出した6枚では、サイドポニーは横向きの間に頭の後ろへ回り、後ろ姿で画面左に出た。
この範囲では、本人の左側に結んだ状態が保たれていた。
前回の2人の動画では、顔を横に向けたところで結ぶ側が入れ替わっていた。
今回は同じ入れ替わりは起きていなかったが、生成方式や構図も異なるため、最後の絵を指定した効果だけによる差とは限らない。
測定した平均音量は-50.1dBだった。
ここでのdBはデジタル音声の上限を0とした値で、負の値が大きいほど音は小さい。
プロンプトには静かな部屋の音と足音を書いたが、聴いても足音や部屋の音は聞こえなかった。
ジャンプ
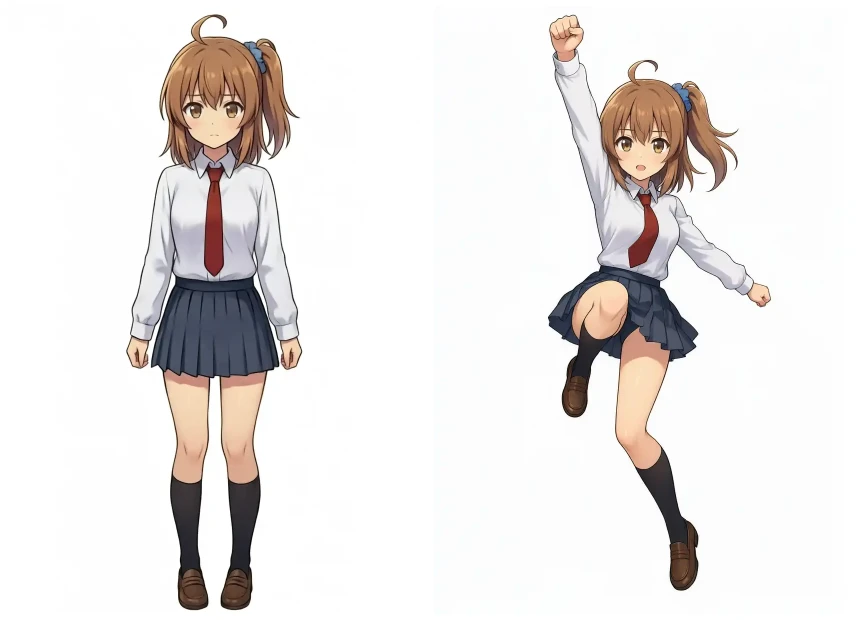
Anime style animation. The girl with brown side ponytail and blue scrunchie bends her knees, then jumps up energetically, thrusting her right fist into the air with an excited open-mouth smile. Her hair and skirt fly up with the motion. Static camera, clean white background, consistent character design. She shouts cheerfully in Japanese: "よーし、がんばるぞー!"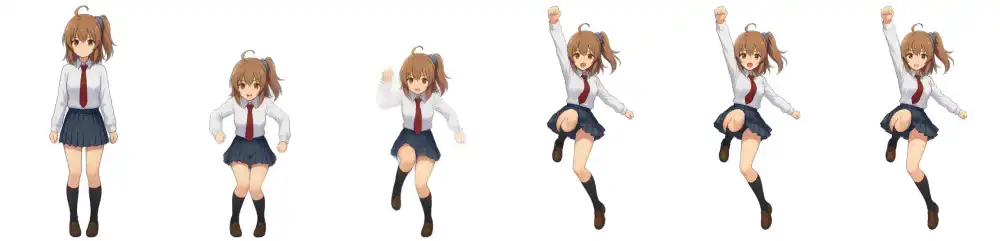
11フレーム目で膝を曲げてかがみ、22フレーム目で跳び上がって、33フレーム目で最後の絵と同じポーズになった。
3フレームおきの確認では、1.12秒で最後の絵のポーズになり、2.25秒まで約1.1秒、体はほぼ同じポーズのままだった。
最後の絵が空中なので、地面に降りないまま終わっていた。
Whisperのlarge-v3-turboで文字起こしすると、「よーし、がんばるぞー!」と出た。
聴いても「よーし、がんばるぞー」と聞こえ、指定したセリフと一致していた。
口パクは前の記事の動画と同じく、声に合っていなかった。
音の時間変化を周波数ごとに描いたスペクトログラムに、推定した声の高さ(基本周波数F0)を重ねてみた。
ジャンプの音声は0.3〜0.8秒にも倍音が出ているが、その大部分をpYINアルゴリズムが有声と判定していなかった。
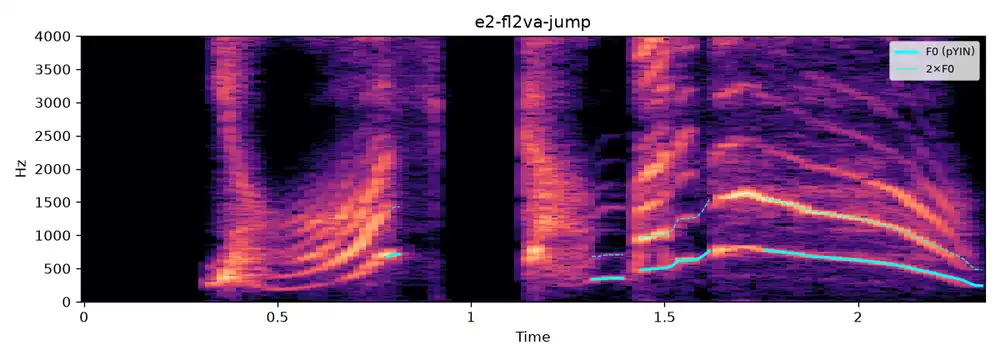
この音声のF0中央値580.1Hzは、ほぼ1.3秒以降の後半の声から計算された値だ。
2人の掛け合いを4.5秒に延ばす
前回、2人のセリフが56フレーム(約2.3秒)に入り切らず、1人目の途中で切れていた。
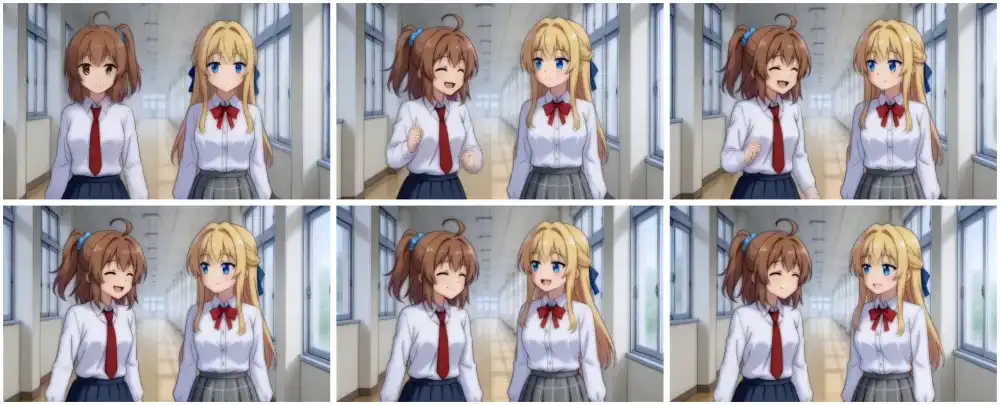
プロンプトとシードはそのままで、フレームを107(約4.5秒)に増やした。
| 区間 | 文字起こし | 声の高さ(中央値) |
|---|---|---|
| 0.0〜3.2秒 | ねえ今日の帰りクレープ食べに行こうよ | 417Hz |
| 3.2〜4.3秒 | いいね行こ | 410Hz |
文字起こしには、1人目のセリフに続いて2人目の返事も出た。
指定の「いいね、行こう!」に対して文字起こしは「いいね行こ」で、聴いても「いいね、行こ」と語尾の「う」がなかった。
かなちゃんは21〜63フレーム目で口が開き、84フレーム目では金髪の子の口が開いていた。
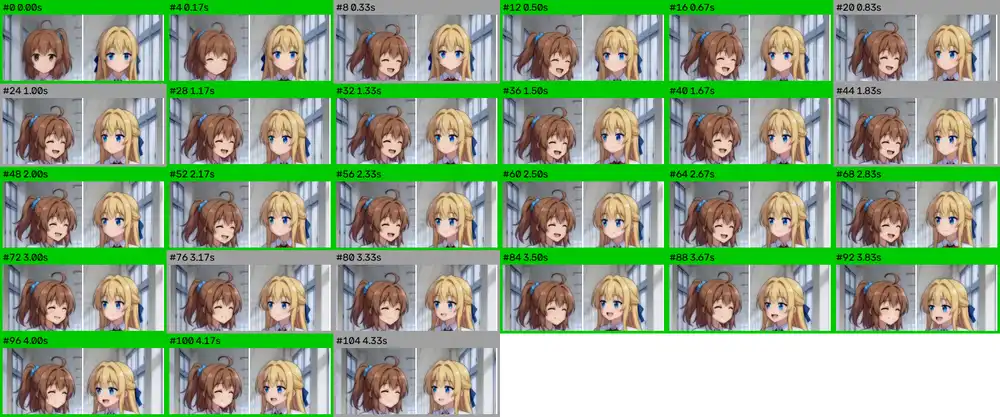
4フレームおきに確認した範囲でも、0.50〜3.17秒はかなちゃんの口が開き、金髪の子は口を閉じていた。
3.50秒以降は金髪の子の口が開き、かなちゃんは目を閉じた笑顔で口はほぼ閉じている。
この入れ替わりは、解析した声の区間とおおむね対応していた。
ただ、再生すると口パク自体は声に合っていなかった。
口が動いていなかったり、途中で閉じたりしていた。
声の高さは、声帯の振動に対応する基本周波数F0を推定して比べた。
音声解析ライブラリlibrosaのpYINを使い、16kHzのモノラル音声から80〜800Hzの範囲で、声が出ていると判定された部分だけを測った。
表の区間はWhisperの文字起こし、声の高さは0〜3.2秒と3.2〜4.46秒の音声に対する値だ。
2人の声の中央値はほぼ同じだった。
声の高さ以外も比べるため、後日、SpeechBrainのECAPA-TDNNでも解析した。
話者の識別に使うモデルで、音声を特徴のベクトルに変換し、その向きの近さをコサイン類似度で比べる。
値は-1〜1の範囲で、高いほどモデルが取り出した特徴が近い。入力は16kHzのモノラルにそろえた。
前半0〜3.2秒と後半3.2〜4.46秒の類似度は0.532だった。
後で試した、WAVを入れた同じセリフの出力どうしは0.885〜0.980なので、それより低い。
セリフが異なり、後半は約1.2秒と短いので、この値だけでは別の話者だと決められない。
聴くと、前半と後半は別人の声に聞こえた。
サイドポニーは、前回と同じく、金髪の子の方を向いた21フレーム目から画面左に移っていた。
再生すると、横を向いたところで後ろで結ぶポニーテールのような形に崩れるのも前回と同じだった。
4人バンドを演奏させる
Qwen-Image 2.1の早期アクセスの記事で、4人バンドの役割を自然文で指定して出した絵を、最初のフレームにした。
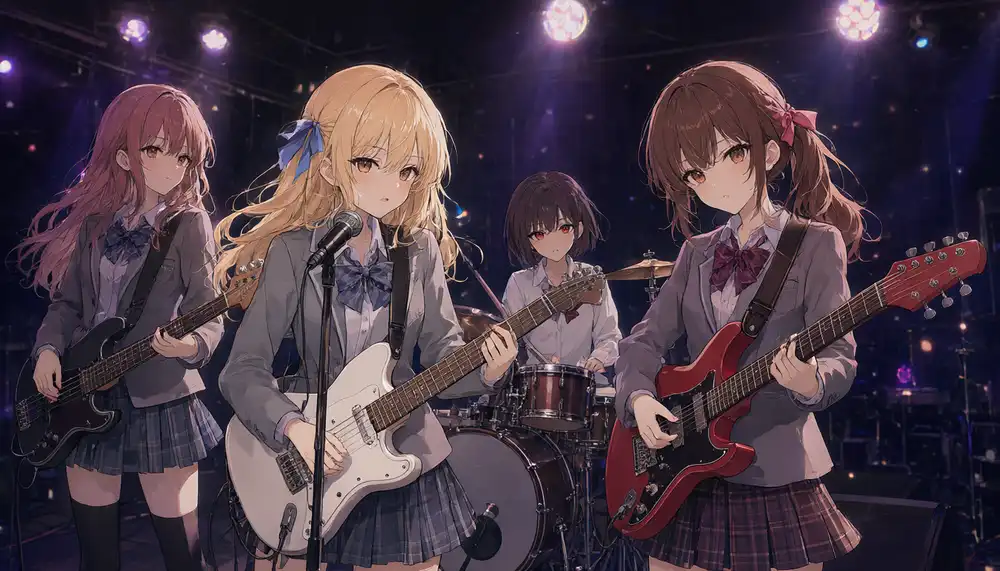
プロンプトには、4人の担当と、日本語の女性ボーカルが入ったJ-ROCKを流すこと、手の動きを音に合わせることを書いた。
Anime style animation. A four-girl rock band performs live on a dark stage with purple spotlights. The blonde girl in the center sings into the microphone while strumming her white electric guitar, the pink-haired girl on the left plays the black bass guitar, the short-haired girl in the back plays the drums with sticks, and the brown-haired twin-tail girl on the right plays the red electric guitar. Energetic upbeat J-rock music with driving drums, distorted guitars, bass, and a bright female vocal singing in Japanese. Instruments and hand movements are synchronized with the music. Stage lights flicker, slow push-in camera.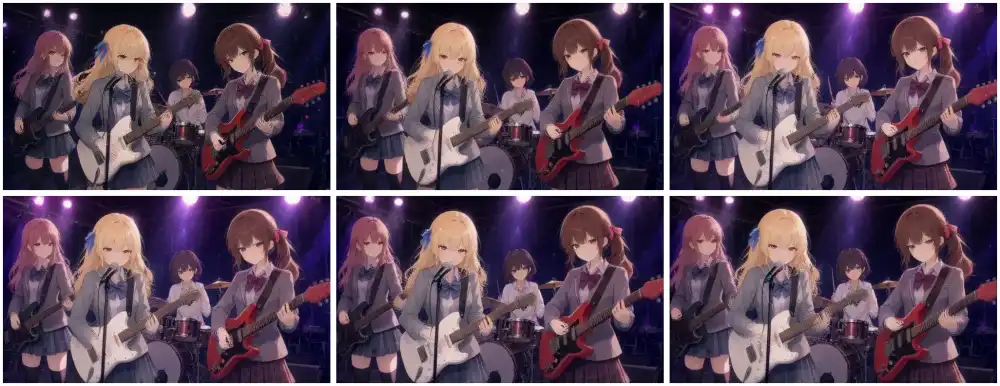
並べた6枚では、4人の髪型、楽器、服は入れ替わらずに残っている。
後のフレームほど人物が大きくなっており、カメラが寄る指定に沿っていた。
| 項目 | 結果 |
|---|---|
| 音量 | 平均-11.0dB、最大-0.0dB |
| テンポ(librosaの推定) | 約94BPM(1分あたりの拍数) |
| 20〜150Hz未満のエネルギーの割合 | 47% |
| 文字起こし(日本語を指定) | You choose a baby, tell your love to die, tell your love to die |
セリフを入れたほかの動画(平均-15.7〜-19.8dB)より音が大きく、低音が半分近くを占めていた。
日本語を指定して文字起こししたのに、英語のような歌詞が出た。
これだけでは、日本語の歌唱になっていないのか、歌声の認識に失敗したのかを区別できない。
聴くと歌ってはいるが、歌詞は聞き取れず、日本語なのかもよく分からなかった。
ドラマーのまわりを2フレームおきに切り抜き、音の立ち上がりに近い時刻も示して比べた。
手とスティックは手前のギターのネックや右の子の腕に隠れており、フレーム一覧ではドラムの音との対応は判断できなかった。
再生すると、曲に合わせてギターを弾き、ドラムを叩いている動きにはなっていた。
ただ、ギターの運指が音と合っているかは判断しづらかった。
ドラムはシンバルを叩いているが、ハイハットを叩いている様子はなかった。
参照音声で声の高さが変わるか
前回のかなちゃん単体の動画と、2人の動画では、喋っている声の高さが違っていた。
| 動画 | 声の高さ(中央値) |
|---|---|
| かなちゃん単体(前回) | 618Hz |
| 2人の掛け合い(前回) | 393Hz |
ref2vaモデルは、--ref-audio でWAVを参照音声として指定できる。
前回のかなちゃん単体の動画から「やっほー、かなだよ!」の1.9秒を切り出し、参照音声にした。
プロンプトでは <Audio 1> で参照した。
画像、シード、解像度、ステップ数、セリフをそろえて2本出した。
参照音声ありでは、WAVを指定するのに加えて、声を <Audio 1> に合わせる1文をプロンプトへ足した。
Anime style animation. Use the girl from <Picture 1> (brown side ponytail with a blue scrunchie, red necktie, navy skirt, black socks). Keep her appearance and identity consistent with the reference. Her voice must match the voice in <Audio 1>: same speaker, same pitch and timbre. She stands in a sunny park, looks at the viewer, smiles and talks cheerfully with small hand gestures. Medium full shot, static camera, soft daylight, birds chirping. She says in Japanese: "今日はいい天気だね、お散歩に行こうよ!"参照音声なしの方は、Her voice must match ... の1文を抜いている。
どちらの影響かを確かめるため、WAV単体のみを足した条件も合わせて比較した。
参照音声なし
参照音声あり
| 音声 | 文字起こし | 声の高さ(中央値) | 下位10%〜90%の範囲 |
|---|---|---|---|
| 参照音声(前回の声) | ヤッホー!カナダよ! | 615Hz | 506〜739Hz |
| 参照音声なし | 今日はいい天気だねお散歩に行こうよ | 425Hz | 315〜521Hz |
| 参照音声あり | 今日はいい天気だね。お散歩に行こうよ。 | 538Hz | 429〜633Hz |
表の範囲は、声の高さの測定値を低い順に並べたときの10〜90パーセンタイル。
参照音声と声を合わせる指示を追加した条件では、中央値が425Hzから538Hzに上がり、参照の615Hzに近づいた。
ただ、参照の高さそのものには達していない。
聴き比べると、どちらも「今日はいい天気だね、お散歩に行こうよ」と聞こえた。
| 音声 | 聴いた印象 |
|---|---|
| 参照音声なし | 参照より若干低いが、不自然さはあまりない |
| 参照音声あり | 参照音声に近いが、水の中のようにどこかくぐもっている |
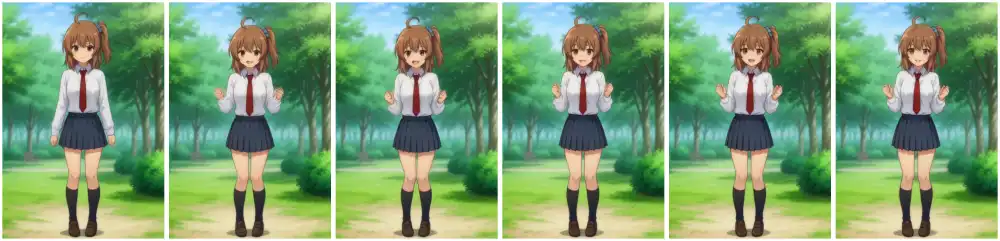
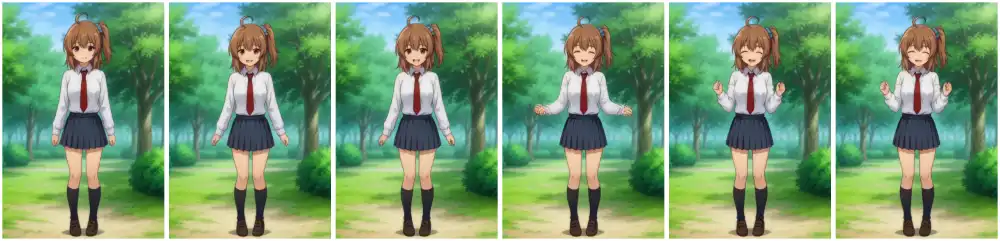
抽出した画像では、どちらもかなちゃんの見た目を保ち、サイドポニーは画面右にある。
参照音声ありの方は、後半で目を閉じた笑顔になっていた。
WAV単体と指示文の切り分け
声を合わせる指示文を入れず、参照音声なしと同じプロンプトにWAVだけを足した条件を追加した。
画像、解像度、ステップ数、セリフをそろえ、3条件をシード42・43・44で比べた。
シード42の「なし」と「WAV+指示文」は上の2本を使い、残り7本を追加で生成した。
WAVだけを足したシード42の出力
| 条件 | F0中央値(シード42 / 43 / 44) | 参照WAVとの類似度(42 / 43 / 44) |
|---|---|---|
| なし | 425 / 507 / 462Hz | 0.144 / 0.350 / 0.241 |
| WAV+指示文 | 538 / 540 / 523Hz | 0.438 / 0.442 / 0.446 |
| WAVだけ | 538 / 541 / 520Hz | 0.444 / 0.396 / 0.424 |
類似度は掛け合いと同じECAPAのコサイン類似度で、F0は四捨五入した。
今回の3シードでは、WAVだけでも指示文を足した条件とほぼ同じ高さになった。
参照との類似度も近く、声を合わせる指示文の1文による追加の効果は確認できなかった。
| 比べた出力 | 出力どうしの類似度 |
|---|---|
| WAVなし、シード違いの3組 | 0.726〜0.887 |
| WAVありの6本から作った15組 | 0.885〜0.980 |
| 同じシードのWAV+指示文とWAVだけ | 0.980 / 0.921 / 0.953(シード42 / 43 / 44) |
WAVを入れた出力は、シードを変えても話者ベクトルの類似度が高かった。
ただし参照WAVそのものとの類似度は0.396〜0.446で、参照の切り出し元の動画とWAVを比べた0.898より低い。
ECAPAはVoxCelebの話者録音で学習したモデルで、モデルカードも別のデータでの性能は保証していない。
合成された声と短い音声での数値は参考程度にとどまる。
シード43・44とWAVだけの条件も聴くと、声の傾向はシード42と同じだった。
WAVなしは参照より少し低い声、WAVを入れた条件は指示文の有無にかかわらず参照に近づくが、くぐもって聞こえた。
| 条件 | シード43の動画 | シード44の動画 |
|---|---|---|
| なし | 43 | 44 |
| WAV+指示文 | 43 | 44 |
| WAVだけ | 43 | 44 |
生成時間とメモリ
| 実験 | フレーム | 大きさ | 生成 | 動画のデコード | 合計 |
|---|---|---|---|---|---|
| 振り向き(最初と最後) | 56 | 416x608 | 173.32秒 | 32.90秒 | 223.41秒 |
| ジャンプ(最初と最後) | 56 | 416x608 | 173.76秒 | 32.97秒 | 223.56秒 |
| 2人の掛け合い | 107 | 640x384 | 319.60秒 | 66.60秒 | 402.38秒 |
| 4人バンド | 107 | 672x384 | 332.39秒 | 83.67秒 | 432.37秒 |
| 声の指定なし | 73 | 416x608 | 198.91秒 | 43.14秒 | 255.70秒 |
| 声の指定あり | 73 | 416x608 | 203.85秒 | 43.70秒 | 261.53秒 |
最初のフレームだけを指定した前回(416x608・56フレームで152.68秒)より、最後のフレームも指定すると生成が約20秒長くなった。
2人の掛け合いは、フレーム数が約1.9倍、生成時間が約2.0倍になった。
追加の生成では、Windowsのメモリ推移も記録した。
最後まで生成した13回の、記録された最大値・最小値を集計した。
| 項目 | 最初の記録 | 記録中の最小 | 記録中の最大 |
|---|---|---|---|
| コミット済みメモリ(物理メモリとページファイルに確保を約束した量) | 15.93〜17.42GiB | 14.64〜17.42GiB | 50.71〜52.96GiB |
| コミットの上限 | — | — | 51.44〜53.54GiB |
| 空き物理メモリ | — | 4.08〜5.20GiB | — |
| GPU専用メモリ(Dedicated Usage) | 1.20〜2.10GiB | — | 35.28〜36.93GiB |
| GPU共有メモリ(Shared Usage) | 3.04GiB | 3.04GiB | 3.04GiB |
| sd-cliのプライベートバイト | — | — | 3.58〜3.70GiB |
各欄は、13回それぞれの開始値・最小値・最大値を集めた範囲。
コミットの上限は、最初の試行の開始時点では46.90GiBだった。
計測コードはバイト数をPowerShellの 1GB(2の30乗バイト)で割っているため、GiBと表記している。
コミット済みメモリとGPU専用メモリは、生成中にどちらも約35GiBずつ増えていた。
コミットの上限も生成中に増えており、固定枠ではなかった。